



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



Bijgewerkt: November 10, 2026
Gepubliceerd: November 9, 2026
De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Met trots kondigen we de integratie aan van Resemble AI met TrueFoundry AI Gateway, waarmee stemklonen, synchrone tekst-naar-spraak (TTS) en streaming TTS naar hetzelfde gateway-pad worden gebracht dat teams al gebruiken voor LLM's, embeddings en agent-verkeer.
Teams die AI-verkeer routeren via TrueFoundry's AI Gateway kunnen Resemble AI nu aansluiten als een volwaardige tekst-naar-spraakprovider via de native SDK pass-through van de gateway. Verzoeken naar het /synthesize-endpoint en /stream-endpoint van Resemble verlopen via het gateway-pad met gecentraliseerde authenticatie, toegangsbeheer per team, uniforme kostenbewaking en volledige verzoek-tracing. Er zijn geen wijzigingen in de clientcode nodig, behalve het instellen van de Resemble-basis-URL naar de gateway en authenticeren met een TrueFoundry-token.
Dit bericht behandelt de architectuur van de integratie. Het legt uit hoe de TrueFoundry AI Gateway TTS-providers ontsluit, hoe het native API-oppervlak van Resemble behouden blijft via de pass-through-laag en hoe failover over meerdere TTS-providers werkt via Virtual Models.
TrueFoundry biedt de beheerslaag voor productie-AI-systemen. Via de AI Gateway centraliseren teams modelrouting, sleutelbeheer, toegangsbeheer, observeerbaarheid en kostenbewaking voor LLM's, embeddings, afbeeldingen- en audioproviders. Elk verzoek stroomt door een enkele proxy-laag waar de identiteit wordt geverifieerd, rate limits worden afgedwongen en traces worden vastgelegd.
TTS-verkeer in productie vertoont op drie manieren overeenkomsten met LLM-verkeer. Er worden meestal meerdere providers gebruikt omdat geen enkele TTS-leverancier op elk vlak de beste is. Latency is cruciaal omdat voice agents audio in real-time terugstreamen naar gebruikers. Kosten lopen snel op per teken of per seconde en profiteren van dezelfde doorberekening en budgetcontrole die teams al toepassen op chat completions. De argumenten voor het plaatsen van een gateway voor LLM-providers gelden dus net zo goed voor TTS.
Resemble AI is een compleet beveiligingsplatform voor generatieve AI voor het maken, verifiëren en detecteren van synthetische media in audio, video en afbeeldingen. Resemble bouwt ook eigen fundamentele modellen voor zowel generatie als detectie, wat een krachtig voordeel biedt bij het identificeren van door AI gegenereerde content. Voor spraakgeneratie is het kern-synthesemodel Chatterbox en Chatterbox Multilingual, met een Chatterbox Turbo-variant voor lagere latency en ondersteuning voor paralinguïstische tags. Alle door Resemble ontwikkelde TTS-modellen worden standaard geleverd met watermarking. Het platform ondersteunt ook stemklonen, voice design, audiobewerking, SSML, HD-synthese en streaming-output. Samen bieden de twee platformen teams één plek om spraakgeneratie te beheren en te traceren, samen met de rest van hun AI-stack. TrueFoundry verzorgt de deployment, routing en operationele controle. Resemble verzorgt de daadwerkelijke synthese. De integratie maakt gebruik van TrueFoundry's native SDK pass-through, die het volledige API-oppervlak van Resemble behoudt zonder het in een OpenAI-compatibele vorm te dwingen.
Het synchrone tekst-naar-spraak-endpoint van Resemble accepteert een klein aantal velden en retourneert audio samen met timing-metadata. Het synthesize-endpoint accepteert een voice_uuid om te selecteren welke getrainde of vooraf gebouwde stem moet worden gebruikt, en een data-veld met tekst of SSML tot 3000 tekens. Optionele velden regelen de modelselectie via model (bijvoorbeeld chatterbox-turbo), de audioprecisie via precision (een van MULAW, PCM_16, PCM_24 of PCM_32), het outputformaat via output_format (wav of mp3), de sample rate, de HD-modus via use_hd en aangepaste uitspraakverwerking via apply_custom_pronunciations.
De response payload retourneert success en een base64-gecodeerd audio_content-veld met de gesynthetiseerde audio-bytes. Timing-metadata komt binnen in audio_timestamps met grafeemtekens, grafeemtijden, fonoomtekens en fonoomtijden voor downstream alignement-toepassingen zoals lipsynchronisatie en ondertiteling. De respons meldt ook duration (de audiolengte in seconden), synth_duration (de bruto synthesietijd), output_format, sample_rate en eventuele problemen die de synthesizer tijdens de generatie heeft opgemerkt.
Een tweede endpoint op /stream ondersteunt streaming synthese over HTTP voor voice agent-toepassingen waarbij de tijd tot het eerste audiofragment (time to first audio chunk) van belang is. De structuur van het verzoek is hetzelfde. De respons is een stream van audioframes in plaats van een enkele base64-payload. De authenticatie voor beide endpoints verloopt via een bearer token dat is uitgegeven vanuit de Resemble-accountconsole.
De TrueFoundry AI Gateway draait op het Hono-framework; een enkele gateway-pod verwerkt meer dan 250 verzoeken per seconde op 1 vCPU en 1 GB RAM met ongeveer 3 ms extra latency. Gateway-pods zijn stateless, CPU-gebonden en schalen horizontaal naar tientallen duizenden RPS via extra pods. Het control plane en gateway plane zijn gescheiden. Providerconfiguratie, inclusief authenticatiegegevens, routingregels en rate limits, bevindt zich in het control plane en synchroniseert met gateway-pods via NATS. Het daadwerkelijke verzoekpad blijft in het geheugen, zonder externe aanroepen buiten de provider-aanroep zelf.
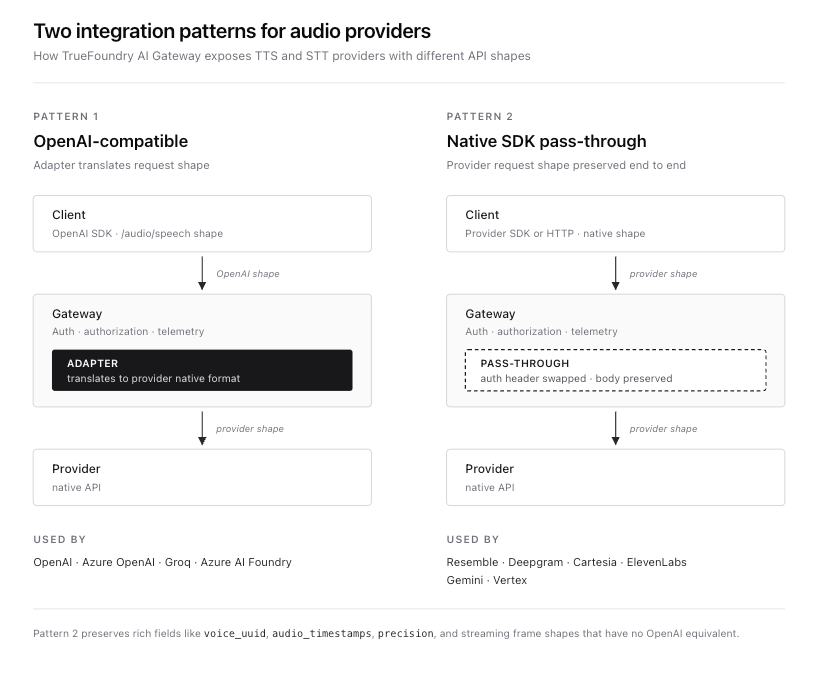
Voor TTS biedt de gateway twee integratiepatronen.
Het eerste is het OpenAI-compatibele API-patroon op de basis-URL van de gateway. Providers die het OpenAI /audio/speech-formaat ondersteunen (OpenAI, Azure OpenAI, Azure AI Foundry en Groq) kunnen hier direct op worden aangesloten. Clients gebruiken de standaard OpenAI SDK en de gateway vertaalt het verzoek naar het native formaat van de provider via een adapterlaag.
Het tweede is het native SDK pass-through-patroon op {GATEWAY_BASE_URL}/tts/{providerAccountName}. Providers met uitgebreide native API's die niet rechtstreeks op de OpenAI-structuur passen, sluiten hier op aan. De volledige verzoek- en responsstructuur van de provider blijft behouden. De gateway verzorgt authenticatie, toegangsbeheer, tracing en routing, maar herschrijft de payload niet. Dit is het patroon dat Resemble gebruikt, omdat de Resemble request body met voice_uuid, audio_timestamps, precisieniveaus en de chatterbox-turbo modelselector geen equivalent heeft in het OpenAI TTS-contract.
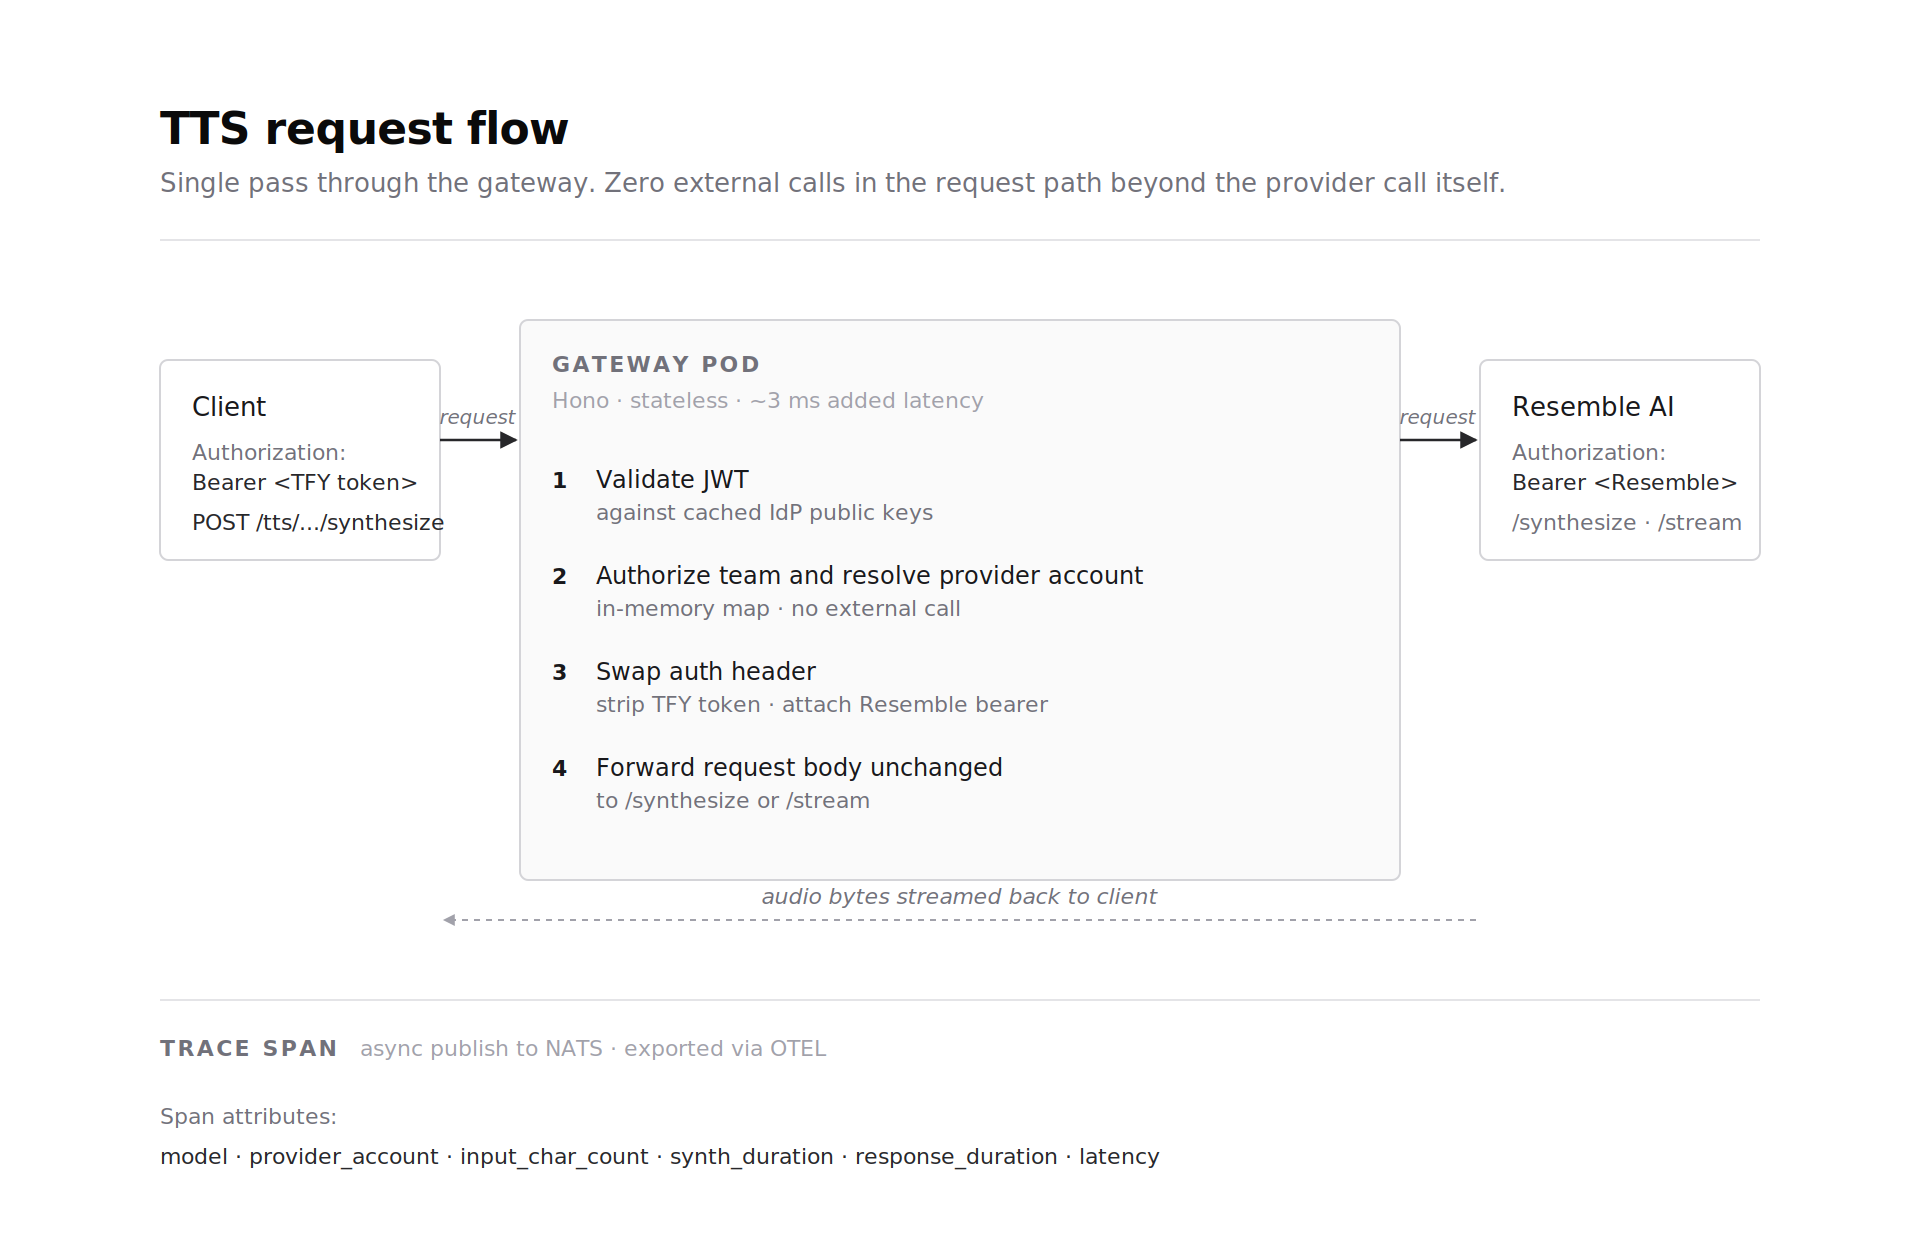
Wanneer een verzoek een gateway-pod bereikt, ziet het pad er als volgt uit. Het TrueFoundry-token in de Authorization-header wordt gevalideerd aan de hand van gecachte IdP openbare sleutels. De teamidentiteit wordt opgezocht in een in-memory map en de autorisatie voor het Resemble-provideraccount wordt gecontroleerd. De request body wordt doorgestuurd naar het synthesize- of stream-endpoint van Resemble met het Resemble bearer token aan de serverzijde toegevoegd. De respons wordt teruggestreamd naar de client. De volledige interactie wordt vastgelegd in een trace span met de modelnaam, het provideraccount, het aantal invoertekens, de responsduur, de synthesieduur en de latency. Er zijn geen extra round trips buiten de daadwerkelijke provider-aanroep.
Resemble is in het TrueFoundry control plane geregistreerd als een provideraccount, waarbij het Resemble bearer token is opgeslagen als een secret. Zodra het account is toegevoegd, ontsluit de gateway er twee TTS-routes voor. De native SDK-route op {GATEWAY_BASE_URL}/tts/{providerAccountName}/synthesize fungeert als proxy naar het synchrone endpoint. De streamingroute op {GATEWAY_BASE_URL}/tts/{providerAccountName}/stream fungeert als proxy naar het streaming-endpoint. Beide routes behouden exact de verzoek- en responsstructuur van Resemble.
Een minimale client-aanroep ziet er uit zoals het onderstaande fragment. Merk op dat de enige verandering ten opzichte van een rechtstreekse Resemble-aanroep de basis-URL en de authenticatieheader is.
Bestaande applicatiecode die zich rechtstreeks op Resemble richt, kan worden gemigreerd door de basis-URL en het bearer token te vervangen. Voice UUID's, SSML-payloads, precisie-instellingen en HD-modus blijven allemaal ongewijzigd behouden. De officiële client-libraries van Resemble kunnen op dezelfde manier worden geconfigureerd door hun basis-URL te overschrijven.
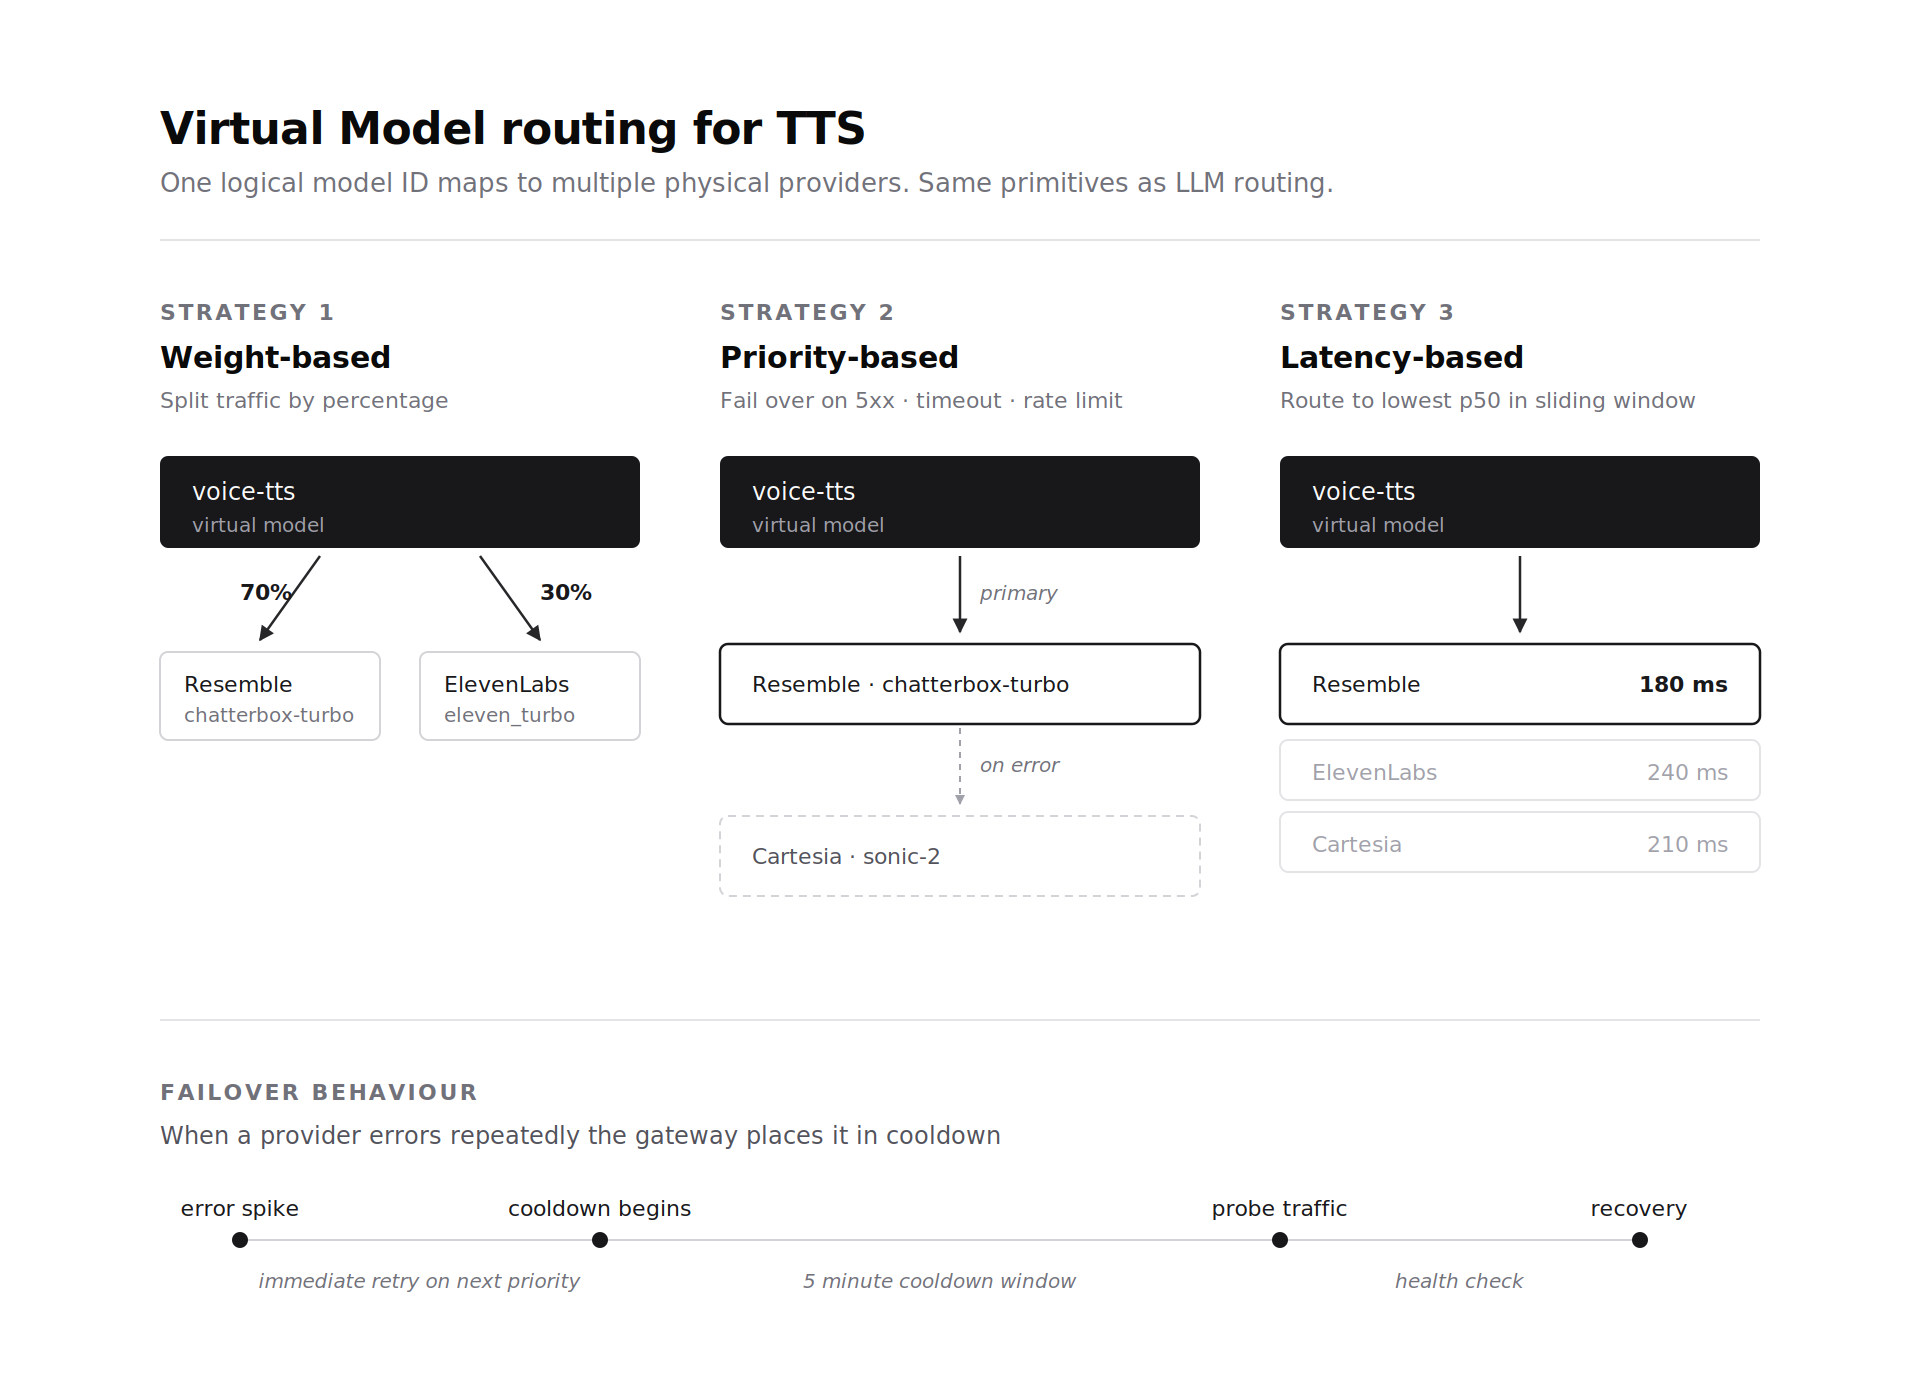
Voice agent-stacks maken in productie vaak gebruik van meerdere TTS-providers vanwege kosten- en latency-overwegingen. De Virtual Model-abstractie van de gateway werkt voor TTS-providers op dezelfde wijze als voor LLM-providers. Een virtual model identifier wordt gekoppeld aan een of meer fysieke TTS-deployments met routingregels. Op gewicht gebaseerde routing verdeelt het verkeer op basis van percentages over providers. Op prioriteit gebaseerde routing probeert de eerste provider en voert een failover uit bij een 5xx-fout, een timeout of een rate limit. Op latency gebaseerde routing stuurt het verkeer naar de provider met de laagste p50-latency in het voortschrijdend gemiddelde.
Failover voor TTS werkt met dezelfde primitieven als LLM-failover. Niet-herhaalbare fouten activeren direct een nieuwe poging bij de volgende prioriteitsprovider. Foutpieken plaatsen een provider in een afkoelperiode van 5 minuten, waarna testverkeer controleert of er herstel is opgetreden. Een team dat Resemble Chatterbox Turbo gebruikt als het primaire pad voor lage latency, kan overschakelen op Cartesia of ElevenLabs zonder de clientcode te wijzigen. Het Virtual Model regelt de selectie.
Kostenbewaking legt TTS-gebruik vast op hetzelfde detailniveau als LLM-gebruik. De gateway registreert het aantal invoertekens, de synthesieduur, het model, het team en de gebruiker bij elk verzoek. De aggregator-service berekent de uitgaven per team en per gebruiker en voedt dezelfde dashboards en budgetbeheersingsprimitieven die al worden gebruikt voor chat completions en embeddings. Rate limits worden afgedwongen via het Sliding Window Token Bucket-algoritme met minutenvensters op basis van gebruiker, team of model. Voor TTS is de eenheid gebaseerd op tekens of verzoeken in plaats van tokens, maar het algoritme blijft ongewijzigd.
Elk TTS-verzoek genereert een trace span. De span-attributen bevatten het provideraccount, de model-identifier (bijvoorbeeld resemble-prod/chatterbox-turbo), het aantal invoertekens, de responsduur in seconden, de bruto synthesietijd, het outputformaat, de sample rate en de latency aan de gateway-zijde. Traces worden asynchroon gegenereerd via NATS en geëxporteerd via OTEL naar de geconfigureerde observeerbaarheids-backend van het team (Arize, Langfuse, LangSmith of een van de andere ondersteunde doelen). De Exclude Request Data-schakelaar werkt op dezelfde manier als bij chat completions om invoertekst uit geëxporteerde traces te houden wanneer de gegevensprivacy dit vereist.
Dit betekent dat TTS-aanroepen in dezelfde trace-tijdlijn verschijnen als de upstream LLM-aanroep die de tekst heeft gegenereerd en de downstream agent-actie die de audio heeft verwerkt. Voor het debuggen van voice agents is deze consolidatie essentieel. Een mislukte interactie kan worden getraceerd van de LLM-completion die het antwoord koos, via de TTS-synthese die het heeft gegenereerd, tot de vervolgactie die de agent heeft ondernomen.
Van begin tot eind ziet de verzoeksstroom er als volgt uit. Een client stuurt een TTS-verzoek naar de gateway op {GATEWAY_BASE_URL}/tts/{providerAccountName}/synthesize of het bijbehorende streaming-endpoint met een TrueFoundry bearer token. De gateway authenticeert de aanroeper aan de hand van gecachte IdP-sleutels, zoekt het provideraccount op en controleert de autorisatie van het team en de gebruiker in het geheugen. Als er een Virtual Model wordt gebruikt, kiest de routinglogica een fysieke provider op basis van gewicht, prioriteit of latency. De request body wordt doorgestuurd naar Resemble met het Resemble bearer token aan de serverzijde toegevoegd. De respons wordt teruggestreamd naar de client, waarbij de volledige Resemble payload-structuur behouden blijft, inclusief audio-inhoud, timestamps en duration-metadata. Elke stap wordt vastgelegd in een trace span die asynchroon naar NATS wordt gestuurd en via OTEL wordt geëxporteerd.
Er hoeft verder niets te veranderen in de applicatie. Er is geen herschrijving van de SDK nodig, geen afhandeling van auth per provider aan de clientzijde en geen afzonderlijke observeerbaarheidspijplijn voor spraakverkeer. De gateway bevindt zich al in het verzoekpad voor de rest van de AI-stack en Resemble sluit op dat pad aan via native pass-through. Bestaande Resemble-clientcode blijft werken met alleen een aanpassing van de basis-URL.
Het architecturale principe dat dit zo gestroomlijnd maakt, is het dubbele integratiepatroon. Providers die het OpenAI-contract ondersteunen, sluiten aan via de OpenAI-compatibele adapter en hergebruiken dezelfde client-SDK's. Providers met uitgebreide native API's sluiten aan via de pass-through-route, die het volledige provideroppervlak behoudt zonder vertaling te vanzetten. Voor TTS is dit belangrijk omdat de verschillen tussen providers niet puur cosmetisch zijn. Voice UUID's, audio timestamp-formaten, precisieniveaus en streaming frame-structuren verschillen op manieren die een adapter in OpenAI-stijl zou moeten afvlakken. Het pass-through-patroon behoudt Resemble's Chatterbox-modelselectie, audio timestamps en precisie-instellingen, terwijl de gateway overkoepelende zaken zoals authenticatie, routing, observeerbaarheid en kostenbewaking afhandelt.
Lees meer over de TrueFoundry AI Gateway en het Resemble AI-platform. Voeg Resemble toe als provideraccount in het gateway control plane en roep het synthesize- of stream-endpoint aan op de /tts/{providerAccountName}-route vanuit uw bestaande applicatiecode.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















