


August 26, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Een prompt is net als een duidelijke instructie of een set instructies die u aan een tool of persoon geeft. Of het nu gaat om een trefwoord dat u in een zoekmachine typt, een commando voor een computerprogramma of een vraag die u aan een vriend stelt, prompts helpen hen te begrijpen waarnaar u op zoek bent of wat u wilt dat ze doen.
Prompt engineering, de kunst en wetenschap van het maken van effectieve prompts, is steeds essentiëler geworden met de toenemende populariteit van Large Language Models (LLMs), omdat het de benutting van de volledige mogelijkheden van LLMs mogelijk maakt.
Dit artikel helpt u prompt engineering te beheersen vanuit het perspectief van taalmodellen.
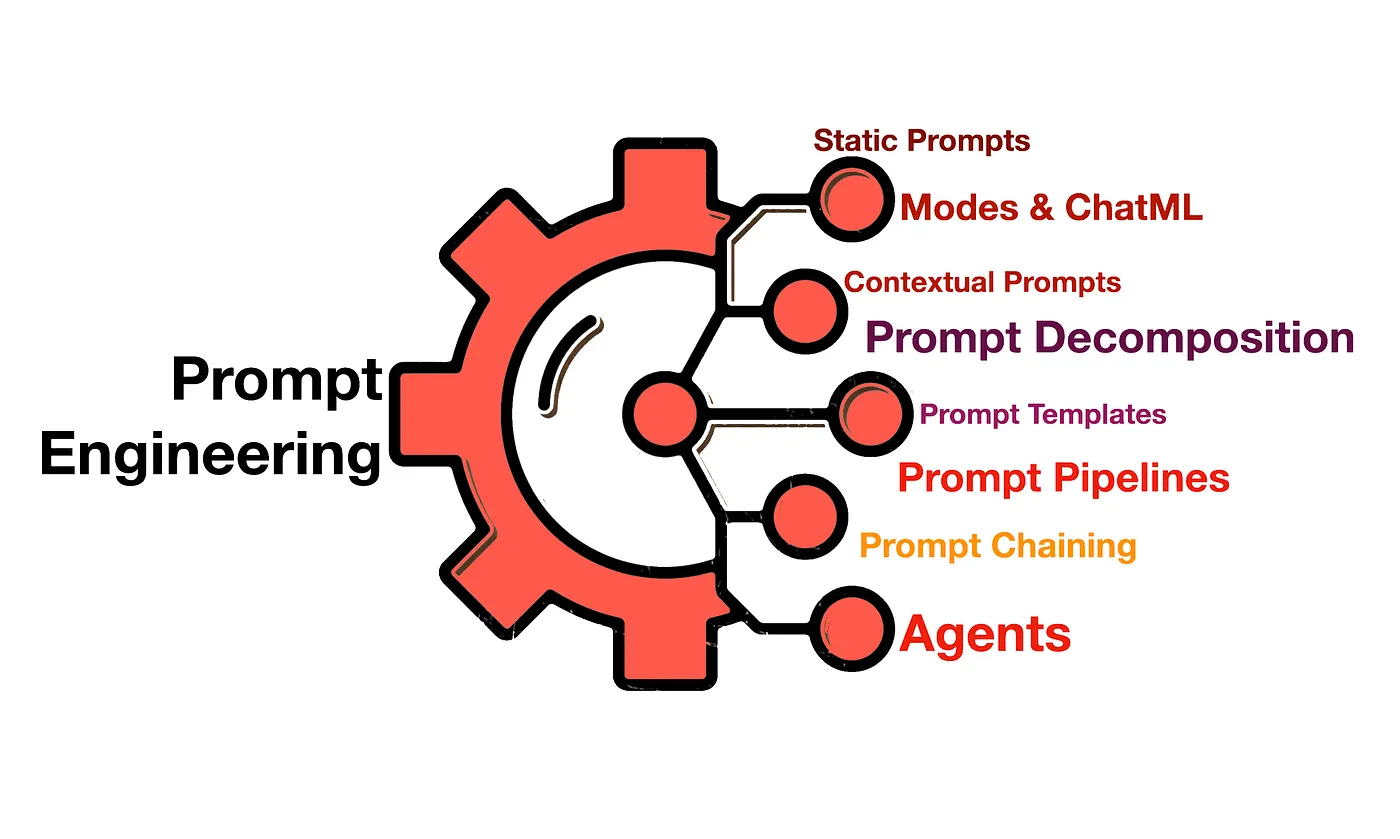
Prompt engineering is het proces van het ontwerpen en verfijnen van instructies om nauwkeurigere, relevantere en nuttigere antwoorden te krijgen van large language models (LLMs). Het omvat het kiezen van de juiste bewoordingen, het toevoegen van context, het verstrekken van voorbeelden en het instellen van beperkingen om te sturen hoe een model op een taak reageert.
In plaats van een LLM bijvoorbeeld te vragen om "te schrijven over cybersecurity", zou u het kunnen vragen om "drie veelvoorkomende cybersecurityrisico's voor kleine bedrijven uit te leggen, een praktisch voorbeeld van elk te geven en één preventiemaatregel voor te stellen". De specifieke instructies helpen het model een meer gerichte en toepasbare respons te genereren.
Prompt engineering kan ook technieken omvatten zoals zero-shot en few-shot prompting, role prompting, prompt chaining en retrieval-augmented generation (RAG). U kunt verschillende prompts testen en parameters zoals temperatuur en maximale output-tokens aanpassen om resultaten voor een specifieke use-case te verbeteren.
Het doel is niet simpelweg om een langere prompt te schrijven. Het is het bieden van voldoende duidelijke instructies en relevante context zodat het model de taak betrouwbaar kan voltooien, terwijl de output wordt gevalideerd voordat deze in een productieworkflow wordt gebruikt.
Prompt engineering helpt u nuttigere en consistentere resultaten te krijgen van large language models (LLMs) zonder het onderliggende model te veranderen.
Dit is waarom prompt engineering van belang is:
Prompt engineering werkt voor verschillende taken, van schrijven en samenvatten tot gegevensextractie en programmeren. Deze voorbeelden laten zien hoe specifieke instructies, context en outputvereisten een LLM kunnen helpen nuttigere antwoorden te genereren.
Een brede schrijf-prompt kan generieke content opleveren. Het toevoegen van de doelgroep, toon en structuur helpt het model een relevanter concept te maken.
Basis-prompt:
Schrijf een blog over cloud security.
Verbeterde prompt:
Schrijf een blog van 500 woorden over cloud security voor IT-beheerders bij kleine bedrijven. Gebruik eenvoudige taal, leg drie veelvoorkomende beveiligingsrisico's uit en geef voor elk een praktische maatregel. Gebruik beschrijvende kopteksten en vermijd niet-onderbouwde beweringen.
Waarom het werkt: De verbeterde prompt definieert de doelgroep, lengte, omvang en opmaak, waardoor het model duidelijkere criteria krijgt voor zijn antwoord.
Bij het samenvatten van lange documenten kunt u opgeven welke informatie moet worden behouden en hoe deze moet worden gepresenteerd.
Basis-prompt:
Vat dit rapport samen.
Verbeterde prompt:
Vat het onderstaande rapport samen in vijf opsommingstekens. Richt u op de belangrijkste bevindingen, ondersteunende cijfers en aanbevolen acties. Gebruik alleen informatie uit het rapport en geef eventuele ontbrekende details aan.
[Voeg rapport in]
Waarom het werkt: De instructies bepalen de lengte, prioriteiten en bewijsvereisten van de samenvatting, waardoor het resultaat gemakkelijker te beoordelen is.
Als u informatie moet extraheren uit ongestructureerde tekst, specificeer dan de vereiste velden en de output-indeling zodat het resultaat kan worden gecontroleerd of verwerkt door een andere applicatie.
Basis-prompt:
Extraheer de bestelgegevens uit dit bericht.
Verbeterde prompt:
Extraheer het bestel-ID, de productnaam, het aantal en de leverdatum uit het onderstaande bericht.
Geef geldige JSON terug met exact deze keys: order_id, product_name, quantity, delivery_date.
Gebruik null voor ontbrekende waarden. Leid geen details af die niet in het bericht staan vermeld.
Bericht: "Bestelling A104 bevat twee draadloze toetsenborden die gepland staan voor levering op 25 oktober 2026."
Voorbeeld-output:
Waarom het werkt: Het definiëren van een schema en regels voor ontbrekende informatie maakt de output consistenter. Valideer voor productiegebruik de JSON tegen het verwachte schema.
Specificeer voor codeertaken de taal, het verwachte gedrag, randgevallen en testvereisten in plaats van het model te vragen code te schrijven zonder context.
Basis-prompt:
Schrijf een functie om e-mailadressen te valideren.
Verbeterde prompt:
Schrijf een Python-functie die controleert of een e-mailadres een basaal geldige indeling heeft.
Vereisten:
- Accepteer een string als invoer.
- Geef True terug voor een basaal geldige indeling en anders False.
- Omgaan met lege strings en ontbrekende @-symbolen.
- Voeg vijf testcases toe die geldige en ongeldige invoer dekken.
- Leg de beperkingen van deze validatie-aanpak uit.
Gebruik geen externe bibliotheken.
Waarom het werkt: De prompt definieert de programmeertaal, het verwachte gedrag, randgevallen en tests. Dit geeft u code die gemakkelijker te beoordelen is, hoewel deze voor gebruik nog steeds moet worden getest.
Prompt engineering werkt door de instructies die u aan een large language model (LLM) geeft te verfijnen om een output te krijgen die overeenkomt met uw vereisten. U definieert de taak, biedt relevante context, stelt beperkingen in en test de respons om te zien of het model het verwachte resultaat levert.
Het proces omvat vier belangrijke stappen:
Begin met het identificeren van wat u wilt dat het model doet. Wees specifiek over het doel, of u nu een rapport moet samenvatten, klantfeedback moet classificeren, code moet genereren of een technische vraag moet beantwoorden.
Geef het model directe instructies en voeg alle informatie toe die het nodig heeft om de taak te voltooien. U kunt ook de toon, output-indeling, lengte en beperkingen opgeven. Als u een bepaald responspatroon wilt, geef dan voorbeelden met behulp van few-shot prompting.
Beoordeel de gegenereerde output op nauwkeurigheid, relevantie, volledigheid en opmaak. Test dezelfde prompt met verschillende invoeren om gevallen te identificeren waarin het model de taak verkeerd begrijpt of inconsistente resultaten produceert.
Pas de bewoording aan, voeg ontbrekende context toe of wijzig de voorbeelden op basis van de resultaten. U kunt ook generatieparameters afstemmen, zoals temperatuur en maximale output-tokens, wanneer dit wordt ondersteund door het model of de API. Herhaal het proces totdat de prompt betrouwbaar presteert bij representatieve invoeren.
Terwijl u aan prompt engineering werkt, gebruikt u over het algemeen een API om te communiceren met het LLM. Deze API's bestaan uit een set hyperparameters die kunnen worden aangepast om de gewenste outputs te bereiken. In deze discussie onderzoeken we de Hugging Face Inference API (zoals afgebeeld in de onderstaande afbeelding) en verkennen we het belang van elke parameter.
Zoals hierboven vermeld, kunnen verschillende hyperparameters worden aangepast om de kwaliteit en diversiteit van gegenereerde tekst te beïnvloeden. Laten we de verschillende hyperparameters binnen de eigenschap gen_kwards hierboven nader bekijken -
Het is net als het aanpassen van het pittigheidsniveau bij het koken - een hogere temperatuur betekent meer willekeur, zoals het toevoegen van kruiden voor de smaak, terwijl een lagere temperatuur de dingen voorspelbaar houdt, zoals het volgen van een recept. Bij creatieve Schrijftaken zoals het genereren van poëzie of het brainstormen over verhaalideeën kan een hogere temperatuurinstelling bijvoorbeeld resulteren in meer diverse en vindingrijke tekst.
Zie het als het beperken van keuzes in een bibliotheek tot de meest populaire boeken. Het selecteert de meest waarschijnlijke tokens tijdens de tekstgeneratie, wat de output verfijnt. Denk aan een klantenservice-chatbot die gebruikers helpt met veelvoorkomende vragen. Door een top_k-parameter in te stellen, kan de chatbot prioriteit geven aan antwoorden op basis van de meest relevante informatie, zodat gebruikers nauwkeurige en nuttige hulp krijgen zonder te worden overspoeld door onnodige details.
Top_p stelt een limiet aan de in aanmerking genomen tokens door tokens te kiezen totdat een cumulatieve waarschijnlijkheid van p is bereikt. Zowel top_k als top_p worden gebruikt om diversiteit en kwaliteit te controleren.
Het is net als het instellen van een woordlimiet voor een essay. Max_new_tokens bepaalt hoeveel tekst het model kan genereren, waardoor het binnen een opgegeven lengte blijft. Als u bijvoorbeeld antwoorden genereert voor een chatbot, zorgt het instellen van een maximale tokenlimiet ervoor dat de antwoorden beknopt en relevant blijven voor de gesprekscontext, of u kunt deze verhogen.
Repetition penalty ontmoedigt het model om tokens te hergebruiken, wat de diversiteit in de gegenereerde tekst bevordert. In een conversationele AI-toepassing, zoals een virtuele assistent, zorgt het instellen van een repetition_penalty ervoor dat de antwoorden van de assistent gevarieerd en natuurlijk blijven tijdens langdurige interacties.
Frequency Penalty moedigt het model aan om minder vaak voorkomende tokens te verkennen, wat de tekst unieker maakt. Stel dat u een nieuwsaggregator-app ontwikkelt die artikelen uit verschillende bronnen samenvat. Door een frequency penalty toe te passen, kan de app prioriteit geven aan minder bekende publicaties of niche-onderwerpen, waardoor gebruikers een divers scala aan perspectieven krijgen.
Presence Penalty stuurt het model om tekst te genereren die aansluit bij specifieke criteria of bepaalde onderwerpen vermijdt, wat de relevantie waarborgt. In een systeem voor contentmoderatie voor online forums helpt het instellen van een presence penalty om ongepaste of beledigende taal te filteren. Als een gebruiker bijvoorbeeld discriminerende reacties probeert te plaatsen, zou de presence penalty het systeem sturen om een waarschuwingsbericht te genereren.
U moet beginnen met het maken van eenvoudige, duidelijke prompts en geleidelijk complexiteit introduceren door middel van verfijning, in plaats van alle informatie aan het begin te belasten. Probeer dus bij een grote taak deze op te splitsen in deeltaken.
Opdrachten moeten duidelijk en expliciet zijn. Bijvoorbeeld,
Slechte prompt: " The quick brown fox jumps over the lazy dog, Vertaal dit."
Betere prompt: "Vertaal de volgende Engelse tekst naar het Spaans: 'The quick brown fox jumps over the lazy dog.'"
Verbeter de helderheid van de prompt door relevante voorbeelden en gedetailleerde instructies op te nemen.
Slechte prompt: “Schrijf over sociale media en de effecten ervan.”
Betere prompt: “Schrijf een essay van 500 woorden waarin de impact van sociale media op de mentale gezondheid van tieners wordt besproken. Voeg statistieken toe van gerenommeerde bronnen zoals de American Psychological Association en geef praktijkvoorbeelden van individuen die worden beïnvloed door overmatig gebruik van sociale media. “
Zorg ervoor dat prompts duidelijk en direct zijn om dubbelzinnigheid in modelresponsen te voorkomen.
Verfijn prompts iteratief op basis van feedback en prestaties om resultaten te optimaliseren via automated prompt engineering.
Het kiezen van de beste prompt engineering tools hangt af van het feit of u prompts optimaliseert voor experimenten, productie-uitrol of modelspecifieke workflows.
Hugging Face Transformers: Het biedt interfaces voor het fine-tunen van modellen op specifieke taken en maakt het maken van aangepaste prompts mogelijk.
OpenAI Codex API: De API van OpenAI bevat mogelijkheden voor prompt engineering, waardoor gebruikers code of tekst kunnen genereren op basis van prompts.
GPT-3 Playground: Platformen zoals de GPT-3 Playground bieden interactieve omgevingen voor het experimenteren met prompts en het in real-time observeren van modelresponsen.
Google's T5 Framework: T5 (Text-To-Text Transfer Transformer) is een framework dat alle NLP-taken giet in een tekst-naar-tekst-indeling, wat prompt engineering voor verschillende taken vereenvoudigt.
AllenNLP: AllenNLP biedt tools voor het bouwen en evalueren van NLP-modellen, inclusief mechanismen voor prompt-ontwerp en -evaluatie.
Prompt engineering-technieken helpen u een LLM te sturen naar relevantere, nauwkeurigere en consistentere outputs. Sommige technieken verbeteren de manier waarop een model instructies volgt, terwijl andere complexe taken opsplitsen in kleinere stappen, redenering ondersteunen of het model verbinden met externe tools en gegevens.
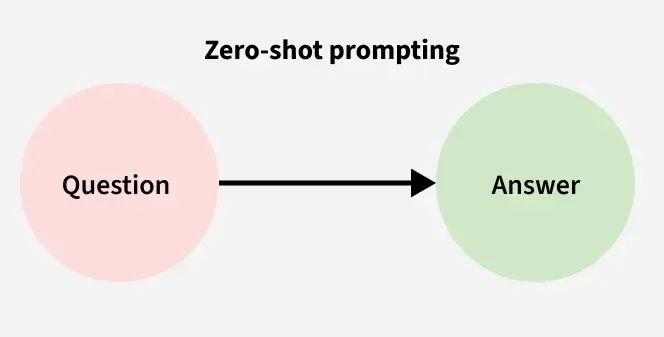
Zero-shot prompting vraagt een LLM om een taak te voltooien zonder voorbeelden te geven. Het model vertrouwt op zijn bestaande training en de instructies in uw prompt.
Voorbeeld-prompt:
Wie was de eerste mens die naar de ruimte reisde?
Voorbeeld-output:
Yuri Gagarin was de eerste mens die naar de ruimte reisde, in 1961.
Gebruik zero-shot prompting voor eenvoudige vragen, samenvattingen, classificaties en andere taken waarbij de instructies duidelijk zijn en voorbeelden onnodig zijn.
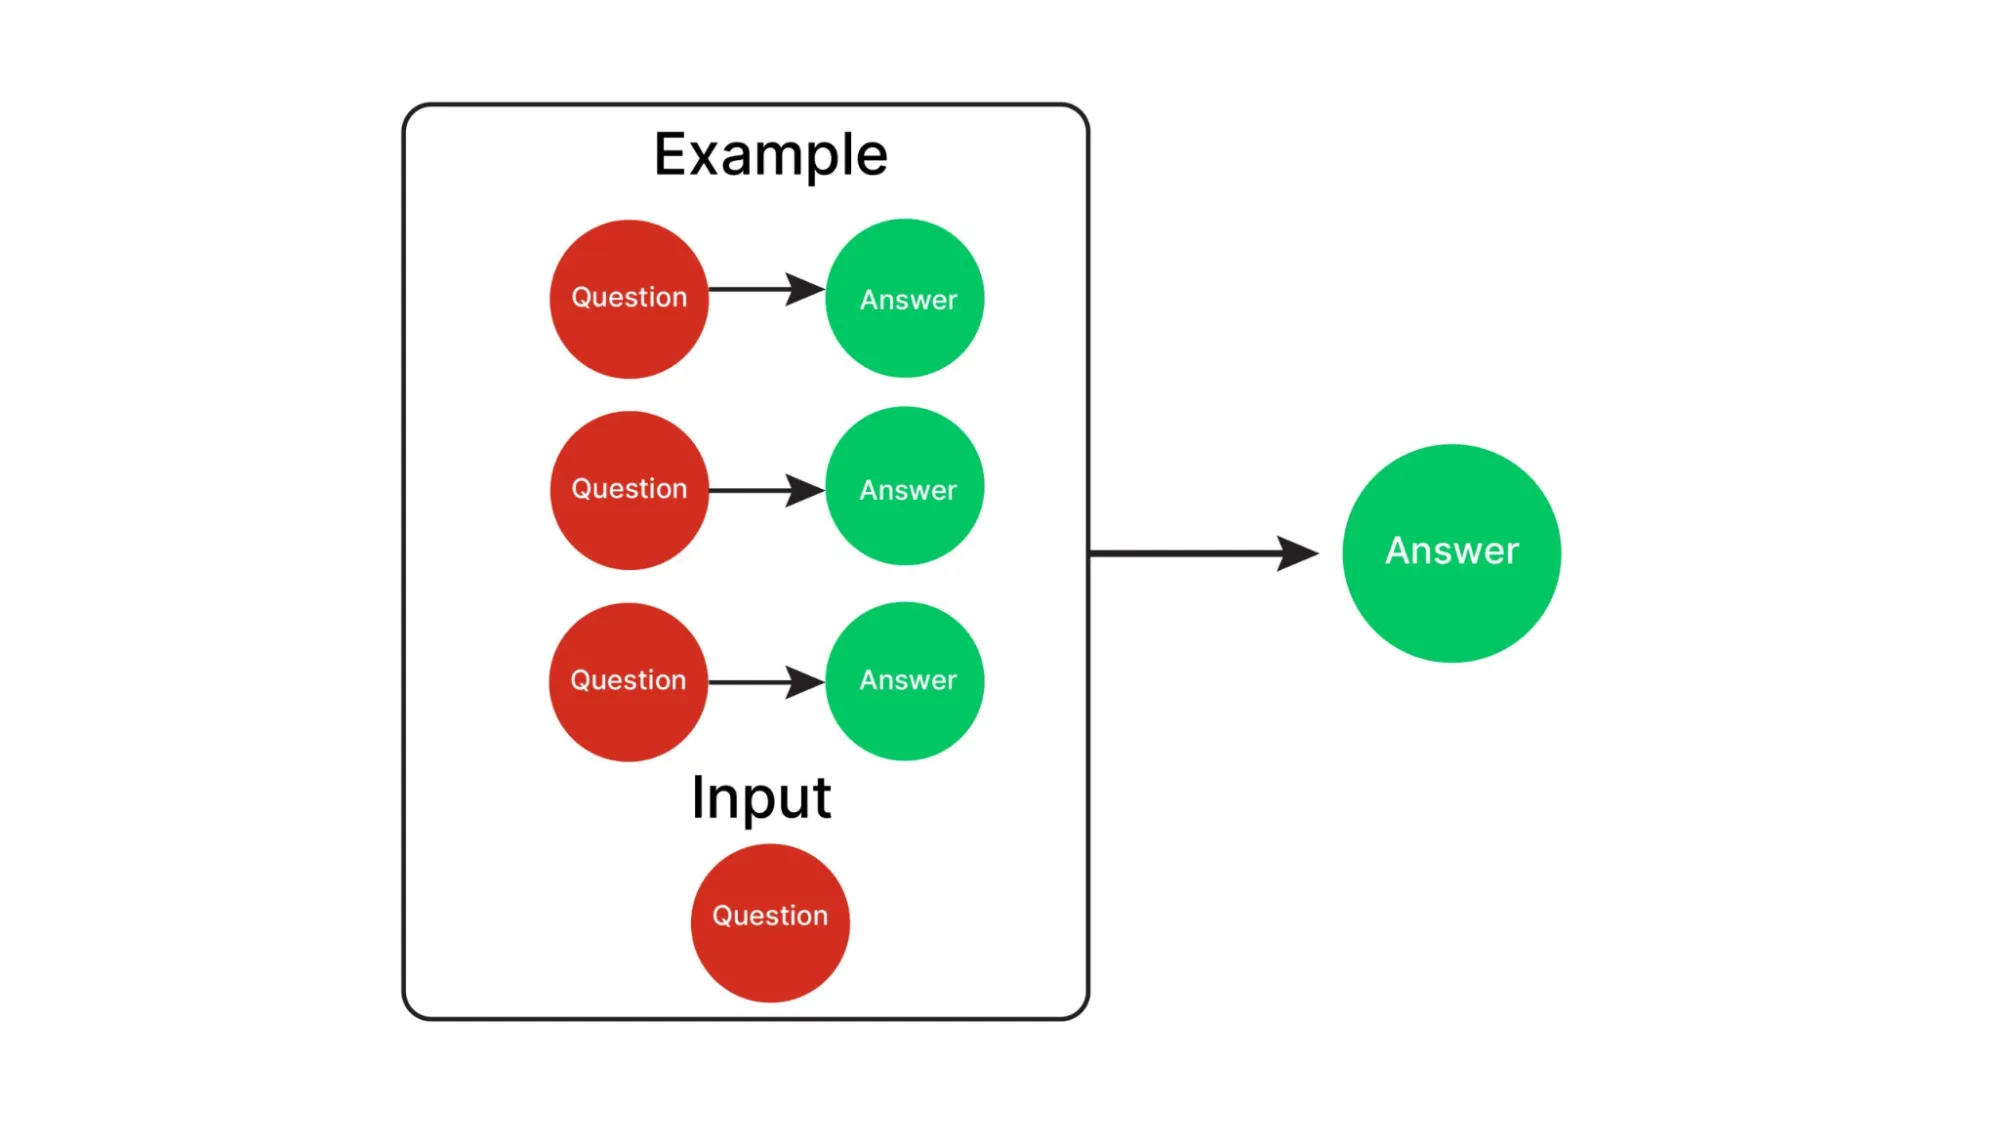
Few-shot prompting biedt een klein aantal invoer-outputvoorbeelden om het model het verwachte patroon, de opmaak of de stijl te tonen. One-shot prompting gebruikt één voorbeeld, terwijl multi-shot prompting er meerdere gebruikt.
Voorbeeld-prompt:
Classificeer elk klantbericht als Positief, Negatief of Neutraal.
Bericht: "De levering was snel en het product werkt goed."
Sentiment: Positief
Bericht: "Het artikel kwam kapot aan."
Sentiment: Negatief
Bericht: "Het pakket is gisteren aangekomen."
Sentiment:
Voorbeeld-output:
Neutraal
Few-shot prompting is nuttig wanneer u consistente classificaties, gestructureerde antwoorden of een bepaalde schrijfstijl nodig heeft zonder het model te fine-tunen.
Role prompting wijst het model een specifieke rol of professioneel perspectief toe. Dit helpt bij het vaststellen van de verwachte toon, het detailniveau en de prioriteiten voor de respons.
Voorbeeld-prompt:
Treed op als een senior software engineer die een pull request beoordeelt. Identificeer potentiële bugs, beveiligingsproblemen en prestatieproblemen. Leg elke bevinding uit en stel een praktische oplossing voor.
Gebruik role prompting wanneer de taak een gedefinieerd perspectief vereist, zoals het beoordelen van code, het uitleggen van technische concepten aan beginners of het opstellen van klantenservice-antwoorden. Een rol kan het antwoord sturen, maar het garandeert geen nauwkeurigheid op expertniveau.
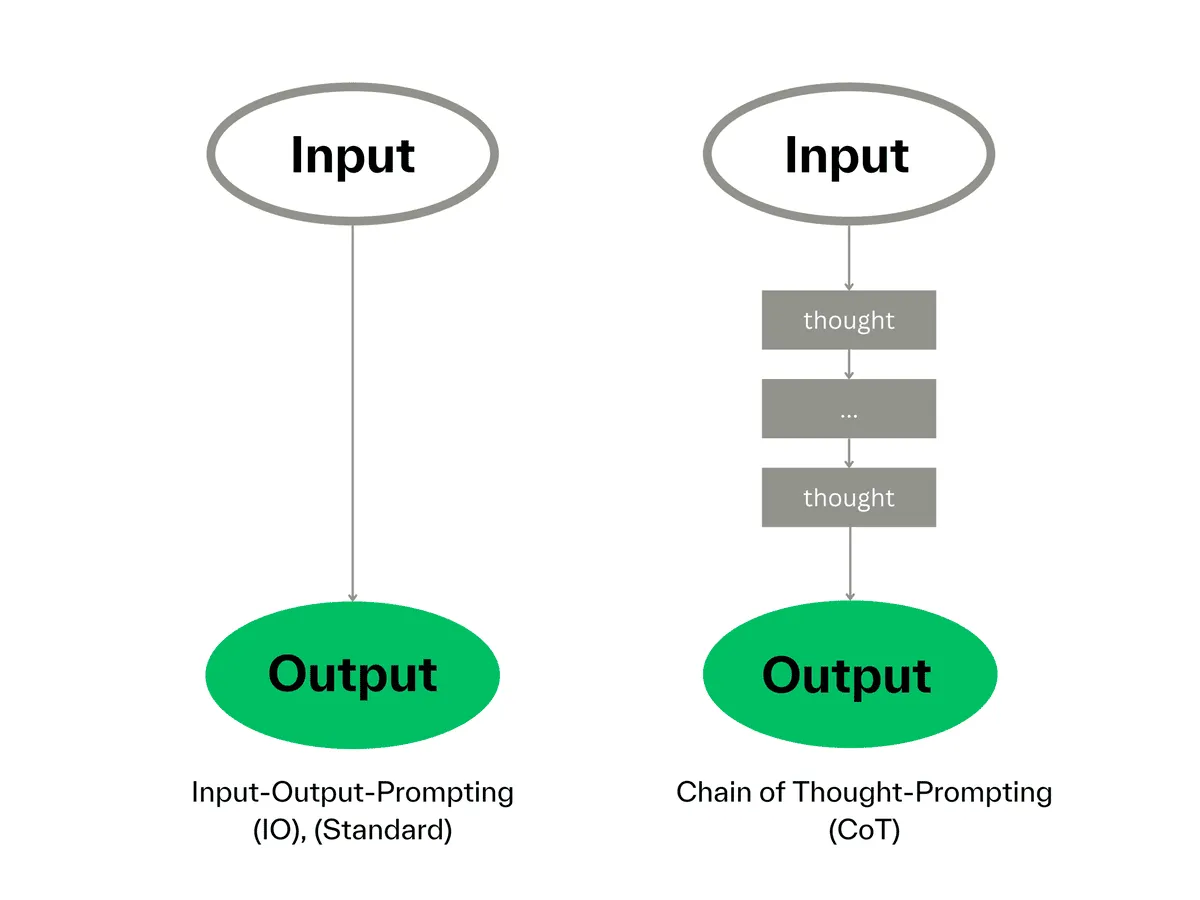
Chain-of-thought (CoT) prompting moedigt een model aan om een probleem te benaderen via tussenliggende redeneerstappen in plaats van direct naar een antwoord te springen. Het wordt vaak geassocieerd met taken op het gebied van wiskunde met meerdere stappen, logica en planning.
Voorbeeld-prompt:
Een team heeft 48 taken te voltooien. Vier engineers verdelen het werk gelijkmatig. Elke engineer voltooit nog drie extra taken. Hoeveel taken worden er in totaal voltooid?
Voorbeeld-output:
48 taken worden gelijkmatig verdeeld over 4 engineers, wat elke engineer 12 taken geeft. Elk voltooit 3 extra taken, dus elk voltooit er 15. Het totaal is 4 × 15 = 60 taken.
Prompting in CoT-stijl kan helpen bij problemen met meerdere stappen, maar vragen om een lange uitleg verbetert niet automatisch de nauwkeurigheid. Voor productietoepassingen kunt u vragen om een beknopte uitleg of verifieerbare tussenresultaten in plaats van te vertrouwen op de volledige interne redenering van het model.
Automatic chain-of-thought genereert voorbeeld-demonstraties die kunnen worden gebruikt om een model door redeneertaken te leiden. In plaats van elk voorbeeld handmatig te schrijven, genereert een systeem representatieve voorbeelden en gebruikt deze in opeenvolgende prompts.
Auto-CoT omvat doorgaans twee fasen:
Auto-CoT kan de handmatige inspanning verminderen die gemoeid is met het voorbereiden van few-shot redeneervoorbeelden. Gegenereerde demonstraties kunnen echter fouten bevatten, dus ze moeten voor gebruik worden gecontroleerd.
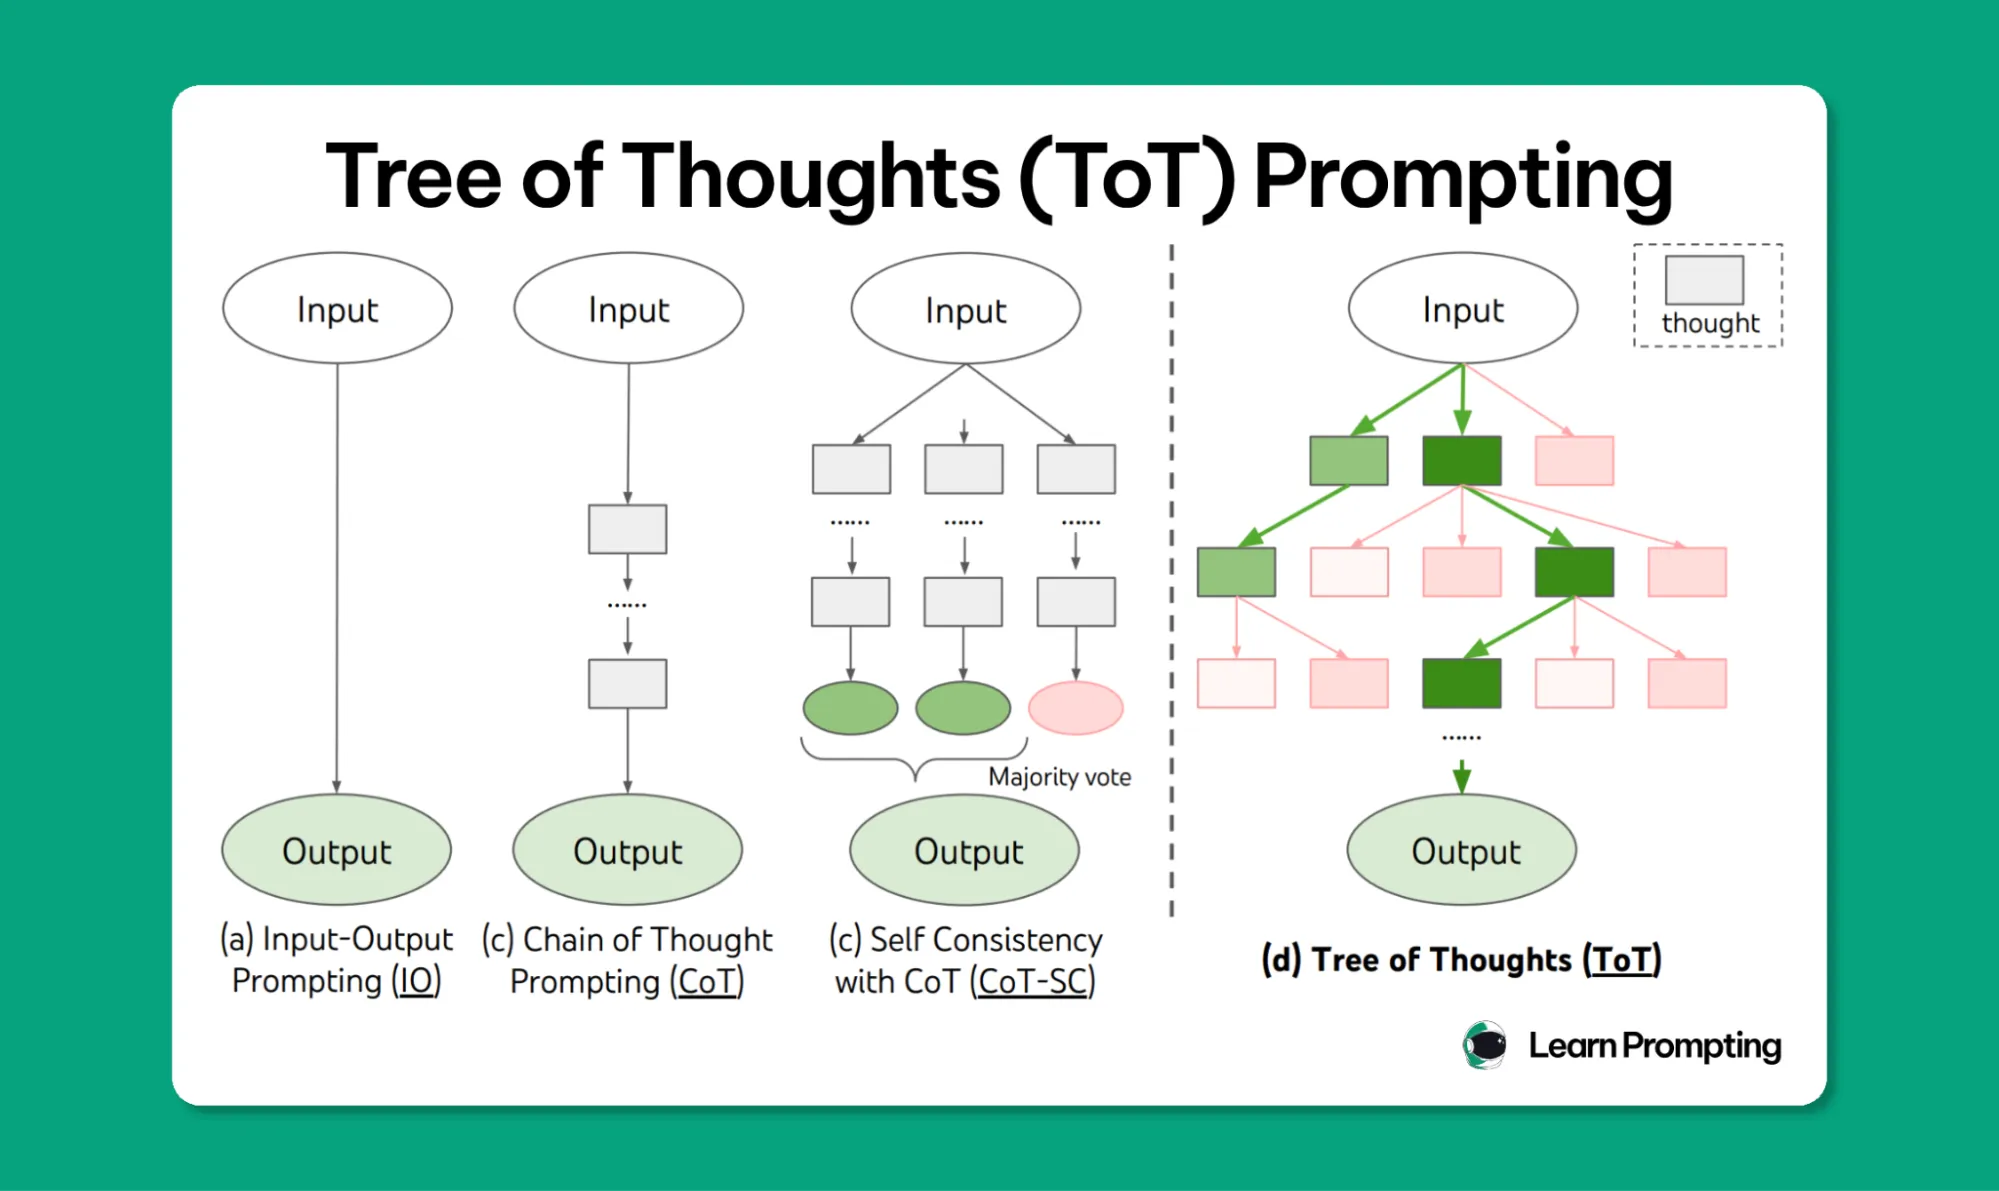
Tree of Thoughts breidt het idee van het verkennen van tussenstappen uit door een model in staat te stellen meerdere mogelijke oplossingspaden te overwegen. Het systeem evalueert deze paden en kan veelbelovende opties uitbreiden of zwakkere opties verwijderen.
Bij het plannen van een migratie van een monolithische applicatie naar microservices zou een Tree of Thoughts-benadering bijvoorbeeld verschillende servicegrenzen, uitrolstrategieën en migratievolgordes kunnen vergelijken voordat een plan wordt geselecteerd.
ToT is nuttig voor problemen die verkenning en vergelijking vereisen, zoals complexe planning, op beperkingen gebaseerde puzzels en strategieselectie. Het kan meer model-calls en berekeningen vereisen dan een eenvoudige prompt.
Self-consistency verbetert de betrouwbaarheid van sommige redeneertaken door meerdere onafhankelijke antwoorden op dezelfde vraag te genereren en hun antwoorden te vergelijken. Het systeem kan het meest voorkomende antwoord selecteren of een andere validatiemethode gebruiken om meningsverschillen op te lossen.
Een systeem kan bijvoorbeeld meerdere oplossingen genereren voor een numeriek vraagstuk en de eindresultaten vergelijken. Als de meeste antwoorden overeenkomen, kan dat antwoord worden geselecteerd voor verdere verificatie.
Self-consistency kan fouten verminderen die worden veroorzaakt door een individuele generatie, met name bij redeneertaken. Het garandeert geen juistheid, omdat meerdere antwoorden dezelfde fout kunnen delen.
Prompt chaining splitst een complexe taak op in kleinere stappen, waarbij de output van de ene prompt de invoer voor de volgende wordt. Elke stap heeft een specifieke verantwoordelijkheid, wat de algehele workflow gemakkelijker maakt om te testen en problemen op te lossen.
Voorbeeld-workflow:
De eerste prompt kan bijvoorbeeld oefennamen in een gestructureerde indeling retourneren. De tweede kan die namen valideren, en de derde kan de gevalideerde output gebruiken om de routine te maken.
Prompt chaining is nuttig voor workflows met meerdere fasen, zoals documentverwerking, onderzoek, contentgeneratie en gegevensextractie. Het maakt het ook gemakkelijker om te identificeren welke stap een onjuist resultaat heeft veroorzaakt.
Retrieval-augmented generation (RAG) voorziet een LLM van relevante informatie die op het moment van de query uit externe bronnen is opgehaald. Het model gebruikt die context om een antwoord te formuleren in plaats van alleen te vertrouwen op informatie die tijdens de training is gecodeerd.
Een typische RAG-workflow omvat:
Een interne ondersteuningsassistent zou bijvoorbeeld relevante handleidingen voor probleemoplossing en productdocumentatie kunnen ophalen voordat hij de vraag van een werknemer beantwoordt.
RAG is nuttig wanneer antwoorden actuele, private of domeinspecifieke informatie moeten weerspiegelen. De prestaties zijn afhankelijk van de kwaliteit van het ophalen, de contextrelevantie en hoe goed het model het geleverde bewijsmateriaal gebruikt.
ReAct combineert redeneergerichte taakplanning met acties die worden uitgevoerd via externe tools. Het model kan beslissen welke actie nodig is, een zoekmachine of API aanroepen, het resultaat observeren en die informatie gebruiken om de volgende stap te bepalen.
Voorbeeld-workflow:
ReAct is nuttig voor AI-agents die moeten communiceren met externe systemen in plaats van alleen vanuit de prompt te antwoorden. Toolrechten, invoervalidatie en limieten op beschikbare acties zijn belangrijke waarborgen bij de implementatie ervan.
Structured output prompting instrueert het model om informatie te retourneren in een gedefinieerd formaat, zoals JSON, XML of een vaste set velden. Dit maakt de output eenvoudiger te parseren en te gebruiken voor software.
Voorbeeldprompt:
Extract the product name, price, and availability. Return the result as JSON with these keys: product_name, price, availability. Do not add fields outside this schema.
Voorbeeld-output:
Deze techniek is nuttig voor API-integraties, data-extractie, classificatiepijplijnen en workflows die model-outputs doorsturen naar andere software. Valideer voor betrouwbaar productiegebruik de output tegen een schema in plaats van ervan uit te gaan dat promptinstructies alleen al geldige JSON afdwingen.
Constraint-based prompting specificeert de grenzen waaraan een antwoord moet voldoen. Dit kunnen woordlimieten, verplichte velden, goedgekeurde bronnen, toon, opmaakregels of acties zijn die het model moet vermijden.
Voorbeeldprompt:
Summarize the report in 150 words or fewer. Use only information from the supplied report. Include three key findings and two recommendations. Flag missing information instead of inventing facts.
Deze techniek is nuttig wanneer outputs moeten voldoen aan redactionele richtlijnen, bedrijfsregels, compliance-vereisten of strenge opmaakbehoeften. Belangrijke beperkingen moeten waar mogelijk ook via applicatielogica worden afgedwongen.
Prompt engineering helpt u om relevantere, consistentere en nuttigere outputs te krijgen van large language models (LLM's) zonder het model voor elke taak opnieuw te trainen.
Als u uw AI-outputs wilt verbeteren of applicaties wilt bouwen die worden aangedreven door large language models (LLM's), kan een cursus prompt engineering u helpen leren hoe u betere instructies schrijft, nuttige context biedt en antwoorden evalueert. Hier zijn vijf cursussen die het overwegen waard zijn, afhankelijk van uw ervaring en leerdoelen.
Deze cursus is een goed startpunt als u wilt begrijpen hoe u effectieve prompts schrijft voor ChatGPT. Het behandelt praktische promptingtechnieken die u kunt toepassen op dagelijkse taken, contentcreatie en probleemoplossing.
Het beste voor: Beginners die hun gebruik van ChatGPT willen verbeteren.
Deze korte cursus, gemaakt door Isa Fulford en Andrew Ng, richt zich op het toepassen van prompt engineering bij de ontwikkeling van AI-applicaties. U leert via praktische voorbeelden hoe u LLM API's kunt gebruiken voor samenvatting, classificatie, teksttransformatie en de ontwikkeling van chatbots.
De cursus duurt ongeveer 1,5 uur en is geschikt voor beginners met een basiskennis van Python.
Het beste voor: Ontwikkelaars die LLM's willen integreren in applicaties.
Bekijk de cursus op DeepLearning.AI
De cursus prompt engineering van IBM behandelt de grondbeginselen van het schrijven van effectieve prompts en het toepassen van promptingtechnieken op generatieve AI-taken. Het kan u helpen begrijpen hoe u instructies structureert en promptingtools gebruikt voor verschillende applicaties.
Het beste voor: Cursisten die een gestructureerde introductie in prompt engineering willen.
Google Prompting Essentials leert u hoe u duidelijke, specifieke prompts schrijft voor dagelijks werk. Het programma behandelt een vijftaps promptingbenadering en laat zien hoe u promptingtechnieken toepast op taken zoals data-analyse, presentaties en zakelijke communicatie. De specialisatie staat vermeld op beginnermenu en duurt ongeveer vier uur.
Het beste voor: Studenten en professionals die AI effectiever willen gebruiken op het werk.
De Generative AI Fundamentals Specialization van IBM biedt een bredere dekking van generatieve AI, inclusief basismodellen, praktische applicaties, prompt engineering en verantwoorde AI. Het is ontworpen voor beginners en bevat praktische leeractiviteiten.
Het beste voor: Beginners die prompt engineering willen leren samen met bredere generatieve AI-concepten.
Bekijk de specialisatie op Coursera
Prompt engineering helpt u relevantere en consistentere resultaten te krijgen van large language models door de manier waarop u instructies structureert, context biedt en outputvereisten definieert te verbeteren. Van zero-shot en few-shot prompting tot prompt chaining en RAG: de juiste techniek hangt af van uw taak en de betrouwbaarheid die uw applicatie nodig heeft.
Goede prompts zijn echter slechts één onderdeel van het bouwen van betrouwbare AI-applicaties. U moet ook outputs evalueren, modeltoegang beheren, prestaties monitoren en controleren hoe AI-systemen met externe tools communiceren.
Ga verder dan het schrijven van betere prompts. Gebruik de AI Gateway van TrueFoundry om LLM-toegang te beheren, modelverzoeken te monitoren en prestaties te evalueren terwijl u AI-applicaties bouwt en opschaalt. Boek een demo.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox




















