



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
PII kan een LLM-pipeline op vier punten binnendringen — gebruikersinvoer, opgehaalde context, tool-resultaten en de eigen output van het model — en veel teams beginnen met het beveiligen van alleen het eerste punt. Deze post behandelt waar PII binnenkomt, de detectiemethoden die elk type opvangen (regex, entropie-analyse, NER, externe API's) en hun afwegingen in nauwkeurigheid en latentie, het verschil tussen het herschrijven van PII en het blokkeren erop, de manier waarop redactie stilzwijgend de betekenis kan vernietigen die het model nodig heeft, en het framework om te beslissen of redactie thuishoort bij de gateway of in de applicatie.
Donderdag bij Northwind. De escalatie-agent van het supportteam beantwoordde een vraag van een klant over hun verzendaccount door het dossier van de klant samen te vatten — en vermeldde in de tweede zin het volledige Burgerservicenummer (BSN) van de klant. Het nummer was echt. Het kwam niet uit iets wat de klant had getypt. Het was afkomstig uit een supportticket dat het RAG-systeem had opgehaald, waar een agent drie jaar eerder het BSN in een tekstnotitie had geplakt.
Reza, een security engineer in het platformteam, achterhaalt het in een middag. De guardrail voor invoer-redactie die het team zes maanden eerder had uitgerold, scande elk gebruikersbericht op PII en werkte exact zoals ontworpen. Het had simpelweg nooit naar de opgehaalde context gekeken. Het BSN kwam de pipeline binnen op een punt dat de guardrail niet in de gaten hield, kwam in de prompt terecht als onderdeel van een opgehaald document, en het model — dat gewoon zijn werk deed — citeerde het terug.
Deze post is het dreigingsmodel dat dat incident leert, en de engineering-afwegingen om het geheel af te dekken: waar PII binnenkomt, hoe u elk type detecteert, wat detectie kost aan latentie, en waar de redactielogica moet leven.
Een LLM-verzoek is geen enkelvoudig kanaal. PII kan de context binnendringen op vier verschillende punten, en elk punt heeft zijn eigen detectiestap nodig:
1. Gebruikersinvoer. Wat de gebruiker typt. Dit is het punt dat iedereen als eerste beveiligt, en het enige punt dat veel pipelines überhaupt beveiligen. Reëel, maar zelden het meest gevaarlijk, omdat de gebruiker over het algemeen weet wat hij heeft getypt.
2. Via RAG opgehaalde context. Documenten die door een ophaalstap in de prompt worden getrokken. De indexeerder heeft ze bijna nooit opgeschoond — het zijn interne tickets, wiki-pagina's, CRM-notities — en alle PII daarin gaat rechtstreeks de prompt in. Dit is het scenario dat zomaar kan optreden, en het is vaak het meest over het hoofd gezien: niemand heeft op het moment van het verzoek gekozen om het toe te voegen, dus een invoer-guardrail die het bericht van de gebruiker in de gaten houdt, ziet het nooit.
3. Tool-resultaten. Gegevens die worden geretourneerd door een tool die de agent heeft aangeroepen — een API voor het zoeken naar klanten, een database-query, een MCP-server (de post-tool hook van de MCP gateway die eerder in deze serie is besproken). Een tool die een klantrecord opvraagt, retourneert PII direct in de context, volgens ontwerp.
4. Model-output. De eigen reactie van het model. Zelfs met schone invoer kan een model PII uitstoten — gehercombineerd uit de context, of in zeldzame gevallen onthouden uit de training. Voor compliance is elke PII in een output die wordt gelogd of getoond aan een onbevoegde kijker een beleidsschending, ongeacht waar deze vandaan kwam.
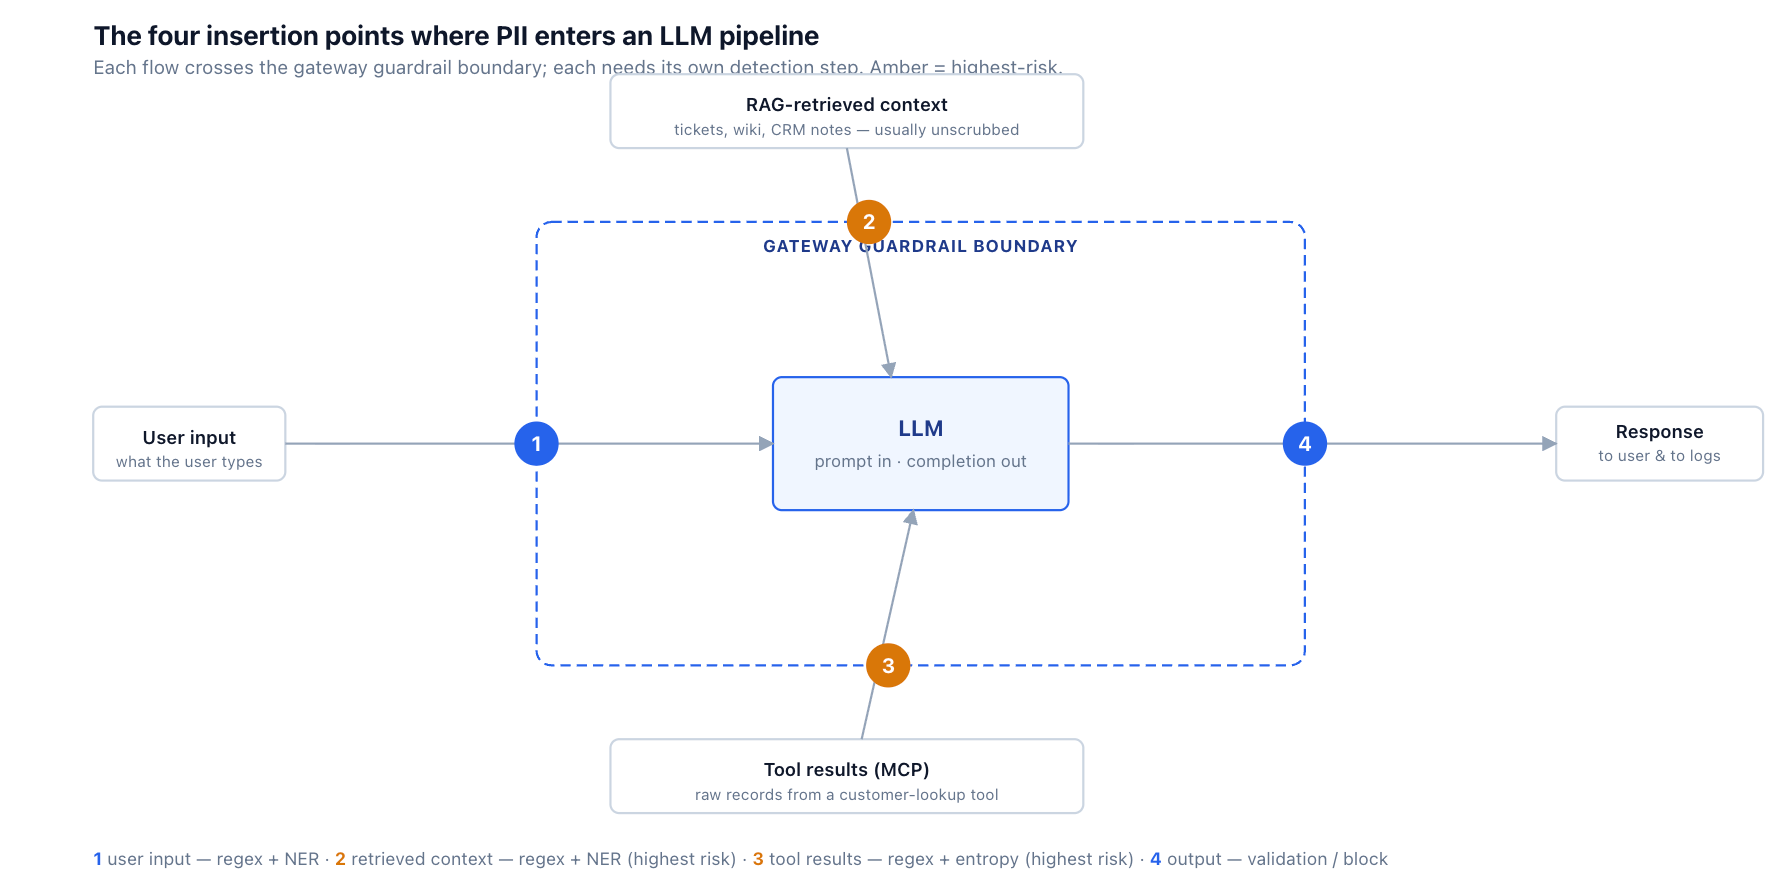
Vroegtijdig is één verduidelijking de moeite waard om te maken, omdat de getallen verwarrend overeenkomen: deze vier invoegpunten zijn een dreigingsmodel — ze beschrijven waar gevoelige gegevens de pipeline binnendringen. Ze zijn niet hetzelfde als de vier guardrail hooks die een gateway biedt om een controle uit te voeren (in het geval van TrueFoundry: LLM-input, LLM-output, MCP pre-tool en MCP post-tool). De twee benaderingen overlappen elkaar, maar komen niet één-op-één overeen. Gebruikersinvoer en opgehaalde context komen beide aan in de prompt, dus beide worden opgevangen bij de LLM-input hook; tool-resultaten worden opgevangen bij de MCP post-tool hook; model-output bij de LLM-output hook. De MCP pre-tool hook beveiligt wat de agent naar een tool verstuurt — een ander punt van zorg (SQL-injectie, argumentvalidatie) dat helemaal geen PII-invoegpunt is. Invoegpunten gaan over waar u moet kijken; hooks gaan over waar u kunt staan om te kijken.
De moeilijkheidsgraad van detectie volgt de structuur van de data. Drie klassen:
Gestructureerde PII heeft een deterministisch formaat dat met een reguliere expressie kan worden gematcht. BSN's (drie cijfers, twee cijfers, vier cijfers in de VS), creditcardnummers, telefoonnummers, e-mailadressen. Creditcards verdienen een kanttekening: "zestien cijfers" is een vereenvoudiging, niet de detector — kaartnummers variëren per netwerk (American Express is vijftien cijfers, andere verschillen in lengte en voorvoegsel), dus productie-detectie combineert netwerkspecifieke voorvoegsel- en lengteregels met een checksum zoals Luhn. De checksum is belangrijk: het verandert "een numerieke reeks" in "een aannemelijk geldig kaartnummer", waardoor het aantal vals-positieven op order-ID's en trackingnummers wordt verminderd.
Semi-gestructureerde PII heeft een herkenbare vorm, maar is geen vast patroon. API-sleutels, OAuth-tokens, AWS-toegangssleutels (het AKIA-voorvoegsel gevolgd door zestien tekens), PEM-gecodeerde private key-blokken. Twee signalen vangen deze op: een voorvoegsel- of scheidingstekenpatroon (AKIA…, -----BEGIN PRIVATE KEY-----) en hoge entropie — een reeks tekens die er willekeurig uitziet in plaats van taalkundig.
Ongestructureerde PII heeft helemaal geen patroon: persoonsnamen, fysieke adressen, geboortedata in lopende tekst. Er is geen reguliere expressie voor "is dit token de naam van een persoon", omdat een naam gewoon woorden zijn, en hetzelfde woord in de ene zin een naam is en in de andere niet. "April" is een naam en een maand. "Penny" is een naam en een muntstuk. Alleen context biedt duidelijkheid, en daarom vereist deze klasse een model — named-entity recognition (NER) of een LLM — en geen patroon.
Eén taxonomienotitie die van belang is voor compliance-taal: PII is strikt genomen informatie die een natuurlijk persoon identificeert. Organisatienamen, leveranciersnamen en interne projectnamen zijn vaak gevoelige zakelijke identificatoren die het waard zijn om te redacteren vanwege vertrouwelijkheid, maar het is niet inherent PII — een organisatienaam wordt alleen persoonsgegevens in specifieke contexten (een eenmanszaak, een praktijk van één persoon, werkgeversinformatie gekoppeld aan een genoemd individu). Ze vallen vanuit een tools-perspectief in dezelfde ongestructureerde detectie-emmer als persoonsnamen, maar het samenvoegen van de twee nodigt uit tot een terecht bezwaar op het gebied van privacywetgeving. Deze post behoudt het engineeringpunt (beide hebben NER-klasse detectie nodig) terwijl de categorieën gescheiden blijven.
Voorbeelden per categorie — waarom regex de eerste twee dekt en de derde niet
Een productie-detector is een keten van lagen, geordend van goedkoopst naar duurst. Elke laag behandelt wat de goedkopere lagen niet kunnen.
De logica van de keten: voer Laag 1 en 2 altijd uit — ze zijn goedkoop en vangen de gestructureerde PII en geheimen met het hoogste risico met hoge betrouwbaarheid op bij goed geformatteerde invoer (met de kanttekeningen over formaatvarianten uit de volgende sectie). Voer Laag 3 (NER) uit wanneer namen en adressen van belang zijn, wat voor de meeste klantgerichte workloads altijd het geval is. Reserveer Laag 4 voor workloads waar de compliance-norm de latentie en kosten per call echt rechtvaardigt — gereguleerde gezondheidszorg- en financiële documenten, waar het missen van een domeinspecifieke identificator een meldenswaardig datalek is. Het uitvoeren van Laag 4 op elk verzoek is een veelvoorkomende en dure fout; de meeste verzoeken worden volledig afgehandeld door de eerste drie lagen.
Één implementatiedetail over Laag 4: sommige externe API's (het real-time pad van AWS Comprehend bijvoorbeeld) retourneren entiteitsoffsets en betrouwbaarheidsscores in plaats van een kant-en-klaar geredacteerde string, en hun ingebouwde redactie kan een asynchrone batchbewerking zijn. Voor inline gateway-gebruik roept u doorgaans detectie aan, ontvangt u de spans en voert u de vervanging zelf uit — dus de gateway blijft eigenaar van offset-afhandeling, vervanging en beleidsgedrag, zelfs wanneer een derde partij de detectie uitvoert.
Microsofts open-source Presidio is een veelgebruikt voorbeeld van deze gelaagde aanpak — vooraf gedefinieerde en aangepaste herkenners, regex, op regels gebaseerde logica, checksums, een NER-model en hooks voor externe PII-detectiemodellen — en de meeste guardrail-implementaties in gateways, waaronder die van TrueFoundry, bouwen voort op hetzelfde gelaagde idee.
Twee fundamenteel verschillende dingen om te doen wanneer PII wordt gedetecteerd:
Mutatiemodus herschrijft de data en laat het verzoek doorgaan. "Jan Jansen bij Goldman Sachs" wordt "[PERSON] bij [ORG]", en de geredacteerde prompt gaat door naar het model. Dit is de juiste modus voor invoerhygiëne — opschonen van de prompt zodat het model de PII in de eerste plaats nooit ziet.
Validatiemodus detecteert PII en blokkeert het verzoek volledig, waarbij een foutmelding wordt geretourneerd. Er wordt niets herschreven; het verzoek mislukt. Dit is de juiste modus voor output-compliance, waar het beleid is dat elke PII in een antwoord een scheiding is — bijvoorbeeld een antwoord dat bestemd is voor een logging-pipeline die PII-vrij moet blijven.
Voorbeeld van een beleidsreactie — blokkering in validatiemodus (exacte statuscode en vorm zijn gateway-specifiek)
De twee combineren op een natuurlijke manier in één pipeline: mutatie bij de invoer (de prompt opschonen), validatie bij de uitvoer (elk antwoord blokkeren dat nog PII bevat). Het zijn geen alternatieven; ze beantwoorden verschillende vragen.
De nuttige benadering in productie is niet dat één detector de "beste" is — het is dat elke detector een gebied heeft waar hij betrouwbaar is en een karakteristieke manier waarop hij faalt. Rapporteerde precisie- en recall-getallen in de PII-literatuur schommelen sterk per dataset, taal, domein, annotatiebeleid en het vergelijkingscriterium voor span vs token, dus een enkel getal is zelden een eigenschap van de methode. Wat stabiel is over onderzoeken heen, is de vorm van de sterke punten en faalmodi:
Twee patronen blijven overeind bij vrijwel elke gepubliceerde vergelijking. Ten eerste is regex op gestructureerde identificatoren met een stabiele syntaxis de sterkste en goedkoopste eerste lijn — voor BSN's, e-mails, telefoonnummers en bekende credential-formaten — en het zwakst wanneer de identificator is geherformatteerd, geobfusceerd, gedeeltelijk is of contextafhankelijk is. Ten tweede zijn NER en PII-API's sterker voor namen, adressen en tekstachtige identificatoren, maar introduceren ze vals-positieven en domeindrift: een naamdetector die is getraind op algemeen Engels mist namen in andere talen, merkt vermeldingen van producten en organisaties te vaak aan als mensen, en gedraagt zich anders in supporttickets, medische notities en logbestanden. Het onderzoek naar de SPY-dataset toonde aan dat toegewijde NER-modellen in PII-contexten te veel taggen — hoge recall, lagere precisie — wat de vals-positieve kant is van precies dit patroon.
Het veilige standpunt voor productie volgt daaruit: benchmark op een representatieve steekproef van uw eigen verkeer voordat u blokkeerdrempels instelt, stem drempelwaarden af per entiteitstype, en gebruik verschillende acties voor verschillende betrouwbaarheidsniveaus — redacteer duidelijke gestructureerde identificatoren, blokkeer uitvoerlekken met een hoge betrouwbaarheid, en audit dubbelzinnige detecties voordat u handhaaft.
Redactie is per definitie met informatieverlies, en het verlies vernietigt soms de informatie waarvan de taak afhankelijk was. Neem het volgende in overweging:
Hoe naïeve redactie de betekenis laat vervallen
De geredacteerde prompt is nu dubbelzinnig op een manier die het origineel niet was. Het model kan niet zien welke [PERSON] de bron is en welke de bestemming — de twee verschillende mensen zijn samengevallen in hetzelfde token. Een model dat wordt gevraagd hierop te reageren zal raden, en een bankoverschrijving is een slechte plek om te raden.
Drie oplossingen, in toenemende volgorde van functionaliteit en kosten:
Unieke placeholders. Vervang door [PERSON_1], [PERSON_2], [ORG_1] in plaats van een generieke tag. Dit behoudt het onderscheid — het model weet dat de twee mensen verschillend zijn, zelfs als het niet weet wie ze zijn. Goedkoop en meestal voldoende.
Een sessie-redactiemap. Onderhoud een koppeling van placeholder naar de oorspronkelijke waarde, gescopet op de sessie, zodat de uitvoer kan worden gederedacteerd voordat deze terugkeert naar een geautoriseerde gebruiker — "[PERSON_1]" in het antwoord van het model wordt op de terugweg weer "Jan Jansen".
De harde limiet op de-redactie. U kunt alleen de-redacteren naar een bestemming die even vertrouwd is als de oorspronkelijke bron. Als de uitvoer wordt gelogd, zet de-redacteren de PII terug in de logs — wat het doel van de redactie tenietdoet. Als de uitvoer naar een gebruiker gaat die niet gemachtigd is om de PII te zien, is de-redactie een onthulling. De-redactie werkt alleen wanneer het vertrouwensniveau van het eindpunt overeenkomt met dat van de invoer; anders moet de placeholder blijven staan.
En de redactiemap zelf is gevoelige infrastructuur. Een sessiemap die [PERSON_1] → Jan Jansen opslaat, is per definitie een PII-opslag — het heeft dezelfde controles nodig als de data die het beschermt: encryptie at rest, een korte TTL, strikte sessie-scoping, audit-logging bij elke de-redactie en autorisatiecontroles vóór elke omgekeerde opzoeking. Een redactielaag die zijn maps onzorgvuldig bewaart, heeft zojuist een tweede PII-database gemaakt, vaak een die minder goed wordt beheerd dan het systeem dat het beschermde.
Bij een representatieve payload — een prompt van 500 tokens met een paar PII-entiteiten — liggen de lagen ruw weg een orde van grootte uit elkaar (dit zijn illustratieve cijfers op typische hardware; echte getallen hangen af van modelgrootte, batching en netwerk):
Het belangrijkste architectonische feit: een mutatie-guardrail draait synchroon vóór het modelverzoek, omdat de prompt moet worden herschreven voordat deze wordt verzonden. Die latentie wordt direct opgeteld bij de time-to-first-token. Een controle via een externe API van 180 ms op de invoer voegt 180 ms toe aan de TTFT van elk verzoek — bovenop de eigen latency voor het eerste token van het model.
Dit is waarom de volgorde van de lagen een prestatiebeslissing is, en niet alleen een beslissing over nauwkeurigheid. Houd regex en entropie overal inline; ze zijn gratis vergeleken met de modellatentie. Plaats NER alleen inline waar namen van belang zijn. Voor de externe API geldt: reserveer deze voor de workloads waarvan de compliance-norm een vijfde van een seconde aan extra TTFT rechtvaardigt, of pas deze toe op het uitvoerpad waar de latentie het eerste token van de gebruiker niet blokkeert.
De parallellisatie die hier helpt is specifiek, en draait aan de invoerkant, niet aan de uitvoerkant. Invoer-validatie (detecteren-en-mogelijk-blokkeren, geen herschrijving) kan gelijktijdig met het modelverzoek draaien — de gateway start beide en annuleert de model-call als de validatie mislukt, dus in het ideale scenario voegt de controle geen latentie toe aan het eerste token. Invoer-mutatie kan niet parallel worden uitgevoerd, omdat het model de reeds opgeschoonde prompt moet ontvangen, dus de kosten worden direct opgeteld. Output-guardrails zijn het lastigere geval: ze hebben de volledige respons nodig om te evalueren, wat de reden is dat de gateway van TrueFoundry bijvoorbeeld output-guardrails volledig overslaat bij streaming-antwoorden (stream: true) en stream: false vereist als u wilt dat ze draaien. De algemene les is dat "de respons annuleren na het detecteren van PII" geen veilig ontwerp is voor streaming — zodra een chunk naar de client of naar een log is gestreamd, is annuleren te laat. Streaming output-redactie is een heel eigen ontwerpprobleem: buffer de respons en scan vóór vrijgave (waarmee het voordeel van streaming-latentie vervalt), of scan chunks met een bewuste vertraging, of accepteer dat handhaving plaatsvindt na gedeeltelijke onthulling.
Geen van beide lagen is universeel de juiste. De beslissing hangt af van wie de context heeft en wie het resultaat nodig heeft.
In de praktijk gebruiken de meeste volwassen setups beide, opgesplitst per PII-klasse in plaats van het kiezen van één laag. De gateway behandelt de gestructureerde PII en geheimen — universeel, goedkoop, met een hoog risico, overal hetzelfde — op alle vier de invoegpunten. De applicatie behandelt de contextafhankelijke semantische gevallen waarbij alleen de applicatie weet wat als gevoelig geldt. De verdeling is niet gateway-versus-applicatie; het is gestructureerd-en-universeel bij de gateway, en contextafhankelijk in de applicatie.
De situatie die zomaar kan optreden is een duidelijk gateway-geval: een opgehaald BSN is gestructureerde PII, gevaarlijk in elke context, en komt binnen op een punt dat geen enkele individuele applicatie beheert. Dat is precies de klasse die de gateway op alle vier de punten zou moeten opvangen.
Maar het is belangrijk om helder te hebben dat redactie tijdens de request-tijd de laatste verdedigingslinie is voor RAG, niet de eerste. Het strakkere architectonische antwoord op de situatie uit de inleiding ligt stroomopwaarts: de ingestie-pipeline moet documenten en chunks al tijdens de indexeringstijd classificeren op PII, gevoeligheidsmetadata vastleggen en retrieval beperken op basis van de autorisatie van de aanvragende gebruiker — zodat een ticket van een klant waarin een BSN staat óf wordt opgeschoond vóór de indexering, óf nooit kan worden opgehaald naar een context die dit niet mag zien. Gateway-redactie vangt de gevoelige tekst op die ondanks dat alles nog steeds de prompt bereikt; het mag niet de enige controle zijn die tussen een vervuilde index en het model staat. Een pipeline die uitsluitend vertrouwt op de gateway om een slecht beheerde index op te schonen, is slechts één fout in de detector verwijderd van het incident dat het juist had moeten voorkomen.
Verslechtert redactie de kwaliteit van de model-output niet?
Tot op zekere hoogte wel — het probleem van semantische vervorming in sectie 6 is daar de oorzaak van. Generieke placeholders die verschillende entiteiten samenvoegen, verminderen het vermogen van het model om te redeneren over de prompt. Unieke placeholders ([PERSON_1], [PERSON_2]) beperken dit grotendeels. Voor workloads met veel PII zijn enkele kwaliteitsconcessies de prijs voor compliance; het technische doel is om dit te minimaliseren, niet om te doen alsof het nultarief is.
Kunnen we niet gewoon een LLM gebruiken om PII te detecteren?
Dat kan, en een LLM-detector heeft de hoogste nauwkeurigheid op contextafhankelijke PII (het begrijpt "de naam van de patiënt is" op een manier die regex en zelfs NER niet begrijpen). De kosten: een volledige modelaanroep aan extra latency en uitgaven, en — belangrijk — de detector-model ziet nu de PII, wat op zichzelf een compliance-vraagstuk kan zijn, afhankelijk van waar dat model draait. Het is in feite een duurdere, nauwkeurigere Tier 4, geschikt voor situaties waarin de complexiteit van het document dit rechtvaardigt.
Hoe zit het met false positives die legitieme requests blokkeren?
Dit is het grootste risico van de validation mode, en het overmatig markeren door NER (sectie 5) maakt dit heel reëel — een organisatie- of productnaam die verkeerd wordt gelezen als een persoon kan een geldig request blokkeren. Pas de confidence threshold per categorie aan, log en beoordeel blokkades, en bied een override-pad voor geautoriseerde gebruikers. Een blocker die te agressief is, leert gebruikers om eromheen te werken, wat erger is dan een gecalibreerde blocker.
Hoe verhoudt redactie zich tot de tracing- en kostenartikelen uit eerdere posts?
Elk redactie-event zendt een span attribute uit dat vastlegt welke categorieën zijn gedetecteerd, door welke tier, en of de actie een mutatie of een blokkade was — zonder de PII zelf op te slaan. Dat levert een gecentraliseerde audit trail op (wat er is geredigeerd, wanneer en op welke route) die kan worden toegewezen aan de team- en app-metadata uit de cost-attribution post. Zie onze posts over OpenTelemetry for LLMs en Cost Attribution.
Werkt dit ook voor niet-Engelstalige PII?
Gedeeltelijk, en het is een reële tekortkoming. NER-modellen zijn taalspecifiek; een model dat is getraind op Engels detecteert namen en adressen in andere talen en schriftsoorten minder goed. Multi-language compliance vereist óf NER-modellen per taal óf externe API's die meerdere talen ondersteunen — en de nauwkeurigheid is over het algemeen lagere voor talen met minder beschikbare data. Het is de moeite waard om dit expliciet te testen in plaats van ervan uit te gaan dat de Engelse cijfers direct overvloeien.
Waar past TrueFoundry in dit plaatje?
De AI Gateway van TrueFoundry voert guardrails uit op de vier hooks — LLM input, LLM output, MCP pre-tool, MCP post-tool — in zowel validate (block) als mutate (rewrite) mode. Specifiek voor PII biedt het meerdere opties in plaats van slechts één: een ingebouwde PII/PHI-detectie guardrail aangedreven door Azure AI Language (SaaS), een ingebouwde Regex Pattern Matching guardrail die in-gateway draait zonder externe aanroep (presets voor kaarten, BSN's en credentials plus custom patterns), een ingebouwde Secrets Detection guardrail voor sleutels en tokens, en integraties met externe providers (Azure PII bring-your-own-key, CrowdStrike en anderen) of custom guardrails gebouwd met Guardrails.AI of een Python-functie. De juiste configuratie hangt af van de vraag of een route mutatie of blokkering nodig heeft, lokale uitvoering of provider-ondersteunde detectie, en SaaS of self-hosted deployment. De keuze tussen gateway versus applicatie in sectie 8 blijft bij de operator; de gateway levert de gecentraliseerde tier voor gestructureerde PII en secrets, en de applicatie behoudt de contextafhankelijke gevallen waarvoor alleen zij de informatie heeft om te oordelen.
De goedkoopste eerste stap met de hoogste impact is degene die de inleiding nodig had: regex op gestructureerde PII op alle vier de invoegpunten, niet alleen de gebruikersinvoer. Het is snel en goedkoop, uiterst effectief op goed geformatteerde identificatoren zoals het eenvoudig opgehaalde BSN in de inleiding, en de juiste eerste laag voor duurdere contextbewuste detectoren — hoewel zelfs regex representatieve testdekking nodig heeft voor formatvarianten en false positives. De duurdere tiers komen op de tweede plaats, bij de workloads waarvan de compliance-lat de latency rechtvaardigt.
Northwind, Reza en het incident met de support-agent dienen ter illustratie; het dreigingsmodel met vier invoegpunten, de kenmerken van de detectietiers en de patroonkenmerken voor nauwkeurigheid en latency weerspiegelen het gepubliceerde gedrag van regex, NER (Presidio-klasse) en externe PII-API's vanaf mei 2026. Sterke punten en foutmodi van detectoren zijn ontleend aan de kwalitatieve patronen die in de geciteerde onderzoeken zijn gerapporteerd, niet aan een enkele benchmark-run; de precieze precision en recall variëren sterk afhankelijk van de dataset, het domein, de taal, het annotatiebeleid en het matchingscriterium, wat de reden is waarom het artikel aanbeveelt om te benchmarken op representatief verkeer voordat drempelwaarden worden ingesteld. Latency-cijfers zijn een indicatie van de grootteorde op typische hardware en hangen af van de modelgrootte, batching, regio en het netwerkpad.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















