



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De eerste neiging bij een nieuwe Claude-build is om alles naar het meest geavanceerde model te sturen en verder te gaan. Het werkt, maar u betaalt ongemerkt te veel, omdat de meeste requests het hoogste niveau niet nodig hebben. De tegenovergestelde neiging — standaardiseren op het goedkoopste model — schiet tekort bij de requests die het product daadwerkelijk dragen. Het juiste antwoord is geen van beide: stem het model af op de moeilijkheidsgraad van elke request, en maak van die match een configuratie in plaats van een regel code.
Deze gids beschrijft de huidige Claude-niveaus op basis van kosten en capaciteit, biedt een praktische koppeling van taaktype naar niveau, en laat zien hoe u per taak kunt routen via een gateway, zodat de beslissing omkeerbaar en meetbaar is. Prijzen en positionering hieronder zijn afkomstig uit Anthropic’s models overview, per oktober 2026; modelaanbod verandert, dus beschouw de exacte tarieven als een momentopname en controleer deze op de prijzenpagina van Anthropic voordat u een budget opstelt.
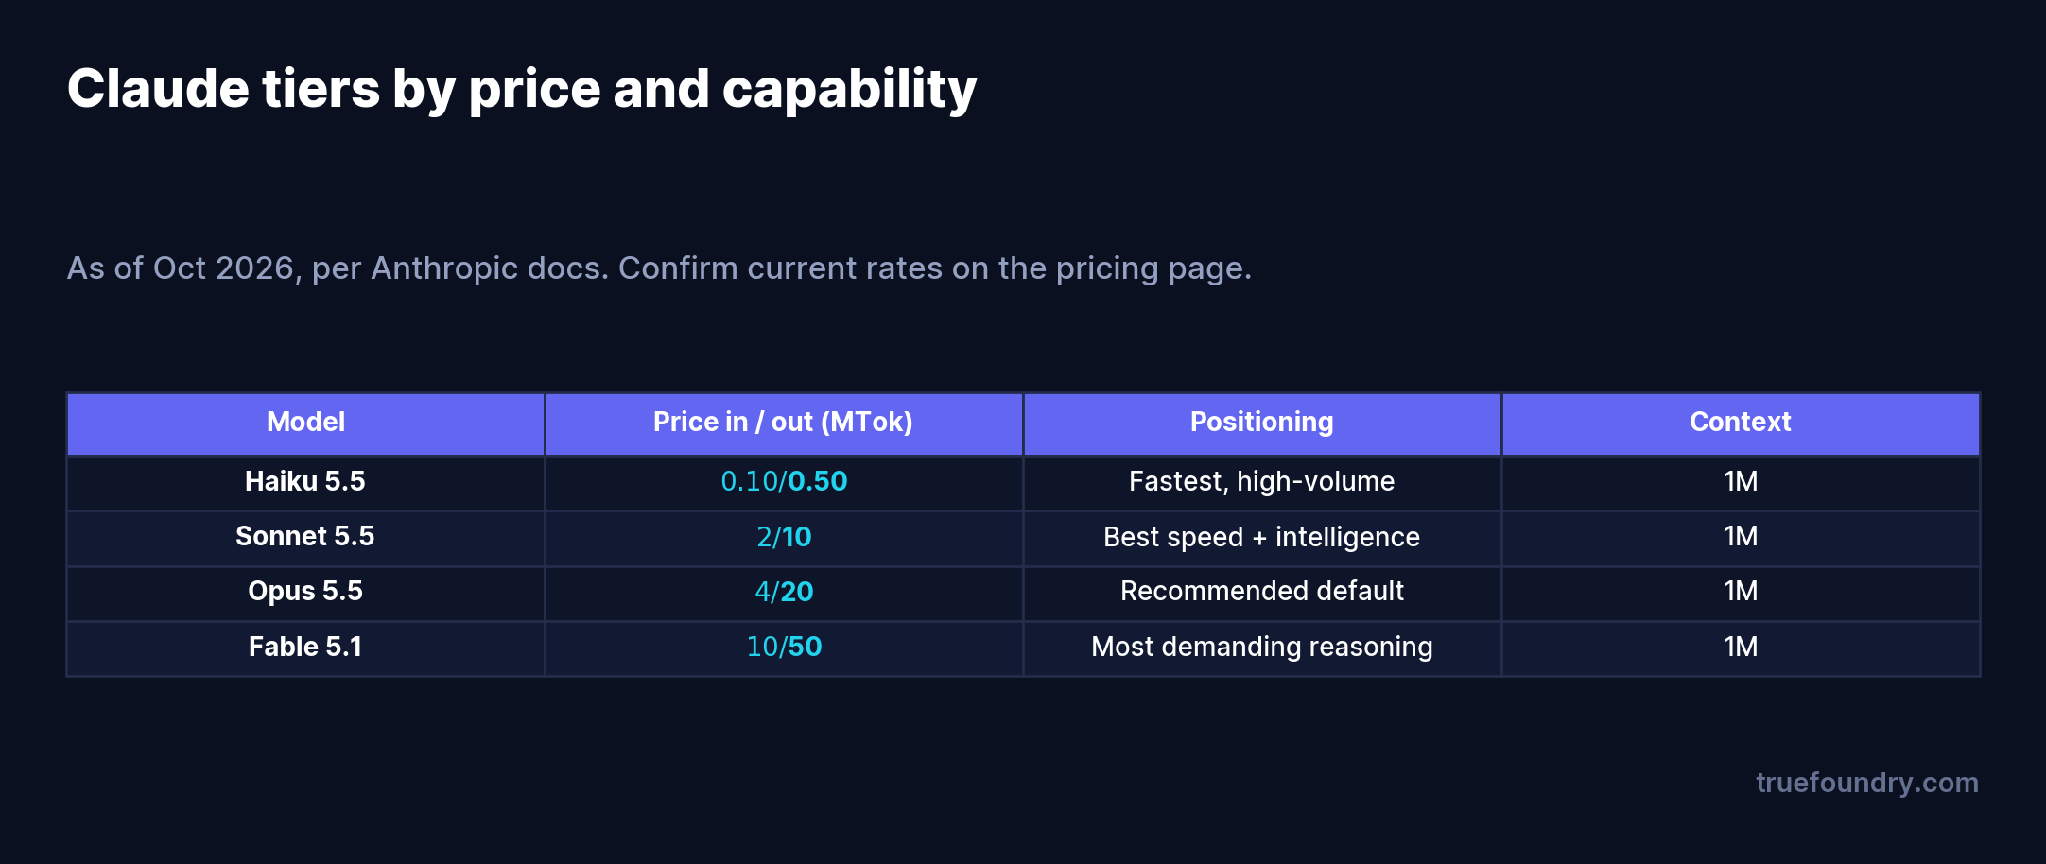
Vier niveaus, één contextvenster. Haiku 5.5 is het snelst en goedkoopst, gebouwd voor latency-gevoelige taken met een hoog volume. Sonnet 5.5 is gepositioneerd als de beste combinatie van snelheid en intelligentie. Opus 5.5 is de aanbevolen standaard voor de meeste workloads, met een gematigde latency. Fable 5.1 staat boven al deze modellen voor veeleisende redeneringen en agentic werk over een lange horizon — en is zowel de traagste als, met $10 / $50 per miljoen tokens, de duurste. Elk niveau deelt het contextvenster van 1M tokens en de kennisgrens van juni 2026, wat betekent dat u bijna nooit een niveau kiest vanwege de contextruimte; u kiest het op basis van hoe moeilijk de taak is en hoe snel u het antwoord nodig hebt.
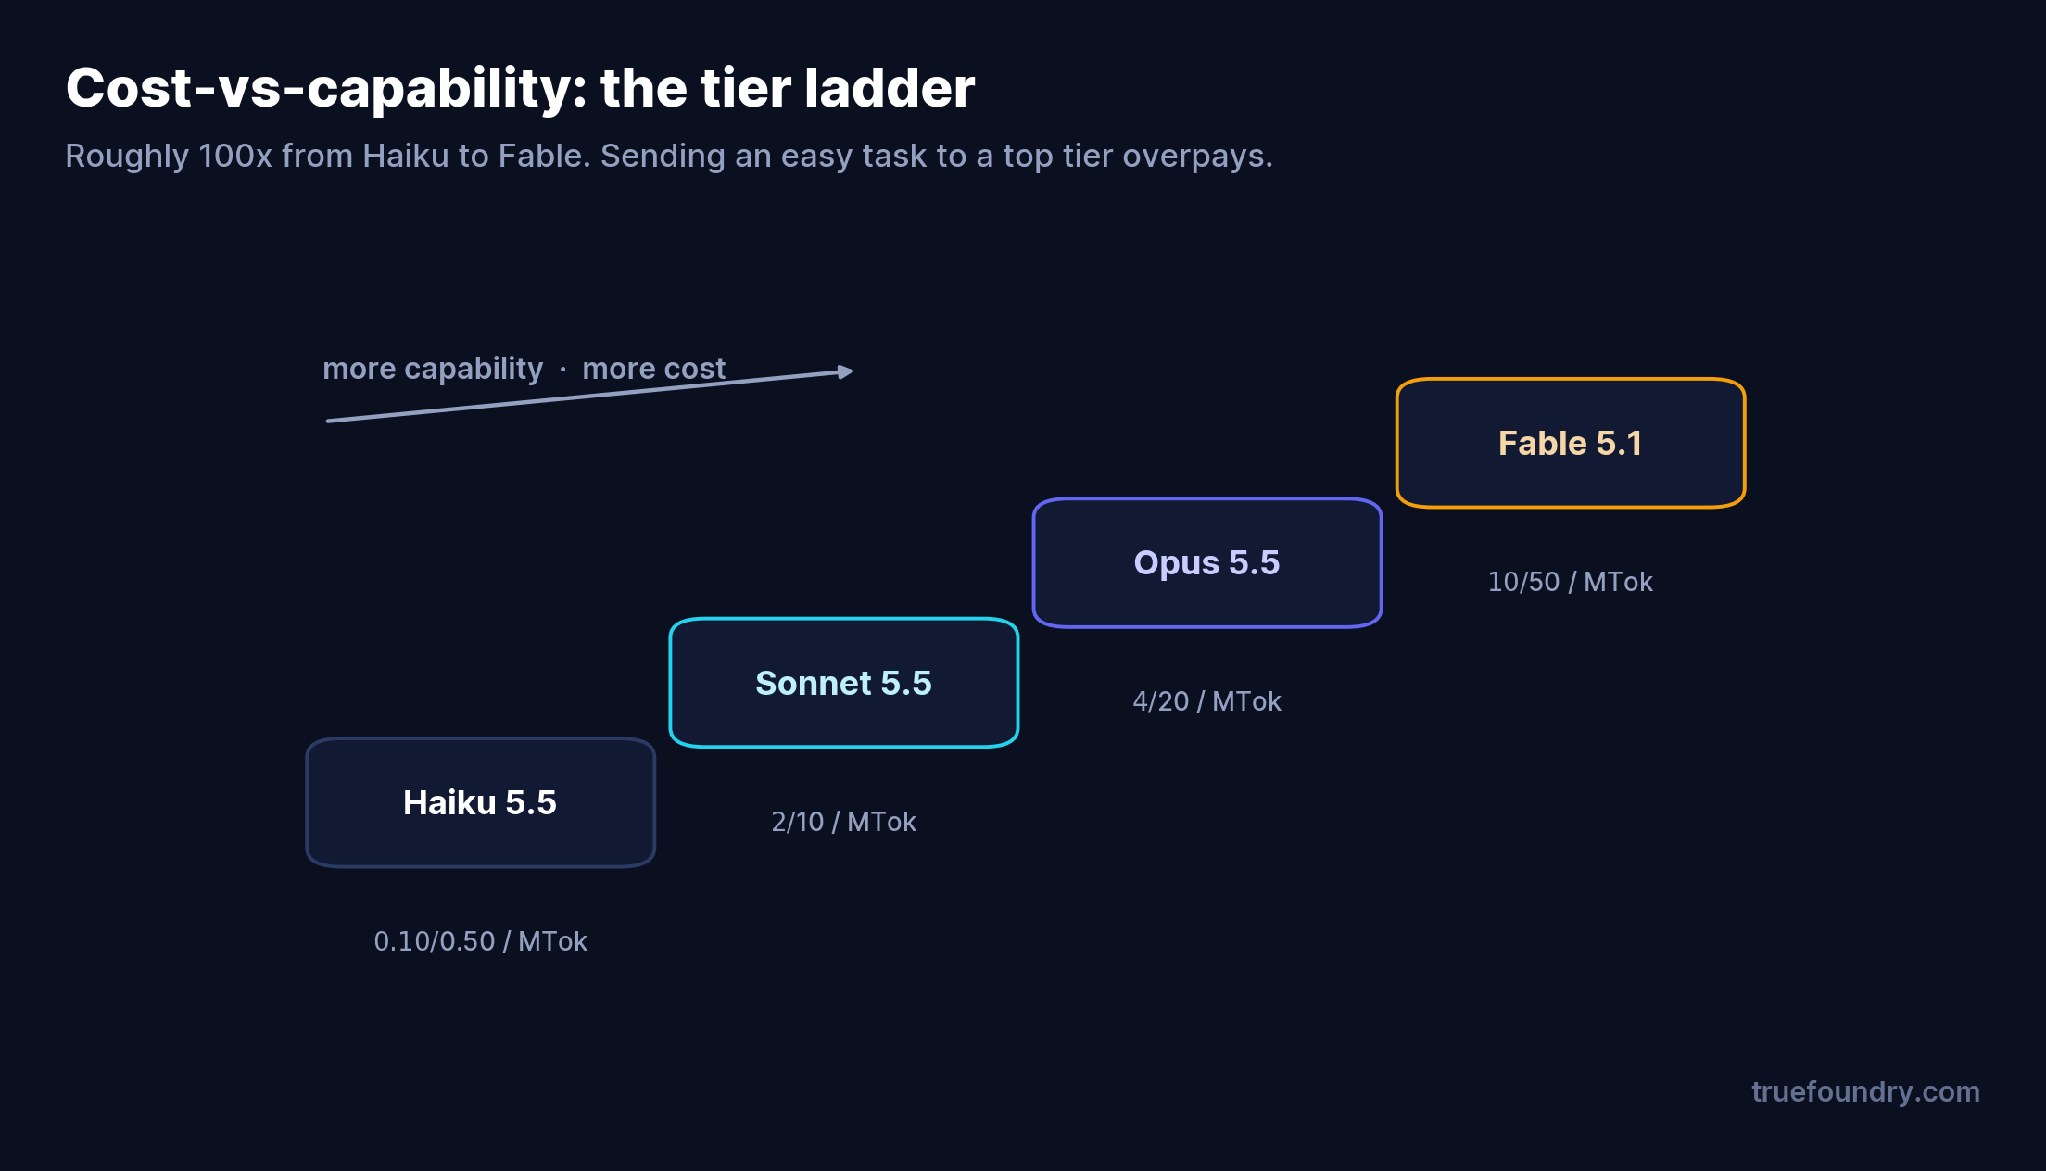
De stap van Haiku naar Fable is ongeveer 100x op de inputprijs en 100x op de output. Die spreiding is het hele argument voor routing: het sturen van een taak van Haiku-formaat naar Fable is geen afrondingsfout, het is een 100x overschrijding van de uitgaven voor die request.
Capaciteitsniveaus laten zich strak koppelen aan de moeilijkheidsgraad van de taak. Gebruik dit als een eerste uitgangspunt en pas het aan op basis van uw eigen evals.
Haiku verwerkt het afgebakende werk met een hoog volume: classificatie, routing en triage, extractie en tagging, korte herschrijvingen, eenvoudige gestructureerde output en de “is dit relevant?”-filters in een RAG-pipeline. Dit zijn taken waarbij een kleiner model geen compromis is — het is het juiste hulpmiddel, en de prijs en latency zijn de essentie.
Sonnet is het werkpaard voor de meeste productiefunctionaliteiten: opstellen en bewerken, samenvatten met nuance, standaard toolgebruik en function calling, code van alledaagse complexiteit, en stapsgewijze maar niet open-ended redeneringen. Als u twijfelt, begin dan hier en meet de resultaten.
Opus is de standaard wanneer kwaliteit er duidelijk toe doet: complexere redeneringen, langere tool-ketens, ingewikkelde code en taken waarbij een verkeerd antwoord kostbaar is. Als de aanbevolen standaard is het ook een veilige baseline om naar op te schalen vanaf Sonnet.
Fable is voor de echt complexe gevallen — diepgaande redeneringen, agentic workflows over een lange horizon die vele stappen aan elkaar koppelen — waar de extra capaciteit de 100x hogere prijs terugverdiend omdat een goedkoper model simpelweg faalt bij de taak. Het is een scalpel, geen standaard.
Het praktische patroon is een goedkope standaard met een escalatiepad: voer de taak uit op Haiku of Sonnet, en escaleer alleen naar Opus of Fable wanneer een betrouwbaarheidssignaal, een validatiecheck of het taaktype dat vereist.
De reden dat de meeste teams te veel betalen is architecturaal: de modelnaam is een string in de applicatiecode, dus het wijzigen ervan vereist een deploy, en het afstemmen van het model op de taak per request is meer dan iemand handmatig wil onderhouden. Een gateway neemt die wrijving weg.
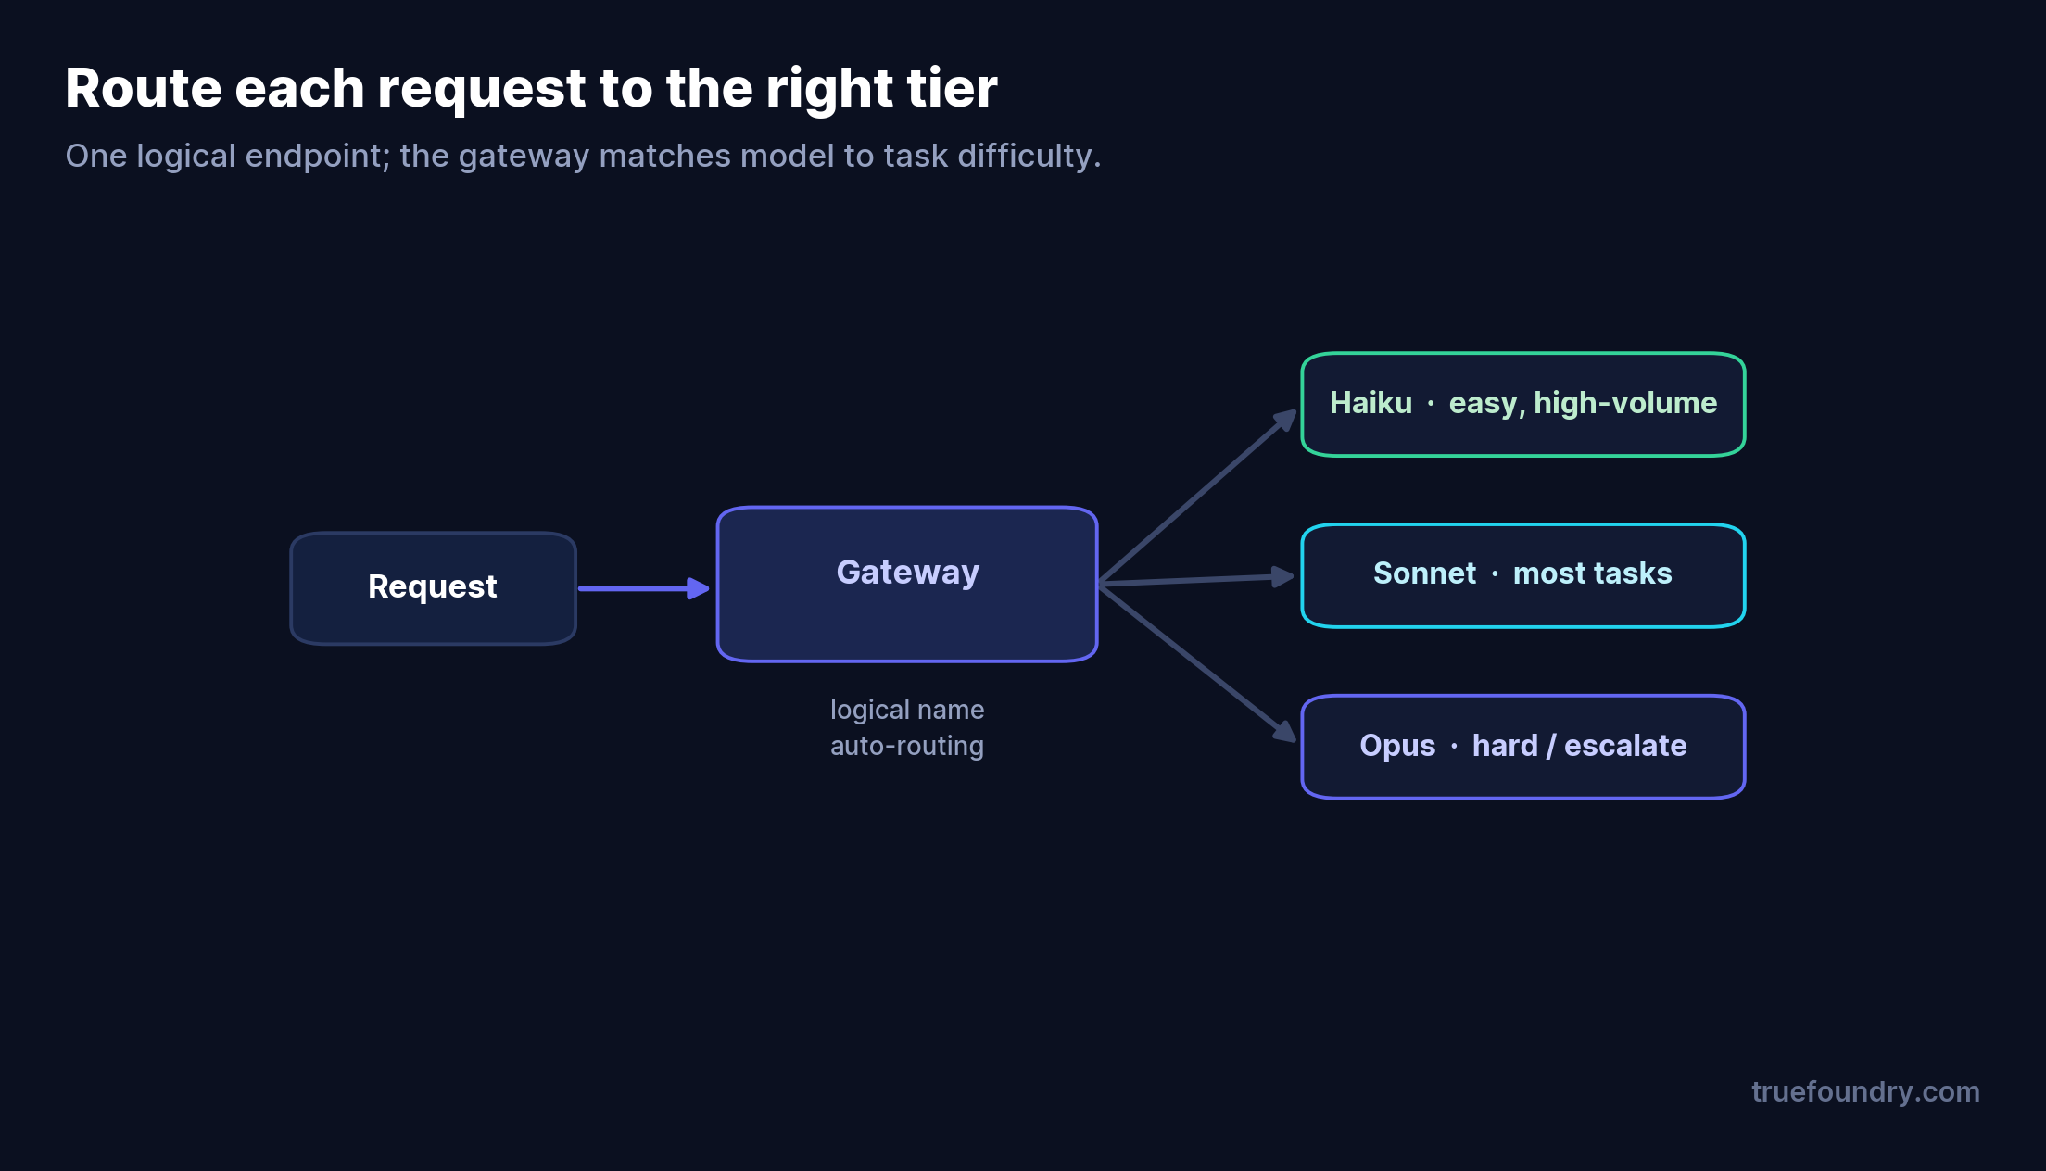
Richt uw applicatie op een logische modelnaam die wordt ondersteund door een echt niveau, en u kunt wijzigen welk niveau deze bedient — of het verkeer verdelen over niveaus — zonder de code aan te raken. Voeg auto-routing toe, en de gateway beoordeelt elke request en stuurt deze automatisch naar een model van het juiste formaat. Hoe dan ook stuurt de applicatie één request naar één endpoint; de routingbeslissing bevindt zich in de configuratie, waar u deze kunt afstellen, testen via canary-releases en terugdraaien.
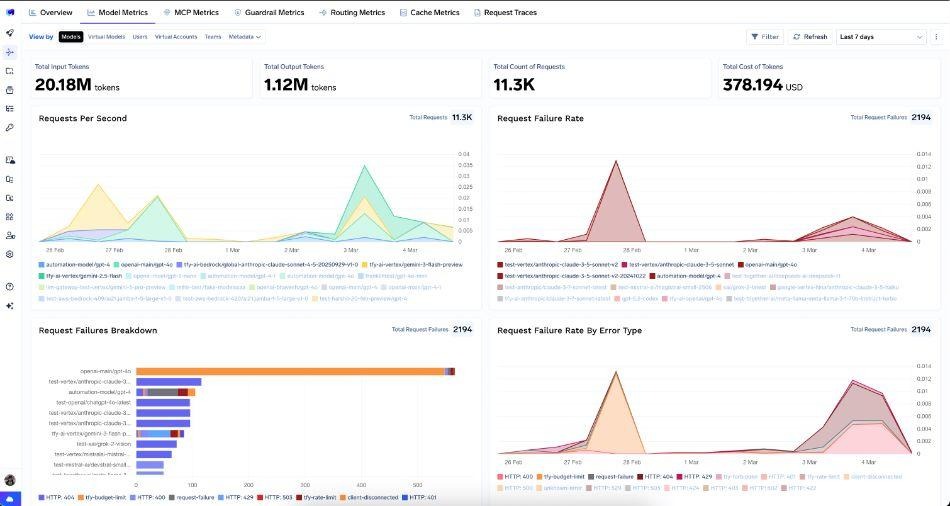
Wanneer kosten en latency per niveau zichtbaar zijn en budgetten per team zijn ingesteld, is de routingbeslissing geen gok meer. U kunt zien dat een workload die u op Opus uitvoerde de kwaliteit behoudt op Sonnet, deze verplaatsen en zien hoe de kostenlijn daalt — het soort verandering dat een configuratiewijziging van één regel is in plaats van een refactor over meerdere services.
Ze standaardiseren op één niveau. Alles op Opus betaalt te veel voor de eenvoudige meerderheid; alles op Haiku schiet tekort voor de moeilijke minderheid. Stem het niveau af op de taak.
Ze kiezen op basis van het contextvenster. Alle vier de niveaus delen 1M tokens, dus context is zelden de doorslaggevende factor. Kies op basis van redeneerdiepte en latency.
Ze programmeren de modelnaam vast in de code. Dat maakt elke routingwijziging een deploy en maakt routing per taak onpraktisch. Gebruik een logische naam zodat het niveau configuratie is.
Ze routen zonder te meten. Omschakelen naar een lager niveau om geld te besparen is alleen veilig als u de kwaliteit in de gaten houdt. Houd evals en metrieken per model ingeschakeld, en escaleer waar de kwaliteit daalt.
Een documentverwerkingsproduct voert drie stappen uit per bestand: detecteer het documenttype, extraheer velden en schrijf een samenvatting. Als alles naar Opus wordt gestuurd, betaalt elke stap het hoogste tarief. Indien gerouteerd op basis van taak, gaan typedetectie en extractie naar Haiku (afgebakend, hoog volume), de samenvatting gaat naar Sonnet (nuance zonder de Opus-toeslag), en alleen bestanden met een lage betrouwbaarheid escaleren naar Opus voor een tweede sessie. De applicatie roept één logisch endpoint aan per stap; de niveaus daarachter zijn configuratie. Het resultaat is dezelfde outputkwaliteit op de moeilijke bestanden en een aanzienlijke besparing op de eenvoudige meerderheid — zichtbaar als een kostenverdeling per model in de gateway.
De Claude-niveaus zijn ontworpen om gecombineerd te worden, niet om één keer gekozen te worden. De capaciteitscurve is steil en dat geldt ook voor de prijscurve, wat betekent dat de kosten van het sturen van een eenvoudige taak naar een topniveau — of een moeilijke taak naar een goedkoop niveau — groot en volledig vermijdbaar zijn. De juiste aanpak is om het model af te stemmen op de moeilijkheidsgraad van de taak, standaard goedkoop te beginnen en te escaleren bij het juiste signaal.
Maak van die match een configuratie in plaats van code, routeer per taak via een gateway, en houd kosten, latency en kwaliteit per niveau inzichtelijk. Dan is de vraag “welk model?” geen voortdurende discussie meer, maar een knop waaraan u per workload kunt draaien om direct het resultaat te zien.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



They are Claude tiers trading capability for price. Haiku 5.5 is the fastest and cheapest for high-volume tasks; Sonnet 5.5 balances speed and intelligence; Opus 5.5 is the recommended default for most workloads. Fable 5.1 sits above them for the most demanding reasoning. All share a 1M-token context window.
Haiku 5.5, starting around $0.10 input / $0.50 output per million tokens as of October 2026. Fable 5.1 is the most expensive at $10 / $50. Confirm current rates on Anthropic’s pricing page.
Usually not — most requests don’t need it, and the price spread from Haiku to Fable is roughly 100x. Route easy, high-volume work to cheaper tiers and reserve the top tiers for hard tasks.
Point the app at a logical model name backed by a tier, or use a gateway’s automatic routing to score each request and pick a tier. The application calls one endpoint; the routing lives in configuration.
Hier niet - alle vier niveaus delen hetzelfde contextvenster van 1 miljoen tokens. Kies op basis van redeneerdiepte en latentie, niet contextgrootte.



Het laatste nieuws, artikelen en bronnen in je inbox



















