



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De homepage van OpenRouter vermeldde voorheen dat het ongeveer 25 ms toevoegt tussen je gebruikers en hun inferentie, en veel gidsen herhalen dit cijfer nog steeds. De homepage zelf zegt nu simpelweg "minimale latency". Op Claude gemeten we meerdere keren dat het veel langer duurde voordat het eerste token aankwam, en de grootste vertraging kwam daarna.
De metingen zijn voor Anthropic: hoeveel latency OpenRouter toevoegt, waar de tijd naartoe gaat, en waarom onze eigen Anthropic-sleutel het grootste deel ervan wegnam. Eén reeks gebruikte korte prompts. De andere gebruikte prompts tot 20.000 tokens. De beperkingen van beide reeksen staan in het gedeelte over wat we niet hebben getest, en ze kaderen de cijfers evenzeer af als de medianen dat doen.
Elke request ging op drie manieren: rechtstreeks naar de API van Anthropic, via OpenRouter gefactureerd op OpenRouter-credits, en via OpenRouter met onze eigen Anthropic-sleutel (BYOK). Dezelfde prompts werden op elke route uitgevoerd, afgewisseld en met een wisselende volgorde per prompt, zodat netwerkschommelingen alle drie even hard raakten. Elke vergelijking is gepaard: elke prompt wordt vergeleken met zichzelf op een andere route, waardoor de promptinhoud wegvalt tegen het verschil.
OpenRouter-requests werden vastgezet op het eigen endpoint van Anthropic in plaats van Bedrock of Vertex, met fallbacks uitgeschakeld, en we controleerden bij elke respons welk endpoint deze had afgehandeld en of onze sleutel was gebruikt. De temperatuur was 0 en verbindingen werden hergebruikt.
Er waren twee reeksen. Op 7 september twee afzonderlijke sessies van elk 100 korte prompts, 4 tot 37 tokens lang, afkomstig uit openbare datasets. Op 14 september 99 prompts opgevuld tot drie groottes: 200 input-tokens met 100 output-tokens, 2.000 met 500, en 20.000 met 1.000. Alles werd uitgevoerd vanaf één laptop op consumenten-wifi via de edge-locatie van OpenRouter in Los Angeles. Dat verhoogt de absolute latency, dus we rapporteren alleen verschillen tussen routes, wat door de gepaarde aanpak valide is.
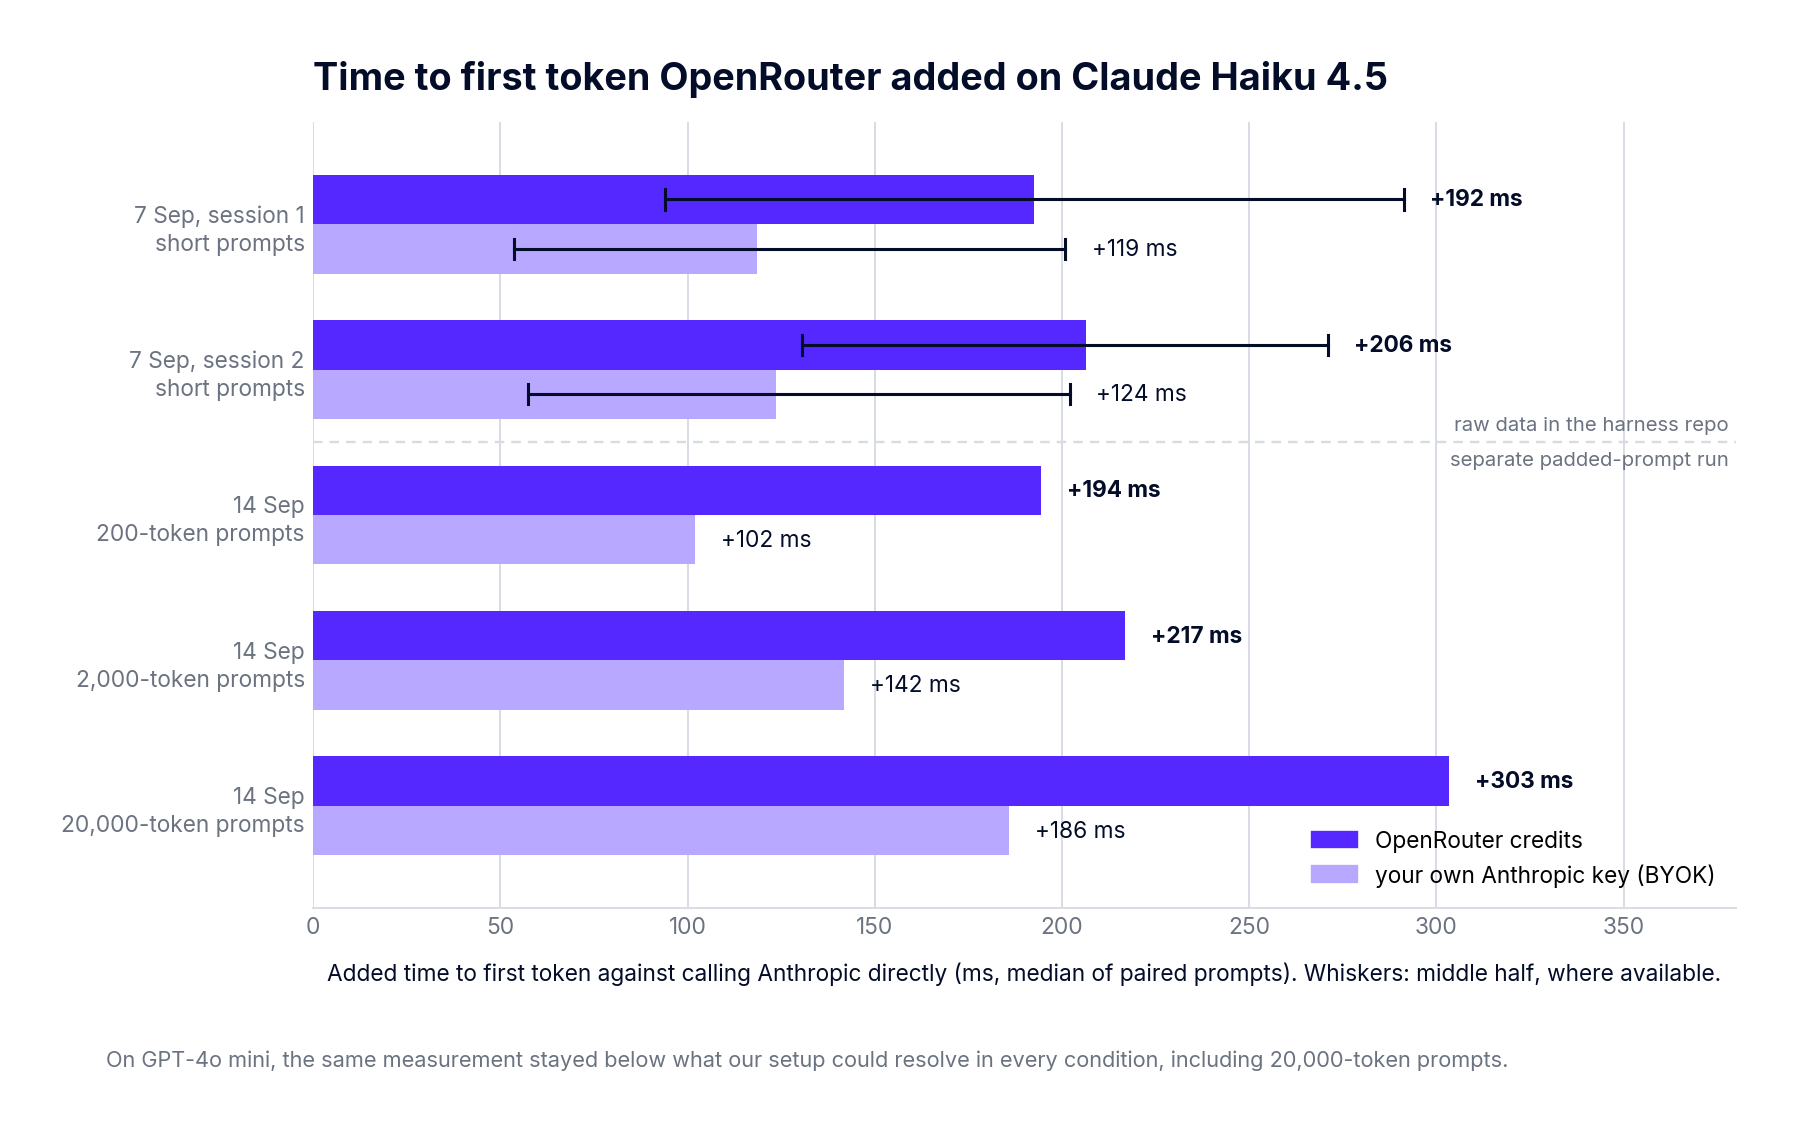
De vertraging tot het eerste token was stabiel. Op credits was dit 192 ms in de eerste sessie en 206 ms in de tweede, en 194 ms bij 200 tokens een week later. Met onze eigen sleutel was dit 119, 124 en 102 ms. Twee reeksen met een week ertussen, op verschillende promptsets, die binnen ongeveer 20 ms van elkaar liggen, is zo'n beetje de beste replicatie die een test aan de clientzijde kan bieden. In vier sessies waarin credits en onze eigen sleutel zij aan zij draaiden, was credits elke keer trager tot het eerste token, met een mediaan van 50 tot 115 ms.
Het groeit ook met de omvang van de prompt. Van 200 tot 20.000 input-tokens steeg de extra tijd tot het eerste token van 194 naar 303 ms op credits en van 102 naar 186 ms met onze eigen sleutel. De groei is sublineair, ongeveer 1,6 tot 1,8 keer voor honderd keer de invoer, en werd pas zichtbaar bij 20.000 tokens; een eerdere test die stopte bij 5.000 vond niets. Binnen de reeksen met korte prompts, waar invoer slechts varieerde van 4 tot 37 tokens, was er helemaal geen verband.
Bij GPT-4o mini bleef dezelfde meting in elke conditie binnen de ruis, inclusief prompts van 20.000 tokens. De mediane extra tijd tot het eerste token was 19.7 ms op credits, maar de middelste helft van de resultaten varieerde van 85 ms sneller tot 157 ms trager dan rechtstreeks gaan, dus het werkelijke cijfer is kleiner dan onze opstelling kan meten.
Tijd tot het eerste token is slechts een deel van een gestreamde respons. Door elke respons op te splitsen in het wachten op het eerste token en de tijd om de rest te streamen, worden twee afzonderlijke kostenposten zichtbaar.
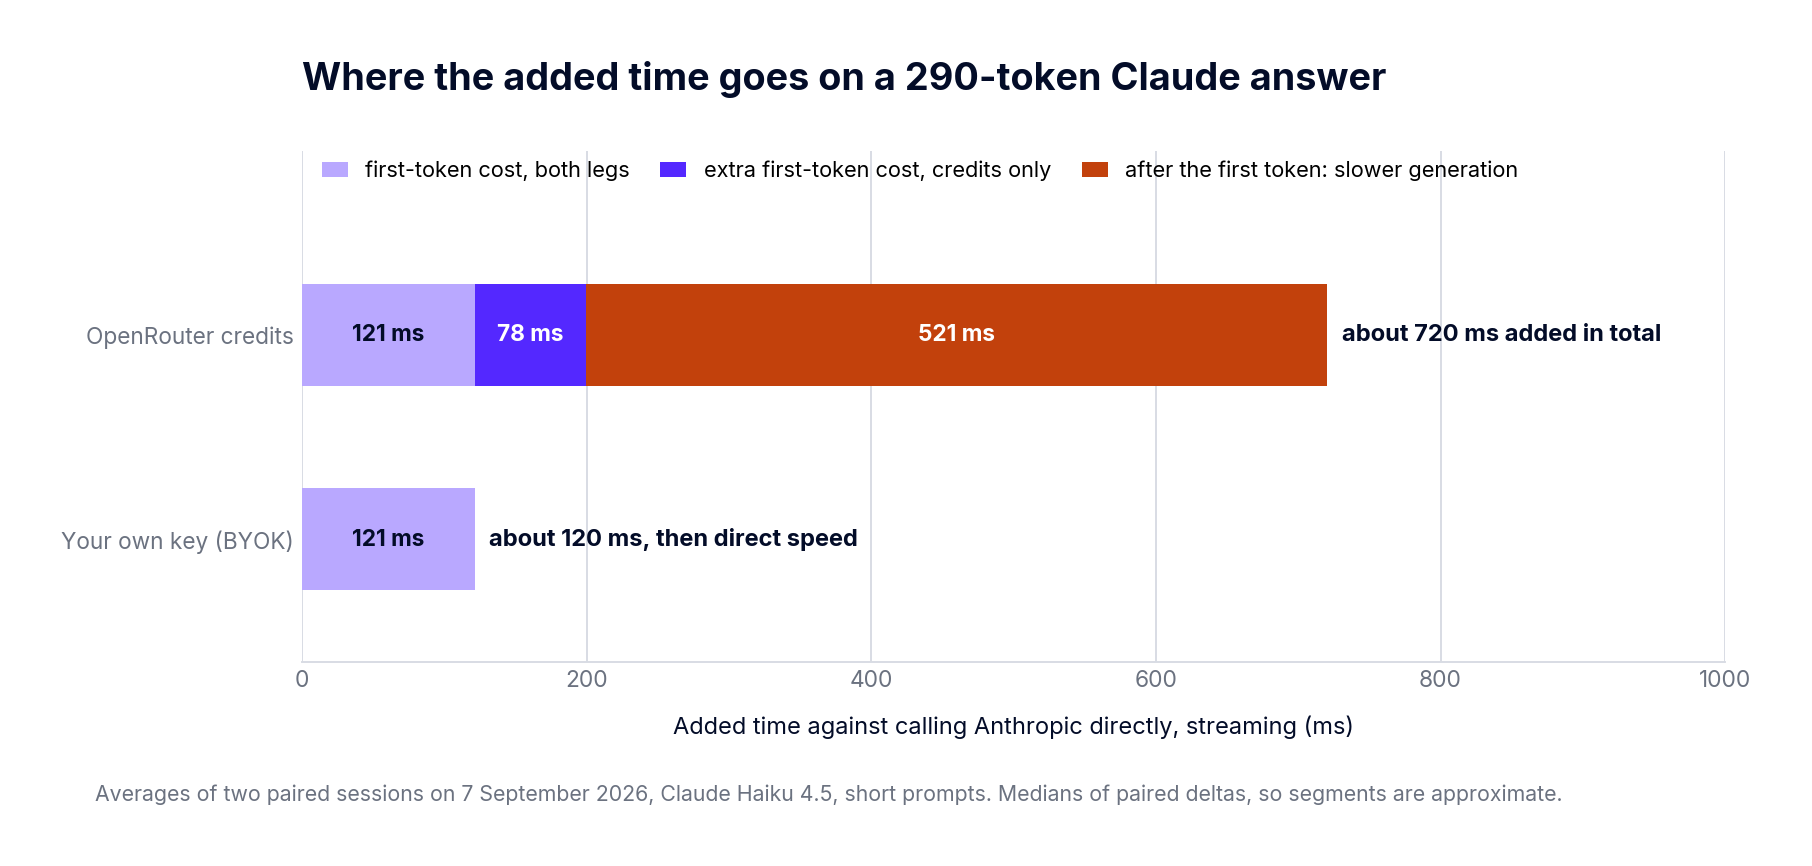
Met onze eigen sleutel voegde OpenRouter ongeveer 120 ms toe vóór het eerste token en niets daarna. Onze sleutel streamde met 115 en 116 tokens per seconde in de twee sessies, vergeleken met 115 en 113 bij een rechtstreekse verbinding. Wat deze vertraging ook is, je betaalt hem één keer, vooraf.
Op credits streamden dezelfde antwoorden langzamer, met 94 en 95 tokens per seconde, ongeveer 17% trager. De antwoorden waren niet langer: de mediane output was rond de 290 tokens op elke route. Bij een antwoord van 290 tokens voegt die langzamere stream ongeveer 520 ms toe, bovenop de vertraging voor het eerste token. De rekensom klopt: 290 tokens aan 94 in plaats van 114 tokens per seconde is ongeveer 540 ms, plus ongeveer 200 ms tot het eerste token, vergeleken met de 711 en 730 ms die we hebben gemeten voor de volledige respons.
Die generatievertraging was reëel in beide reeksen, maar niet van dezelfde omvang. Op 14 september was de extra tijd na het eerste token ongeveer 130, 215 en 280 ms voor antwoorden van 100, 500 en 1.000 tokens, veel kleiner dan op 7 september. Die cijfers komen voort uit medianen in plaats van gepaarde verschillen, dus beschouw ze als een schatting, maar de richting is duidelijk: de vertraging voor het eerste token bleef over dagen en promptgroottes heen stabiel, en de generatievertraging varieerde.
De twee soorten vertragingen wijzen op twee verschillende oorzaken.
De vertraging voor het eerste token treedt zowel op bij onze eigen sleutel als bij credits, dus het hoort bij de route van OpenRouter naar Anthropic en niet bij welk account betaalt. De meest waarschijnlijke oorzaken zijn het omzetten van een request in OpenAI-formaat naar Anthropic's Messages-formaat en het terugvertalen van de stream, evenals de netwerkroute van de edge-locatie van OpenRouter naar Anthropic. Toename met de grootte van de prompt past bij het eerste, aangezien vertaalwerk meeschaalt met de request. Onze data kan de twee niet scheiden, en het ontbreken van enige meetbare vertraging bij GPT-4o mini, die geen formaatvertaling nodig heeft, is consistent met beide. Het versturen van dezelfde requests via het native Anthropic-endpoint van OpenRouter, /api/v1/messages, is het experiment dat hier uitsluitsel over zou geven, en dat hebben we nog niet uitgevoerd.
De generatievertraging is anders. Credits en onze eigen sleutel gaan door dezelfde gateway, dezelfde vertaling en hetzelfde Anthropic-endpoint. Wat verschilt is het Anthropic-account achter de request: dat van OpenRouter, gedeeld met al haar klanten, of dat van ons. Onze beste verklaring is dat requests op het account van OpenRouter werden afgehandeld met minder capaciteit dan requests op het onze, en dat de hoeveelheid varieert met de vraag, wat ook zou verklaren waarom de vertraging kromp tussen onze twee reeksen. Dat is een aanname. Noch OpenRouter noch Anthropic publiceert hoe accounts zijn ingedeeld in tiers.
Op OpenAI draaide het patroon om. Bij GPT-4o mini bereikten credits het eerste token 23 tot 50 ms sneller dan onze eigen sleutel in alle drie de sessies waarin beide draaiden, en in de sessie waar we de streamingsnelheid vergeleken, genereerden beide met dezelfde snelheid. Het account dat je request afhandelt heeft invloed op de snelheid, en welk account sneller is hangt af van de provider. Je kunt de tier waarop je zit niet van buitenaf zien. Je kunt het alleen meten.
Het midden van de verdeling vertegenwoordigt de typische request. Tails (uitschieters) zijn van belang voor gebruikersgerichte toepassingen. In de twee sessies met korte prompts was de tijd tot het eerste token in het 95e percentiel ongeveer 700 ms bij rechtstreeks gebruik, 950 tot 985 ms op credits, en 885 tot 905 ms met onze eigen sleutel. Het 99e percentiel werd veel breder op beide OpenRouter-routes, van ongeveer 750 tot 765 ms rechtstreeks naar 1,2 tot 2,6 seconden op credits, maar bij 100 requests per sessie is het 99e percentiel in feite de op één na traagste request, dus lees het als een indicatie van een zwaardere tail in plaats van een hard cijfer.
Zonder streaming is het beeld hetzelfde. Gepaard met rechtstreeks voegden credits 548 en 629 ms toe aan de volledige respons in twee sessies, en onze eigen sleutel voegde 42 en 56 ms toe.
Deze resultaten betreffen één model, Claude Haiku 4.5, op het eigen endpoint van Anthropic. We hebben Sonnet of Opus niet getest, evenmin als Claude op Bedrock of Vertex via OpenRouter, andere OpenRouter edge-locaties of verschillende tijdstippen van de dag. De reeksen met korte prompts zijn meeneembaar en te reproduceren vanuit onze gepubliceerde testomgeving. De reeks met opgevulde prompts was een afzonderlijke sessie. We hebben geen gelijktijdigheidstest (concurrency sweep) uitgevoerd op Anthropic-credits, wat de meest directe test zou zijn voor de verklaring van gedeelde capaciteit, of de vergelijking met /api/v1/messages zoals hierboven beschreven. En alles werd uitgevoerd vanaf een enkele client, wat prima is voor verschillen tussen routes, maar niets zegt over de absolute latency vanaf jouw eigen infrastructuur.
X-OpenRouter-Experimental-Metadata: enabled en lees openrouter_metadata in de respons, wat je vertelt welk endpoint de respons heeft geleverd en of je eigen sleutel is gebruikt. Zonder dit vertrouw je blind op de pinning.Rate limits zijn de andere veelvoorkomende reden waarom Claude trager aanvoelt via OpenRouter, en ons artikel over OpenRouter rate limits legt uit hoe je een trage respons kunt onderscheiden van een geknepen respons (throttled).
De TrueFoundry AI Gateway draait in je eigen VPC of datacenter en roept Anthropic rechtstreeks aan met je eigen sleutel en contract. Zo delen requests nooit een upstream account met andere klanten en is er geen hop via een derde partij tussen jouw netwerk en de provider. Ons gepubliceerde cijfer is ongeveer 3 tot 4 ms gateway-overhead, waarbij 350+ RPS wordt afgehandeld op een enkele vCPU.
Dat cijfer van 3 tot 4 ms is de gepubliceerde benchmark van TrueFoundry. We hebben dit niet gemeten met de testomgeving achter dit artikel. Als je gateways wilt vergelijken, is de gepaarde methode hierboven de manier waarop wij het zouden doen, en het werkt op elk OpenAI-compatibel endpoint, inclusief het onze.
OpenRouter latency op Anthropic bestaat uit twee delen. Een vertraging bij het eerste token van ongeveer 100 tot 300 ms die toeneemt met de omvang van de prompt en optreedt ongeacht welk account je gebruikt, en, op OpenRouter-credits, een tragere generatie die meer dan een halve seconde toevoegde aan een typisch antwoord in de ene testreeks en minder in een andere. Het meenemen van je eigen sleutel nam de tragere generatie in onze tests weg en liet alleen de vertraging voor het eerste token bestaan. De enige manier om te weten wat die extra wachttijd kost op jouw prompts, is door het te meten zoals wij hebben gedaan, via een gepaarde vergelijking.
Om Anthropic aan te roepen met je eigen sleutel, vanaf je eigen netwerk, zonder gedeeld upstream account, bekijk hoe de TrueFoundry AI Gateway rechtstreeks verbinding maakt met Anthropic.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Dat hangt af van de provider. In onze gepaarde tests was de toegevoegde time-to-first-token op GPT-4o mini te klein om te meten, terwijl Claude Haiku 4.5 via OpenRouter-credits ongeveer 206 ms toevoegde, of ongeveer 124 ms met onze eigen Anthropic-sleutel. OpenRouter zelf publiceert geen overhead-cijfer meer.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Het traceert elk verzoek van prompt tot tool- en modeluitvoering, zodat u uniforme logging krijgt zonder wat u al draait te hoeven vervangen.
Bij Anthropic wel in onze tests: onze eigen sleutel voegde ongeveer 120 ms toe aan het eerste token tegenover ongeveer 200 ms met credits, en streamde vervolgens op directe snelheid. Bij OpenAI was credits iets sneller. Welke route sneller is, hangt af van de provider en het account erachter.
Roughly 3–4 ms of overhead, handling 350+ RPS on a single vCPU. That matters more as model calls get faster: a routing layer that adds hundreds of milliseconds would erase the advantage of a sub-second decision model.
Ja. De gateway is OpenTelemetry-compliant en exporteert traces naar externe backends, wat hoe gatewaydata platforms zoals Braintrust, Langfuse of Arize bereikt. TrueFoundry voert zelf geen offline scoringtaken uit.



Het laatste nieuws, artikelen en bronnen in je inbox



















