



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
AI-ondersteunde coderingstools zoals OpenCode veranderen fundamenteel hoe ontwikkelaars met code omgaan. In plaats van te werken op geïsoleerde fragmenten, redeneren deze systemen over bestanden, afhankelijkheden en historische context heen. Het resultaat is een aanzienlijke productiviteitsboost, maar ook een nieuwe uitdaging op het gebied van kosten en schaalbaarheid die veel teams onderschatten: tokengebruik.
In tegenstelling tot traditionele ontwikkelaarstools met voorspelbare licentiekosten, wordt het gebruik van OpenCode bepaald door prijzen op basis van tokens. Elke interactie, codegeneratie, refactoring, debugging of review verbruikt tokens. Naarmate teams het gebruik schalen over ontwikkelaars, repositories en geautomatiseerde agents, wordt tokenconsumptie de belangrijkste kostendrijver.
Wat dit bijzonder lastig maakt, is dat tokengebruik vaak niet-intuïtief is. Kleine wijzigingen in contextgrootte, promptstructuur of agentgedrag kunnen leiden tot grote schommelingen in het tokenverbruik. Zonder een helder mentaal model van hoe tokens worden gebruikt, hebben teams moeite om kosten te voorspellen, workflows te optimaliseren of guardrails af te dwingen.
Deze blog legt op technisch niveau uit hoe tokengebruik werkt in OpenCode, waarom code-gerelateerde workloads bijzonder token-intensief zijn en wat platformteams moeten begrijpen voordat ze het gebruik in productie schalen.
In de kern volgt het tokengebruik van OpenCode dezelfde principes als de meeste door LLM aangedreven systemen: tokens worden verbruikt voor zowel invoer als uitvoer. De aard van codeer-workloads brengt echter extra complexiteit met zich mee.
OpenCode-tokengebruik kan globaal worden onderverdeeld in twee categorieën:
In OpenCode omvatten prompt-tokens doorgaans:
Completion-tokens omvatten:
Vanuit het oogpunt van kosten zijn prompt-tokens vaak de dominante factor in OpenCode-gebruik, vooral naarmate repositories en contextgrootte toenemen.
Code-gerelateerde taken gedragen zich heel anders dan query's in natuurlijke taal. Verschillende factoren dragen bij aan een hoger tokenverbruik:
In tegenstelling tot op chat gebaseerde use-cases verstuurt OpenCode vaak:
Zelfs een "kleine" codebase kan zich snel vertalen naar tientallen of honderden duizenden tokens wanneer meerdere bestanden worden opgenomen.
Broncode is compact. Syntaxis, inspringen, symbolen en opmaak tellen allemaal mee voor tokens. Een paar duizend regels code kunnen veel meer tokens verbruiken dan een vergelijkbare hoeveelheid platte tekst.
OpenCode-workflows omvatten vaak:
Elke stap kan de context of tussenliggende uitvoer opnieuw verzenden, wat het tokengebruik voor één enkele taak vermenigvuldigt.
Wanneer OpenCode wordt gebruikt via agents of automatisering (bijvoorbeeld refactoring over meerdere bestanden of draaien in CI-pipelines), stapelt het tokengebruik zich snel op:
Dit maakt agent-gestuurd gebruik krachtig, maar ook duur als het niet wordt begrensd.
Eén van de grootste uitdagingen bij het tokengebruik van OpenCode is dat ontwikkelaars zelden de volledige context zien die naar het model wordt gestuurd. Editors en tools abstraheren:
Het resultaat is dat twee schijnbaar vergelijkbare taken enorm verschillende token-voetafdrukken kunnen hebben. Zonder expliciete tracking op verzoekniveau ontdekken teams kostenproblemen vaak pas nadat het gebruik piekt.
Dit is waarom inzicht in de werking van tokens alleen niet voldoende is. Teams hebben zichtbaarheid nodig in het daadwerkelijke tokenverbruik per taak, per ontwikkelaar en per workflow om onderbouwde optimalisatiebeslissingen te nemen.
Het begrijpen van tokengebruik is belangrijk voor elke door AI aangedreven toepassing, maar het wordt vooral cruciaal naarmate AI-adoptie schaalt over ontwikkelaars, agents en enterprise-platformen. Het monitoren en optimaliseren van tokenconsumptie helpt organisaties kosten te beheersen, efficiëntie te verbeteren en voorspelbare AI-uitgaven te behouden.
AI-coderingsassistenten zoals OpenCode, Claude Code en vergelijkbare tools verwerken regelmatig grote codebases, omvangrijke contextvensters en gesprekken met meerdere turns. Naarmate ontwikkelaars gedurende de dag met deze tools werken, kan de tokenconsumptie snel toenemen.
Het bijhouden van tokengebruik helpt engineeringteams om:
AI-agents voeren vaak complexe workflows uit met planning, redeneren, toolgebruik, retrieval en codegeneratie. Deze interacties in meerdere stappen kunnen een aanzienlijk hoger tokengebruik genereren dan traditionele chattoepassingen.
Het monitoren van tokenconsumptie stelt teams in staat om:
Naarmate de inzet van agents groeit, wordt token-zichtbaarheid essentieel voor het behoud van voorspelbare operationele kosten.
Grote organisaties zetten AI-toepassingen vaak in over meerdere teams, producten en bedrijfsonderdelen. Zonder gecentraliseerde zichtbaarheid kan het moeilijk zijn om te begrijpen hoe tokens worden verbruikt en waar kosten stijgen.
Organisaties gebruiken tokenmonitoring om:
Naarmate AI-adoptie uitbreidt, wordt tokengebruik een belangrijke operationele metriek naast latentie, betrouwbaarheid en modelprestaties. Organisaties die het tokenverbruik actief monitoren en optimaliseren, zijn vaak beter gepositioneerd om AI-workloads efficiënt te schalen en tegelijkertijd de kosten onder controle te houden.
De meeste pieken in het OpenCode-tokengebruik worden niet veroorzaakt door één enkele duidelijke fout. Ze ontstaan uit de manier waarop OpenCode wordt gebruikt in de praktijk van engineering-workflows—vooral wanneer tools en agents diep geïntegreerd zijn in ontwikkelings- en automatiseringspipelines.
Hieronder staan de meest voorkomende scenario's die het tokenverbruik onevenredig verhogen.
Eén van de grootste veroorzakers van hoog tokengebruik is te brede contextopname. Veel OpenCode-workflows bevatten hele mappen of grote delen van een repository om "voor de zekerheid te gaan", zelfs wanneer slechts een klein deel van de code relevant is.
Voorbeelden hiervan zijn:
Omdat prompt-tokens lineair meeschalen met de contextgrootte, kan dit patroon alleen al de kosten snel vermenigvuldigen.
OpenCode werkt vaak iteratief: code genereren, beoordelen, aanpassen, opnieuw genereren. In veel opstellingen stuurt elke iteratie de volledige context opnieuw mee, inclusief bestanden en eerdere uitvoer.
Dit leidt tot:
Zonder caching of intelligent contexthergebruik wordt iteratie één van de duurste patronen.
Wanneer OpenCode wordt gebruikt via agents of geautomatiseerde workflows, kan het tokengebruik snel escaleren als de uitvoering niet expliciet begrensd is.
Veelvoorkomende oorzaken zijn:
Omdat deze processen vaak op de achtergrond draaien, opmerken teams onbeheerd gebruik pas als de kosten pieken.
Refactoring- en reviewtaken zijn meestal meer token-intensief dan codegeneratie omdat ze het volgende vereisen:
Wanneer deze taken worden toegepast op grote codebases of meerdere pull-requests, neemt het tokengebruik aanzienlijk toe.
OpenCode-gebruik dat is ingebed in CI-pipelines of automatiseringsworkflows introduceert een ander risicoprofiel. Deze systemen:
Zelfs een bescheiden tokengebruik per run kan duur worden wanneer het wordt vermenigvuldigd over veel builds of deployments.
Tot slot is één van de meest over het hoofd geziene factoren voor hoog tokengebruik het ontbreken van zichtbaarheid. Wanneer teams niet kunnen zien:
Geraakt optimalisatie gissen. Teams reageren vaak door het gebruik globaal te beperken, in plaats van de specifieke workflows aan te pakken die de kosten veroorzaken.
Zodra teams begrijpen waar tokengebruik vandaan komt, is de volgende stap optimalisatie. Belangrijk is dat optimalisatie niet gaat over het willekeurig beperken van het gebruik; het gaat over het bewust gebruiken van tokens zodat productiviteitswinst niet verandert in onbeheerde kosten.
Hieronder staan praktische best practices die het tokengebruik van OpenCode consequent verminderen zonder dat dit ten koste gaat van de uitvoerkwaliteit.
De meest effectieve optimalisatieknop is het controleren van welke context naar het model wordt gestuurd. Meer context is niet altijd beter, vooral niet als het irrelevant is.
Praktische technieken omvatten:
Een goede vuistregel: als een bestand niet vereist is om over de wijziging te redeneren, mag het geen deel uitmaken van de prompt.
In plaats van vooraf grote hoeveelheden code te verzenden, moeten teams overstappen op retrieval op aanvraag.
Voorbeelden:
Deze aanpak vermindert de promptgrootte en verbetert vaak de kwaliteit van de redenering, omdat het model meer gerichte informatie ontvangt.
Generieke prompts moedigen breder redeneren en grotere uitvoer aan, wat zowel prompt- als completion-tokens verhoogt.
Betere patronen:
Taakgerichte prompts verminderen niet alleen het tokengebruik, maar verbeteren ook de determinstiek.
Op agents gebaseerde workflows versterken het tokengebruik als ze niet worden gecontroleerd. Elke agent moet werken binnen duidelijk gedefinieerde limieten.
Belangrijke guardrails omvatten:
Zonder deze grenzen kunnen agents onbedoeld grote contexten meerdere keren herverwerken, wat het gebruik opdrijft.
Veel OpenCode-workflows herhalen vergelijkbare taken over iteraties of gebruikers heen. Caching kan het dubbele tokenverbruik aanzienlijk verminderen.
Toepasbare scenario's:
Zelfs gedeeltelijke caching op workflow-niveau kan aanzienlijke besparingen opleveren.
Hoewel prompt-tokens vaak domineren, doen completion-tokens er ook toe, vooral bij refactoring- of uitlegintensieve workflows.
Technieken omvatten:
Duidelijke uitvoerbeperkingen verminderen onnodige langradigheid.
Tot slot moet optimalisatie niet reactief zijn. Teams moeten het tokengebruik vanaf dag één instrumenteren.
Dit betekent minimaal het bijhouden van:
Zonder deze gegevens kunnen teams geen onderscheid maken tussen productief gebruik en verspilling.
De meeste teams worstelen op dag één niet met het tokengebruik van OpenCode. De problemen ontstaan geleidelijk naarmate het gebruik zich verspreidt over ontwikkelaars, repositories en geautomatiseerde workflows. Wat begint als een individuele productiviteitstool wordt snel gedeelde infrastructuur en het tokengebruik schaalt op manieren die moeilijk te voorspellen of te beheren zijn.
Op schaal wordt OpenCode niet langer gebruikt door een enkele ontwikkelaar in een editor. Het wordt gebruikt door:
Elk van deze verbruikers genereert onafhankelijk tokengebruik. Zonder een gecentraliseerd overzicht wordt het moeilijk om basisvragen te beantwoorden zoals wie gebruikt er tokens, voor welk doel en tegen welke kosten.
Vroege optimalisatie-inspanningen worden vaak geïmplementeerd op toepassings- of toolniveau: aangepaste promptlimieten, contextopschoning of retry-logica. Hoewel deze lokaal helpen, schalen ze niet over:
Het resultaat is dat het beleid gefragmenteerd en inconsistent wordt. Het ene team optimaliseert agressief terwijl een ander onbewust de kosten opdrijft.
Automatisering verandert de rekensom. Een workflow die een bescheiden aantal tokens per run verbruikt, kan duur worden wanneer deze:
Omdat deze taken draaien zonder directe menselijke zichtbaarheid, stapelen inefficiënties zich snel op. Pieken in tokengebruik zijn vaak afkomstig van automatisering in plaats van interactief gebruik.
Zonder gedetailleerde toeschrijving zien teams alleen geaggregeerde gebruiksnummers. Dit maakt optimalisatie reactief en bot.
Veelvoorkomende valkuilen zijn:
Effectieve controle vereist kennis van welke workflows waarde genereren en welke verspilling genereren, iets wat geaggregeerde metrieken niet kunnen onthullen.
In veel organisaties gaat de adoptie van AI-tooling sneller dan de governance. OpenCode-gebruik verspreidt zich sneller dan:
Tegen de tijd dat tokengebruik een zorg wordt, is de tooling al diep ingebed in workflows, wat retroactieve controles moeilijk en verstorend maakt.
Het kernprobleem is geen misbruik - het is gedecentraliseerd gebruik zonder gecentraliseerde controle. Naarmate OpenCode gedeelde infrastructuur wordt, moet het tokengebruik op dezelfde manier worden beheerd als teams rekenkracht, opslag of CI-bronnen beheren.
Dit vereist:
Zonder deze omslag blijft het tokengebruik onvoorspelbaar en blijven de optimalisatie-inspanningen reactief.
Zodra het gebruik van OpenCode productieschaal bereikt, werken ad-hoc tracking en handmatige optimalisaties niet meer. In dit stadium moet tokengebruik worden behandeld als elke andere gedeelde infrastructuurbron - continu gemeten, gecentraliseerd beheerd en gekoppeld aan eigenaarschap.
Veel teams beginnen met het bijhouden van tokengebruik binnen individuele tools of workflows. Hoewel dit lokaal inzicht biedt, loopt het snel vast wanneer:
Elke integratie rapporteert het gebruik anders en geen enkele biedt een holistisch beeld. Als gevolg hiervan ontbreekt het platformteams aan één enkele bron van waarheid voor tokenconsumptie.
Op schaal moet monitoring plaatsvinden op verzoekniveau, niet alleen op toolniveau. Effectieve opstellingen leggen het volgende vast:
Hiermee kunnen teams vragen beantwoorden zoals:
Zonder deze gedetailleerdheid blijven optimalisatie-inspanningen grof en vaak verkeerd gericht.
Governance begint met toeschrijving. Tokengebruik moet worden gekoppeld aan eigenaren die er naar kunnen handelen.
Veelvoorkomende toeschrijvingsmodellen omvatten:
Zodra het eigenaarschap duidelijk is, verschuiven kostengesprekken van abstract budgetteren naar concrete beslissingen over welke workflows voldoende waarde opleveren.
Monitoring alleen voorkomt geen kostenoverschrijdingen. Productiesystemen vereisen mechanismen voor afdwinging die in real-time werken.
Typische guardrails omvatten:
Deze controles moeten gecentraliseerd worden afgedwongen, zodat alle door OpenCode aangedreven workflows ze automatisch overnemen.
De rode draad bij effectieve governance-inrichtingen is centralisatie. Tokengebruiksbeleid, limieten en transparantie moeten samenkomen op een gedeeld controlepunt in plaats van opnieuw te worden geïmplementeerd in verschillende tools.
Dit is waar infrastructuurgeoriënteerde platforms zoals TrueFoundry van nature passen. Door AI-verkeer, observability en beleidshandhaving te centraliseren, kunnen platformteams het OpenCode-tokengebruik consistent beheren over ontwikkelaars, agents en geautomatiseerde systemen heen - zonder afzonderlijke teams te vertragen.
Naarmate de adoptie van AI groeit, wordt het volgen en beheren van tokengebruik steeds belangrijker. Hoewel individuele ontwikkelaars het tokenverbruik vaak handmatig kunnen beheren, hebben organisaties die meerdere toepassingen, teams en modellen gebruiken doorgaans gecentraliseerde transparantie en governance nodig.
Handmatige monitoring kan werken voor kleinschalige implementaties, maar het wordt vaak moeilijk om uitgaven bij te houden, inefficiënties te identificeren en gebruiksregels af te dwingen naarmate AI-workloads schalen. AI Gateways bieden een gecentraliseerde laag voor het monitoren van tokengebruik, het beheren van kosten en het optimaliseren van modelbenutting in de gehele organisatie.
Vanuit het oogpunt van een platform is de belangrijkste uitdaging bij OpenCode-tokengebruik niet het begrijpen van hoe tokens worden verbruikt, maar waar de controle en transparantie moeten liggen.
TrueFoundry benadert dit probleem door AI- en LLM-gebruik, inclusief tools voor ontwikkelaars zoals OpenCode, te behandelen als gedeelde infrastructuur die standaard waarneembaar, bestuurbaar en kostenbewust moet zijn. Centraal in deze aanpak staat de AI Gateway, die fungeert als het controlepunt voor al het LLM-verkeer binnen de organisatie.
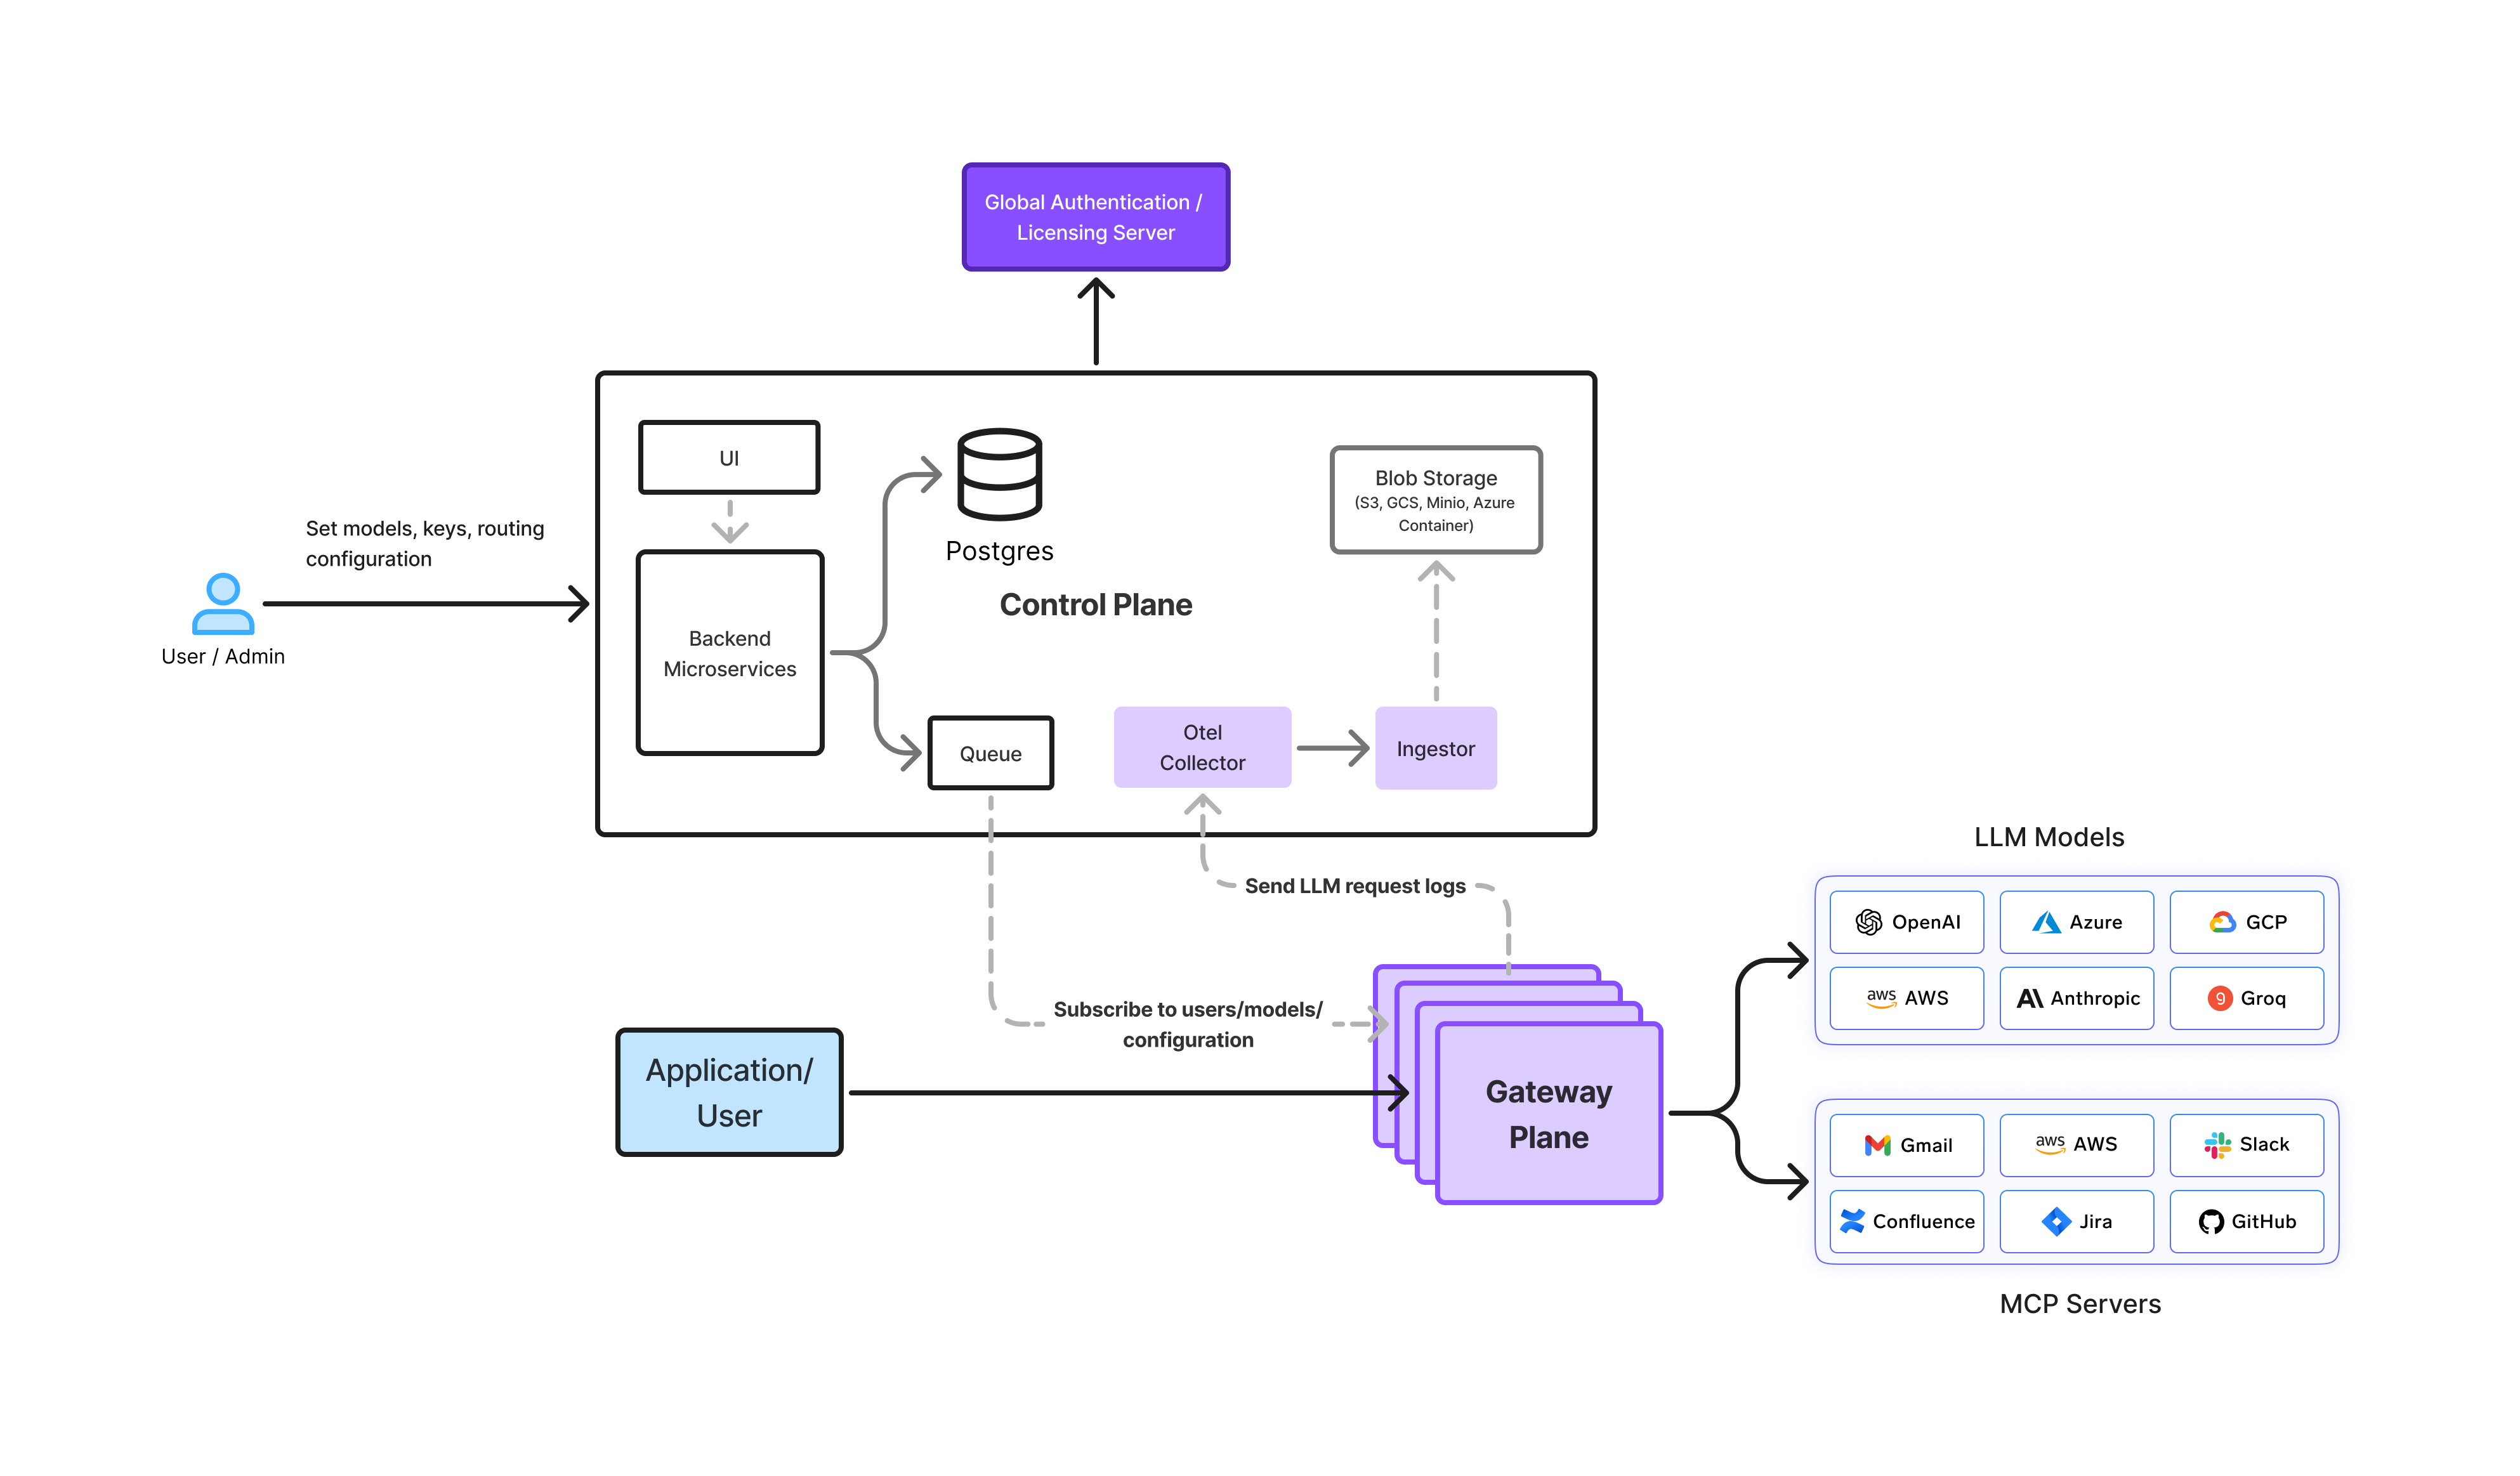
In een TrueFoundry-inrichting communiceert OpenCode niet rechtstreeks met de onderliggende LLM-providers. In plaats daarvan verlopen alle verzoeken via de AI Gateway, die één enkele, consistente interface biedt voor inference.
Architectonisch maakt dit het volgende mogelijk:
Door directe toegang tot modellen weg te nemen bij afzonderlijke tools, krijgen platformteams volledig inzicht in hoe OpenCode daadwerkelijk wordt gebruikt door ontwikkelaars, agents en automatisering.
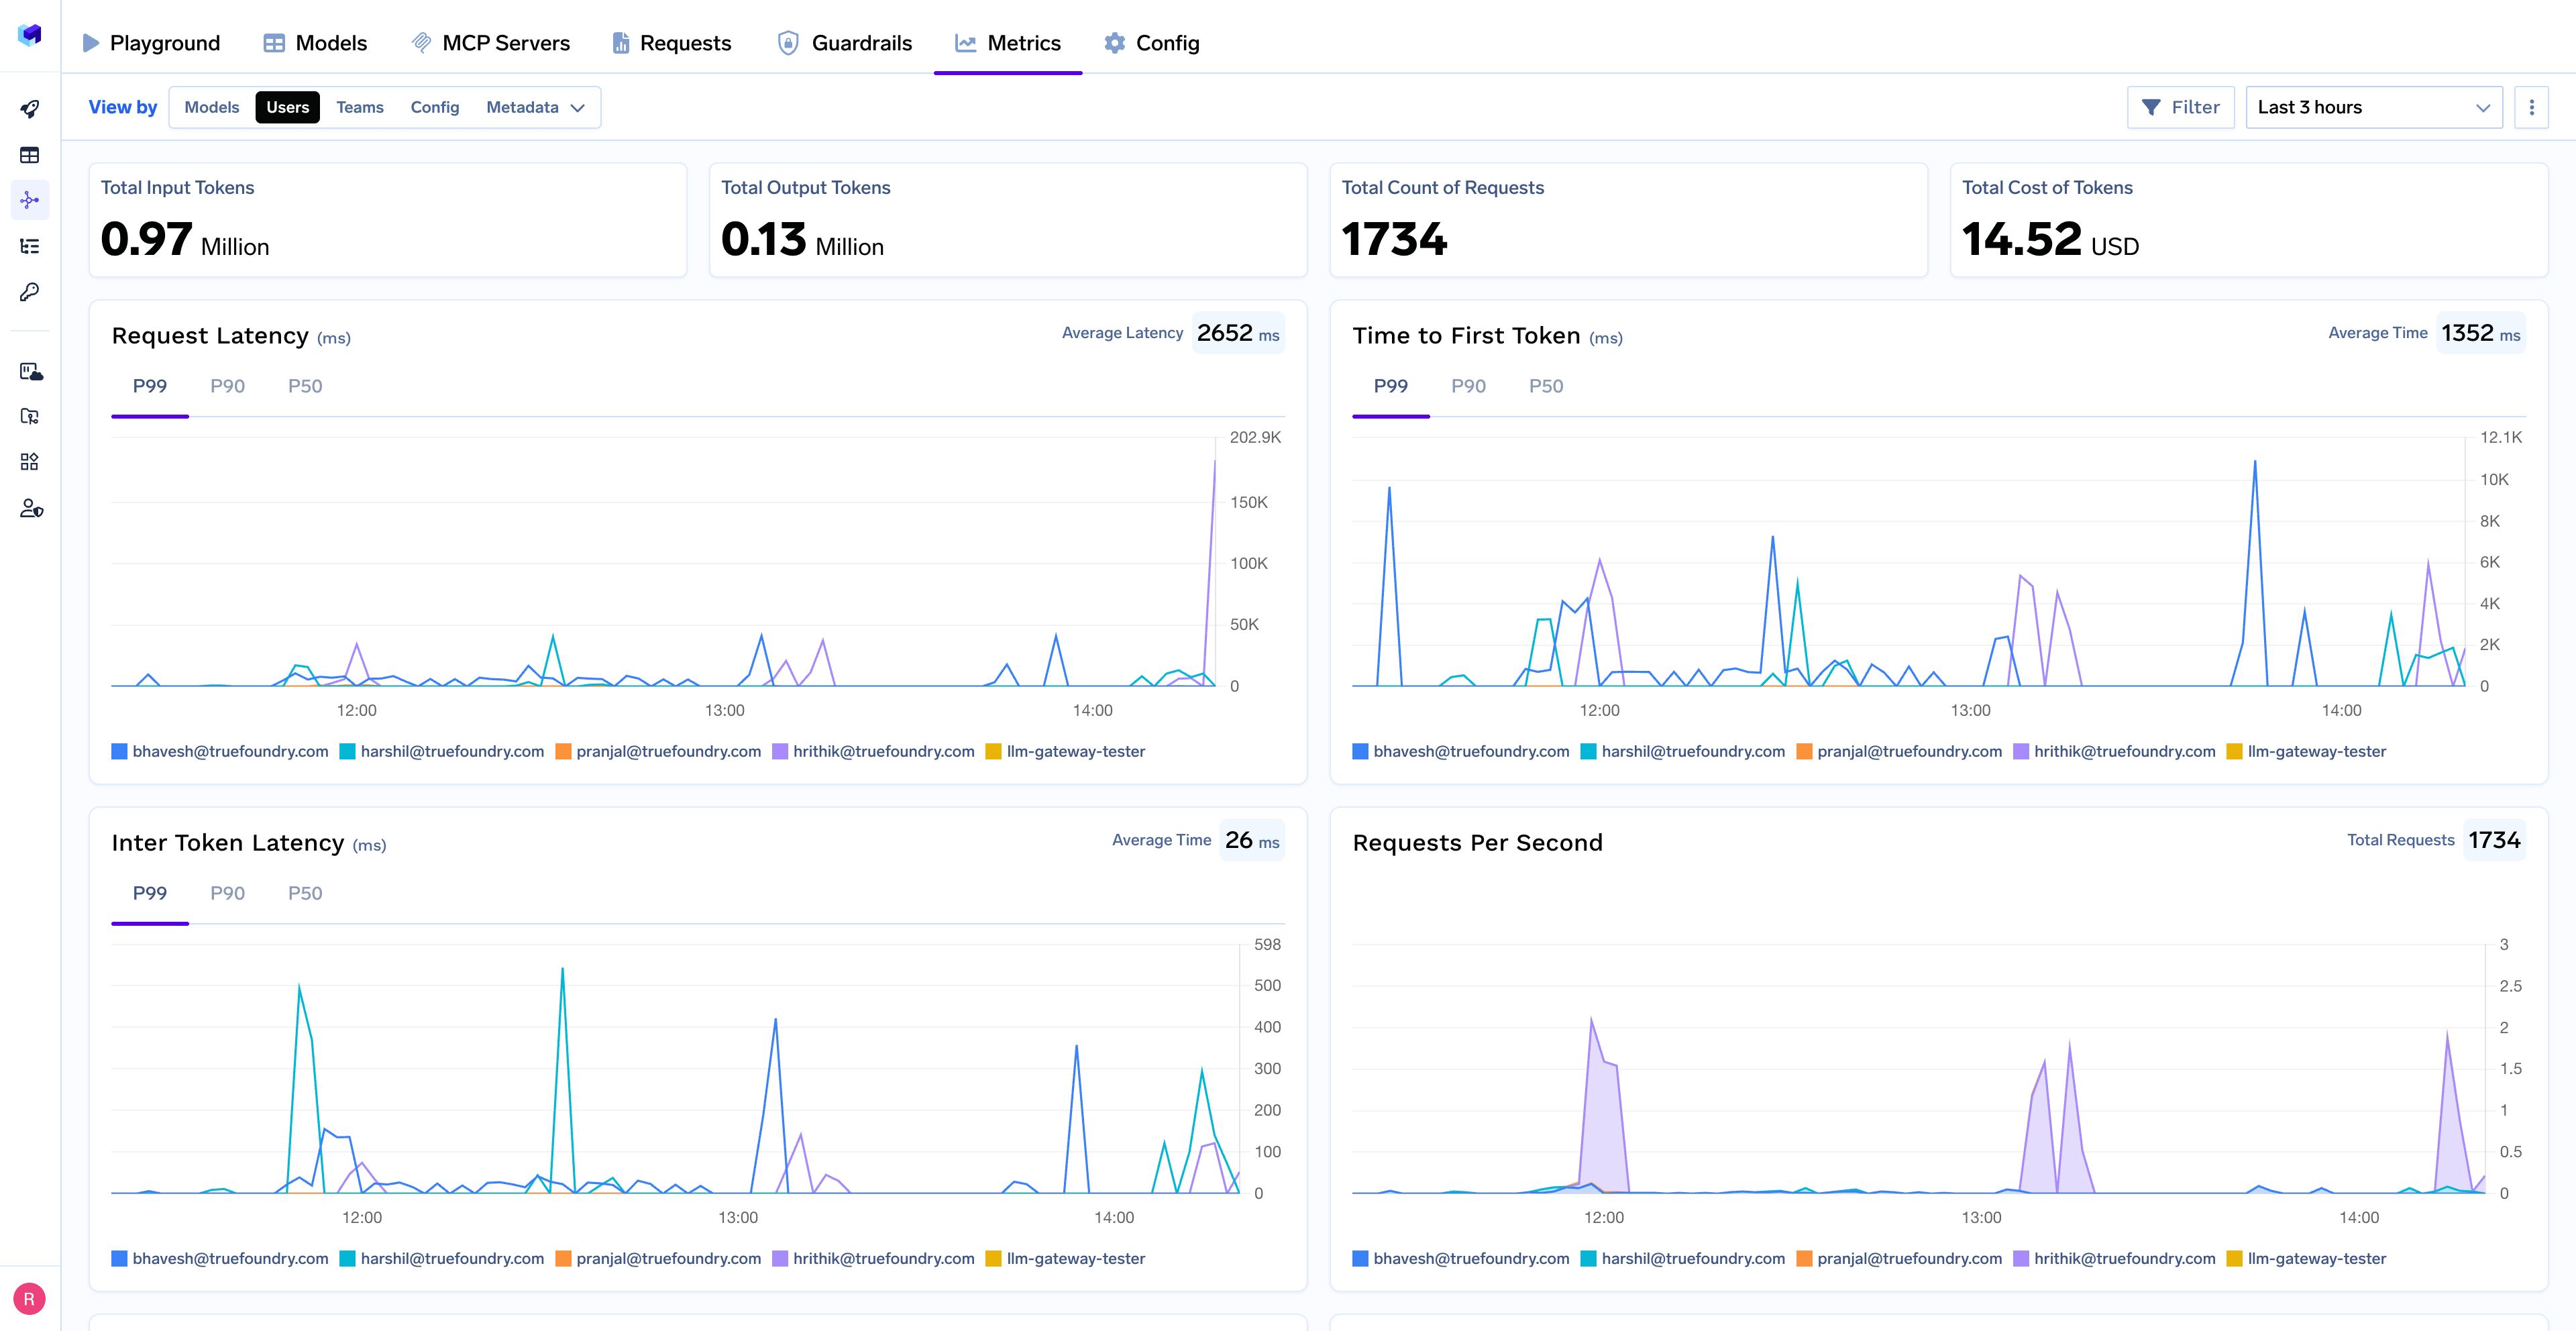
De AI Gateway van TrueFoundry legt tokengebruik vast op verzoekniveau, waaronder:
Cruciaal is dat deze telemetrie niet opgesloten zit in een door de leverancier beheerd systeem. Logs en metrieken worden opgeslagen in de eigen cloud en storage van de klant, waardoor teams het volgende kunnen doen:
Dit voorkomt het "black box"-probleem dat vaak voorkomt bij AI-tooling en maakt optimalisatie op de lange termijn mogelijk.
Omdat al het OpenCode-verkeer via de gateway verloopt, kunnen kostenbeheersingen consistent en in real-time worden toegepast.
Platform teams kunnen:
Deze policies worden eenmalig bij de gateway afgedwongen en zijn automatisch van toepassing op elke door OpenCode aangedreven workflow, zonder dat er aanpassingen nodig zijn in editors, plugins of interne tools.
De architectuur van TrueFoundry is ontworpen voor omgevingen waarin het gebruik van OpenCode verder reikt dan de IDE. CI-pipelines, achtergrondtaken en agenten genereren vaak het grootste en minst zichtbare tokenverbruik.
Door deze workloads via dezelfde AI Gateway te routen, kunnen teams:
Dit maakt het mogelijk om het gebruik van OpenCode binnen de organisatie op te schalen zonder de voorspelbaarheid of controle te verliezen.
OpenCode token usage is de werkelijke schaalbeperking voor AI-assisted coding. Naarmate het gebruik zich verspreidt over developers, repositories, automatisering en agenten, wordt tokenverbruik moeilijk te voorspellen en te controleren zonder gecentraliseerde zichtbaarheid en governance.
Dit beheren op tool- of applicatieniveau is niet schaalbaar. Token usage vereist observability op request-niveau, heldere toewijzing en real-time afdwinging, waarbij AI-assisted coding wordt behandeld als gedeelde infrastructuur en niet als een geïsoleerde feature.
Platforms zoals TrueFoundry weerspiegelen deze aanpak door OpenCode-verkeer te centraliseren via een AI Gateway, waardoor teams in staat worden gesteld om token usage consistent te monitoren, te beheren en te optimaliseren. Voor platform- en engineering-leaders is de conclusie eenvoudig: als OpenCode essentieel is voor de manier waarop software wordt gebouwd, moet token usage met dezelfde striktheid worden beheerd als elke andere kritieke infrastructuurbron.
Het nauwkeurig controleren van opencode token usage vereist expliciete tracking en instrumentatie op request-niveau. Omdat tools vaak de volledige context die naar het model wordt gestuurd abstraheren, is het verkrijgen van inzicht in het daadwerkelijke tokenverbruik per taak, developer en workflow cruciaal om kosten te voorspellen en je gebruik effectief te optimaliseren.
Opencode token usage is het op tokens gebaseerde prijsmodel voor AI-assisted coding tools zoals OpenCode. Elke interactie, van input prompts en codecontext tot gegenereerde code en uitleg, verbruikt tokens. Het beheren van deze opencode token usage is cruciaal, aangezien het de primaire kostendrijver wordt voor development teams in de VS.
Om opencode token usage te verminderen, beperk je contextinjectie tot alleen essentiële bestanden en vermijd je het opnemen van brede repositories. Voorkom herhaalde context-rehydratie door outputs slim te hergebruiken over iteraties heen. Verdeel complexe taken in kleinere stappen en gebruik precieze prompts. Het monitoren van het tokenverbruik voor elke taak biedt kritieke inzichten voor het optimaliseren van kosten en efficiëntie.
Je kunt OpenCode token usage verminderen door de lengte van prompts te optimaliseren, onnodige context te beperken en het juiste model voor de taak te gebruiken. Grote prompts, uitgebreide gesprekgeschiedenis en te grote codecontexten kunnen het tokenverbruik aanzienlijk verhogen. Het regelmatig beoordelen van gebruikspatronen kan helpen om kansen te identificeren voor het verbeteren van de efficiëntie en het verlagen van de kosten.
Verschillende factoren kunnen de token usage in OpenCode verhogen, waaronder:
Inzicht in deze factoren helpt teams om AI-gebruik te optimaliseren en uitgaven effectiever te beheersen.
Organisaties monitoren token usage doorgaans via gecentraliseerde dashboards, analytics-tools of AI Gateway-platforms. Deze oplossingen bieden inzicht in het tokenverbruik over gebruikers, teams, applicaties en modellen heen, wat organisaties helpt om uitgaven bij te houden, afwijkingen te identificeren en AI-budgetten effectiever toe te wijzen.
Het monitoren van token usage op teamniveau maakt het ook eenvoudiger om optimalisatiekansen te identificeren en onverwachte kostenstijgingen te voorkomen.
Ja. AI Gateways kunnen organisaties helpen om het tokenverbruik te optimaliseren door inzicht te bieden in gebruikspatronen, budgetten en rate limits af te dwingen en intelligente routing naar modellen mogelijk te maken.
Een AI Gateway kan bijvoorbeeld eenvoudiger requests automatisch routen naar goedkopere modellen, terwijl premium modellen bewaard blijven voor complexere taken. Gecombineerd met gebruiksanalyses en governance controls helpt dit organisaties om AI-kosten te verlagen met behoud van prestaties en betrouwbaarheid.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















