



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Nu Generatieve AI een kernonderdeel wordt van enterprise-workflows, heroverwegen veel organisaties waar en hoe hun AI-modellen draaien. Hoewel cloudgebaseerde diensten gemak en snelheid bieden, roepen ze ook vragen op over dataprivacy, compliance, vendor lock-in en langetermijnkosten. Voor enterprises die gevoelige gegevens verwerken of actief zijn in gereguleerde sectoren, biedt on-premise GenAI een veilig en controleerbaar alternatief. Het stelt bedrijven in staat om krachtige taalmodellen, vector databases en AI-infrastructuur binnen hun eigen omgevingen te laten draaien. Dit artikel verkent wat on-premise GenAI is, waarom het aan populariteit wint, en welke platforms enterprise-grade implementaties mogelijk maken.

On-premise generatieve AI verwijst naar de implementatie en uitvoering van generatieve AI-modellen, zoals large language models (LLMs), afbeeldingsgeneratoren of multimodale systemen, binnen de eigen infrastructuur van een organisatie. Deze infrastructuur kan bestaan uit eigen datacenters, private clouds of hybride omgevingen, waarin de organisatie de volledige controle behoudt over datastromen, modeltoegang en systeembeveiliging.
In tegenstelling tot cloudgebaseerde GenAI-oplossingen, die op infrastructuur van derden draaien, zijn on-premise-implementaties ontworpen om achter enterprise-firewalls te werken. Deze opzet zorgt ervoor dat gevoelige gegevens de vertrouwde omgeving van de organisatie nooit verlaten. Het maakt ook fijne afstemming van modellen mogelijk, evenals een hechtere integratie met interne systemen en naleving van strenge regelgevende normen zoals GDPR, HIPAA of SOC 2.
On-premise GenAI-oplossingen bestaan doorgaans uit verschillende sleutelcomponenten: getrainde of gefinetunede LLMs, een inference engine (zoals vLLM of TGI), een container-orchestratieplatform zoals Kubernetes, en optionele vector databases voor retrieval-augmented generation (RAG) use-cases.
Met deze opzet kunnen enterprises GenAI-functionaliteiten implementeren — zoals chat-assistenten, samenvattingsengines en intelligent zoeken — zonder te vertrouwen op externe APIs of gegevens te delen met cloudproviders. Deze aanpak is bijzonder aantrekkelijk voor sectoren zoals de gezondheidszorg, financiële dienstverlening, defensie en juridische diensten, waar dataprivacy en controle over de infrastructuur cruciaal zijn.
On-premise GenAI vertegenwoordigt een verschuiving van gemak naar controle, waarbij enterprises de flexibiliteit krijgen om AI-workloads op hun eigen voorwaarden te schalen, terwijl ze voldoen aan de eisen op het gebied van compliance, beveiliging en prestaties die zijn afgestemd op hun behoeften.
Naarmate Generatieve AI dieper verankerd raakt in de bedrijfsvoering, stappen veel organisaties af van cloud-only oplossingen ten gunste van on-premise-implementaties. Deze verschuiving wordt gedreven door de noodzaak van meer controle over data, infrastructuur en de AI-strategie voor de lange termijn.
Een belangrijke reden om te kiezen voor on-premise GenAI is dataprivacy en compliance. Enterprises in sectoren zoals de gezondheidszorg, de financiële sector en defensie moeten voldoen aan strenge regelgeving zoals GDPR, HIPAA en CCPA. Cloudgebaseerde diensten roepen vaak vragen op over waar data wordt opgeslagen, hoe deze toegankelijk is en wie inzicht heeft in gevoelige informatie. Bij een on-premise-implementatie blijft de data binnen de omgeving van de organisatie, wat de controleerbaarheid verbetert en de blootstelling vermindert.
Een andere belangrijke factor is maatwerk en controle. Enterprises moeten modellen vaak finetunen, strikt gedrag afdwingen voor de uitvoer, of integreren met interne systemen. Met on-premise GenAI kunnen organisaties model-pipelines aanpassen, prompt-gedrag beheren en domeinspecifieke verbeteringen doorvoeren zonder afhankelijk te zijn van APIs van derden of externe releasecycli.
Het vermijden van vendor lock-in is eveneens een sterke motivator. Uitsluitend vertrouwen op één enkele cloudprovider beperkt de flexibiliteit en kan op de lange termijn tot kosten- en innovatiebeperkingen leiden. On-premise-opstellingen bieden full-stack eigenaarschap, waardoor teams onderdelen kunnen vervangen, open-source modellen kunnen testen en hun architectuur kunnen laten evolueren zonder externe afhankelijkheden.
Voorspelbaarheid en optimalisatie van kosten zijn evenzeer belangrijk bij het evalueren van de kosten van generatieve AI. Voor bedrijven die grootschalige inference-workloads draaien, kan facturering op basis van gebruik moeilijk te beheren worden. Met on-premise infrastructuur zijn de kosten gekoppeld aan het hardwaregebruik in plaats van aan vergoedingen per token of per verzoek, wat de financiële planning transparanter maakt.
On-premise GenAI biedt enterprises de mogelijkheid om AI-workloads veilig, flexibel en kosteneffectief uit te voeren, terwijl ze voldoen aan de compliance-eisen en afhankelijkheid van externe dienstverleners vermijden.
Het draaien van Generatieve AI on-premise vereist een goed ontworpen stack die prestaties, controle en schaalbaarheid in evenwicht brengt. Hieronder staan de belangrijkste infrastructuurcomponenten die nodig zijn om GenAI-systemen te implementeren binnen enterprise-omgevingen.
Samen vormen deze componenten het fundament van een robuuste, schaalbare, on-premise GenAI-implementatie.
Hoewel on-premise GenAI grotere controle en databeveiliging biedt, brengt het een eigen reeks uitdagingen met zich mee waar enterprises zorgvuldig voor moeten plannen. Deze uitdagingen omvatten infrastructuur, schaalbaarheid, operaties en onderhoud.
Hardware-inkoop en -instelling: Het aanschaffen en onderhouden van GPUs of gespecialiseerde AI-versnellers kan tijdrovend en kostbaar zijn. De levertijden voor high-end hardware zoals NVIDIA A100s of H100s kunnen maanden duren, en het opzetten van koeling, stroom en rackruimte voegt extra complexiteit toe.
Complexiteit van Infrastructuur en DevOps: Het draaien van grote modellen on-premise vereist het beheer van container-orchestratie, GPU-scheduling, netwerken en resource-limieten. Zonder een toegewijd DevOps- of MLOps-team kan het garanderen van uptime en schaalbaarheid een knelpunt worden, vooral naarmate het gebruik groeit.
Schaalbaarheid en Belastingsbeheer: Autoscaling is complexer in on-premise omgevingen in vergelijking met cloudplatforms. Enterprises moeten plannen voor piekbelastingsscenario's en buffercapaciteit inbouwen, wat kan leiden tot onderbenutting en hogere kosten als het niet goed geoptimaliseerd is.
Modelbeheer en Versiebeheer: Het hosten van meerdere modellen voor verschillende teams of use-cases vereist versiebeheer, ondersteuning voor rollbacks en veilige toegangscontrole. Zonder de juiste tools kan een wildgroei aan modellen leiden tot instabiliteit en inefficiëntie in de implementatie-pipelines.
Monitoring en Probleemoplossing: Het identificeren van knelpunten, latency-pieken of geheugenproblemen vereist realtime monitoringtools. Zonder robuuste observabiliteit wordt het diagnosticeren van prestatieproblemen reactief in plaats van proactief.
Ondanks deze uitdagingen slagen veel enterprises erin om GenAI succesvol on-premise te implementeren door vanaf het begin te investeren in de juiste tools, platforms en operationele praktijken.
Het kiezen van het juiste platform is essentieel om GenAI-workloads succesvol on-premise te implementeren en te beheren. Deze platforms helpen de complexiteit van infrastructuur, orchestratie en het serveren van modellen te abstraheren. Hieronder staan enkele van de beste oplossingen die zijn gebouwd voor veilige, schaalbare en aanpasbare on-premise GenAI-implementaties.

TrueFoundry is een enterprise-grade, Kubernetes-native platform dat is ontworpen om de implementatie, inference en schaling van AI- en GenAI-workloads te stroomlijnen in cloud- en on-premise omgevingen. Het abstraheert de complexiteit van het beheren van LLM-infrastructuur door het bieden van een robuuste AI Gateway, geoptimaliseerde model-servinglagen en full-stack MLOps-integratie.
Gebouwd met een developer-first insteek stelt TrueFoundry ML- en platformteams in staat zich te concentreren op het bouwen en optimaliseren van modellen in plaats van op het beheren van rekeninfrastructuur. Het biedt naadloze integraties met vooraanstaande inference-frameworks zoals vLLM en Text Generation Inference (TGI), en ondersteunt razendsnelle, token-efficiënte LLM-implementaties.
Belangrijkste kenmerken:
Geïntegreerde AI Gateway: Serves 250+ open-source en eigen LLMs met een consistente OpenAI-compatibele API-laag. Schakel tussen modellen zoals LLaMA 2, Mistral, Mixtral, Claude en GPT via multi-model routing — allemaal zonder je integratiecode te wijzigen.
Kubernetes-Native Architectuur: Schaalt LLM-inference-workloads automatisch in elke omgeving — AWS, GCP, Azure of on-prem met behulp van native Kubernetes-orchestratie. Wordt geleverd met vooraf ingebouwde Helm-gebaseerde GitOps-ondersteuning voor declaratief infrastructuurbeheer.
Geoptimaliseerd voor Inference op Schaal: TrueFoundry integreert van nature met vLLM om een latency van minder dan 400 ms te leveren en 100+ gelijktijdige gebruikers per GPU te bedienen. Gemengde precisie, kwantisering en batching worden standaard ondersteund om de kosten per token te verlagen.
Volledige Observabiliteit & Controle: Realtime analyses op token-niveau, latency-statistieken, rate limiting en automatische load balancing geven engineeringteams volledig inzicht in en controle over de productie-inference.
Prompt- & Versiebeheer: Beheer, versioneer en test prompts rechtstreeks binnen het platform. Maak A/B-testen en rollback-ondersteuning mogelijk voor snelle iteratie en experimenten.
Beveiliging & Compliance: Implementeer LLMs in je VPC of on-premise met ingebouwde RBAC, versleutelde communicatie en SOC2-compliant praktijken. Er verlaat nooit model- of prompt-data jouw infrastructuur.

NVIDIA Enterprise AI is een full-stack suite van software en GPU-versnelde infrastructuur, gebouwd om schaalbare AI-, machine learning- en generatieve AI-workloads in enterprise-omgevingen aan te drijven. Ontworpen voor hybride en on-premise implementaties, stelt het organisaties in staat om geavanceerde AI, waaronder LLMs, computer vision en voorspellende analyses, uit te voeren op NVIDIA-gecertificeerde systemen met NVIDIA AI Enterprise, een softwarelaag die is geoptimaliseerd voor prestaties, beveiliging en ondersteuning.
Of het nu gaat om het implementeren van modellen in private datacenters of op een hybride cloud infrastructuur, NVIDIA Enterprise AI stelt enterprises in staat veilige, low-latency AI-toepassingen te bouwen zonder data buiten hun netwerk te sturen. Het is ideaal voor sectoren zoals de gezondheidszorg, financiële dienstverlening en productie die on-premise AI met volledige datasoevereiniteit vereisen.
Belangrijkste kenmerken

Red Hat OpenShift AI (voorheen Red Hat OpenShift Data Science) is een enterprise-ready MLOps-platform waarmee organisaties AI/ML-modellen kunnen bouwen, trainen, implementeren en monitoren in hybride cloudomgevingen. Gebouwd op Kubernetes via OpenShift, biedt het een volledig geïntegreerde omgeving voor modelontwikkeling en productie, met flexibiliteit voor on-premise-, cloud- of edge-implementaties.
OpenShift AI brengt open-source tools en enterprise-ondersteuning samen, wat een naadloze samenwerking tussen data scientists, ML engineers en DevOps-teams mogelijk maakt. Het ondersteunt aangepaste modellen evenals integratie met open-source en commerciële LLMs, en biedt een veilige en compliant infrastructuur voor gevoelige workloads.
Belangrijkste kenmerken

Ray is een schaalbaar, gedistribueerd computing-framework ontworpen voor het bouwen en implementeren van AI-toepassingen — van het trainen van LLMs tot het serveren ervan met een hoge doorvoer. Het kan volledig on-premise worden geïmplementeerd, wat het een uitstekende keuze maakt voor organisaties die volledige controle over de infrastructuur nodig hebben.
Ray drijft moderne AI-stacks zoals vLLM, DeepSpeed en Hugging Face Transformers aan, en ondersteunt schaalbare inference via Ray Serve. Met native ondersteuning voor Kubernetes en GPU-scheduling kunnen Ray-clusters veilig draaien in private datacenters voor LLMOps-workloads.
Belangrijkste kenmerken:

IBM Watson AI is een suite van AI-diensten en -tools die is ontworpen om enterprises te helpen kunstmatige intelligentie te integreren in hun workflows, met een sterke nadruk op vertrouwen, transparantie en governance. Nu het onderdeel is van IBM watsonx, omvat het platform watsonx.ai voor het bouwen en finetunen van modellen, watsonx.data voor schaalbaar databeheer, en watsonx.governance om verantwoord AI-gebruik gedurende de gehele levenscyclus te garanderen.
Watson AI is geoptimaliseerd voor hybride cloud- en on-premise omgevingen met behulp van IBM Cloud Pak for Data en Red Hat OpenShift, waardoor enterprises de volledige controle behouden over hun data en modelimplementatie. Het ondersteunt foundation models, het finetunen van aangepaste modellen en integratie met open-source LLMs, allemaal ondersteund door enterprise SLAs.
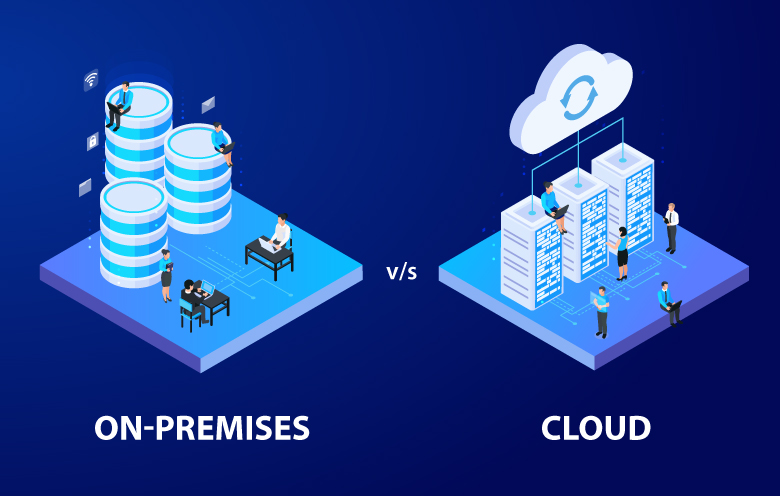
On-Premise GenAI biedt enterprises volledige controle over hun infrastructuur, modellen en data. Het is de voorkeurskeuze voor organisaties die actief zijn in sterk gereguleerde sectoren zoals de gezondheidszorg, de financiële sector of de overheid, waar naleving van privacy-normen zoals GDPR en HIPAA cruciaal is. On-premise-implementaties stellen teams in staat om gevoelige data binnen hun eigen omgevingen te houden, het gedrag van modellen aan te passen en de infrastructuur te optimaliseren voor voorspelbare kosten op de lange termijn. Hoewel de initiële instelling meer inspanning en investeringen kan vergen, biedt het grotere flexibiliteit, controleerbaarheid en integratie met interne systemen.
Cloud GenAI daarentegen biedt snelheid, schaalbaarheid en gemak. Het stelt teams in staat om snel AI-toepassingen te prototypen en te implementeren zonder zich zorgen te hoeven maken over infrastructuurbeheer. Cloudproviders verzorgen de autoscaling, hardware-inrichting en modelupdates, wat zorgt voor een snellere marktintroductie. Het kan echter vragen oproepen over datalocatie, vendor lock-in en onvoorspelbare prijzen op basis van gebruik. Voor veel organisaties komt de keuze neer op het balanceren van compliance-behoeften met operationele wendbaarheid.
Concluderend is on-premise Generatieve AI niet langer alleen een uitwijkoptie voor gereguleerde sectoren. Het wordt snel een strategisch voordeel voor enterprises die datasoevereiniteit, infrastructuurcontrole en schaalbaarheid op de lange termijn vereisen. Oplossingen zoals TrueFoundry, NVIDIA Enterprise AI, Red Hat OpenShift AI, IBM Watson AI en Ray bieden krachtige, production-grade mogelijkheden om GenAI-modellen volledig binnen de eigen infrastructuur van een bedrijf te bouwen en te serveren.
Naarmate AI-systemen complexer worden en de gevoeligheid van data toeneemt, biedt een on-premise-implementatie een toekomstbestendig fundament. Het stelt organisaties in staat om met vertrouwen te innoveren, compliant te blijven en het volledige eigenaarschap van zowel hun modellen als hun data te behouden.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















