



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Veel teams die hun derde of vierde productie-agent uitrollen, opmerken hetzelfde patroon: een groot deel van de code in elk agent-bestand is infrastructuur, geen agent-logica. Retry-wrappers, het laden van credentials, tool-registers, sessiestatus, sandboxing — gekopieerd van de vorige agent met kleine afwijkingen. Een steeds vaker gekozen oplossing is een managed agent layer die deze taken eenmalig overneemt, een beperkte API beschikbaar stelt aan de agent-code en het daadwerkelijke werk routeren via de gateways die het platform al draait. Dit artikel definieert deze laag, doorloopt de vijf componenten en laat zien hoe de AI gateway en MCP gateway hierop aansluiten — met als hoogtepunt Anthropic's release van Managed Agents in april 2026 als een voorbeeld van dezelfde algemene scheiding.
Woensdag bij Northwind. Devi, senior engineer in het platformteam, opens de PR voor de vierde agent die haar team dit kwartaal heeft opgeleverd — een generator voor release notes die is gekoppeld aan de deploy-bot. De diff telt 312 regels. Ze weet uit ervaring dat hooguit 30 van die regels de daadwerkelijke redeneerlus van de agent vormen. De overige ~280 regels bestaan uit dezelfde vijf dingen die ze nu al vier keer heeft geschreven: een tool-register dat MCP server-configuraties uit twee locaties laadt, retry-logica met exponentiële backoff die net niet overeenkomt met de versie van de vorige agent, het laden van credentials uit een mix van omgevingsvariabelen en de secrets manager, sessiestatus die naar Redis wordt gepusht met een op de gok ingestelde TTL, en een cascade van try/except-blokken die rate limits onderscheidt van authenticatiefouten en provider-uitval.
Met vier agents in productie betekent dat ongeveer 1.120 regels aan infrastructuurcode verspreid over het team, waarbij elke kopie subtiel is afgeweken. Wanneer het rate-limit-beleid van de provider volgende maand wijzigt, zijn er vier PR's nodig om het te herstellen. Wanneer de procedure voor het roteren van credentials verandert, volgen er nog eens vier. De agent-logica zelf — het deel dat beslist welke tool wanneer moet worden aangeroepen — is het kleinste en minst gewijzigde onderdeel van elk bestand. De infrastructuur eromheen is wat de tijd van de engineers opslokt.
De oplossing is niet een betere kopieer-en-plakdiscipline. Het patroon waarvoor dit artikel pleit, is een laag tussen de agent-code en de runtime die de infrastructuur eenmalig beheert, zodat de agent-code puur agent-code kan blijven. Het is één architectuur uit meerdere — workflow-grafieken en durable-execution-engines zijn geldige alternatieven — maar het is degene die het meest duidelijk naar voren is gekomen in recente provider-managed-agent-producten, en waar de gateway-primitieven van TrueFoundry direct op aansluiten.
Hier is hoe de verstrengelde versie van een van Devi's agents er verkort uitziet. Het volledige bestand telt ongeveer 200 regels; hieronder staan de eerste 35.
Python — naïeve agent, infrastructuur gemengd met logica (verkort)
Niets hiervan is de agent zelf. Het is het substraat waarop de agent draait. En elke agent die het team oplevert, heeft zijn eigen licht afgeweken kopie van dit alles, omdat er geen laag is die het beheert.
De managed agent layer is de abstractie die het substraat beheert. Het stelt drie beperkte API's beschikbaar aan de agent-code, en verder niets:
Python — de API-interface die de beheerde laag beschikbaar stelt aan agent-code
Agent-code is verantwoordelijk voor drie dingen en uitsluitend drie dingen: het doel (wat de agent probeert te bereiken), de redeneerlus (wanneer welke tool moet worden aangeroepen en hoe resultaten geïnterpreteerd moeten worden) en het uitvoerformaat (wat de agent retourneert wanneer hij klaar is). Al het andere — authenticatie, retries, sandboxing, statuspersistentie, observabiliteit — behoort toe aan de runtime. Opvallend is dat er geen get_credential-methode is: geheimen stromen niet door de agent-code, zelfs niet op verzoek.
Hier is dezelfde code-review-agent op de beheerde laag. De PR is nu kleiner dan het oude testbestand:
Python — dezelfde agent op de beheerde laag, pure logica
Geen credentials. Geen retry-lus. Geen statuscode. Geen provider-SDK. De infrastructuur die voorheen in elk agent-bestand leefde, bevindt zich nu eenmalig in de runtime, waar deze onafhankelijk kan worden getest, van versies voorzien en uitgerold.
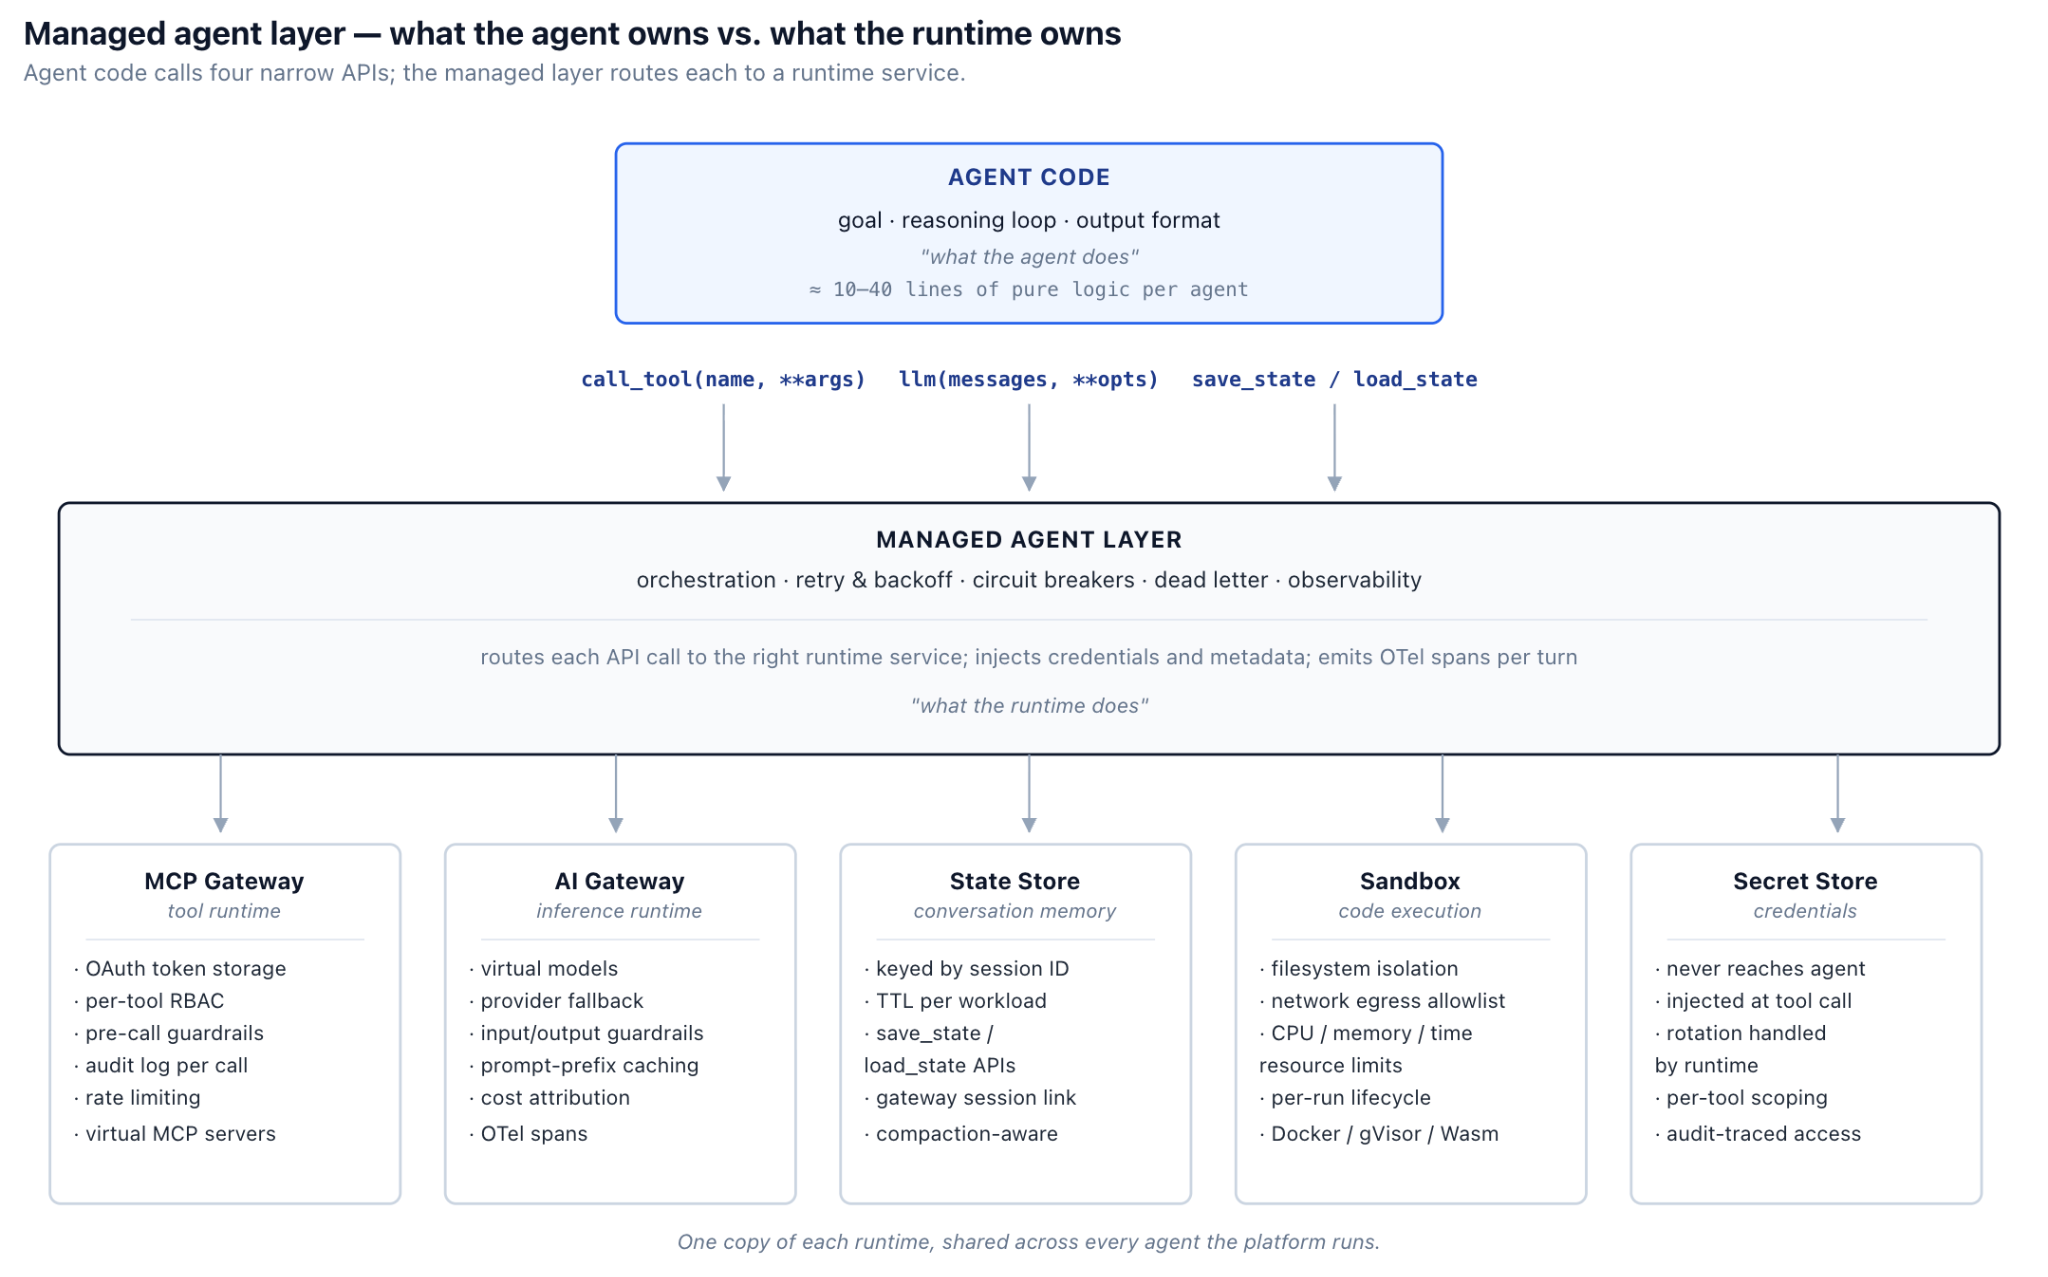
Orchestratie. In een managed-runtime-architectuur beheert de runtime de agent-lus — het aanroepen van de redeneerstap van de agent, het analyseren van de model-uitvoer voor tool-calls, het afhandelen daarvan, het terugkoppelen van resultaten en het detecteren van de beëindiging. (Workflow-graph en durable-execution stijlen draaien dit om — de agent beheert de grafiek en de runtime biedt primitieven; de afweging is een explicietere besturingsstroom ten koste van meer machinerie aan de agent-zijde.) Stopcondities zijn niet-triviaal in beide modellen: een expliciete "klaar" vanuit het model, een uitvoer die geen tool meer aanvraagt, een harde limiet op het aantal beurten om oneindige lussen te voorkomen, of een vastloopdetector die geactiveerd wordt wanneer de agent drie beurten op rij dezelfde tool met dezelfde argumenten aanroept.
Sandboxing. Een coding-agent die tests uitvoert om zijn eigen wijzigingen te verifiëren, heeft een geïsoleerde executie-omgeving nodig — geen toegang tot het hostsysteem buiten een aangewezen werkruimte, geen uitgaand netwerk behalve naar de AI gateway en geregistreerde MCP servers, en harde limieten voor CPU, geheugen en kloktijd. De sandbox is per run en eenmalig te gebruiken.
Statusbeheer. Tussen beurten door moeten de gespreksgeschiedenis, het kladblok van de agent, tussenliggende tool-resultaten en voortgangsindicatoren ergens worden opgeslagen. De runtime biedt save_state en load_state aan gekoppeld aan de sessie-ID, met een TTL die is afgestemd op de werklast.
Credential-injectie. Agent-code krijgt nooit een ruw geheim te zien. De runtime haalt credentials op uit een secret store en injecteert deze op het moment van de tool-call — doorgaans als een Authorization-header die de agent-code nooit kan lezen. Hetzelfde mechanisme verwerkt rotaties: wanneer een credential wordt geroteerd, gebruikt de volgende tool-call de nieuwe waarde zonder dat er wijzigingen in de agent-code nodig zijn.
Retry en foutafhandeling. Exponentiële backoff voor rate limits, circuit breakers voor provider-uitval en een dead-letter queue voor runs die mislukken na het uitputten van de retries. De runtime categoriseert elke fout — tijdelijk, permanent, authenticatie — en past het juiste beleid toe. Agent-code ziet ofwel een succesvol resultaat of een definitieve, gecategoriseerde uitzondering, niet de ruwe retry-status.
De llm() API van de beheerde laag roept niet rechtstreeks een provider-SDK aan. Deze routeert via de AI gateway, die het probleem van provider-koppeling namens de agent overneemt.
Python — wat een agent NIET doet, versus wat de runtime ervoor doet
De ontkoppeling is structureel. Agent-code weet niet — en hoeft niet te weten — of de aanroep naar OpenAI, Anthropic of een zelfgehost model ging. Wanneer het platformteam een nieuwe provider toevoegt, van model wisselt of een nieuwe guardrail uitrolt, zijn er geen PR's voor agents nodig. Het contract van de agent is de API-interface, niet de upstream-provider.
Hetzelfde patroon geldt voor tools. Agent-code roept call_tool() aan met een logische naam; de MCP gateway herleidt deze naar een specifieke MCP server, injecteert het juiste OAuth-token, past RBAC toe, voert guardrails uit vóór executie, logt de aanroep en retourneert het resultaat.
Python — agent-code die een tool aanroept via de MCP gateway
Achter die interface bewaart de gateway de OAuth-tokens voor elke MCP server die het platform ondersteunt, gekoppeld aan de identiteit van de aanroepende gebruiker of service. De gateway ververst ze wanneer ze verlopen. Het dwingt RBAC af op het niveau van afzonderlijke tools — "deze agent kan github.get_pr_diff aanroepen, maar niet github.create_pr" — onafhankelijk van wat de code van de agent zegt. Het logt elke aanroep met argumenten, retourwaarden en de ID's van de aanroepende agent en sessie, wat zorgt voor een gecentraliseerde audit-log voor toolgebruik over het gehele platform (rekening houdend met de gebruikelijke praktijk — log-pipelines kunnen gegevens verliezen, samplen of vertraging oplopen). De MCP Gateway van TrueFoundry voegt hier een virtuele MCP server-abstractie aan toe: één enkel logisch eindpunt dat tools van meerdere fysieke MCP servers aggregeert, zodat de tool-lijst van een agent niet verandert als backend-implementaties wijzigen.
Het contract voor agent-code is hetzelfde als dat van de AI gateway: roep de API aan met een logische naam, ontvang het resultaat en laat de runtime de credentials afhandelen.
Wanneer een agent code uitvoert — een coding-agent die tests draait, een data-agent die Python op een CSV-bestand uitvoert, of een tooling-agent die een willekeurig shell-commando uitvoert — moet die code draaien in een omgeving die geïsoleerd is van de host. De drie serieuze opties in mei 2026, met indicatieve koude-starttijden (werkelijke cijfers hangen sterk af van de image-grootte, warm pools, snapshotting en node-status):
De keuze is een functie van tenancy en latency. Een single-tenant agent die een lange coderingssessie per taak uitvoert, gebruikt Docker — de kosten van de koude start worden eenmalig gemaakt en gemiddeld over honderden code-executies. Een multi-tenant platform dat niet-vertrouwde agent-code verwerkt, gebruikt gVisor — de gedeelde kernel van standaard containers is een reëel risico bij willekeurige code. Een latency-gevoelige werklast die een sandbox per tool-call uitvoert (een rekenmachine-tool, een regex-tool), gebruikt Wasm — een koude start van één seconde per aanroep is onacceptabel wanneer de aanroep zelf slechts twintig milliseconden duurt.
Niets hiervan is de verantwoordelijkheid van de agent. De runtime biedt de interface "voer deze code uit, hier is het resultaat" en kiest de juiste sandbox voor de specifieke categorie werklast.
Waar het werkgeheugen van de agent tussen beurten blijft bestaan, kent drie serieuze opties:
De meeste productie-agents gebruiken uiteindelijk een combinatie: een gateway-sessie voor de gespreksamenvatting en observabiliteit, een externe store voor het expliciete kladblok en de voortgangsindicatoren van de agent, en in-context voor de meest recente beurten. De runtime stelt save_state en load_state beschikbaar als de API voor de agent, ongeacht welke backend eronder ligt.
Anthropic's Managed Agents, in publieke bèta sinds 9 april 2026 (bèta-header: managed-agents-2026-04-01), kan worden gezien als een voorbeeld van dezelfde algemene scheiding tussen agent-logica en executie-infrastructuur. Hun "meta-harness"-architectuur biedt componenten die overeenkomen met het grootste deel van wat in dit artikel wordt beschreven: een georchestreerde agent-lus, geïsoleerde code-execution (aanvankelijk gehost door Anthropic, met zelfgehoste sandboxes toegevoegd in een latere release), sessiecontinuïteit met statusvol pauzeren en hervatten, credential-beheer voor externe systemen en observabiliteit via traces. Anthropic gebruikt zelf de metafoor van brein-en-handen: Claude plus de harness draait op de infrastructuur van Anthropic (het brein); de sandbox waarin shell-commando's en code worden uitgevoerd, vormt de handen.
Voor teams die agents bouwen op één enkele provider, is het product van Anthropic de eenvoudigste weg — de harness staat standaard ingeschakeld voor elk Claude API-account, en de API-interface is de nieuwe managed-agents bèta-header. Voor teams die agents over meerdere providers draaien, of specifieke eisen hebben voor sandboxing en tooling, kan hetzelfde patroon worden opgebouwd uit gateway-primitieven: een AI gateway als inference-runtime (multi-provider, waarbij kostentoewijzing en budgethandhaving behouden blijven uit eerdere artikelen in deze reeks), een MCP gateway als tool-runtime, en een sandbox- en statusbeheerlaag die door het platformteam wordt beheerd. De AI Gateway en MCP Gateway van TrueFoundry zijn twee van deze lagen die we als product leveren; de bovenliggende orchestratie- en sandboxlagen zijn bewust pluggbaar gelaten, omdat daar de werklastspecifieke beslissingen worden genomen.
Is de managed agent layer niet gewoon een framework zoals LangGraph of AutoGen?
Frameworks zoals LangGraph en AutoGen zijn bibliotheken voor de agent-lus — ze beheren het orchestratiecomponent van wat dit artikel de managed layer noemt, maar laten credentials, sandboxing, statuspersistentie en provider-routing doorgaans over aan de applicatie. Een managed agent layer in de hier gebruikte betekenis beheert al deze aspecten en draait ze als platforminfrastructuur in plaats van als code binnen het proces van de agent.
Wat zijn de alternatieven voor een managed runtime en wanneer zijn ze beter?
De belangrijkste alternatieven, in volgorde van mate van verschil:
Dit artikel pleit voor één specifieke architectuur. Geen van deze opties is verkeerd; ze bevinden zich op verschillende punten op de schaal van flexibiliteit versus operationele consistentie.
Wat zijn de nadelen van een managed runtime?
Vier nadelen om eerlijk over te zijn. (1) Minder lokale flexibiliteit — agent-code kan de runtime niet omzeilen voor specifieke credential-afhandeling per tool of aangepast retry-beleid. (2) Lastiger experimenteren — het lokaal uitvoeren van een agent vereist nu dat de runtime beschikbaar is, niet alleen een Python-interpreter. (3) Runtime lock-in — het migreren van een agent naar een andere runtime is een serieuze migratie, geen kwestie van hercompileren. (4) Abstractielekkage bij problemen — het debuggen van een mislukte agent vereist redeneren over de logica van de agent, de orchestratie van de runtime én de onderliggende gateways, met drie log-streams die gecorreleerd moeten worden. Dit artikel stelt dat deze nadelen meestal opwegen tegen de voordelen zodra er meer dan drie of vier agents in productie draaien; voor een eerste agent is dat vaak nog niet het geval.
Als Anthropic managed agents als product levert, waarom zou je dan zelf iets bouwen?
Voor agents die volledig op Claude draaien, is het managed-agents-product van Anthropic meestal de eenvoudigste weg. De situaties waarin teams hun eigen oplossing bouwen, hebben vaak te maken met multi-provider routing (dezelfde agent draaien tegen verschillende modellen voor verschillende werklasten), werklastspecifieke sandboxing (een eigen gVisor-pool voor niet-vertrouwde code) of integratie met bestaande platforminfrastructuur (een enterprise secrets manager, een bestaande observabiliteitsstack). Het patroon blijft hetzelfde; de vraag is wat er wordt ingekocht versus zelf geassembleerd.
Hoe werkt dit voor agents die geen code uitvoeren?
Het sandbox-component is optioneel. Een agent die louter tools gebruikt — en die MCP-calls orchestreert en gestructureerde uitvoer genereert — heeft geen code-execution nodig, waardoor de runtime de sandbox volledig kan overslaan. De overige vier componenten (orchestratie, status, credentials, retry) blijven van toepassing.
Hoe ziet de runtime eruit bij streaming antwoorden of gedeeltelijke uitvoer?
De llm() API biedt zowel batched- als streaming-varianten. Bij streaming ontvangt de agent-code een async iterator van chunks; de runtime verwerkt de onderliggende provider-stream, past guardrails toe op de uitvoer naarmate chunks binnenkomen en verzendt OTel-spans per beurt zodra de stream sluit.
Hoe wordt dit getest? Je kunt iets dat afhankelijk is van een LLM en een sandbox toch niet unit-testen?
De managed layer is juist wat agents testbaar maakt. De drie API's (call_tool, llm, save_state/load_state) vormen de volledige afhankelijkheidsinterface van de agent, en elk daarvan kan worden gemocked of opnieuw afgespeeld. Een testsuite combineert typisch een deterministische mock-llm met opgenomen tool-antwoorden, zodat de redeneerlus van de agent getest kan worden zonder een provider of sandbox te raken. De runtime zelf wordt afzonderlijk getest op het platformniveau.
Waar past TrueFoundry in dit geheel?
De TrueFoundry AI Gateway en MCP Gateway bieden de inference- en tool-runtimelagen van de hier beschreven architectuur — model-routing met provider-fallback, guardrails, kostentoewijzing en budgetten aan de AI-zijde; OAuth-afhandeling, RBAC, virtuele MCP servers en audit-logging aan de tool-zijde. De bovenliggende orchestratie-, sandbox- en statusbeheerlagen worden bewust beheerd door het platformteam, omdat daar de werklastspecifieke beslissingen liggen. Voor teams die een volledig verticaal beheerd product op Claude willen, is Managed Agents van Anthropic de juiste vergelijking.
De praktische eerste stap voor een team dat zijn derde of vierde agent heeft geschreven en het patroon uit Devi's PR herkent, is het abstraheren van de call_tool / llm / save_state interface naar een kleine gedeelde bibliotheek en het routeren van elke aanroep via de gateways die het platform al draait. Credentials en authenticatie per tool worden vanaf het begin door de runtime beheerd en lopen nooit door de agent-code. Al het andere volgt uit dat contract.
Northwind, Devi en de codebase met vier agents dienen ter illustratie; het architecturele patroon, het verstrengelingsprobleem en de op gateways gebaseerde ontkoppeling vormen de manier waarop productie-agent-platformen in 2026 daadwerkelijk worden gebouwd, waarvan Anthropic's Managed Agents het meest zichtbare voorbeeld van één enkele provider is. TrueFoundry's AI Gateway en MCP Gateway zijn bestaande producten die de inference- en tool-runtimelagen leveren.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















