



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Vraag drie teams wat hun LLM router doet en u krijgt drie antwoorden die geen overlap vertonen. Het ene team draait GPT-4o op zowel Azure als OpenAI en wil dat het dataverkeer een storing overleeft. Het andere team zag de factuur en wil dat de eenvoudige 70% van de requests wordt afgehandeld door iets goedkopers. Het derde team heeft een Duitse dochteronderneming waarvan de prompts de EU niet mogen verlaten. Alle drie hebben ze een andere configuratie nodig, en twee van de drie zouden niets hebben aan wat de andere heeft gebouwd.
Het is de moeite waard om de typologie precies te formuleren, omdat dit is wat de meeste content over llm routing overslaat:
De sleutel ligt in wat er wordt uitgelezen om een beslissing te nemen. Load balancing leest de status van de infrastructuur, modelselectie leest de request body, datarouting leest metadata en identiteit. Drie soorten input, dus drie functionaliteiten — en ze vullen elkaar aan in plaats van te concurreren.
Dit is de oudste en minst spectaculaire betekenis van het woord, en precies daarom is het de meest betrouwbare. U heeft meerdere manieren om dezelfde functionaliteit te bereiken — azure/gpt-4o en openai/gpt-4o, of twee deployments in verschillende regio's — en u wilt requests hierover verdelen zodat één enkel probleem niet tot downtime leidt.
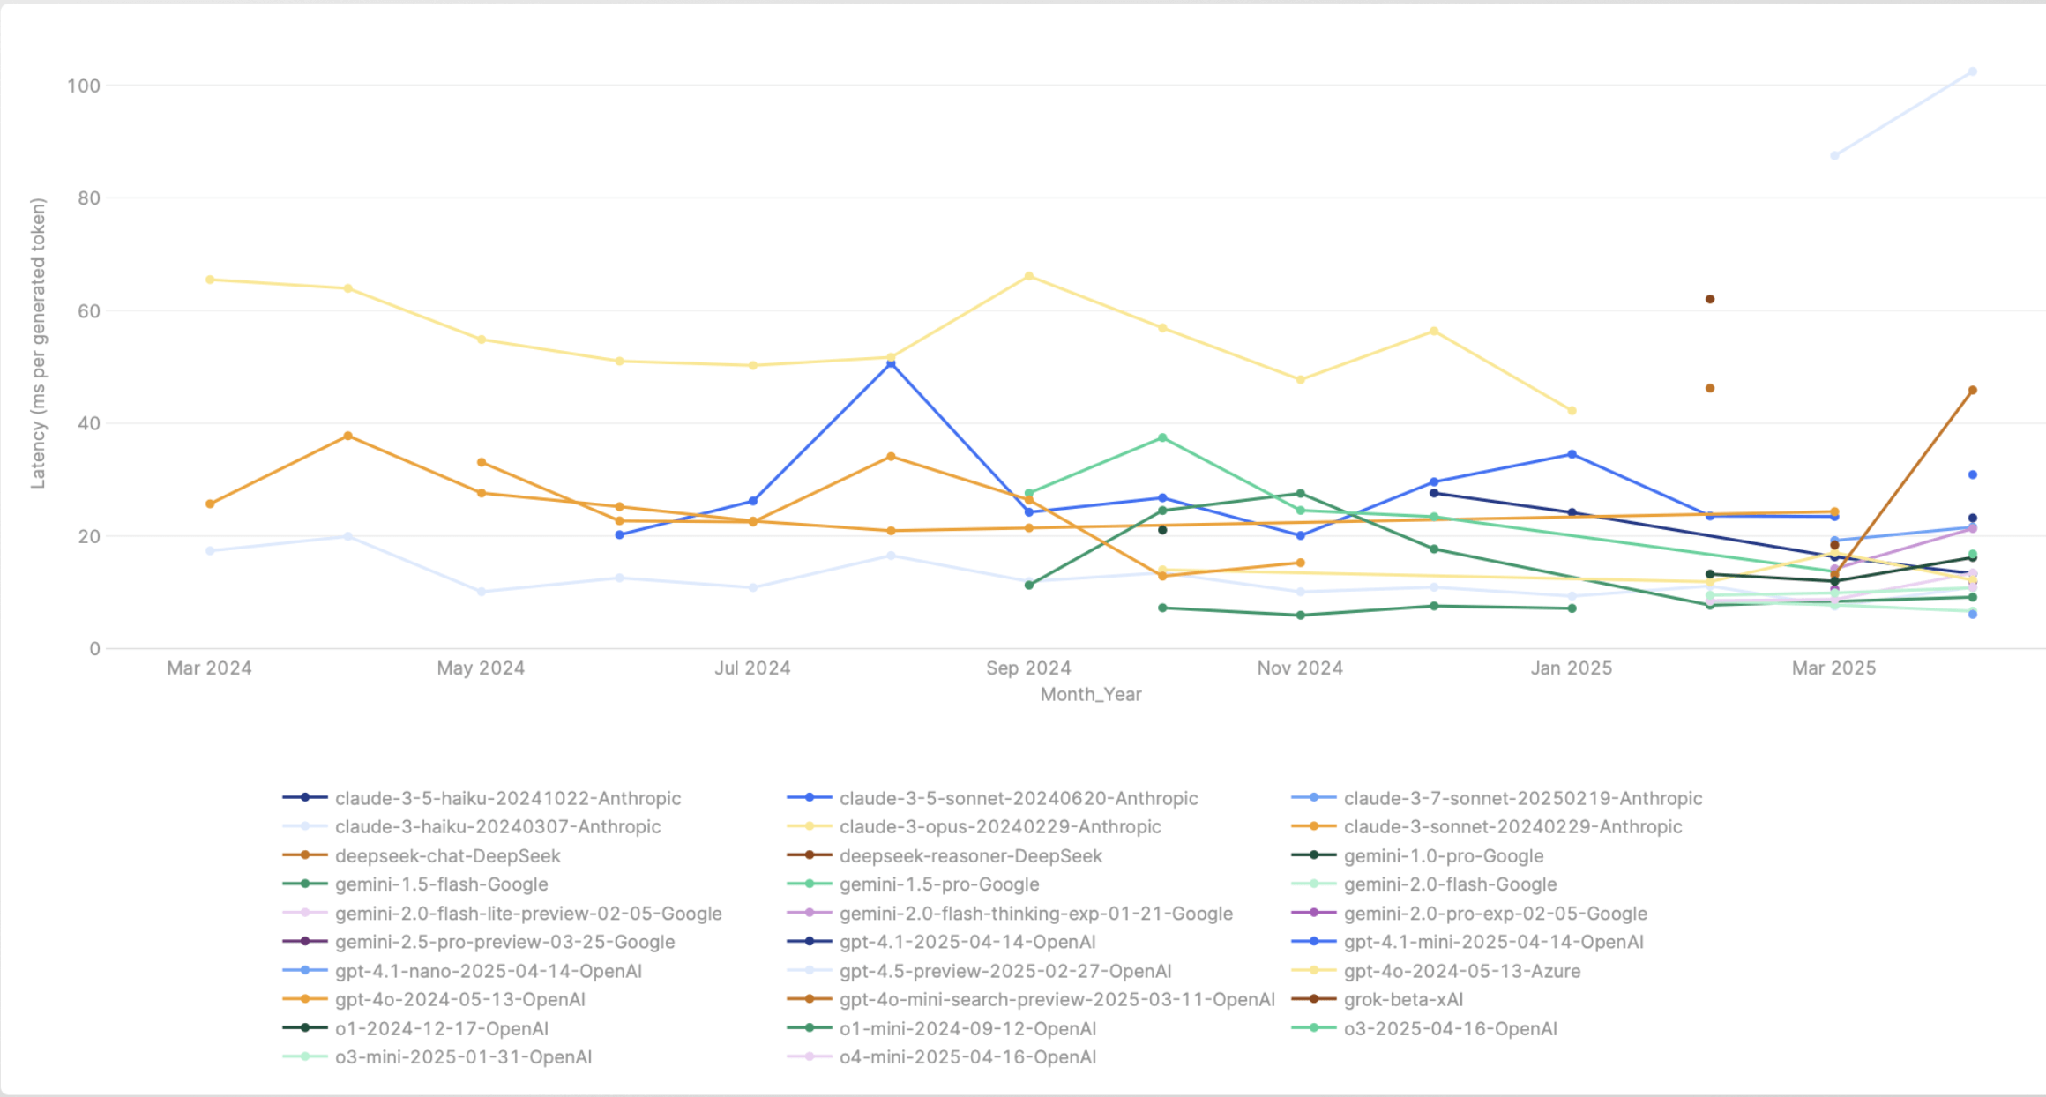
Het uitgangspunt is dat elke target gelijkwaardig is qua resultaat. Elk target zou de request kunnen afhandelen; u kiest op basis van beschikbaarheid, capaciteit en snelheid. Dat maakt llm load balancing veilig om te automatiseren. En de latentie van een provider is niet stabiel genoeg om te negeren — deze varieert per model, regio, provider en tijdstip van de dag:
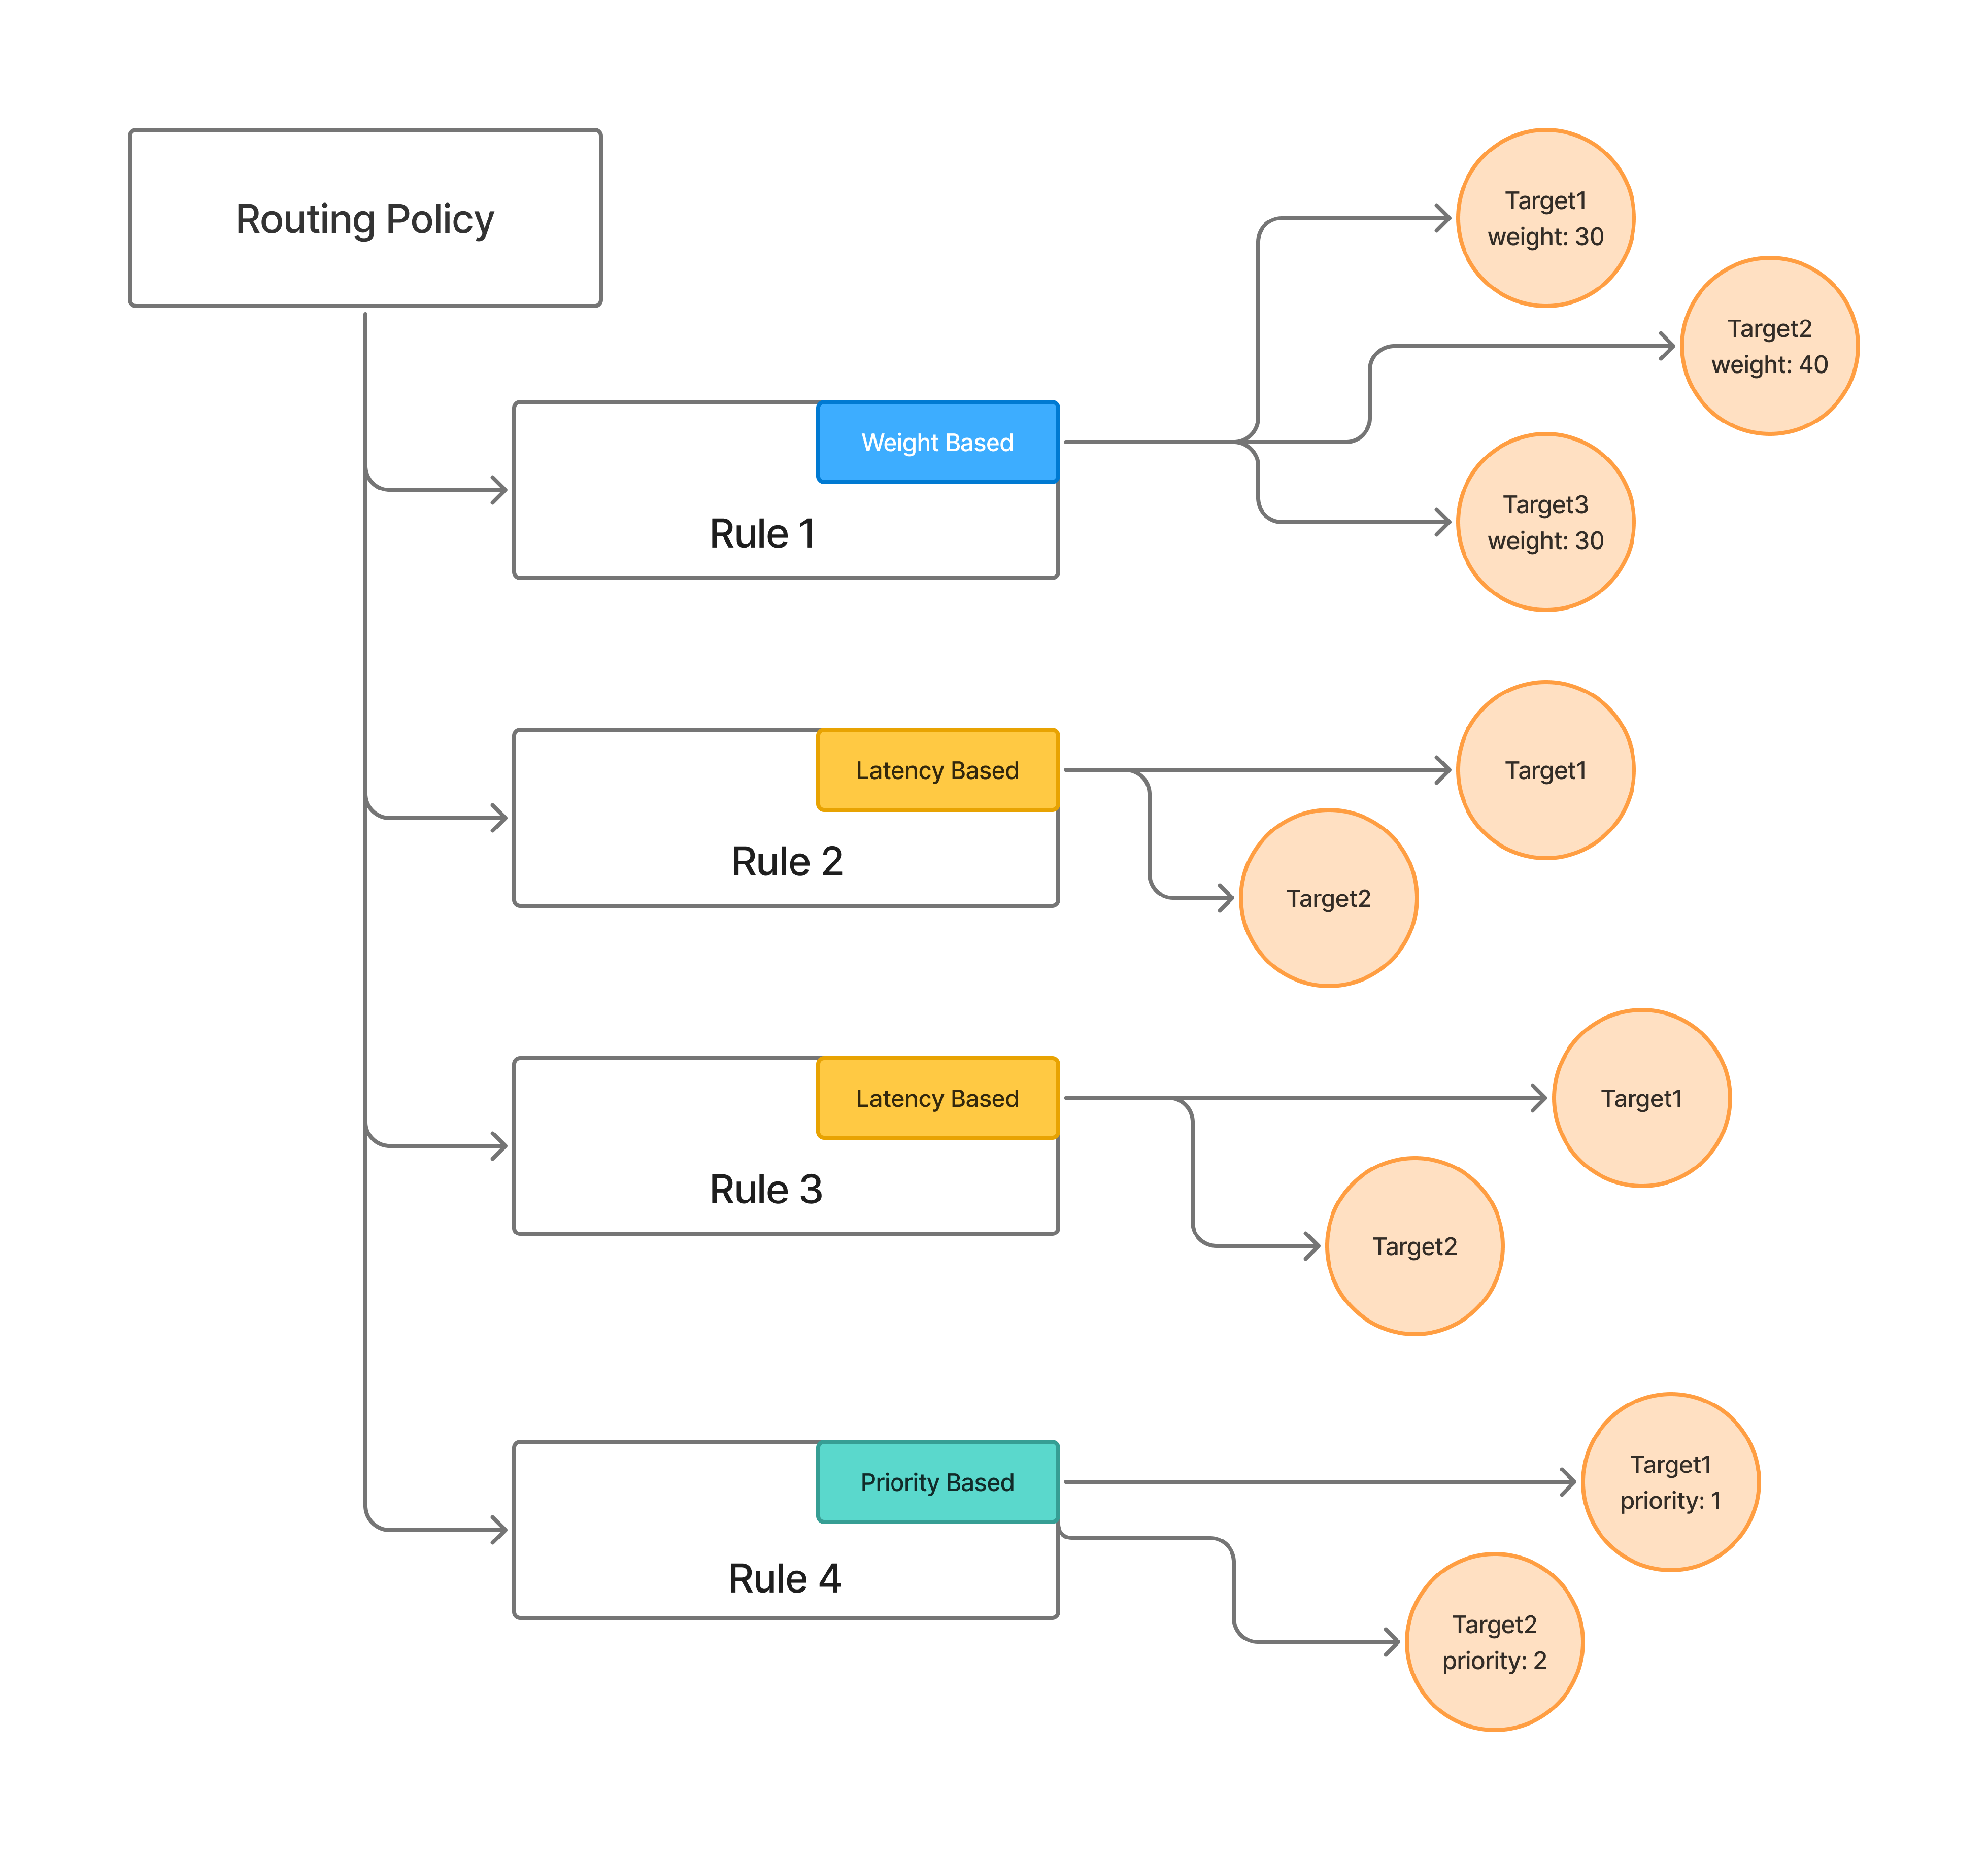
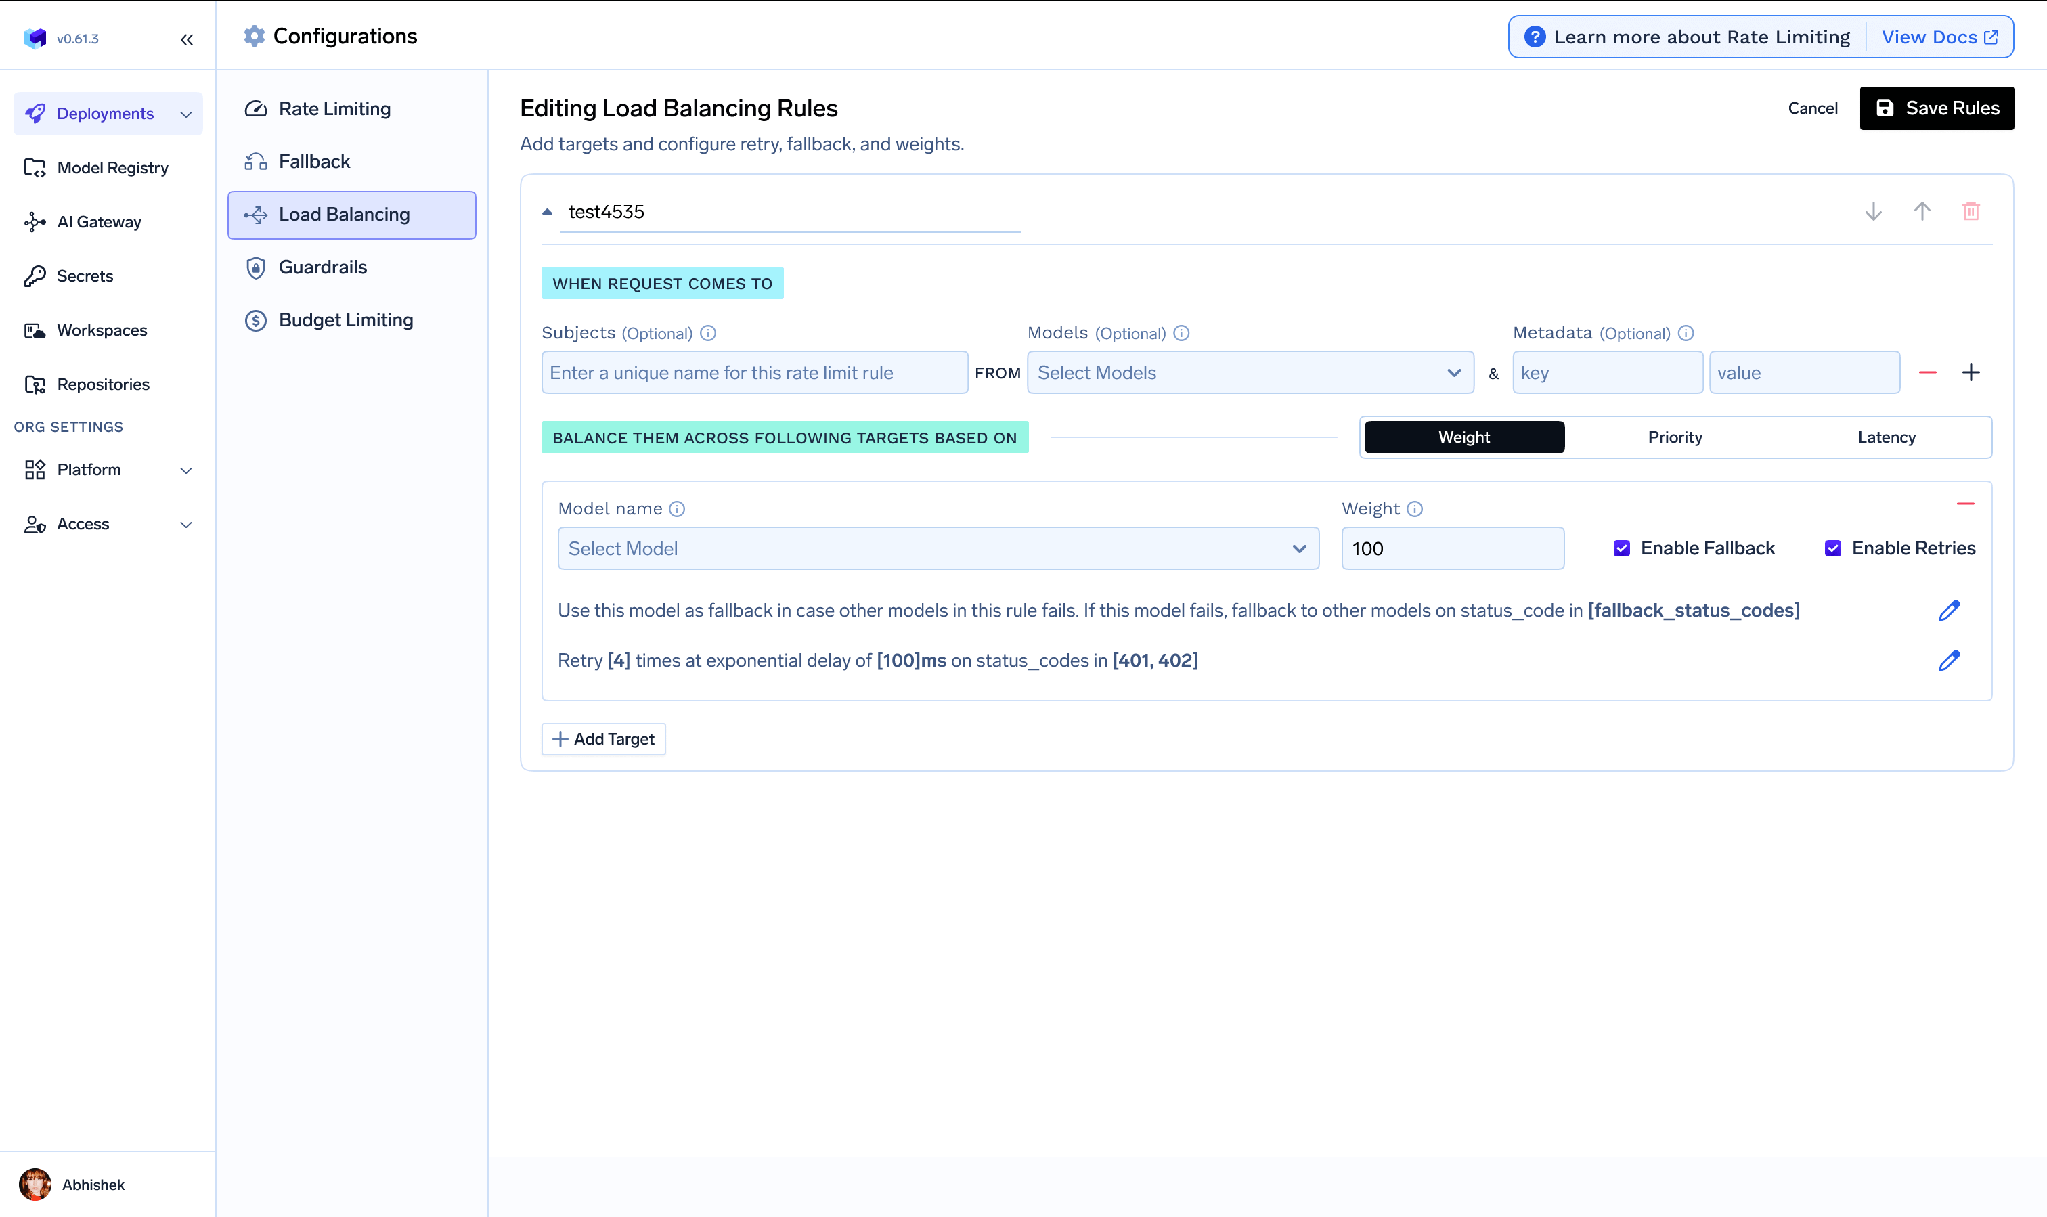
TrueFoundry configureert dit op een virtueel model — een naam die uw applicatie aanroept, zoals my-group/production-chat, met één routingstrategie en een lijst met echte targets erachter. Drie strategieën vallen onder load balancing:
Twee details onderscheiden deze aanpak van een eenvoudige round robin.
Routing op basis van latentie is ontworpen om sticky te zijn. De gateway meet over de afgelopen 20 minuten de tijd per output-token voor elke target en kiest vervolgens per aanroeper een target die vast blijft staan voor een periode van 10 minuten. Over een groot aantal aanroepers wordt het verkeer omgekeerd evenredig met de latentie verdeeld, maar één specifieke aanroeper blijft lang genoeg dezelfde target gebruiken om te profiteren van prompt caching. U hoeft dit niet te configureren; dit is hoe de strategie werkt.
De status (health) wordt continu gemonitord. Een target die binnen een voortschrijdend venster van twee minuten twee keer een 5xx, 429, 401 of 403 meldt, wordt als ongezond gemarkeerd en naar het einde van de lijst verplaatst. Deze herstelt zodra die fouten buiten het venster vallen. Routing op basis van prioriteit voegt een optionele SLA-drempelwaarde toe: een drempel voor de tijd per output-token of time-to-first-token die de target in prioriteit verlaagt wanneer het voortschrijdend gemiddelde over drie minuten deze overschrijdt.
Regels kunnen ook op tenant-niveau worden geschreven als YAML, die in volgorde worden geëvalueerd waarbij de eerste match geldt:
Een prioriteitsketen met failover bij rate limits:
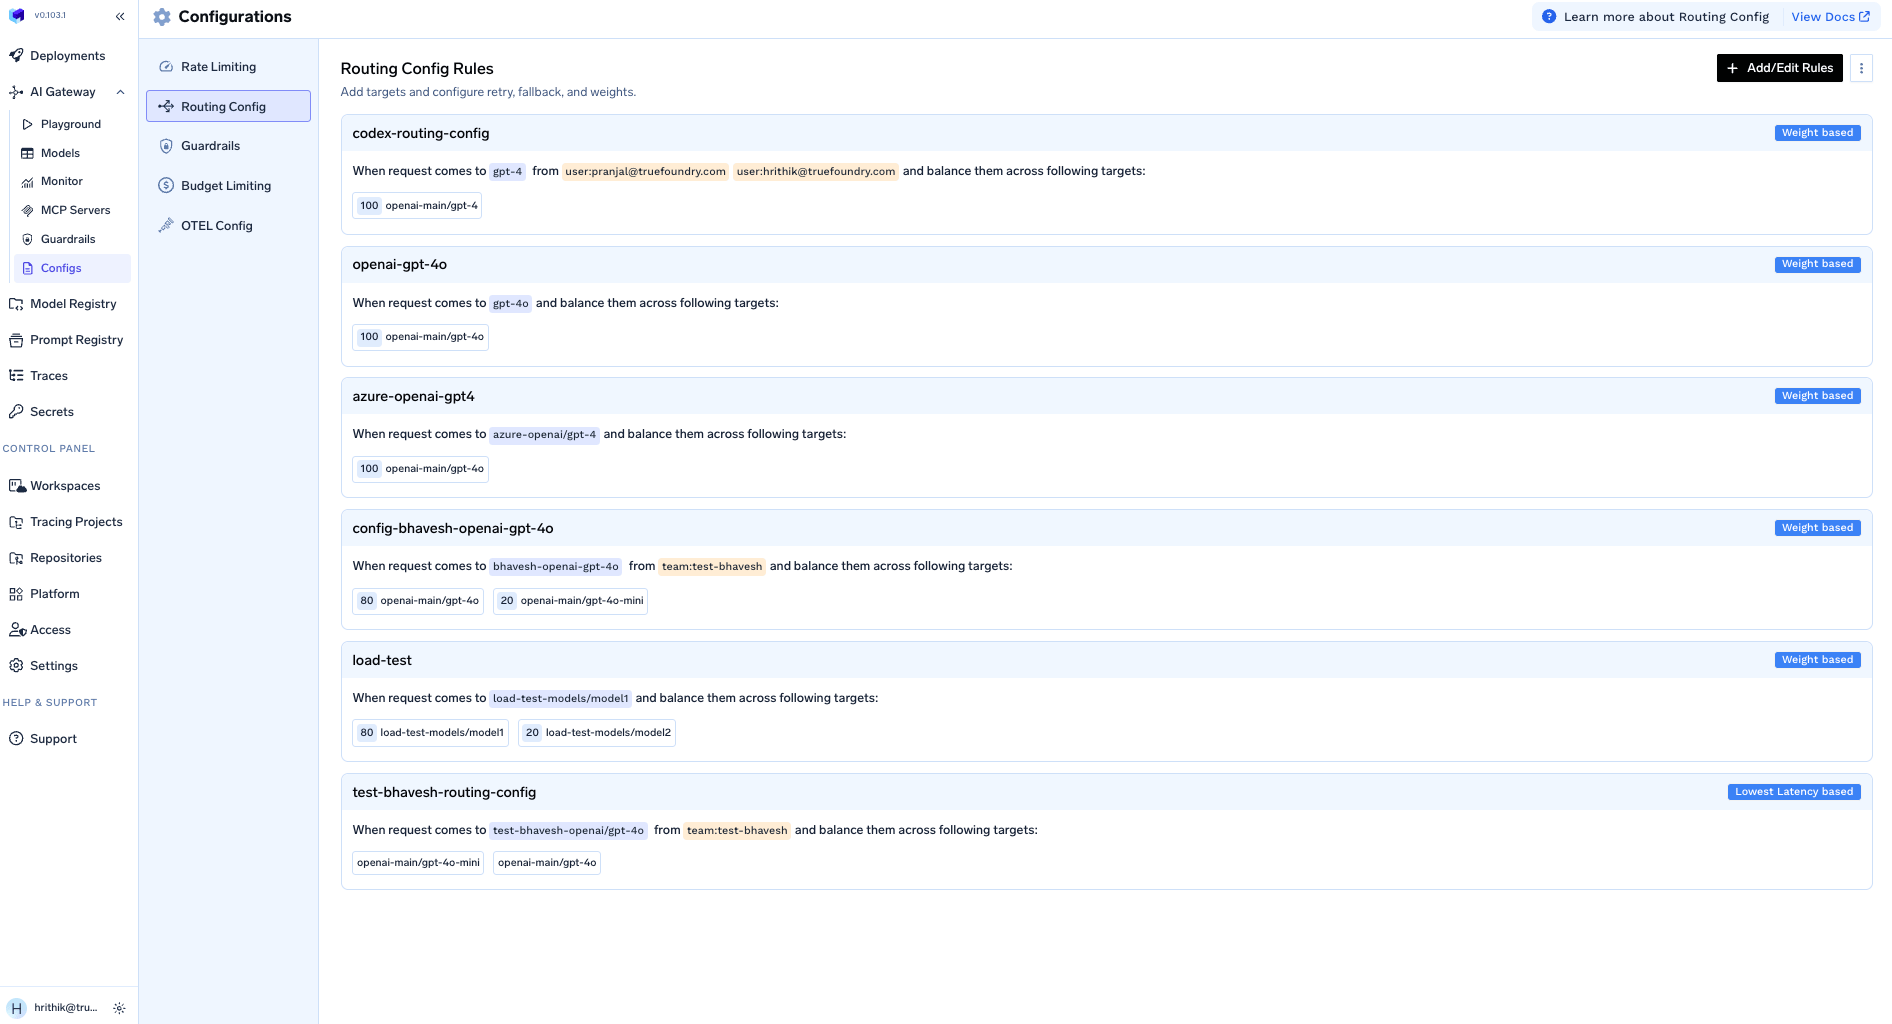
Deze YAML bevindt zich onder AI Gateway → Configs → Routing Config, kan in Git worden beheerd en toegepast met tfy apply, zodat wijzigingen in de routing een PR-review doorlopen. Eén kanttekening: voor nieuwe configuraties adviseert TrueFoundry het gebruik van virtuele modellen. De YAML blijft functioneel voor bestaande deployments, maar virtuele modellen bieden duidelijker eigenaarschap en toegangsbeheer.
Dit is de variant waarnaar gezocht wordt als men zoekt naar de beste llm router, en het is een fundamenteel ander probleem. De targets hier zijn niet inwisselbaar: een goedkoop model en een geavanceerd topmodel geven allebei antwoord, maar niet van dezelfde kwaliteit. De router maakt hier een beoordeling op basis van kwaliteit, niet van capaciteit.
De economische argumenten zijn helder. Productieverkeer is niet uniform complex — een begroeting, een feitelijke opzoeking en een verzoek om een gedistribueerde rate limiter te ontwerpen komen binnen op hetzelfde eindpunt. Als u ze alle drie afhandelt met uw krachtigste model, betaalt u de hoofdprijs voor de eenvoudige meerderheid van de verzoeken.
TrueFoundry’s Auto Routing classificeert elk request in een van de drie tiers en stuurt het naar de target die u voor die tier heeft geconfigureerd. Uw applicatie blijft dezelfde virtuele modelnaam aanroepen.
U kiest Complexity als routingtype bij het aanmaken van het virtuele model:
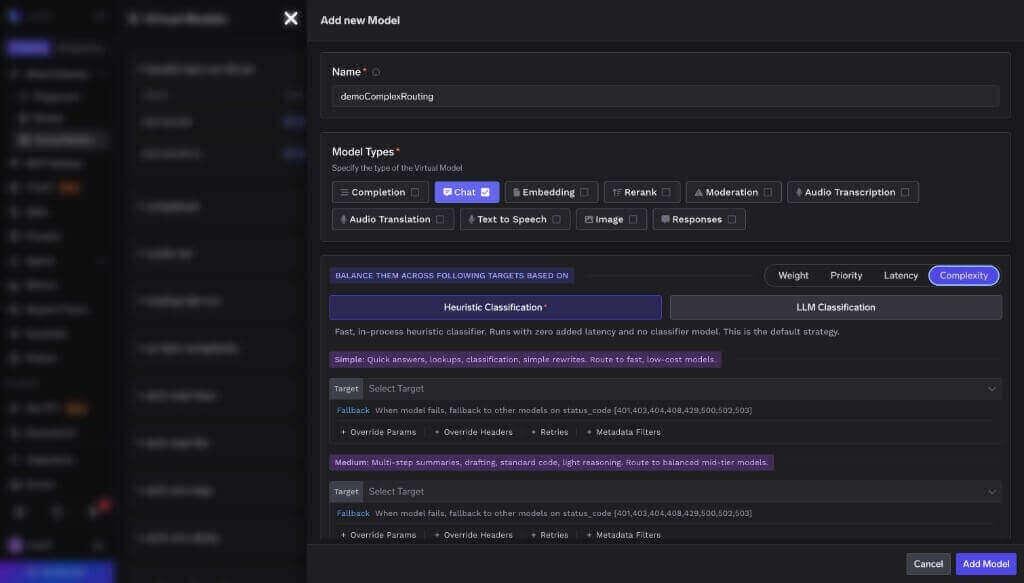
Kies vervolgens hoe requests worden geclassificeerd. Heuristic is de standaardinstelling: in-process, kosteloos, geen extra latentie en volledig deterministisch. Het kent punten toe op basis van een vaste set signalen — trefwoorden in code, redeneerzinnen zoals “stap voor stap”, technisch jargon, promptlengte en structuren met meerdere stappen. Twee afzonderlijke redeneerzinnen leiden altijd tot een routing naar complex, ongeacht wat er verder matche.
De LLM classifier roept in plaats daarvan een klein, snel model aan voor verkeer waarbij de complexiteit niet direct uit het woordgebruik blijkt:
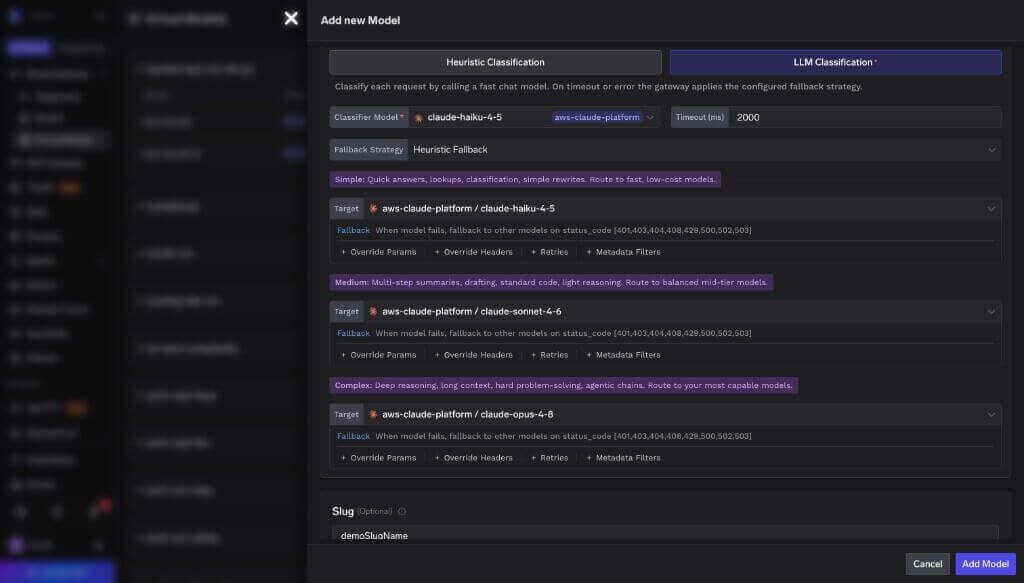
Wees realistisch over de kosten. Elke classifier-aanroep is een factureerbaar gateway-request. Dit verschijnt in uw logs, de tokens worden toegewezen aan dezelfde tenant en subject als het oorspronkelijke request, en het voegt een extra stap toe voordat het uiteindelijke model wordt aangeroepen. De heuristiek is gratis maar globaal; de classifier is nauwkeuriger bij ambigue prompts, maar u betaalt er dubbel voor: in centen en in milliseconden. Een fallback_strategy is verplicht, zodat een timeout van de classifier nooit leidt tot het mislukken van het request.
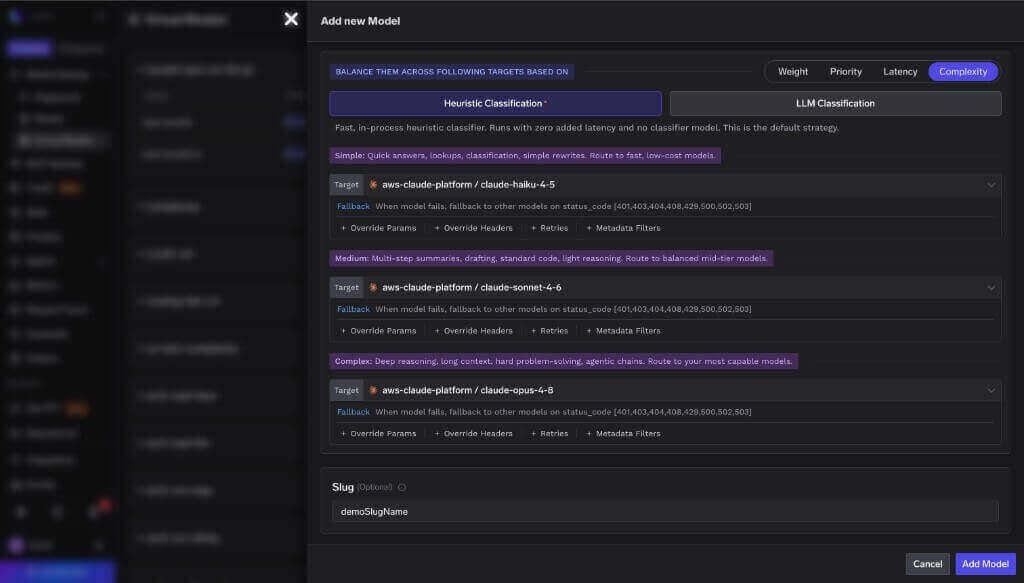
Wijs ten slotte een model toe aan elke tier:
TrueFoundry heeft Auto Routing vergeleken met het sturen van elk request naar één enkel topmodel. De antwoorden werden deterministisch beoordeeld — gegenereerde code werd getest met unit tests, en uitkomsten voor wiskunde en multiplechoicevragen werden vergeleken met een antwoordsleutel.
De gemiddelde latentie dalen van ongeveer 7,6s naar 4,0s, doordat de meeste requests het zware redeneermodel overslaan. [VERIFY — latentiecijfers staan niet in de openbare documentatie, waarin alleen vermeld staat dat Auto Routing “gemiddeld sneller” was.]
Bekijk die 98% realistisch. Het is geen claim dat het downgraden naar een lagere tier kosteloos is. Het is de gemeten omvang van wat u inlevert: twee procentpunt van een beoordeelde slagingspercentage, gekocht voor ongeveer tweederde van de totale rekening. Bij sommige workloads is dat een logische keuze, bij andere niet. Daarom wordt het exacte getal gepubliceerd in plaats van afgerond op “geen kwaliteitsverlies”. Ten opzichte van een topmodel van een vorige generatie ligt de besparing dichter bij de 50%, en de gratis heuristiek verliest nauwkeurigheid bij korte maar complexe prompts. Gemeten in augustus 2026.
De derde variant heeft niets te maken met kosten of doorvoer. Een request van een Duitse dochteronderneming moet mogelijk worden afgehandeld door een Europese deployment, en de loggegevens moeten mogelijk in een EU-bucket blijven. Geen enkele aanpassing in gewichten kan dat afdwingen. Twee zaken worden allebei datarouting genoemd, en TrueFoundry implementeert ze via verschillende functionaliteiten:
Voor de verwerking bevatten targets een metadata_match-blok. Een target blijft alleen beschikbaar wanneer elk sleutel-waardepaar overeenkomt met de vastgestelde metadata van het request. Op de SaaS-gateway wordt elk request automatisch voorzien van de tags tfy_gateway_region en tfy_gateway_zone vanuit de betreffende regio (uit meer dan 12 regio's) die het heeft afgehandeld, zodat de client zelf niets hoeft mee te sturen:
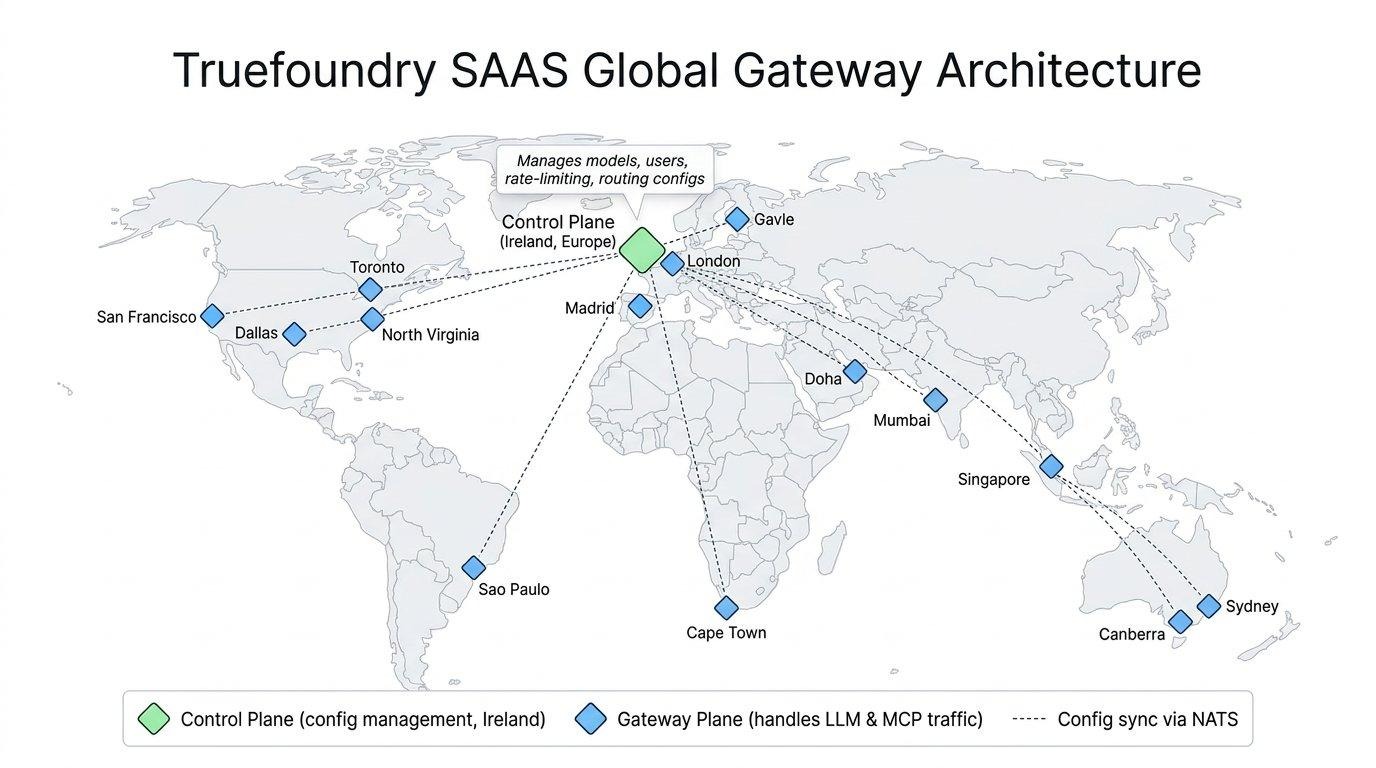
Filteren vindt plaats voordat de volgorde voor load balancing wordt berekend, waardoor een niet-matchende target nooit meedoet. Die volgorde is essentieel: datarouting beperkt de verzameling geschikte targets, load balancing maakt binnen die selectie de keuze.
Voor de opslag is er een afzonderlijke pagina Data Routing onder AI Gateway → Controls → Data Routing:
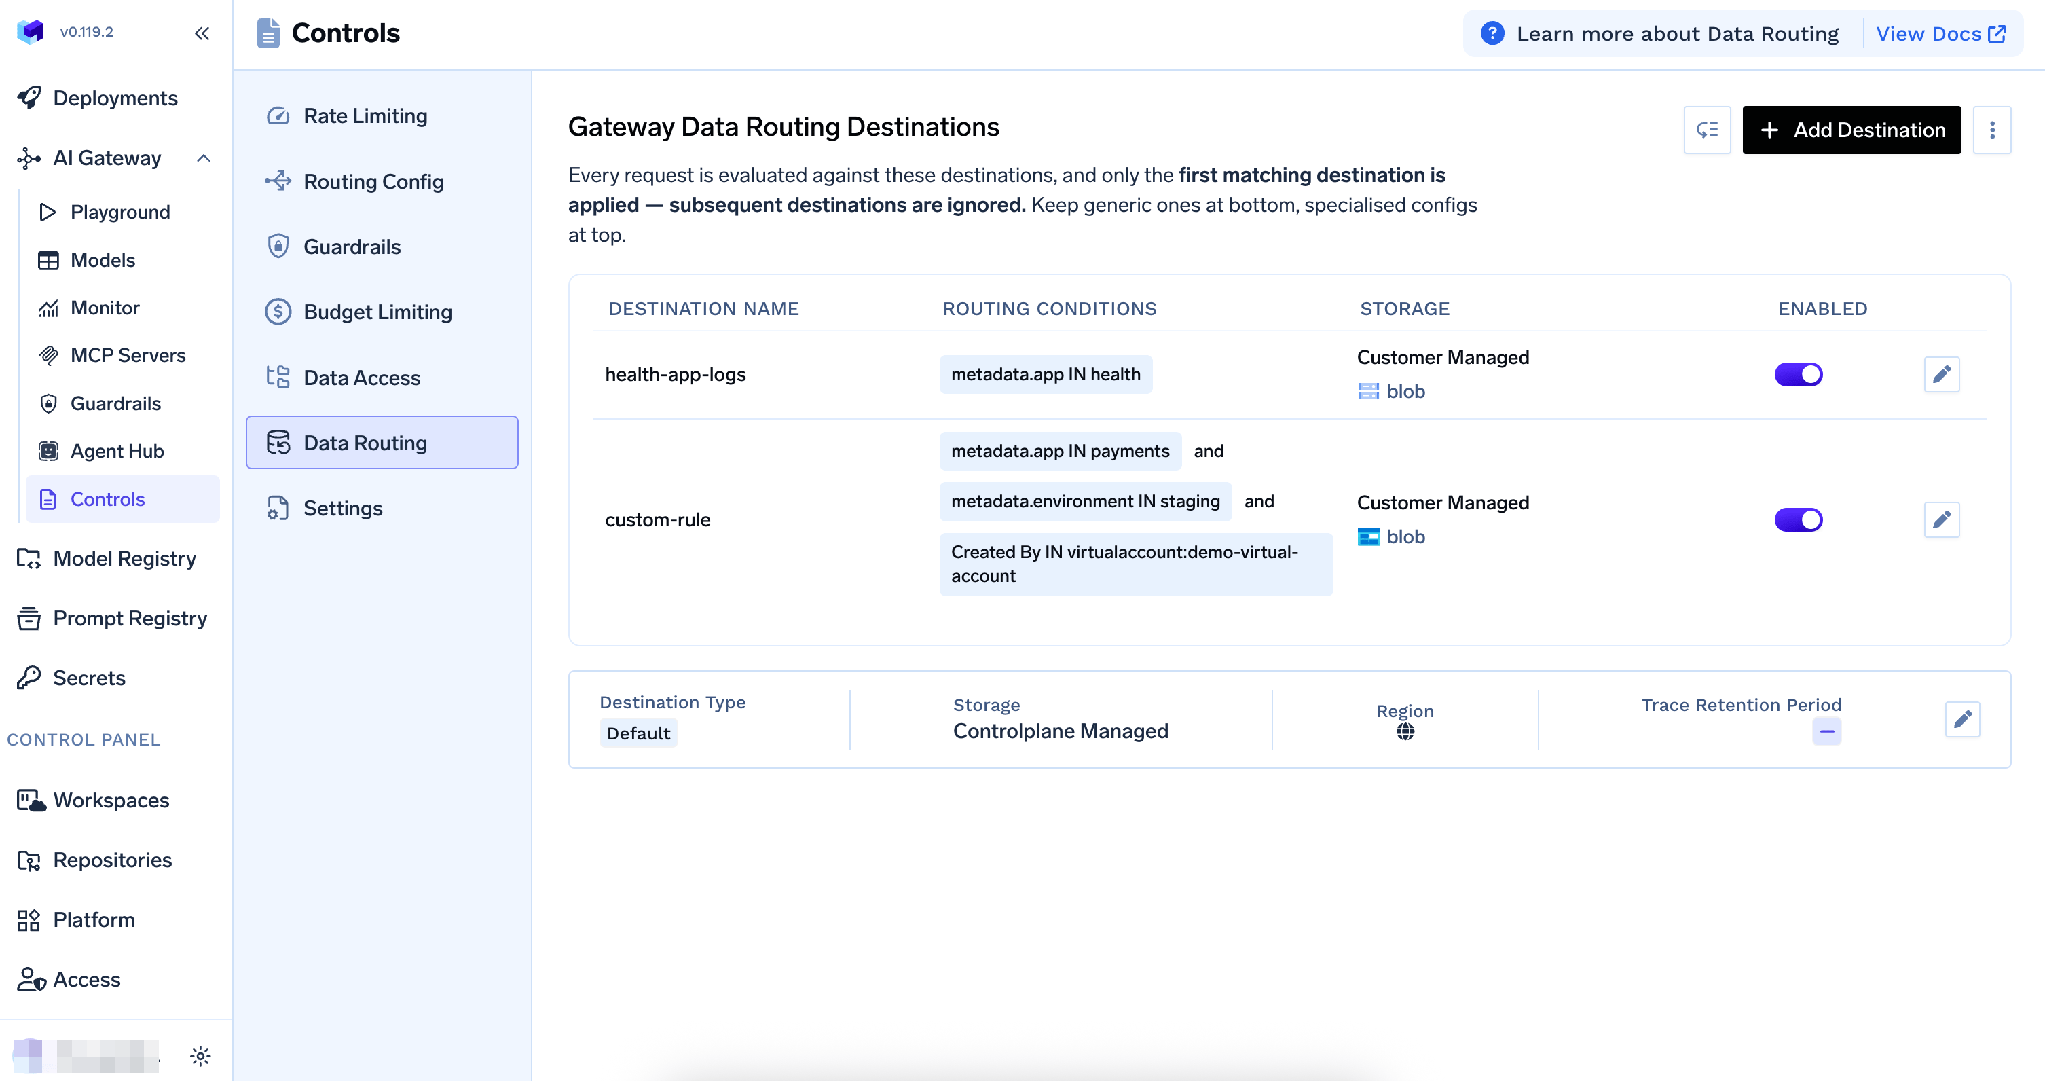
Aangepaste bestemmingen zijn een Enterprise-functionaliteit en routen traces op basis van voorwaarden — door de gebruiker gedefinieerde metadata zoals metadata.app, of wie het request heeft aangemaakt. Bestemmingen worden van boven naar beneden geëvalueerd, waarbij de eerste match geldt. Plaats specifieke regels daarom boven generieke regels:
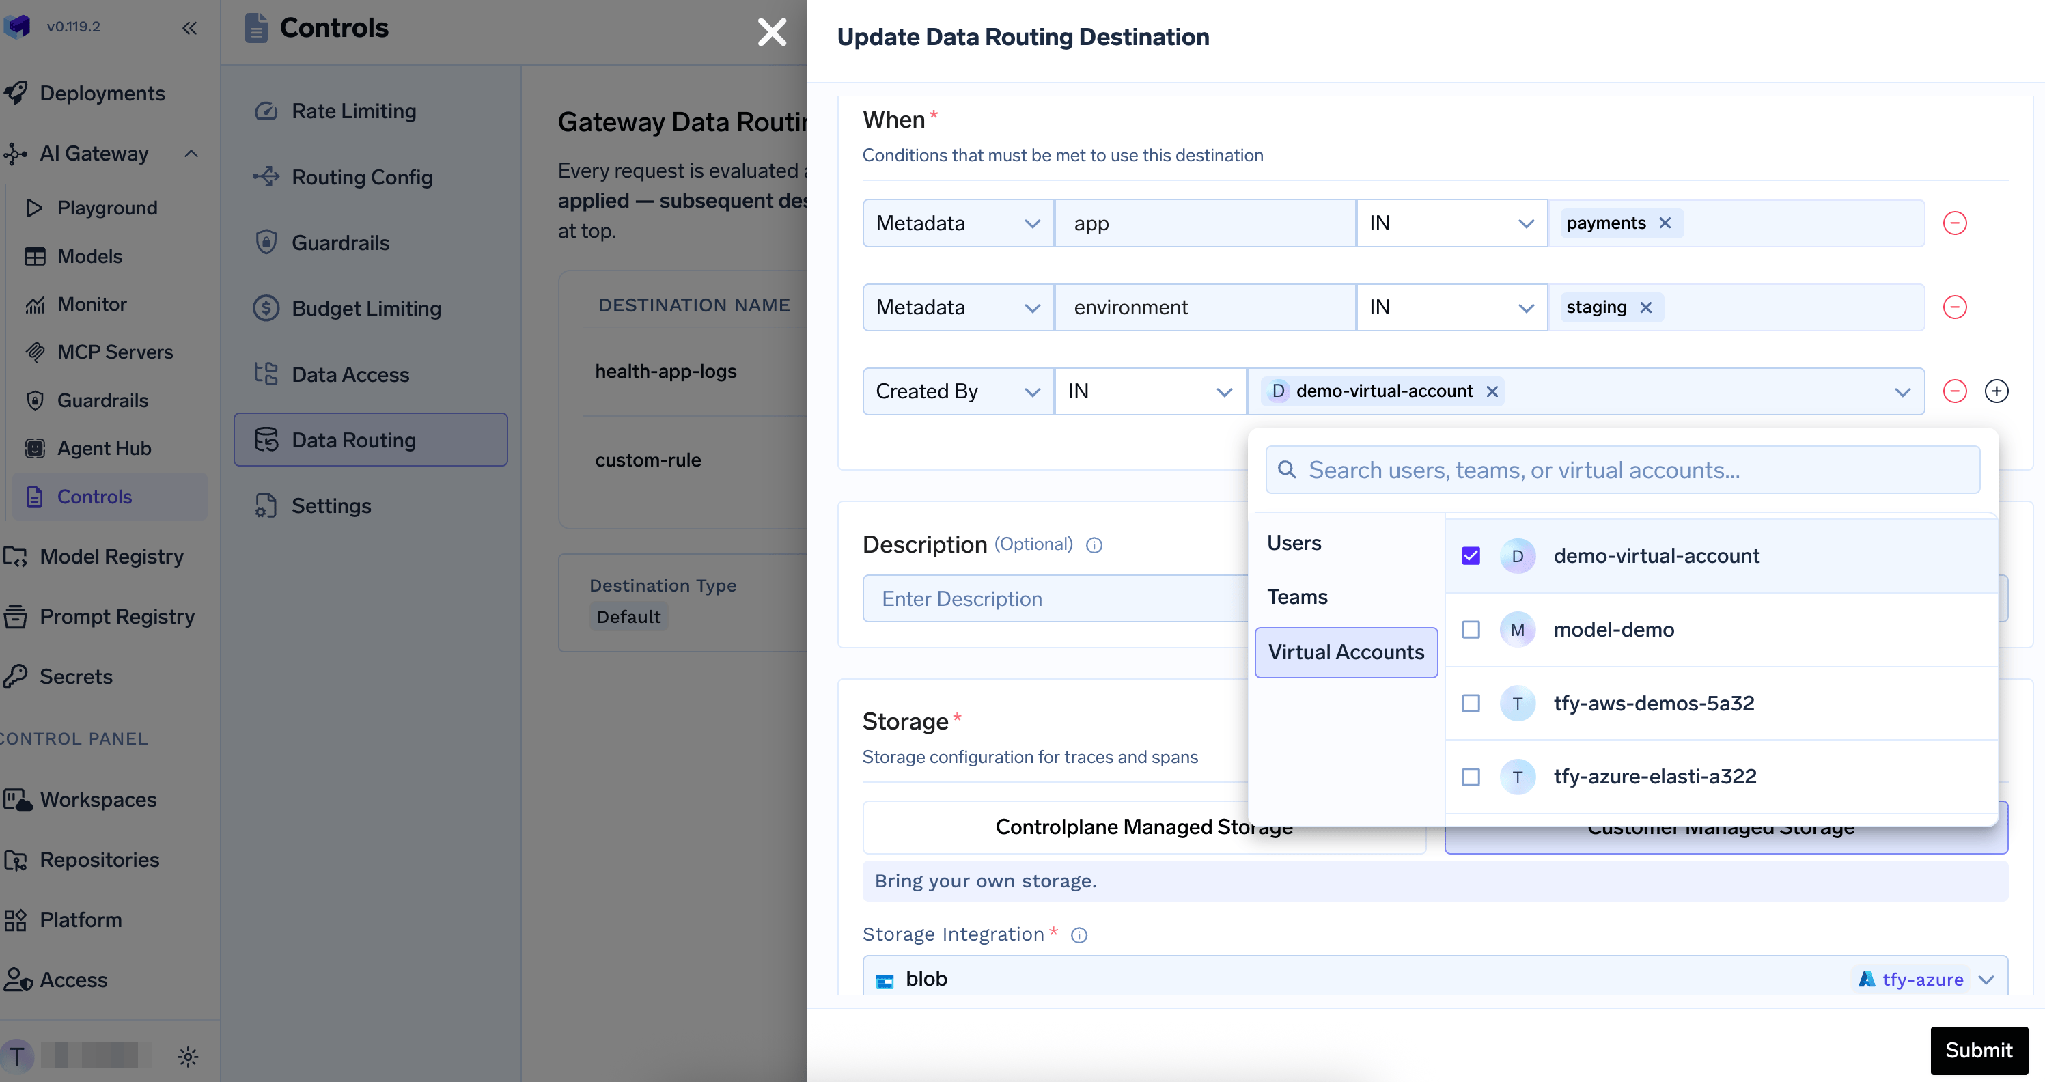
Elke bestemming is ofwel door het control plane beheerde opslag (waarbij op SaaS een regio kan worden geselecteer voor dataresidentie), ofwel uw eigen S3-, GCS- of Azure Blob-bucket:
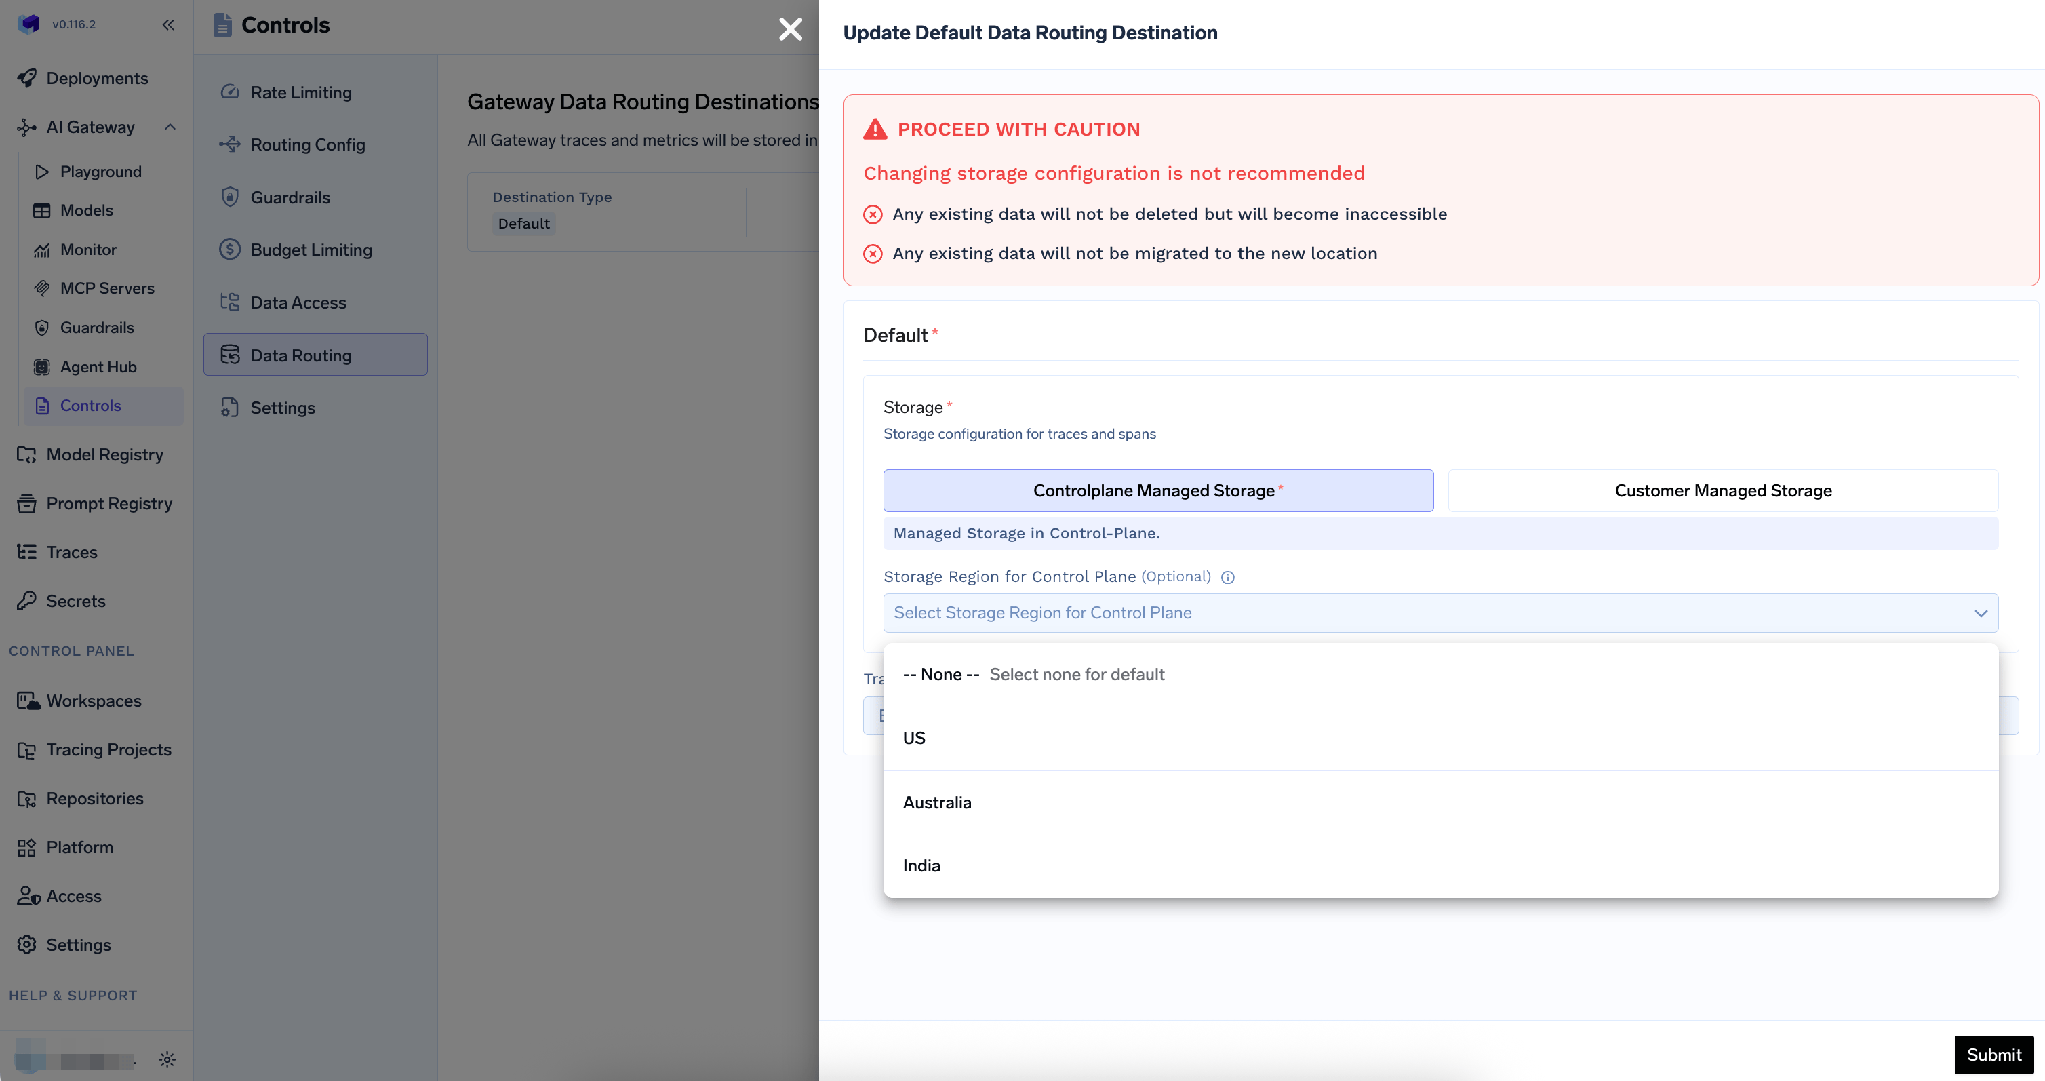
Er zijn twee beperkingen om rekening mee te houden. Metrics gaan altijd naar de standaardbestemming en worden onbeperkt bewaard — alleen traces kunnen op maat worden gerouted. En het wijzigen van een opslagconfiguratie migreert geen bestaande data: aanwezige gegevens worden niet verwijderd, maar zijn niet langer toegankelijk vanaf de nieuwe locatie.
Het verkeerde probleem oplossen. Een team dat zich zorgen maakt over de uitgaven, bouwt een gewogen verdeling over drie providers. Gewichten houden geen rekening met de complexiteit van requests, waardoor de factuur nauwelijks verandert. Een team dat bang is voor storingen schakelt complexity routing in en is verrast wanneer een incident bij een provider alsnog tot downtime leidt. Definieer het probleem voordat u het mechanisme kiest.
Aannemen dat tijdelijke deactivering bij problemen overal werkt. Bij routing op basis van gewicht, prioriteit en latentie wordt een haperende target naar het einde van de lijst verplaatst. Bij Auto Routing gebeurt dit niet — de targetvolgorde volgt altijd de tier-volgorde, en de escalatieketen vormt het failover-pad. Retries per target, fallback-statuscodes, rate limits en budgetten blijven van toepassing; het cooldown-gedrag geldt hier niet.
Een classifier als kosteloos beschouwen. De heuristiek is dat daadwerkelijk. De LLM-classifier is een tweede modelaanroep bij elke niet-vastgezette interactie, die net als elk ander request wordt gefactureerd en getraced. Vaak is het de moeite waard — maar het hoort thuis in uw kostenmodel en moet geen verrassing op de factuur zijn.
Routen zonder een uitgavenplafond. Kostengebewuste routing verlaagt de gemiddelde kosten per request, maar het maximaliseert de totale uitgaven niet. Één doorgedraaide agent-loop kan een kwartaal aan besparingen tenietdoen. Modelrouting bepaalt de efficiëntie, budgetregels vormen het plafond — u heeft ze allebei nodig.
Een support-product stuurt alle verzoeken naar een topmodel. De kosten rijzen de pan uit, een provider had vorige maand een ernstige storing en de juridische afdeling vraagt waar de gesprekken met EU-klanten worden verwerkt. Alle drie de categorieën in één applicatie.
Stap één: modelselectie. Maak een virtueel model support/assistant aan met Complexity-routing. Koppel simple aan een klein, snel model, medium aan een model uit het middensegment en complex aan het topmodel. Laat de heuristische classifier ingeschakeld. De applicatie past slechts één string aan: de modelnaam.
Gedrag bij gesprekken met meerdere interacties vereist geen configuratie. Elke interactie wordt geclassificeerd en de vastzetting (pin) beweegt alleen omhoog: als de vierde interactie complexer is, schaalt het gesprek op; als de vijfde interactie “bedankt” is, blijft het op dat hogere niveau. Een pin blijft tien minuten actief bij inactiviteit en wordt bij elke interactie ververst. Zodra een gesprek het niveau complex bereikt, slaan vervolginteracties de classificatie volledig over.
Stap twee: load balancing binnen een tier. Voeg aan de tier complex een tweede target toe bij een andere provider. Targets binnen dezelfde tier worden geprobeerd in de volgorde waarin ze zijn gedefinieerd voordat er wordt geëscaleerd. Zo heeft het topmodel een gelijkwaardig alternatief voor failover. Het dashboard ondersteunt één target per tier, dus voor deze opzet is tfy apply of de API nodig.
Stap drie: datarouting. Voeg metadata_match: { tfy_gateway_region: EU } toe aan een in de EU gehoste target met een algemene fallback eronder. Stel vervolgens een Data Routing-bestemming in die traces met metadata.region equal to eu naar een EU-bucket stuurt.
Stap vier: het uitgavenplafond. Een budgetregel die is ingesteld op het ID van het virtuele model maximeert de uitgaven, ongeacht hoe de routing zich gedraagt:
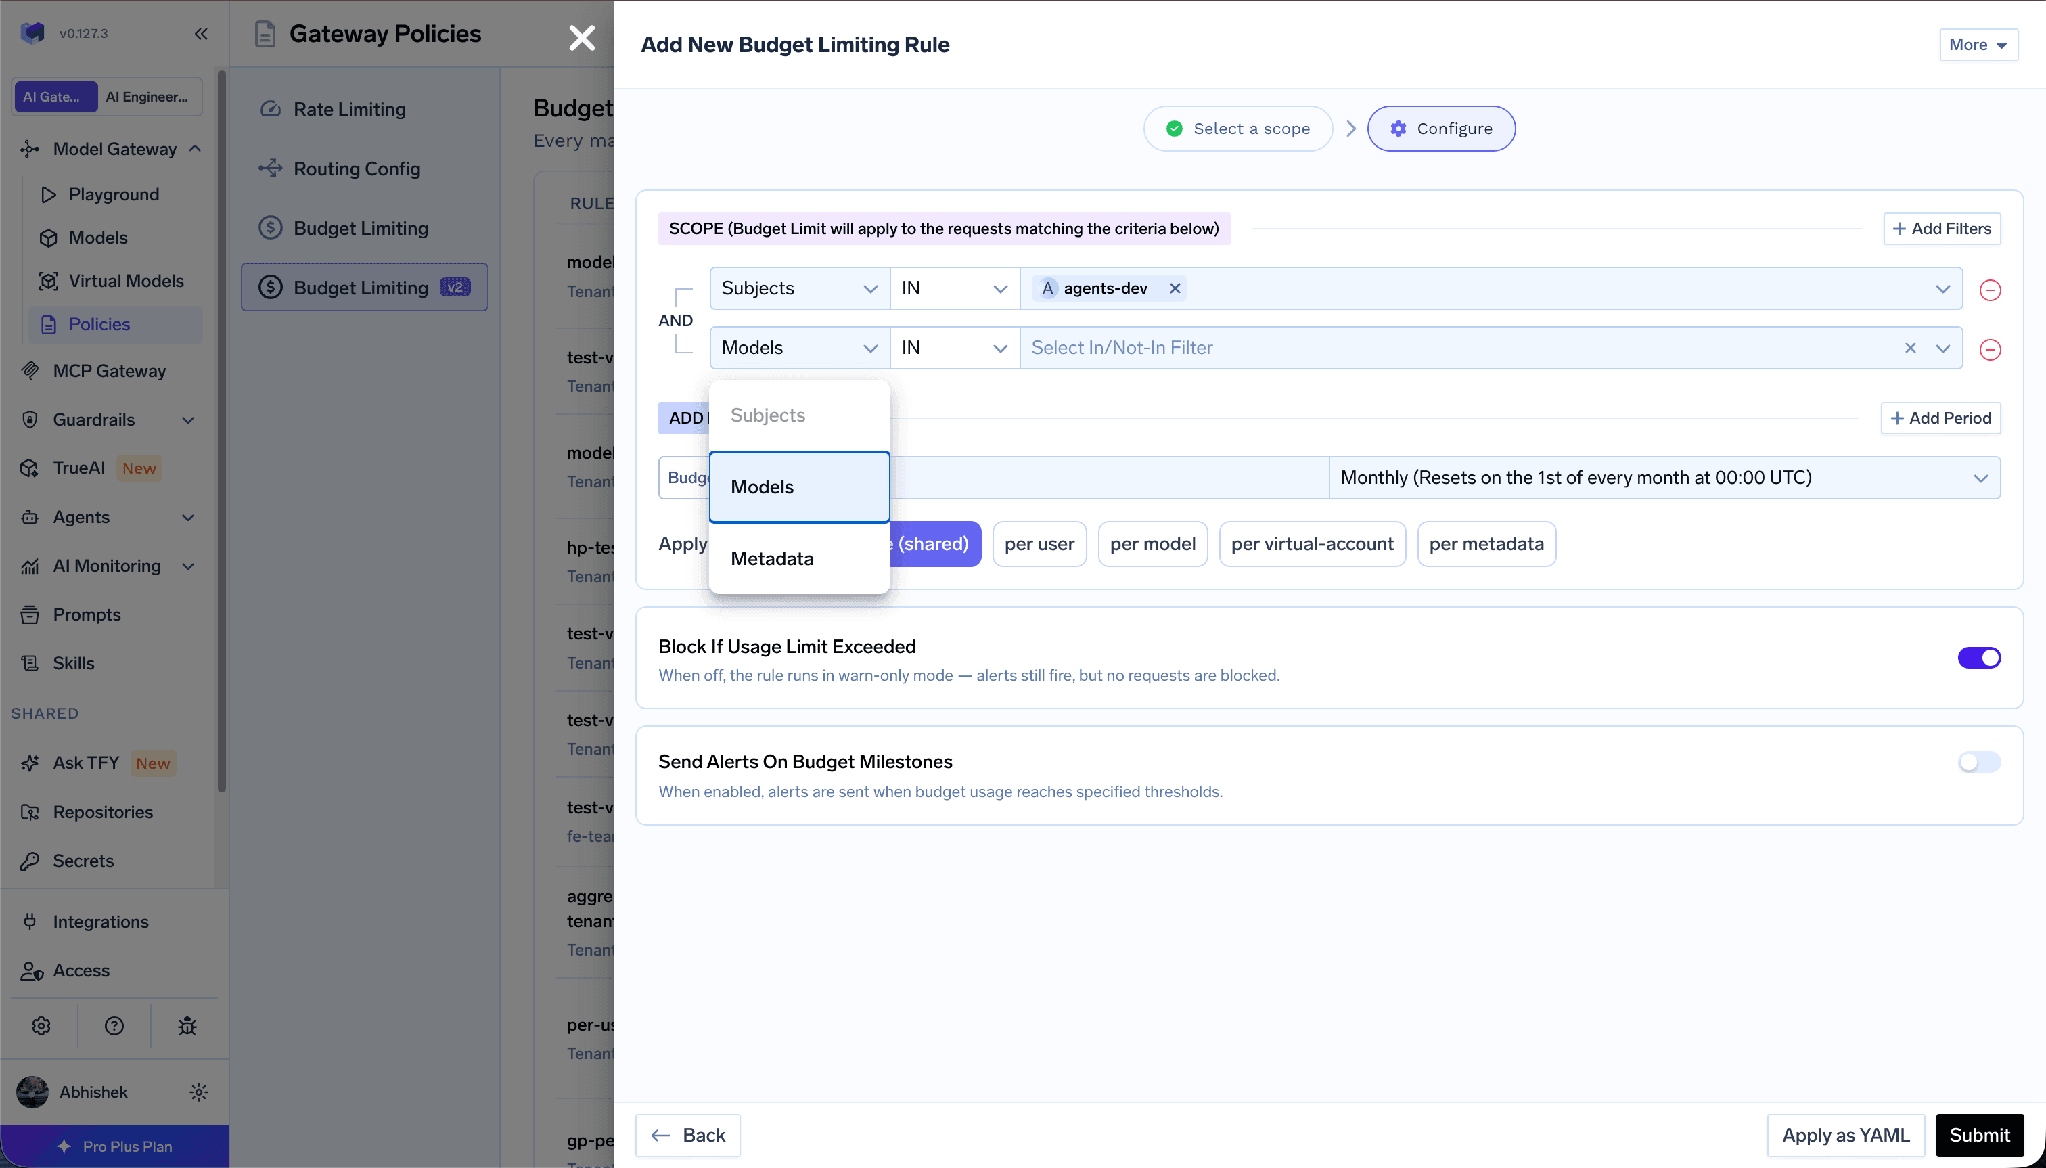
Budgetregel-filters met voorwaarden voor Subjects, Models en Metadata
Zo'n regel matcht zowel op het ID van het virtuele model als op de concrete target waarnaar het verwijst, en deze twee gedragen zich heel verschillend. Een overschreden budget voor een virtueel model in de modus enforce blokkeert het gehele request voordat er een backend wordt aangeroepen; fallback-targets worden niet geprobeerd. Een overschreden budget voor een concrete target slaat alleen die specifieke target over, waarna het virtuele model terugvalt op een ander target. Dezelfde functionaliteit, maar met een heel andere impact.
Stap vijf: verifiëren. Elke response bevat de header x-tfy-applied-rules met de geleverde tier, de aanleiding en de volledige geordende keten, evenals x-tfy-resolved-model waarin het uiteindelijke model wordt genoemd. De teller ai_gateway_complexity_routing_decisions_total geeft een gespecificeerd overzicht op basis van decided_tier, resolved_tier en cause. Vermenigvuldig het verkeersaandeel van elke tier met het prijsverschil om uw werkelijke besparing te berekenen, in plaats van uit te gaan van een brochurecijfer.
Auto Routing werkt alleen met virtuele modellen. Het is geen geldig regeltype in de routing-YAML op tenant-niveau en het wordt niet ondersteund voor modeltypen zoals embedding, image, audio, rerank en moderation — het werkt uitsluitend voor chat, completion en responses. Gemengde lijsten worden eveneens geweigerd: het gelijktijdig opgeven van chat en embedding wordt bij het opslaan afgekeurd.
Escalatie geldt ook voor niet-geconfigureerde tiers. Wanneer alleen simple- en complex-targets zijn ingesteld, zal een als medium geclassificeerd request escaleren naar complex, wat in de header wordt gerapporteerd. Dit is een ondersteunde opzet met twee tiers — maar als decided_tier en resolved_tier voortdurend van elkaar afwijken om een andere reden dan session_pin, ontbreekt er een tier of is er sprake van een onjuiste configuratie.
De classifier leest slechts twee berichten. Het laatste bericht van de gebruiker en het laatste system- of developer-bericht, met een limiet van respectievelijk 8.000 en 2.000 tekens. Eerdere interacties, antwoorden van de assistant en tool-berichten worden genegeerd. Consistentie gedurende een gesprek wordt gerealiseerd door vastzetting (pinning), niet door het uitlezen van de volledige historie.
“LLM router” voelt als een vage categorie omdat het drie verschillende functionaliteiten onder één noemer schaart. Load balancing is een middel voor beschikbaarheid waarbij de targets inwisselbaar zijn. Modelselectie is een instrument voor kostenbeheersing waarbij de targets dat nadrukkelijk niet zijn. Datarouting is een instrument voor compliance dat de mogelijkheden vooraf inperkt, nog voordat de andere twee mechanismen worden toegepast.
Los van elkaar is elke keuze overzichtelijk. Verliest u requests door storingen, betaalt u te veel voor eenvoudige verzoeken, of moet u verantwoorden waar data wordt verwerkt? Het eerste vraagt om een prioriteitsketen, het tweede om complexity tiers, het derde om metadata-matching en een specifieke opslagbestemming. De meeste teams hebben één van deze oplossingen direct nodig, en de andere op termijn.
En wanneer u aan de slag gaat met kostenbesparing, neem de gepubliceerde cijfers dan in beide opzichten serieus. Een besparing van negenennegentig procent is reëel. Maar dat geldt ook voor de twee procent aan nauwkeurigheid die het kost.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



An LLM router sits between your application and your models and decides which model or deployment serves each request. The term covers three distinct jobs: load balancing across interchangeable targets for throughput and failover, model selection between a cheaper and a stronger model, and data routing constraining where a request may be processed and where its logs land. Each reads different inputs, so the first question is which one you need.
Routering op basis van modelselectie wel; load balancing en datarouting over het algemeen niet. De Auto Routing van TrueFoundry behaalde in benchmarks 69% kostenbesparing met behoud van 98% van de kwaliteit over 550 beoordeelde prompts, en tot 80% op verkeer dat lijkt op productieverkeer. De besparingen hangen af van uw verkeersmix: splits de routeringsbeslissingen-metric uit per opgelost niveau en vermenigvuldig het aandeel van elk niveau met het prijsverschil.
Complexity-based routing on one virtual model with the free heuristic classifier, because it needs no application change and no classifier spend. Add a priority chain across two providers once an outage has cost you something. Add data routing when someone asks where the data goes.
Yes — VPC, on-prem, air-gapped, hybrid, or across multiple clouds, with no data leaving your domain.
Roughly 3-4 ms of overhead, handling 350+ RPS on a single vCPU, across 1,000+ supported LLMs. The exception is the optional LLM classifier, which adds a real model call before the request is forwarded.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog of Prometheus. Elke LLM-classifieraanroep produceert zijn eigen span, zodat de latentie van de classifier apart zichtbaar is van die van het geserveerde model.



Het laatste nieuws, artikelen en bronnen in je inbox



















