



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Korte versie: Kimi-K2 Thinking (Moonshot AI) is een open-weight, tool-aware "thinking" model dat grenzen verlegt op het gebied van multi-step reasoning, long-horizon tool orchestration en enorme context windows. Op Humanity’s Last Exam (HLE) en verschillende agentic benchmarks behaalt het toonaangevende resultaten (vooral wanneer tool access is ingeschakeld). Dit vormt een sterk argument dat de volgende grote doorbraak in LLMs ligt in thinking + tools + long context, en niet alleen in het aantal parameters.
Gebruik de Truefoundry AI Gateway om het nu direct te proberen.
Benchmarks zoals MMLU, coding tests en chat benchmarks hebben ons veel verteld, maar ze meten multi-step reasoning, tool orchestration of long-horizon planning niet volledig. Een nieuwe klasse van "thinking" modellen wordt expliciet getraind voor deze vaardigheden: het model moet interne stap-voor-stap reasoning afwisselen met externe tool calls (search, code interpreters, web browsing) en coherentie behouden over vele opeenvolgende stappen.
Kimi-K2 Thinking is een vlaggeschipvoorbeeld van deze trend. Het is ontworpen als een agentic systeem: het redeneert, besluit om tools aan te roepen, verwerkt tool outputs en gaat door met redeneren — dit alles terwijl de context behouden blijft over honderden stappen. Het resultaat: aanzienlijke winst op moeilijke "thinking" benchmarks zoals HLE en BrowseComp.
Belangrijkste technische highlights uit de officiële model card:
Deze elementen — MoE-schaal, enorme context, expliciete tool orchestration en efficiënte low-bit inference — zijn de bouwstenen waarmee Kimi-K2 zich meer als een agent gedraagt dan als een conversationale transformer.
Humanity’s Last Exam (HLE) is bedoeld als een zeer uitdagende benchmark op examenniveau die echte reasoning op de proef stelt, en niet alleen retrieval of snelkoppelingen. Het bevat domeinspecifieke, vaak multi-step problemen in wiskunde, wetenschap, engineering en andere vakgebieden. Omdat de problemen van HLE meestal multi-step reasoning en in sommige gevallen externe lookup of berekening vereisen, is het een uitstekende stresstest voor tool-capable agents met een lange context. Bij de ontwikkeling van Kimi-K2 lag de nadruk op HLE en andere agentic benchmarks — de model card belicht HLE als een van de belangrijkste evaluatiedoelen.
Volgens de door Moonshot AI gepubliceerde evaluatieresultaten:
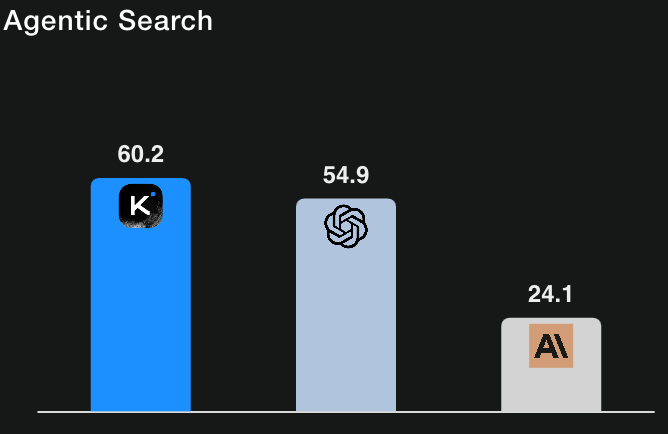
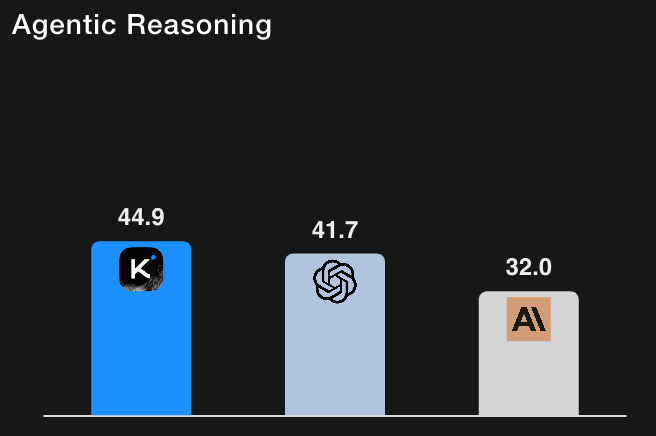
Ter vergelijking: GPT-5 (High) op ~41,7% op HLE met tools (hun interne re-runs) en Claude Sonnet 4.5 op ~32,0% (thinking mode). De resultaten van Kimi-K2 plaatsen het daarom voor op de gerapporteerde baselines bij HLE-runs met tools. (Alle cijfers zijn overgenomen uit de evaluatietabel en voetnoten van Moonshot AI.)
Belangrijke nuance: de model card documenteert zorgvuldig hoe tool access, judge settings, token budgets en context limits zijn behandeld; de auteurs merken ook op dat sommige baseline-cijfers zijn overgenomen uit officiële berichten, terwijl andere intern opnieuw zijn getest. Kortom: dit zijn sterke signalen, maar lezers moeten er rekening mee houden dat ze zijn gerapporteerd door Moonshot AI en afhankelijk zijn van het gedetailleerde evaluatieprotocol dat bij de resultaten is beschreven.
We hebben een steekproef genomen van 50 datarijen uit HLE en dit zijn de resultaten
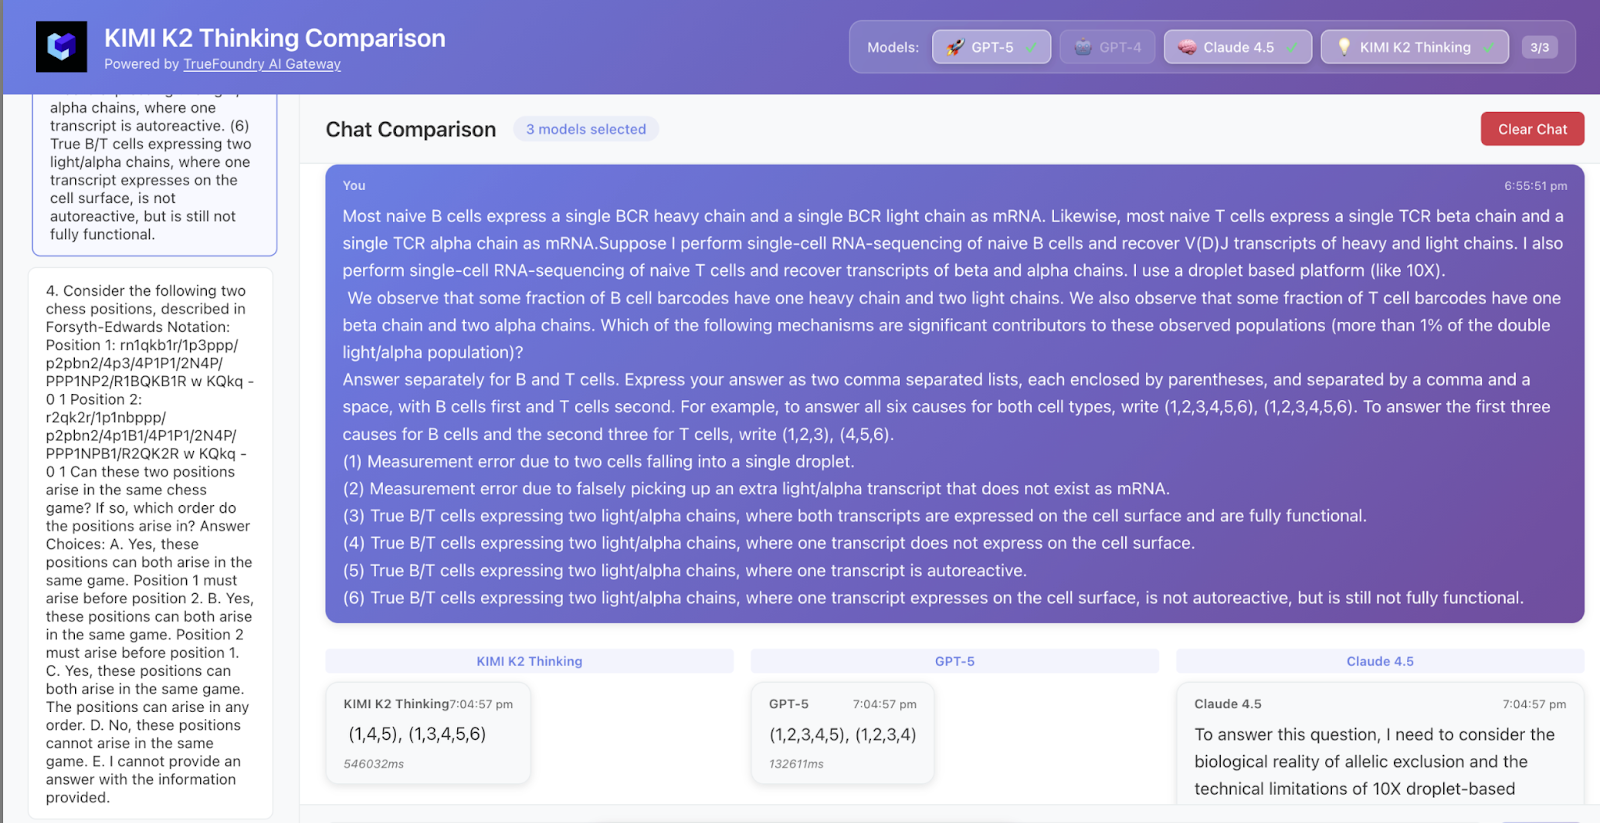
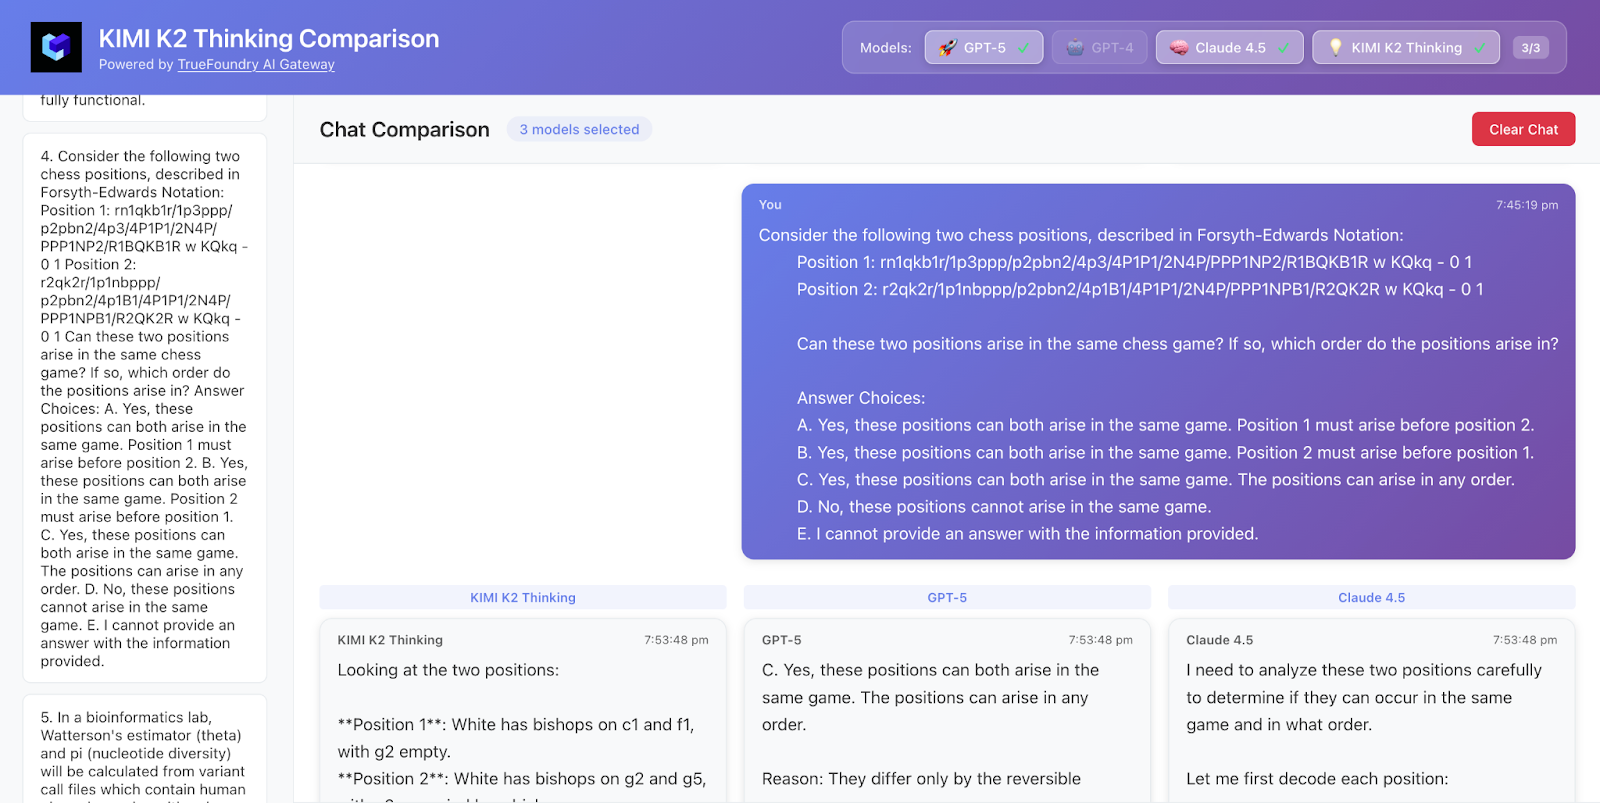
Kimi K2 had zowel het antwoord als de logica juist, terwijl GPT-5 alleen het antwoord juist had en Claude niet juist was.
De vrijwel verdubbeling van Kimi-K2's HLE-prestaties van no-tools → with-tools (≈24→45%) toont een cruciaal punt aan:
Eenvoudig gezegd: de winst op HLE suggereert dat het kernprobleem is hoe een model redeneert en tools gebruikt, en niet alleen de omvang van het model.
Naast benchmarks is het meest opwindende hoe toegankelijk dit soort mogelijkheden wordt. Je hoeft geen maanden te wachten om te experimenteren — je kunt het zelf proberen. Met de TrueFoundry AI Gateway krijg je eenvoudig direct toegang tot Kimi-K2 Thinking en andere geavanceerde modellen, kun je ze benchmarken op je eigen data, of ze integreren in workflows.
Als je meer persoonlijke hulp wilt, boek dan een demo — het team kan je door de prestaties, deployment-opties, kosten en het evalueren van deze modellen voor jouw taken praten. We blijven op de hoogte van de markt en zorgen ervoor dat nieuwe modellen zo snel mogelijk beschikbaar zijn voor jouw gebruik.
Kortom: Kimi-K2 Thinking is niet zomaar een LLM — het is een duidelijk kijkje in de toekomst van agents die in staat zijn tot reasoning: open, efficiënt, tool-aware en afgestemd op het oplossen van multi-step problemen. Probeer het, vergelijk het op je eigen problemen en zie hoeveel verschil agentic tool orchestration maakt bij echte taken.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















