



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
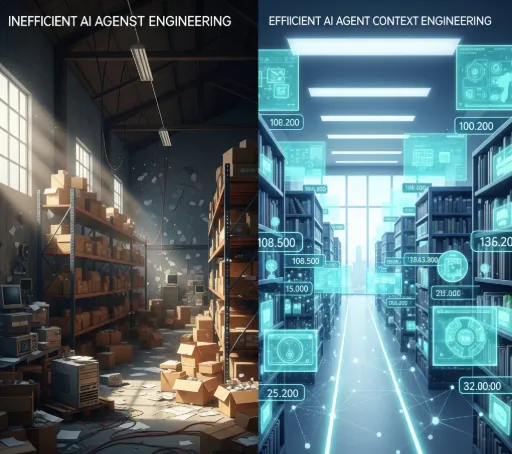
Gedurende het grootste deel van het agent-tijdperk was contextstrategie een verhuiswagen: laad alles wat de agent mogelijk nodig zou kunnen hebben — het document met conventies, de volledige toolcatalogus, het referentiemateriaal — vooraf in het venster, en hoop dat het model de relevante onderdelen vindt. Een opkomend patroon in context-engineering draait dat om. JIT-context — JIT zoals in just-in-time, hetzelfde idee als de just-in-time-compilers in je browser — is het patroon dat Anthropic's richtlijnen voor context-engineering centraal stelden binnen de discipline: het houdt het venster vrijwel leeg van payloads en vol met pointers: de agent weet wat er bestaat — skills aan de hand van hun metadata, data aan de hand van de referenties, tools aan de hand van een dunne index — en de zware inhoud wordt pas geladen op het moment dat deze nodig is, en daarna weer vrijgegeven. Voor veel langlopende agents wordt JIT-context de veiligere standaard, en het vooraf laden van alles een bewuste uitzondering. Dit artikel behandelt de engineering achter die omkering — wat laat geladen moet worden, wat vooraf geladen moet blijven, en waarom JIT-context uiteindelijk een runtime-eigenschap is in plaats van een gewoonte bij het prompten.
Lucia, een platform engineer, erfde een agent waarvan de systeemcontext was gegroeid zoals rommel op een zolder groeit. Iemand had het volledige engineering-handboek vooraf geladen "zodat het de conventies volgt." Iemand anders hatte alle veertig toolbeschrijvingen in-line toegevoegd "zodat het de opties kent," en vervolgens drieduizend regels API-referentie "zodat het stopt met gissen naar schema's." Elke toevoeging had een reden; de som was een agent die elke sessie begon met het grootste deel van zijn venster al verbruikt, opnieuw betaalde voor die ballast bij elk van zijn dertig lus-stappen, en — het deel dat uiteindelijk de aandacht trok — slechter presteerde op dezelfde taken dan een gestripte prototype.
Die refactor heeft nu een naam — JIT-context — en het komt samen uit drie richtingen: Anthropic's richtlijnen voor context-engineering (september 2025) maakten runtime-ophalen in plaats van vooraf laden tot een kernprincipe; het ecosystem van skills maakte progressive disclosure het laadmodel voor verpakte kennis; en ontwikkelaars van harnesses maakten uitbesteding en isolatie tot standaard runtime-gedrag. Dit artikel verbindt die draden, laag voor laag, en eindigt bij de vraag die context-artikelen in deze reeks altijd bereiken: wie zou dit werk moeten doen — je prompt-auteurs, of de runtime daaronder?
Het instinct om vooraf te laden is rationeel in een chatwereld. Een interactie met één enkele turn heeft maar één kans op context, dus je laad vooraf; in het ergste geval negeert het model de overvloed. Agents hebben beide aannames ontkracht. Een lus verstuurt zijn venster opnieuw bij elke stap, dus overvloed wordt herhaaldelijk gefactureerd, niet één keer. En de overvloed wordt niet genegeerd — onderzoek naar long-context en praktijkervaring laten zien dat modellen minder goed presteren naarmate vensters gevuld raken met tekst van lage relevantie, de foutmodus die de community context-rot noemt. De aanpak van de handleiding — lees alles voordat je op Start klikt — blijkt de manier te zijn om een agent tegelijkertijd trager, duurder en minder intelligent te maken.
JIT-context draait de standaard om. De permanente inhoud van het venster krimpt tot wat echt altijd nodig is (taak, kerninstructies, recente stappen) plus een catalogus — compacte beschrijvingen van wat er bestaat en hoe je het kunt krijgen: een skill als zijn naam en één zin, een dataset als een pad, een eerder resultaat als een handle. Wanneer een stap de payload nodig heeft, haalt de agent (of de harness namens hem) deze op, gebruikt deze, en laat deze daarna uit het actieve venster vallen. Anthropic's formulering is degene om te onthouden: behoud lichtgewicht identifiers, laad data tijdens runtime. Het venster is geen magazijn meer, maar een werkbank.
Het patroon is niet nieuw — het is bewust geleend uit interface-design. Progressive disclosure is het UX-principe uit de jaren 90 dat stelt dat gebruikers die vijftig instellingen te zien krijgen blokkeren, terwijl gebruikers die drie instellingen en een knop "Geavanceerd" zien, succesvol zijn; je onthult complexiteit op het moment van intentie, niet daarvoor. De community is expliciet geweest over de overname: een agent wiens venster volgepropt is met alles wat hij nodig zou kunnen hebben, verliest precies op dezelfde manier zijn effectiviteit als een gebruiker die naar een overvol scherm kijkt, en de oplossing is dezelfde fasering van informatie. De agent weet dat een functionaliteit bestaat — dat is de metadata, altijd zichtbaar, goedkoop. De volledige omvang van de functionaliteit — instructies, scripts, referentiebestanden — blijft achter de knop totdat de agent besluit deze te gebruiken.
De naam zelf draagt een stamboom die het waard is om te lenen. Als je een achtergrond in CS hebt, is de dichtstbijzijnde analogie JIT-compilatie: in plaats van een heel programma van tevoren te compileren, vertaalt een JIT-compiler elk onderdeel op het moment dat het wordt uitgevoerd — wanneer de runtime weet dat het codepad daadwerkelijk wordt genomen en live informatie heeft over hoe het wordt gebruikt. De winst is tweeledig: je betaalt niet om code te compileren die nooit wordt uitgevoerd, en de compilatie die je uitvoert is beter geïnformeerd omdat deze plaatsvindt met runtime-context bij de hand. JIT-context komt daar vrijwel exact mee overeen. Vooraf laden is vooraf compilatie: je betaalt aandacht en tokens voor alles wat nodig zou kunnen zijn, beslist voordat de taak onthult wat er daadwerkelijk nodig is. JIT-context stelt het laden uit tot het moment van gebruik — de referentie in het venster is het symbool dat de runtime kan oplossen, en de activering door de agent is de aanroeplocatie die het oplossen triggert. De les is dezelfde die compiler-ontwikkelaars decennia geleden leerden: alles vooraf klaarzetten is duurder dan ophalen op verzoek, en het ophalen is, mits goed uitgevoerd, goedkoop en beter gericht omdat het plaatsvindt wanneer je eindelijk weet wat de taak vereist.
Wat deze overname meer maakt dan een metafoor, is dat de laadgrens afdwingbaar is in software. Een UI kan gebruikers alleen maar aanmoedigen tot de juiste disclosure; een harness kan het implementeren — door mechanisch te beslissen wat er in het venster komt en wanneer, op dezelfde manier als een virtueel geheugensysteem beslist wat er in het RAM zit. Die analogie (contextvenster als RAM, externe opslag als harde schijf, de harness als de pager) is de manier vanuit systems-engineering om alles wat volgt te begrijpen: JIT-context is paging voor aandacht.

Drie versterkende effecten maken het patroon de moeite waard. Aandacht: elke vooraf geladen token concurreert met de taak om de focus van het model, en de verslechtering is geen lineaire beleefdheid — irrelevante omvang verslechtert actief de prestaties op wat er toe doet, wat verklaart waarom Lucia's gestripte prototype de volgeladen productie-agent versloeg. JIT is de architectonische verdediging tegen context-rot: het venster bevat signaal omdat ruis nooit is toegelaten. Kosten: in een lus wordt het venster bij elke stap opnieuw verstuurd, dus een vooraf geladen handboek is geen eenmalige betaling, maar dertig betalingen; de rekenkunde van ons werk rond token-verbruik is van toepassing, en JIT valt de grootste factor aan — het permanente gewicht dat overal mee naartoe reist. Versheid: een vooraf geladen kopie is een momentopname die veroudert naarmate de sessie vordert, terwijl een referentie verwijst naar de huidige staat van het bestand, het ticket, de database op het moment van gebruik — voor langlopende agents is laat laden niet alleen goedkoper, het is ook correcter.
De eerlijke kolom in het grootboek: JIT koopt dit ten koste van ophaallatentie op de stappen die laden (meestal verwaarloosbaar vergeleken met een modelaanroep, maar niet nul), een nieuwe foutmodus (een niet-oplosbare referentie moet naar voren komen als een eerlijke fout, niet als een gehallucineerde payload), en een afhankelijkheid van de kwaliteit van de beschrijving — de agent laadt op basis van de eenregelige beschrijvingen uit de catalogus, dus een slechte beschrijving verbergt een goede payload. Geen van deze verandert het oordeel; ze horen allemaal thuis in het ontwerp.
Skills zijn de plek waar het patroon het meest zichtbaar is, omdat het SKILL.md-ecosysteem eromheen is gebouwd. Een skill blijft inactief als een map; wat de agent standaard ziet is de metadata — een naam en een beknopte beschrijving — en de zware inhoud (stapsgewijze procedure, referentiebestanden, scripts) wordt pas geïnjecteerd wanneer de agent de skill activeert omdat de taak ermee overeenkomt. Dat is progressive disclosure als laadmodel, en het verandert wat een skill-bibliotheek kan zijn: een organisatie kan tientallen diepgaande procedures onderhouden zonder dat een agent voor meer dan de catalogus betaalt, omdat diepte niets kost totdat het wordt gebruikt. Het uitvloeisel dat ontwikkelaars snel leren: de beschrijving is drager van de functie — het is de volledige basis waarop de agent besluit te laden, dus een saaie, nauwkeurige omschrijving is beter dan een slimme.
Op TrueFoundry is dit het standaardgedrag van de Skills Registry: SKILL.md-artefacten met versiebeheer, gepubliceerd met RBAC, waarnaar wordt verwezen via de naam, en op verzoek gekoppeld in de sessie. De registry voegt toe wat de laptopversie mist — herkomst van de payloads die JIT worden geladen: met versiebeheer, RBAC en audit-historie kunnen teams van “welke versie van de procedure heeft deze sessie gebruikt?” een controleerbaar feit maken in plaats van een gok, wat juist van belang is omdat de inhoud niet statisch in een beoordeelbare prompt staat. JIT-laden zonder versiebeheer is dynamisch gedrag zonder audit-trail; de registry dicht dat gat.
De tweede laag bestaat uit toolresultaten — in langdurige sessies vaak het grootste deel van het venster. De naïeve lus plakt een API-respons van 38.000 tokens in de context omdat dat is waar resultaten terechtkomen; JIT draait het om met het uitbesteden van grote resultaten: de payload belandt in opslag, het venster ontvangt een compacte handle (wat het is, hoe groot, waar het zich bevindt), en de inhoud wordt pas opgehaald als een latere stap deze echt moet lezen. Dezelfde stap zie je in moderne agent-systemen: omvangrijke uitvoer wordt extern bewaard terwijl het model werkt met beknopte voorbeelden of referenties in plaats van ruwe payloads, en oude tool-uitvoeren worden ter plekke vervangen door pointers.
Code mode is de sterkere vorm: veel "lees de data"-stappen hadden de data nooit in het venster nodig — ze hadden een berekening erover nodig. Het filteren van tienduizend logregels, het samenvoegen van twee exports, het tellen van fouten per type: de agent schrijft code die wordt uitgevoerd tegen de uitbestede payload in een sandbox en geeft het antwoord terug — drie regels in de context in plaats van tienduizend. Het venster bevat conclusies; de sandbox bevat de bulk. Beide gedragingen zijn standaardonderdelen van de context-engineering suite van de harness, wat de juiste plek hiervoor is: geen enkel model kan via een prompt worden geïnstrueerd om geen payload te ontvangen — alleen de runtime die het model voedt kan beslissen wat er binnenkomt.
Op het laagste niveau zijn de mechanismen niet spectaculair, maar waard om een keer te zien. De harness onderschept het toolresultaat voordat het een bericht wordt; boven de ingestelde drempel gaat de payload naar opslag op sessieniveau en ontvangt het model de handle — getypeerd, op maat gemaakt, adresseerbaar — zodat de gespreksstructuur die de API vereist intact blijft, terwijl de token-footprint met drie factorordes afneemt:
Wat het model daadwerkelijk ziet: uitbesteden en code mode op berichtniveau (ter illustratie)
Twee implementatiedetails onderscheiden een robuuste versie hiervan van een kwetsbare. De voorbeeldregel doet echt werk — het is de catalogus-entry die het model laat beslissen of een latere ophaalactie gerechtvaardigd is, dus het moet schema en vorm bevatten, niet alleen een aantal bytes. En in een robuuste implementatie moeten handles gebonden zijn aan de sessie en voorzien zijn van toegangsbeheer zoals elke andere resource: een referentie die het model kan genereren is een referentie die een geïnjecteerde prompt kan proberen te openen, dus het oplossen gaat via dezelfde gateway-autorisatie als een tool call.
Het patroon generaliseert van inhoud naar werk. Een subtaak met veel context — onderzoek deze verzameling logs, bekijk deze bestanden — kan JIT worden gedelegeerd aan een sub-agent: een nieuw, geïsoleerd venster vangt het onderzoek op, en alleen de samengevatte conclusie keert terug. Het venster van de parent bevat nooit het onderzoek, zoals een JIT-venster nooit het ongelezen handboek bevat — de delegatie-trede van ons spectrum van tools/skills/sub-agents, gelezen als een context-instrument. Dezelfde logica geldt voor tool-oppervlakken: veertig vooraf geladen beschrijvingen zijn veertig permanente claims op de aandacht, dus de JIT-houding is een gecureerde, voor de taak relevante set die aanwezig is (de preload-tools functionaliteit van de harness) waarbij de rest op verzoek ontdekt kan worden — wat minimale aandacht en minimale rechten tot dezelfde configuratie maakt.
En wanneer de historie van een lange sessie zelf de omvang vormt, is compactie de opruim-tegenhanger van de preventie hierboven: vat de transcriptie samen, bewaar beslissingen en openstaande punten, laat de overbodige details vallen. Een beheerde sessie ademt — referenties hopen zich op, payloads komen voorbij, samenvattingen vervangen historie — in plaats van monotoon vol te lopen naar de grens van context-rot.
JIT-context als configuratie, niet als kunstgrepen in de prompt (ter illustratie)
De veldnamen hierboven dienen ter illustratie en zijn geen letterlijk schema. Let er met name op dat sub-agents primair een mechanisme zijn voor context-isolatie — ze houden een zware subtaak buiten het venster van de parent — en geen grens voor toegangsrechten. Wanneer je harde scheiding van toegangsrechten nodig hebt, dwing dit dan af met afzonderlijke agents of afgebakende MCP-rechten met hun eigen authenticatiegegevens, niet door een sub-agent te nesten.
Een eerlijke benadering moet de andere grens trekken, omdat "alles JIT-en" zijn eigen foutmodus kent. Het openingsdeel van het venster — kerninstructies, de essentiële toolbeschrijvingen, de permanente identiteit van de agent — moet vooraf geladen en byte-stabiel zijn, om zowel een economische als een cognitieve reden: prompt caching van de provider maakt een stabiele prefix aanzienlijk goedkoper bij elke vervolgaanroep, en een prefix die verschuift omdat er iets "dynamisch in is geoptimaliseerd", verbreekt de cache en factureert het hele segment opnieuw. JIT de variabele suffix; bevries de prefix — en plaats het cache-breekpunt bewust op de grens, aangezien providers de gemarkeerde prefix cachen en de suffix opnieuw factureren, waardoor een JIT-koppeling die boven het breekpunt belandt, ongemerkt het hele gecachte segment ongeldig maakt. De twee patronen staan niet op gespannen voet met elkaar — het is dezelfde discipline toegepast op inhoud met verschillende wijzigingssnelheden, en de praktische test is eenvoudig: als het bij de meeste stappen nodig is en zelden verandert, laad het vooraf en houd het stabiel; als het bij weinig stappen nodig is of verandert tijdens de sessie, neem het op in de catalogus en laad het laat.
De test vertaalt zich in een standaard per type inhoud:
Nog twee uitzonderingen verdienen een permanente plek. Veiligheidskritische instructies worden niet ge-JIT — een guardrail die de agent moet "besluiten te laden" is geen guardrail, wat ook de reden is waarom handhaving plaatsvindt bij de gateway en harness, geheel buiten het venster (onze post over guardrails). En zeer kleine payloads zijn de omweg niet waard: een referentie van 50 tokens naar een document van 200 tokens is administratieve rompslomp. JIT-context is een afweging van omvang en frequentie, geen ideologie over laden.
Alles hierboven kan handmatig worden gebouwd — teams doen dat ook, met scripts voor uitbesteding, masking-stappen en op maat gemaakte skill-loaders — en het resultaat is het harness-probleem in het klein: vijf agents, vijf JIT-implementaties, vijf sets bugs in het mechanisme dat beslist wat het model ziet. Wat er elke stap in het venster komt is de functieomschrijving van de harness, dus JIT-context goed uitgevoerd is een eigenschap van de runtime: geconfigureerd per agent, identiek in mechanica over allemaal.

Op TrueFoundry is het patroon de standaardhouding van de Agent Harness context-engineering suite — skills gekoppeld op verzoek, uitbesteding van grote resultaten, code mode tegen de sandbox, controle op vooraf geladen versus on-demand tools, sub-agent-isolatie, compactie — samengesteld in één declaratieve agent-definitie, zonder aangepaste laadcode. Daaronder draagt de gateway de lagen waarvan JIT afhankelijk is: sessiebeheer, prompt caching voor de stabiele prefix (de economie van onze post over gateway context-engineering), en traces per stap die tonen wat er actief was, wat er geladen werd en wat het venster van elke stap kostte — hoe je controleert dat de catalogus werkt in plaats van het aan te nemen.

Lucia's zolder, op deze manier heringericht, behield elk stukje kennis dat het had verzameld — het handboek, de schema's, de procedures — en stopte met ervoor te betalen per stap. De agent werd sneller, goedkoper en meetbaar scherper, en het deel dat het herhalen waard is, is waarom: er werd niets verwijderd. Het werd in een andere tijdsvorm geplaatst. Wat de agent nodig zou kunnen hebben werd wat de agent kan bereiken; wat hij kan bereiken laadt wanneer erom wordt gevraagd. Dat is het hele patroon.
Is JIT-context niet gewoon RAG onder een nieuwe naam? RAG is er één toepassing van — ophalen op het moment van de query in plaats van de hele verzameling vooraf te laden — maar JIT-context is breder: skills geladen bij activering, resultaten uitbesteed aan handles, berekeningen verplaatst naar een sandbox, subtaken gedelegeerd aan nieuwe vensters. RAG vraagt "welke documenten komen in het venster?"; JIT-context vraagt "wat komt er überhaupt in het venster, en wanneer?" — voor elke categorie inhoud.
Maken enorm grote contextvensters dit niet overbodig? Grotere vensters verhogen de limiet, maar veranderen het principe niet. De achteruitgang die leidt tot de keuze voor JIT heeft te maken met de dichtheid van relevantie, niet met de capaciteit — modellen verliezen hun effectiviteit naarmate er meer ruis bij komt, ongeacht de beschikbare ruimte — en de kosten worden erger bij grote vensters, aangezien een lus bij elke stap opnieuw factureert wat er aanwezig is. Capaciteit maakt vooraf laden mogelijk; het heeft het nooit goed gemaakt.
Wat gebeurt er als een referentie tijdens de sessie niet kan worden opgelost? Hetzelfde wat er moet gebeuren als een tool faalt: een gestructureerde, duidelijke foutmelding in het venster — "handle verlopen, payload niet beschikbaar" — met een beperkt aantal herhaalpogingen, nooit een stilzwijgend gat dat het model opvult. Dit is het terrein van de foutafhandeling van de harness, en het is een reële prijs van het patroon: een JIT-architectuur kent fouten bij het ophalen die een vooraf geladen architectuur niet heeft. Ontwerp daarop; doe niet alsof ze niet bestaan.
Hoe beslis ik wat er vooraf geladen blijft? Stel twee vragen per item: hoe vaak is het nodig (meeste stappen → vooraf laden; weinig → catalogus) en hoe vaak verandert het (zelden → vooraf laden, byte-stabiel, gecacht; tijdens de sessie → referentie, laat oplossen). Veiligheidsinstructies worden altijd vooraf geladen — beter nog, dwing ze af buiten het venster. Kleine payloads slaan de omweg over; alles wat zwaar is en incidenteel gebruikt wordt gaat in de catalogus.
Maakt JIT-loading het gedrag van agents minder controleerbaar? Minder controleerbaar dan een statische prompt, maar meer controleerbaar dan het lijkt — als het laden runtime-machinerie is. Een goed harness moet registreren welke skill-versies zijn gekoppeld, welke handles zijn opgehaald en voldoende context-metadata verzamelen bij elke stap om te reconstrueren wat het model zag; TrueFoundry's versiebeheerde registry, offloading en trace-primitieven — die de contextgrootte per stap al inzichtelijk maken — maken dat operationele model praktisch, zodat "wat zag de agent?" verandert in een precies antwoord per stap. JIT-via-maatwerk-scripts is waar auditeerbaarheid verdwijnt; JIT-via-harness is waar het wordt hersteld.
Northwind en Lucia zijn een illustratief samengesteld voorbeeld, geen specifieke organisatie. De just-in-time-benadering volgt Anthropic's gepubliceerde context-engineering-richtlijnen (september 2025) en daaropvolgende community- en academische discussies, geparafraseerd met bronvermelding; bevindingen over kwaliteitsverlies bij grotere invoer worden geciteerd als onderzoek van derden, niet als metingen van TrueFoundry. Token-aantallen, percentages en het configuratie-fragment zijn illustratief, geen product-schema of benchmarks. TrueFoundry-functionaliteiten weerspiegelen de openbare documentatie op het moment van schrijven; controleer deze met de huidige documentatie.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















