



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
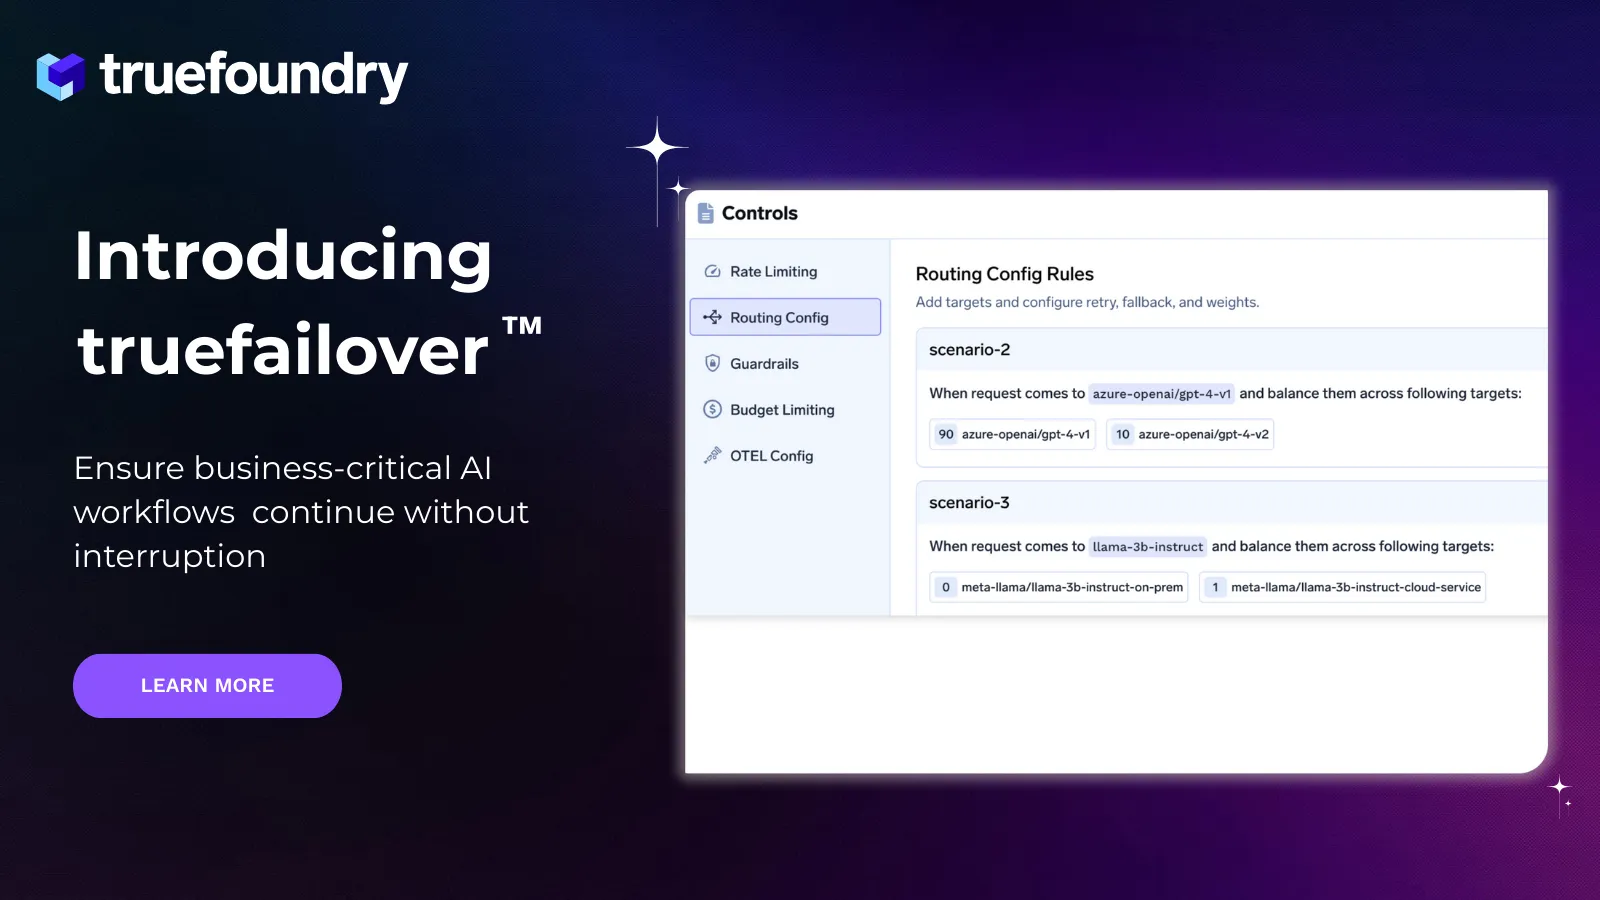
AI-uitval komt steeds vaker voor en treft productiesystemen hard. truefailover is onze nieuwe resilience-functionaliteit die automatisch om modeluitval, regionale storingen en API-degradatie heen routeert, zodat je AI-applicaties online blijven.
In november 2025 verstoring een storing bij Google Meet vergaderingen, sollicitatiegesprekken en klantgesprekken over de hele wereld. Een AWS-storing in oktober 2025 trof duizenden productiesystemen die afhankelijk zijn van cloudinfrastructuur. Weken later veroorzaakte een Cloudflare-storing in november 2025 wijdverbreide instabiliteit op het internet. En in januari 2026 zorgde een storing bij Anthropic’s Claude AI er direct voor dat AI-gestuurde workflows binnen ondernemingen tot stilstand kwamen.
Het opvallende is niet alleen dat deze storingen plaatsvonden — het is waar ze plaatsvonden. Dit waren kernbouwstenen waarvan moderne applicaties aannemen dat ze altijd beschikbaar zijn. Voor teams die AI in productie draaien, vertaalden deze incidenten zich in stilgelegde workflows, gemiste SLA's, oplopende supportwachtrijen en klanten die in de kou bleven staan.
We hebben truefailover gebouwd omdat "het model ligt eruit" geen acceptabele foutmodus meer is.
De meeste AI-applicaties zijn tegenwoordig hecht gekoppeld aan één enkel model, één provider of één regio. Wanneer die afhankelijkheid faalt — of zelfs maar vertraagt — faalt de applicatie mee.
Dit is bijzonder riskant omdat AI-uitval zelden eenduidig is. Het uit zich vaak als:
Van buitenaf lijkt het systeem "up", maar gebruikers ervaren timeouts, Inconsistente antwoorden of onderbroken flows.
Zoals Nikunj Bajaj, co-founder en CEO van TrueFoundry, uitlegt: "Te veel teams hebben gebouwd op capaciteit, niet op continuïteit. Ze kiezen op papier het beste model, maar vragen zich nooit af wat er gebeurt als het op dinsdagmiddag om 15.00 uur niet beschikbaar is."
truefailover is een toegewijde module voor storing-veerkracht die is ingebouwd in de TrueFoundry AI Gateway.
Het bevindt zich tussen je applicaties en de AI-providers waarvan ze afhankelijk zijn, waar het continu status-signalen monitort en realtime routingbeslissingen neemt. Wanneer een model, regio of provider ongezond wordt, wordt het verkeer automatisch omgeleid naar een gezond alternatief — zonder dat applicatieteams code hoeven aan te passen of handmatig hoeven in te grijpen.
In plaats van dat storingen incidenten worden, worden het routinggebeurtenissen.
In de kern combineert truefailover multi-model en multi-region uitvoering met statusbewuste routing.
Teams definiëren een primair uitvoeringspad (bijvoorbeeld een voorkeursmodel of -regio) samen met een of meer fallbacks. truefailover evalueert continu de latency, foutpercentages en andere statussignalen voor deze opties. Wanneer de omstandigheden verslechteren tot voorbij acceptabele drempelwaarden, wordt het verkeer automatisch omgeleid. Dit gebeurt snel genoeg zodat eindgebruikers de storing nooit merken.
De volgende functionaliteiten maken dit mogelijk:
1. Multi-model failover over verschillende providers
Met truefailover kun je fallback-modellen configureren over providers zoals OpenAI, Anthropic, Gemini, Groq, Mistral of self-hosted modellen. Als een primair model niet beschikbaar is, tegen rate-limits aanloopt of is gedegradeerd, stromen verzoeken naadloos door naar de op één na beste optie.
Dit is vooral belangrijk voor klantgerichte AI, waar "het model ligt eruit" geen acceptabel antwoord is.
2. Multi-region en multi-cloud veerkracht
truefailover ondersteunt het draaien van AI-endpoints over meerdere regio's en clouds, met routing op basis van status die verkeer wegleidt van falende zones. Regionale storingen worden geïsoleerd in plaats van dat ze wereldwijd doorwerken, terwijl gebruikers antwoorden met een lage latency blijven ontvangen.
3. Degradatiebewuste routing
Niet alle storingen zijn binair. truefailover reageert op vertragingen en gedeeltelijke fouten — niet alleen op harde uitval — en voorkomt zo de "technisch up maar onbruikbaar"-scenario's die de gebruikerservaring en SLA's geruisloos aantasten.
4. Ingebouwde observability en traceerbaarheid
Elke routingbeslissing is observeerbaar. Teams kunnen zien waar storingen ontstonden, hoe het verkeer verschoof en welke modellen de belasting hebben opgevangen. Dit maakt incidentanalyses sneller en geeft platformteams het vertrouwen dat de failover daadwerkelijk heeft gewerkt.
5. Caching en rate protection
Tijdens upstream-instabiliteit of pieken in het verkeer gebruikt truefailover strategische caching en rate protection om ketenstoringen te voorkomen. Hierdoor kunnen systemen providerlimieten en vraagpieken opvangen zonder plotselinge capaciteitsval.
truefailover zal beschikbaar zijn als een add-on resilience-module op de TrueFoundry AI Gateway en het platform. We openen binnenkort een early access-programma voor designpartners, waarna een bredere beschikbaarheid volgt.
Als je geïnteresseerd bent in het krijgen van early access, kun je hier contact met ons opnemen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox

















