



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Klantenservice-chats lekken BSN-nummers in prompts. Interne ontwikkelaars plakken AWS-toegangssleutels in een coding assistant. Een toxisch antwoord glipt door naar een eindgebruiker. Elk van deze gevallen is een daadwerkelijk LLM-operatieprobleem — en elk geval kan binnen enkele milliseconden worden opgevangen door een kleine lokale classifier, zonder LLM-roundtrip. De moeilijkere vraag is hoe u deze controles instelt over honderden applicaties en tientallen model providers, inline met elk verzoek, zonder voor elke app een andere validatiestack te bedenken. De integratie tussen Guardrails AI en TrueFoundry AI Gateway brengt het antwoord samen op één plek.
Elke LLM-aangedreven applicatie binnen een organisatie stuit uiteindelijk op dezelfde vraag: waar moeten de veiligheidscontroles plaatsvinden? Als ze in elke app afzonderlijk worden ingebouwd, raken ze gefragmenteerd bij elke deployment en ontstaan er verschillen tussen teams. Worden ze voor elke model provider geplaatst, dan vermenigvuldigen ze zich over verschillende leveranciers en missen ze de apps die eromheen werken. TrueFoundry AI Gateway lost dit vraagstuk op door te fungeren als de enkele uitvoeringslaag waar al het LLM-verkeer doorheen gaat — het spreekt de OpenAI-compatibele API aan de voorkant, verdeelt het verkeer naar elke model provider aan de achterkant en verwerkt alle overkoepelende taken (authenticatie, rate limits, observability, policy) in het midden. Eén enkele pod verwerkt 250+ RPS op 1 vCPU met ongeveer 3 ms aan toegevoegde latency, stateless en CPU-gebonden, met configuratie gesynchroniseerd via NATS zodat het verzoekpad nul externe calls maakt.
Het centraliseren van het verzoekpad is wat guardrails een natuurlijke plek geeft. De gateway biedt vier hooks — llm_input, llm_output, mcp_pre_tool, mcp_post_tool — en elk gewenst aantal guardrails kan hierop worden aangesloten. De gateway voert ze parallel uit op hetzelfde verzoek, zodat een PII-detector, een secret scanner en een toxicity-classifier allemaal dezelfde prompt op hetzelfde moment evalueren zonder dat er seriële latency ontstaat. Input rails draaien gelijktijdig met de model call, en als een van de rails blokkeert, wordt de actieve model call geannuleerd voordat er tokens in rekening worden gebracht — een echte kostenbesparing wanneer validators daadwerkelijke policy-schendingen in klantverkeer opvangen. Met een custom HTTP-plugin kan elke leverancier of interne dienst meedoen zolang deze het verdict-contract van de gateway ondersteunt, wat precies het koppelvlak is waarop Guardrails AI aansluit.
Guardrails AI is een open-source Python-framework voor het valideren van LLM-inputs en -outputs. De belangrijkste abstractie is de Guard — een wrapper om een of meer validators die zijn opgehaald uit de Guardrails Hub, een registry van vooraf gebouwde controle-implementaties. De Hub-catalogus omvat PII-detectie, secret-detectie, toxicity-classificatie, profaniteitsfilters, onderwerprestrictie, hallucination grounding en meer. De meeste validators zijn lokale heuristieken of kleine classifiers; een klein deel roept een externe LLM aan tijdens de validatie.
De v1-bundle voor deze integratie maakt gebruik van vier lokale validators: DetectPII (een Microsoft Presidio-wrapper voor e-mails, telefoonnummers, US SSN, creditcards, IBAN, US paspoort / rijbewijs / ITIN), SecretsPresent (Yelp's detect-secrets voor AWS-sleutels, OpenAI-tokens, GitHub-tokens, JWT's, private keys), ToxicLanguage (Unitary's Detoxify classifier van Hugging Face), en ProfanityFree (een woordenlijstfilter voor antwoorden van assistants). Geen van deze vereist een LLM-call. De mediane validatie-latency op een opgewarmde pod is minder dan 100 ms per validator.
De integratie behandelt Guardrails AI als een library, wikkelt deze in een FastAPI-dienst en registreert de dienst als een custom HTTP-guardrail in TrueFoundry. Om een bekende v0.9.3-eigenaardigheid te omzeilen waarbij opeenvolgende Guard.use()-calls elkaar overschrijven, biedt de wrapper één POST-endpoint per validator per richting — /detect-pii-input, /secrets-present-output, /toxic-language-input, enzovoort — en voert elke Guard in isolatie uit. Beheerders kiezen in het dashboard welke validators aan welk model worden gekoppeld.

Hub-validators worden geïnstalleerd op Docker-buildtijd via een build-arg met het Hub-token. Het token wordt gebruikt in de build-laag en is niet aanwezig in de runtime-omgeving. Validator-versies zijn vastgezet op de versie die de Hub op buildtijd leverde; het vernieuwen van de bundle vereist het bewerken van de Dockerfile en een hernieuwde deployment.
De structuur van de wrapper-response is:
Wrapper meldtGateway interpreteertHTTP 200 + {"verdict": true}Toestaan — validator is niet geactiveerdHTTP 200 + {"verdict": false, "message": "<validator>: ..."}Blokkeren — gateway geeft het bericht doorHTTP 5xxEchte fout — gerouteerd via de Fail on error policy van het dashboard
De HTTP-status geeft "voltooid vs fout" aan; het verdict bevindt zich in de JSON. Rail-blokkades en tijdelijke storingen zijn te onderscheiden, waardoor Fail on error: false de veilige standaardinstelling is.
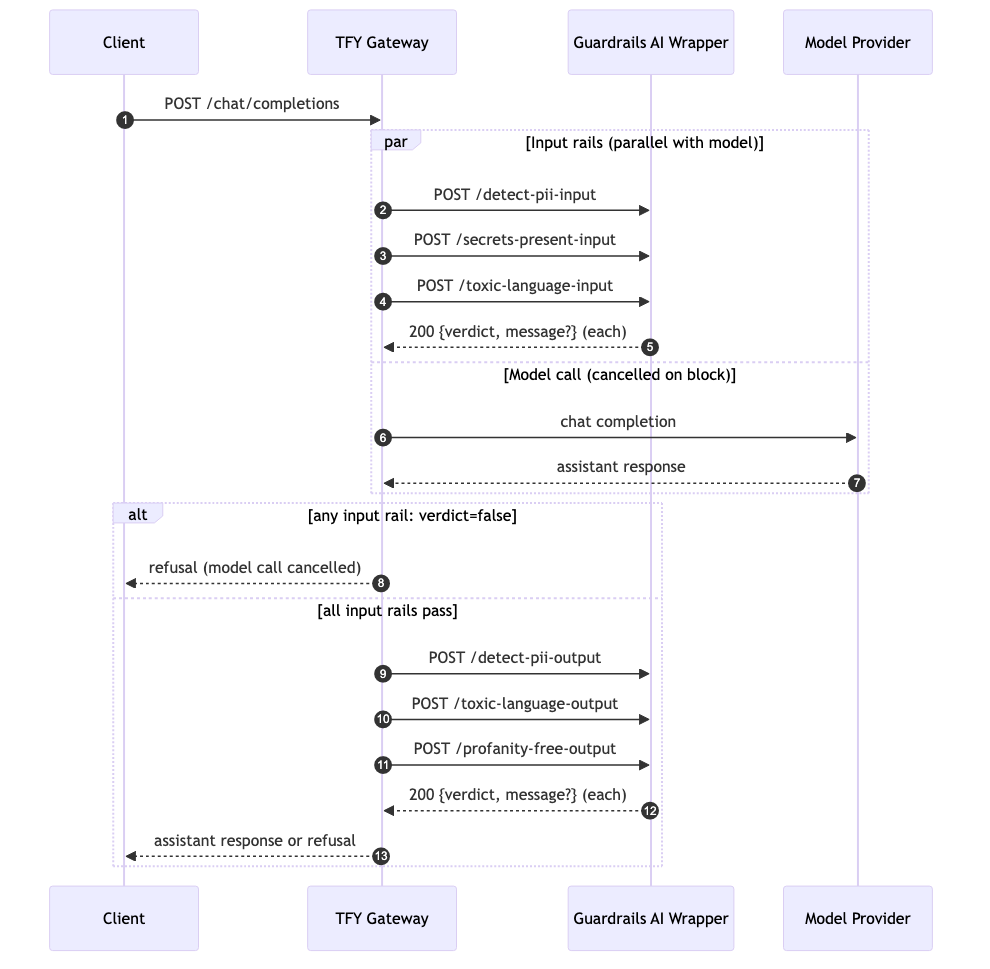
X-TFY-GUARDRAILS-header).{"verdict": false, "message": "<validator>: <reason>"}; alle validators die slagen, retourneren {"verdict": true}.Omdat geen enkele validator een externe LLM aanroept, wordt de toegevoegde latency per rail voornamelijk bepaald door Python-uitvoering en classifier-inferentie — doorgaans ruim onder 100 ms op een opgewarmde pod, zonder externe afhankelijkheden die kunnen uitvallen.
De wrapper wordt geleverd als een enkele FastAPI-dienst die kan worden gedeployed via de standaard TrueFoundry Python SDK. Configureer de URL van de wrapper en de bearer key als een Custom Guardrail per validator in het dashboard, koppel de rails aan een model of selecteer per verzoek, en de validators draaien inline op elke call. De referentie-implementatie bevindt zich op integrations/guardrails-ai/ in de integrations-custom-guardrails repository; bekijk de TrueFoundry custom guardrail documentatie voor de workflow in het dashboard en de Guardrails Hub catalogus voor aanvullende validators.
Het architectonische principe is de strikte scheiding tussen de complexiteit van de validator en de uitvoering door de gateway. De gateway blijft stateless, CPU-gebonden en vrij van externe afhankelijkheden in het verzoekpad. Presidio-analyzers, detect-secrets plugins en Hugging Face-inferentie bevinden zich allemaal achter één HTTP-grens. Het vervangen van een validator-engine in de toekomst is enkel een aanpassing in de wrapper — de dashboardconfiguratie, het contract en de aanroepende apps blijven exact hetzelfde.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















