Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.
9,9
Gemini 3 vs Kimi-K2 Thinking vs Grok-4.1 vs GPT-5.1: Wie wint daadwerkelijk Humanity’s Last Exam?
Bijgewerkt: November 10, 2026
Gepubliceerd: November 9, 2026
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting
De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Verwerkt 350+ RPS op slechts 1 vCPU — geen tuning nodig
Productieklaar met volledige enterprise-ondersteuning
Wanneer Google zegt “Plan anything” met Gemini 3, Moonshot beweert dat Kimi-K2 Thinking de nieuwe redeneer-SOTA is, xAI Grok-4 “het meest intelligente model ter wereld” noemt, en OpenAI GPT-5.1 blijft pushen, is het lastig te bepalen wat echt is en wat slechts marketingpraatjes zijn.
In plaats van nog een muur van benchmark-grafieken, is hier een belangrijkere vraag:
Wat gebeurt er als je Gemini 3, Kimi-K2 Thinking, Grok-4.1 en GPT-5.1 dezelfde set problemen in de stijl van Humanity’s Last Exam voorlegt — en daadwerkelijk bekijkt hoe ze denken?
In dit artikel:
Waarom Humanity’s Last Exam (HLE) de “eindbaas” van academische benchmarks is geworden.
Een snelle rondleiding langs Gemini 3, Kimi-K2 Thinking, Grok-4.1 en GPT-5.1 als “denkende” modellen.
Vijf concrete casestudies in HLE-stijl op het gebied van wiskunde, multimodale fysica, long-context wetenschap, speltheorie en planning.
Hoe je deze experimenten zelf kunt uitvoeren via de TrueFoundry AI Gateway.
1. Humanity’s Last Exam in 2 minuten
Benchmarks zoals MMLU zijn voor de nieuwste modellen vrijwel “uitgespeeld”. Veel topmodellen scoren daarin boven de 90%, dus een procentje meer of minder zegt weinig over hoe het is om er daadwerkelijk mee te werken.
Humanity’s Last Exam (HLE) is anders:
Het is een door experts samengesteld examen over wiskunde, natuurwetenschappen, engineering, economie, geesteswetenschappen, recht en meer.
Het combineert meerkeuze- en exact-match-vragen, waarvan er veel meerdere niet-triviale redeneerstappen vereisen.
Een aanzienlijk deel van de vragen is multimodaal, wat modellen dwingt om gezamenlijk over tekst en afbeeldingen te redeneren.
Cruciaal is dat zelfs de allerbeste modellen van vandaag op HLE nog ver verwijderd zijn van het niveau van menselijke experts, en hun zekerheid is vaak slecht gecalibreerd.
De auteurs vragen expliciet om de ruwe vragen niet te herpubliceren, omdat ze willen dat HLE een nuttige benchmark voor de lange termijn blijft. Daarom in dit artikel:
Laten we de originele formulering van vragen niet zien.
In plaats daarvan beschrijven we vijf representatieve taken in "HLE-stijl" en hoe de modellen zich hierop gedragen.
Je kunt deze patronen zelf reproduceren met behulp van de openbare HLE-dataset of vergelijkbare problemen uit je eigen domein.
2. Vier “denkende” modellen in 2025
We vergelijken hier geen eenvoudige “chatbots”, we kijken naar modellen die expliciet zijn gepositioneerd als redeneerders: diepgaande chain-of-thought, tools, long-context, planning.
Gemini 3 (Pro + Deep Think)
Google presenteert Gemini 3 als zijn krachtigste model tot nu toe:
Sterkere redeneervermogens en multimodaal begrip dan de Gemini 2.5-generatie.
Competitieve scores op HLE zonder tools, plus uitstekende prestaties op GPQA, MMMU-Pro, Video-MMMU en andere redeneer-benchmarks.
Een grote focus op long-horizon agents met tool-calling: het “plan anything”-verhaal, inclusief toptesultaten op planningsbenchmarks zoals Vending-Bench.
Gemini 3 biedt ook een Deep Think-modus die meer rekenkracht en tokens gebruikt bij moeilijke problemen om extra nauwkeurigheid te behalen.
Kimi-K2 Thinking
Moonshots Kimi-K2 Thinking is een open-weight “denkend” model:
Mixture-of-experts-architectuur met een gigantisch totaal aantal parameters, maar een kleinere actieve subset per token.
Lange context (honderdduizenden tokens) en van nature een zeer intensieve chain-of-thought.
Publieke analyses tonen Kimi-K2 Thinking en de “Heavy”-variant vaak aan of nabij de top op HLE en andere redeneer-benchmarks.
Als je ooit een model pagina’s aan interne monoloog hebt zien spuien voor één wiskundeprobleem: dat is de typische Kimi-stijl.
Grok-4 / Grok-4.1
xAI’s Grok-4-lijn wordt gepositioneerd als:
Een zeer krachtig redeneermodel met native toolgebruik en internetzoekfunctionaliteit.
Sterk op HLE, GPQA en long-horizon taken waar agents over vele stappen consistent gedrag moeten vertonen.
Grok-4.1 legt meer nadruk op “emotionele” en creatieve intelligentie, maar behoudt de kernkracht op het gebied van redeneren.
Zie Grok-4.x als het model dat echt een agent wil zijn: plannen, zoeken, handelen, reflecteren, herhalen.
GPT-5.1 (GPT-5-familie)
OpenAI’s GPT-5-familie is de standaard waar de meesten naar grijpen:
Zeer sterk in brede benchmark-suites: coding, redeneren, multimodaal, long-context.
Wanneer uitgevoerd in een modus met een hoge “reasoning effort” / “thinking”, kent het meer tokens toe, berekent het lastige problemen en verkleint het de kloof op geavanceerde benchmarks zoals HLE en GPQA.
We verwijzen naar GPT-5.1 Thinking als een GPT-5-variant die in dat profiel met hoge inspanning draait.
3. Hoe we ze hebben vergeleken (zonder HLE te lekken)
Het doel hier was niet om het zoveelste leaderboard te bouwen, maar om te zien hoe deze modellen zich gedragen op taken in HLE-stijl.
In hoofdlijnen:
We hebben een set representatieve HLE-vragen geselecteerd (wiskunde, multimodale fysica, lange wetenschappelijke passages, speltheorie, planning).
Voor elke vraag gebruikten we een consistente “examen-modus” prompt:
“Reason step by step.”
“Explain your thinking.”
“End with Final answer: … and Confidence: ….”
We voerden exact dezelfde vraag en structuur uit op:
Kimi-K2 Thinking
Grok-4.1
GPT-5.1 Thinking
Gemini 3 Pro (en indien beschikbaar, Gemini 3 Deep Think)
Dit alles werd aangestuurd via de TrueFoundry AI Gateway:
Één endpoint waarop we OpenAI, Google, xAI, Moonshot en meer dan 1000 andere modellen aansluiten.
Één plek om antwoorden, tokens, latency en kosten per call te loggen.
Één set van authenticatie, quota en guardrails over alle vendors heen.
Daarover later meer — laten we nu kijken naar de vijf casestudies.
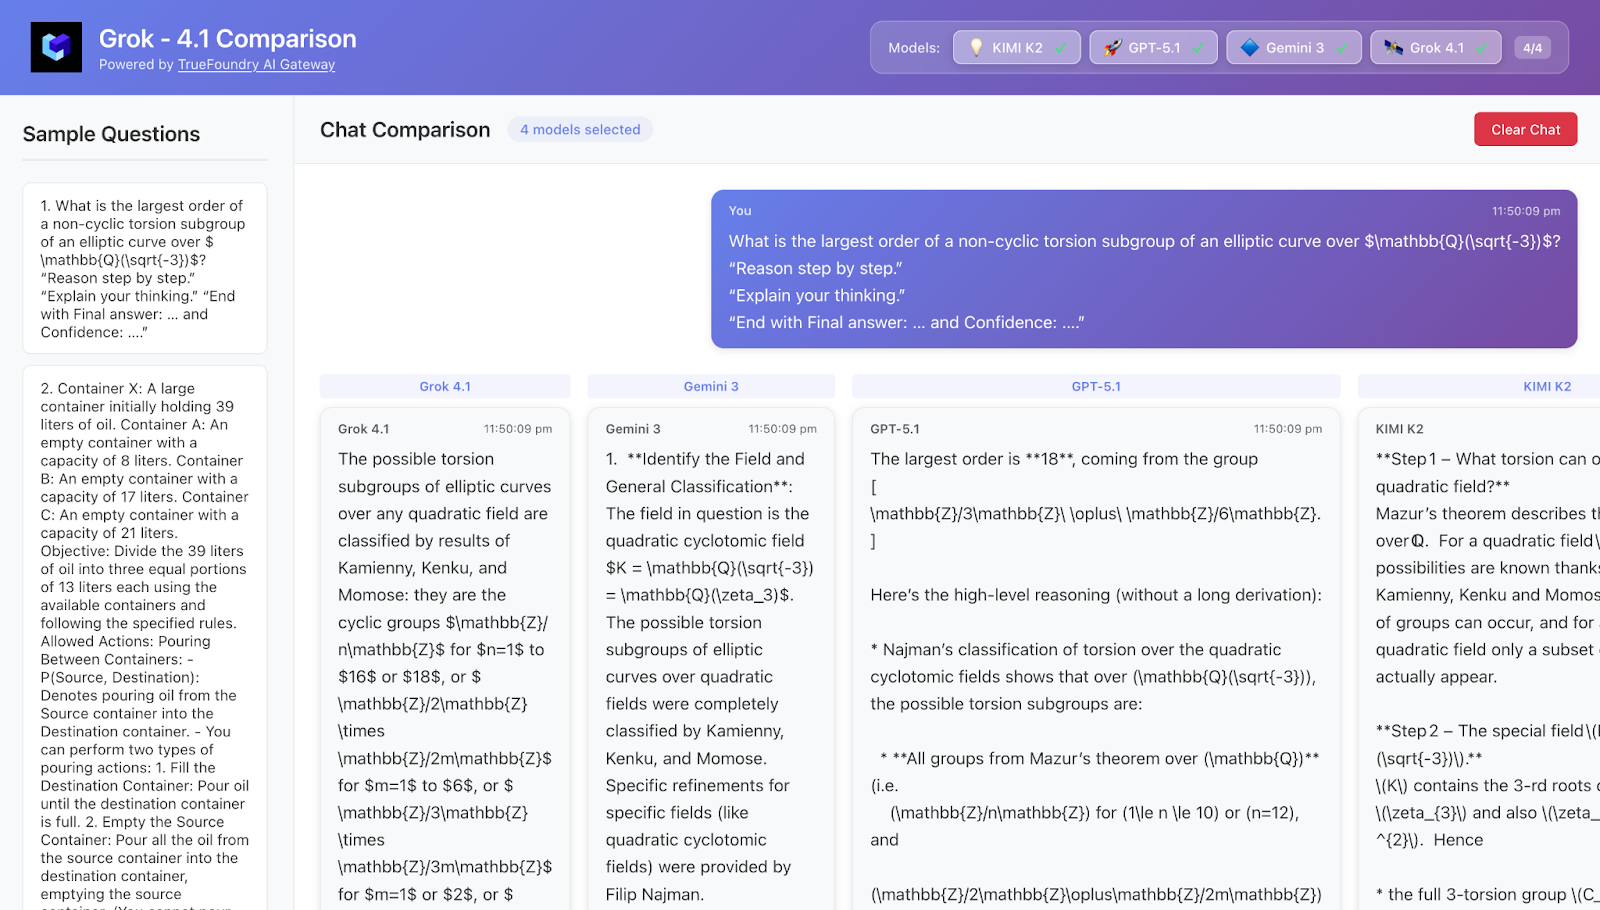
4. Casestudie 1 – Diepgaande wiskunde: nauwkeurigheid vs token-hongerig denken
Taak Een wiskundeprobleem op universitair niveau (denk aan getaltheorie / combinatoriek):
Eén kort antwoord (een geheel getal of een eenvoudige expressie).
Vereist ~4–6 niet-triviale redeneerstappen.
Zeer moeilijk correct te raden zonder het daadwerkelijk uit te werken.
Waar we naar kijken
Zet het model de structuur correct op (bijv. de juiste stelling / classificatie)?
Voert het de redenering tot het einde uit zonder een minteken te vergeten?
Hoeveel tokens verbruikt het om daar te komen?
Hoe goed is de zekerheid gecalibreerd?
Typische waargenomen patronen
Kimi-K2 Thinking
Extreem lange chain-of-thought: roept relevante stellingen op, onderzoekt meerdere mogelijke benaderingen, vertakt en herstelt vaak van dwaalsporen.
Zeer sterk in nauwkeurigheid, vooral in de “Heavy”-modus, maar verbruikt vaak aanzienlijk meer tokens dan andere modellen.
Zelfrapportage van zekerheid is vaak 90–100%, zelfs bij vrij delicate problemen.
Grok-4.1
Moedig en verkennend: schetst snel een intuïtief antwoord en probeert het daarna te onderbouwen.
Als het klopt, is het briljant; als het fout is, kan het zeer zelfverzekerd fout zitten.
GPT-5.1 Thinking
Goede structuur: somt gevallen duidelijk op, labelt ze en verwijst er helder naar terug.
Onderneemt vaak iets bescheidener schattingen van de eigen zekerheid, vooral wanneer het probleem meerdere diepgaande feiten vereist.
Gemini 3 (Pro / Deep Think)
Redenering in meerdere stappen, maar merkbaar beknopter dan Kimi-K2’s muren van tekst.
De Deep Think-modus dicht een groot deel van de HLE-kloof met Kimi/Grok, terwijl de uitleg wat beheerster blijft.
Conclusie Als je op zoek bent naar elk extra punt op wiskunde in HLE-stijl, voelen Kimi-K2 Thinking en Grok-4.x als de koplopers, met Gemini 3 Deep Think vlak daarachter. Als je evenveel geeft om kosten en snelheid als om pure nauwkeurigheid, zijn Gemini 3 en GPT-5.1 Thinking aantrekkelijk omdat ze vergelijkbare resultaten behalen terwijl ze minder tokens verbruiken.
5. Casestudie 2 – Multimodale fysica: “kijk daadwerkelijk naar het diagram”
Taak Een natuurkunde- / engineeringvraag met veel diagrammen:
Een schakelschema, krachten diagram of optische opstelling is ingebed als afbeelding.
De vraag vraagt om een numeriek antwoord (bijv. stroom, hoek, tijd).
Je kunt niet correct antwoorden zonder de afbeelding goed te analyseren.
Waar we naar kijken
Beschrijft het model het diagram op een manier die overeenkomt met de afbeelding?
Maken ze aannames die niet aanwezig zijn in de afbeelding?
Hoe goed combineert het afbeelding en tekst tot een coherente afleiding?
Typische waargenomen patronen
Gemini 3
Zeer zorgvuldig over de afbeelding zelf: “de pijl wijst naar links”, “er zijn drie weerstanden in serie”, “de massa is bevestigd met twee veren”.
Minder hallucinaties over de inhoud van het diagram.
Voelt over het geheel genomen het meest gegrond in zijn multimodale redeneringen.
GPT-5.1 Thinking
Sterk multimodaal begrip, maar vaak minder expliciet: gebruikt het diagram correct, maar beschrijft het niet altijd in detail.
Fouten ontstaan meestal door een verkeerde lezing van de tekst in plaats van de afbeelding.
Kimi-K2 Thinking
Zodra de gegevens kloppen, is de natuurkunde solide.
Maar onder druk kan het elementen in het diagram verkeerd tellen (bijv. aantal componenten) en die fout vervolgens doorwerken in een zeer lange afleiding.
Grok-4.1
Vergelijkbaar met GPT-5.1 in stijl: intuïtief, vaak correct, maar af en toe overmoedig bij een verkeerd geïnterpreteerde lijn of label.
Conclusie Als een groot deel van je werklast in HLE-stijl bestaat uit diagrammen, schema's of visuele puzzels, is de multimodale stack van Gemini 3 een uitblinker. GPT-5.1, Kimi-K2 en Grok-4.1 zijn allemaal capabel, maar gevoeliger voor het “zien” van details die er niet helemaal zijn.
6. Casestudie 3 – Long-context wetenschap: lezen, niet alleen oplossen
Meerdere alinea's die een experiment, methoden, resultaten en kanttekeningen beschrijven.
Vervolgens een vraag die vraagt om integratie van informatie over de gehele passage, niet alleen de laatste alinea.
Waar we naar kijken
Vat het model de passage nauwkeurig samen?
Houdt het variabelen, voorwaarden en uitzonderingen in de verschillende alinea's bij?
Identificeert het correct welke details er echt toe doen om de vraag te beantwoorden?
Typische waargenomen patronen
Gemini 3
Goed in het comprimeren van lange passages tot vlijmscherpe opsommingstekens.
Heeft de neiging om kernfeiten te herhalen en vervolgens “vanuit de notities” naar het antwoord te redeneren.
Spreekt zichzelf zelden tegen bij het verwijzen naar eerdere delen van de passage.
GPT-5.1 Thinking
Uitstekend in het bijhouden van variabelen en experimentele opstellingen; voelt als een zorgvuldige onderwijsassistent.
Onderneemt vaak de strakste “lezen → samenvatten → concluderen” pijplijn.
Kimi-K2 Thinking
Hyper-gedetailleerd: herhaalt veel van de passage en leidt soms achtergrondtheorie opnieuw af.
Die diepgang is nuttig, maar de enorme lengte betekent dat er af en toe afdwalingen of interne tegenstrijdigheden kunnen insluipen.
Grok-4.1
Zeer goed in het extraheren van praktische implicaties (“dit suggereert dat behandeling A de voorkeur heeft wanneer…”).
Zie soms zeldzame randgevallen over het hoofd die in de tekst worden genoemd.
Conclusie Voor vragen in HLE-stijl van het type “lees dit en begrijp het daadwerkelijk”, zijn Gemini 3 en GPT-5.1 Thinking bijzonder sterk: ze vatten helder samen, behouden belangrijke details en houden de logica strak. Kimi-K2 en Grok-4.1 zijn eveneens capabel, maar hun langere verhalen kunnen meer kansen op afdwaling bieden.
7. Casestudie 4 – Speltheorie & micro-economie: wie redeneert als een onderwijsassistent?
Taak Een vraag over micro-economie / speltheorie:
Meerdere spelers, een kleine set acties en beschrijvingen van uitbetalingen.
Er wordt gevraagd om evenwichten te vinden, strategieën te karakteriseren of welvaartsuitkomsten te vergelijken.
Waar we naar kijken
Somt het model alle relevante gevallen op?
Houdt het de logica consistent van de casusanalyse tot het uiteindelijke antwoord?
Is het zich bewust van subtiliteiten zoals gemengde strategieën, dominantie of symmetrie?
Typische waargenomen patronen
Kimi-K2 Thinking
Leest als een student-assistent: veel stapsgewijze analyses per geval, expliciete constructie van tegenvoorbeelden, zorgvuldige afweging van randgevallen.
Zeer sterk wanneer je de gehele redeneerboom wilt zien.
Grok-4.1
Intuïtief uitstekend in redeneren over prikkels (“als speler A afwijkt, winnen ze X, dus dit kan geen evenwicht zijn”).
Blijft af en toe vroeg steken in een intuïtief evenwicht en moet worden aangespoord om dit te heroverwegen.
GPT-5.1 Thinking
Systematisch: labelt gevallen (Geval 1, Geval 2, …), vat bevindingen samen en knoopt ze vloeiend aan elkaar.
Goede balans tussen diepgang en beknoptheid.
Gemini 3
Vergelijkbaar met GPT-5.1 in structuur, met een grotere neiging om expliciet terug te krabbelen (“laten we de aanname heroverwegen dat…”), vooral in een Deep Think-modus.
Conclusie Bij speltheoretische HLE-vragen voelen Kimi-K2 Thinking en Grok-4.1 het dichtst bij een menselijke onderwijsassistent: veel expliciet werk per casus en intuïtieve discussie. Gemini 3 en GPT-5.1 komen met minder omwegen tot het antwoord, wat de voorkeur kan hebben wanneer je de uitvoer rechtstreeks naar code of beslissingspijplijnen stuurt.
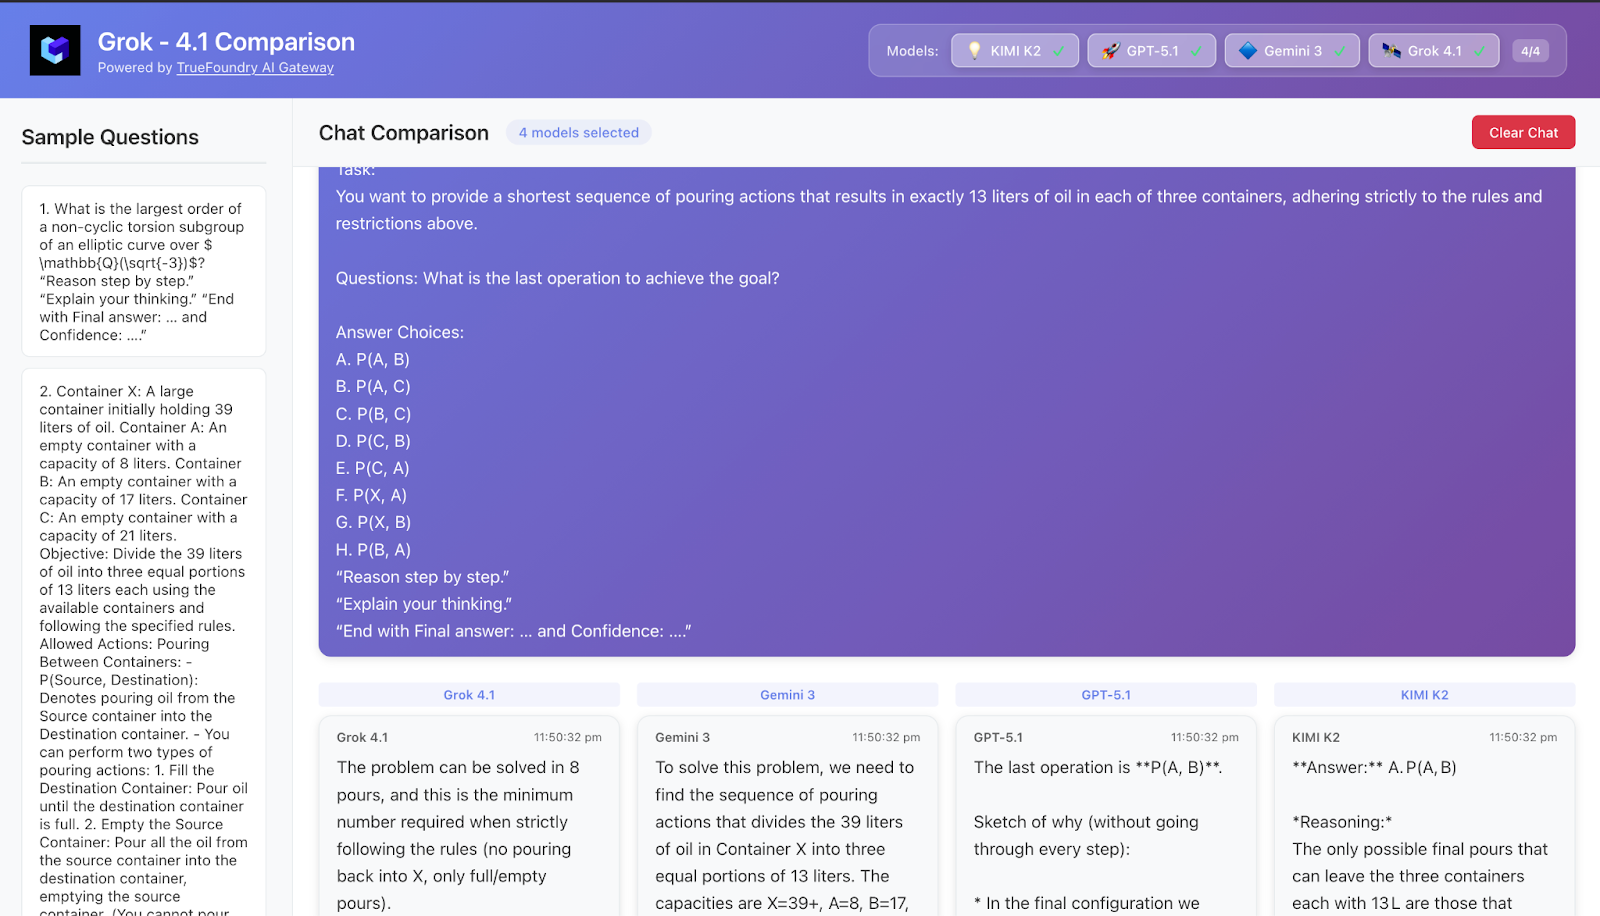
8. Casestudie 5 – Planningsproblemen: mini-agents in een prompt
Taak Een puzzel in de stijl van planning / operations research:
Meerdere containers, capaciteiten en schenkregels, of een opstelling voor planning / voorraadbeheer.
Je moet een beleid of een reeks acties kiezen die een doel bereikt in minimale stappen onder restricties.
Waar we naar kijken
Zet het model de toestandsruimte duidelijk op?
Simuleert het reeksen correct zonder eerdere acties te vergeten?
Houdt het zich aan de restricties die het zelf heeft gesteld?
Typische waargenomen patronen
Grok-4.1
Zeer agent-achtig: schrijft expliciet toestanden uit (“na stap 3: voorraad is X, Y, Z”), controleert elke toestand tegen het doel en stuurt bij waar nodig.
Voelt het dichtst bij het gebruik van een echte plannings-agent binnen één enkele prompt.
Gemini 3
Vergelijkbare planningsstijl: herformuleert de doelstelling en restricties, stelt een beleid voor en simuleert vervolgens meerdere stappen.
Bijzonder goed in het niet kwijtraken van de toestand over langere reeksen, wat goed aansluit bij de long-horizon / Vending-Bench positionering.
GPT-5.1 Thinking
Goede conceptuele planning, maar gevoeliger voor kleine reken- of administratiefouten over veel stappen heen.
Wanneer gevraagd wordt om de “kortste reeks” te garanderen, heeft het soms een tweede poging nodig.
Kimi-K2 Thinking
Biedt veel gedetailleerde simulaties, maar de combinatie van lange CoT + complexe toestand leidt soms tot kleine inconsistenties (bijv. een hoeveelheid die geruisloos verandert tussen stappen).
Conclusie Op planningsgerichte HLE-taken voelen Grok-4.1 en Gemini 3 als de meest betrouwbare mini-agents. Kimi-K2 en GPT-5.1 zijn zeer capabel, maar hun lange redeneersporen kunnen soms tegen hen werken wanneer het bijhouden van de toestand kritiek is.
9. Dus… wie “wint” Humanity’s Last Exam?
Als je alleen kijkt naar de hoofdpercentages op HLE, staan Kimi-K2 Thinking (vooral de Heavy-varianten) en sommige Grok-4-configuraties momenteel aan of nabij de top, met Gemini 3 Deep Think er vlak achter en GPT-5 Pro iets lager.
Maar HLE is op de beste manier chaotisch:
Nauwkeurigheid ligt nog steeds ver onder het niveau van menselijke experts.
Zekerheid is vaak verkeerd gecalibreerd: modellen kunnen zeer zeker en volledig fout zijn.
Verschillende domeinen (wiskunde vs wetenschap vs planning vs geesteswetenschappen) tonen verschillende winnaars.
Uit de vijf casestudies:
Kimi-K2 Thinking
Het beste wanneer je maximale diepgang wilt en bereid bent te betalen in tokens en latency om het allerlaatste beetje prestatie eruit te persen.
Grok-4.1
Blinkt uit in planning en agent-achtig redeneren; als je taken lijken op simulaties of meerstaps zakelijke beslissingen, voelt Grok zeer natuurlijk aan.
GPT-5.1 Thinking
Een sterke, veilige standaard: geweldige long-context tekstinterpretatie, algemeen strakke structuur en zeer eenvoudig te integreren in bestaande systemen.
Gemini 3 (Pro + Deep Think)
Bijzonder overtuigend op het gebied van multimodaal redeneren, gestructureerd begrijpend lezen en planning — en de “Plan anything”-claim is niet zomaar marketing; het komt duidelijk naar voren in hoe het omgaat met lange, toestand-afhankelijke problemen.
Er is geen enkele winnaar voor Humanity’s Last Exam. Het “beste” model is het model dat het minste faalt op jouw specifieke taken, binnen jouw specifieke randvoorwaarden.
10. Hoe we dit hebben uitgevoerd via TrueFoundry AI Gateway
Onder de motorkap hebben we geen vier afzonderlijke integraties gebouwd. Alles liep via de TrueFoundry AI Gateway (truefoundry.com/ai-gateway):
Één endpoint voor OpenAI (GPT-5.1), Google (Gemini 3), xAI (Grok-4.x), Moonshot (Kimi-K2) en honderden andere modellen.
Gecentraliseerde observability: logs voor prompts, antwoorden, tokens, latency en fouten over alle vendors heen.
Ingebouwde governance & security: RBAC, audit logs en implementatieopties die data in jouw cloud of on-premise houden.
Aan de kant van het experimenteren betekende dit:
We hebben onze evaluatie-harness één keer aangesloten op de Gateway.
We hebben gpt-5.1-thinking, kimi-k2-thinking, grok-4.1, gemini-3-pro en gemini-3-deep-think simpelweg geregistreerd als verschillende model-ID's.
Wisselen tussen de modellen was een aanpassing van één regel in de configuratie, geen nieuwe SDK-integratie.
11. Probeer Gemini 3 (en de rest) op je eigen “eindexamen”
Als je de patronen uit dit artikel wilt reproduceren (of uitdagen):
Kies je examen.
Gebruik HLE of een intern “eindexamen” opgebouwd uit je eigen domein: onderzoeksvragen, supporttickets, code reviews, incident post-mortems.
Draai het via meerdere modellen.
Richt je evaluatie-harness op de TrueFoundry AI Gateway en voer dezelfde prompts uit op Gemini 3, Kimi-K2 Thinking, Grok-4.1 en GPT-5.1 Thinking.
Vergelijk op één plek.
Vergelijk correctheid, kwaliteit van redeneren, tokenverbruik, latency en kosten naast elkaar.
Bepaal welk “denkend” model daadwerkelijk de beste resultaten oplevert voor jouw taken.
Omdat in 2025 de enige benchmark die er echt toe doet niet HLE, MMLU of GPQA is — het is het examen dat lijkt op je eigen werk. En je hoeft niet op goed geluk een enkel model te kiezen wanneer je er vier kunt aansluiten achter één gateway en de resultaten voor zich kunt laten spreken.
Veelgestelde vragen
Wat is het verschil tussen Kimi K2 en Gemini 3?
Gemini 3 van Google richt zich op multimodaal begrip en sterke tool-calling-mogelijkheden met een Deep Think-modus. Kimi-K2 Thinking, een open-weight model, staat bekend om zijn uitgebreide lange context en gedetailleerde chain-of-thought-redenering. Het vergelijken van Kimi K2 met Gemini 3 laat verschillende benaderingen zien van geavanceerde AI-probleemoplossing.
Waar is Kimi K2 Thinking het beste voor?
Kimi-K2 Thinking is het beste voor complexe redeneringen en diepgaande probleemoplossende taken. Met zijn lange context en van nature intensieve chain-of-thought blinkt **Kimi K2** uit in uitdagingen die een uitgebreide interne monoloog vereisen, zoals geavanceerde wiskundeproblemen en benchmarks zoals Humanity's Last Exam, waar het vaak tot de topmodellen behoort.
Gemini 3 vs GPT-5: welke is beter?
Ons blog duikt in Gemini 3 vs GPT-5.1 door hun prestaties op Humanity's Last Exam te beoordelen. We hebben ontdekt dat 'beter' afhangt van de specifieke redeneertaak en het modelgedrag. De analyse van TrueFoundry, uitgevoerd via onze AI Gateway, belicht hun unieke benaderingen van probleemoplossing, zodat u de optimale pasvorm voor uw AI-oplossingen kunt bepalen.
Gemini 3 vs Grok-4: welk model presteert beter?
Bij het vergelijken van Gemini 3 vs Grok-4 blinken beide uit als krachtige redeneeragents, met sterke prestaties op complexe taken zoals Humanity's Last Exam. Gemini 3 beschikt over geavanceerd multimodaal begrip en een Deep Think-modus, terwijl Grok-4 zich richt op native toolgebruik en agentic functionaliteiten. De optimale prestaties hangen vaak af van de vereisten van de specifieke taak.
Welk AI-model is het beste voor redeneertaken?
Voor complexe redeneertaken tonen modellen zoals Gemini 3, Kimi-K2 Thinking en GPT-5.1 sterke capaciteiten. Ons blog evalueert hoe elk model presteert bij verschillende uitdagingen, zodat u hun specifieke sterkten kunt begrijpen. De optimale keuze bij het vergelijken van gemini 3 vs kimi k2 thinking vs gpt 5 hangt uiteindelijk af van de unieke eisen van uw project en het vereiste type redenering.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.
Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting