



november 20, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Als u ooit in een vergadering met uw InfoSec- of juridische team heeft gezeten over een wereldwijde ML-implementatie, kent u precies het moment waarop de sfeer omslaat. Het is wanneer iemand vraagt: "Wacht eens, waar staan de inference logs voor de Duitse klanten eigenlijk?"
Data residency was vroeger een databaseprobleem. Nu, met ML-pipelines die training, serving, monitoring en feature stores omvatten, is het een wijdverbreide chaos geworden over uw gehele infrastructuurstack. GDPR, CCPA, data-soevereiniteitswetten in Azië – het zijn geen vrijblijvende adviezen. Een fout maken betekent enorme boetes of, erger nog, het moeten afbreken van een actieve implementatie.
We gebruiken TrueFoundry voor het beheren van onze ML-infrastructuur, en eerlijk gezegd is hun aanpak van data residency een van de belangrijkste redenen waarom we bij hen zijn gebleven. Het verandert fundamenteel hoe we denken over waar data staat versus waar deze wordt beheerd.
Hier is een overzicht van hoe het in de praktijk werkt en waarom het anders aanvoelt dan typische SaaS MLOps-platforms.
Het grootste probleem met veel beheerde MLOps-platforms is dat u, om het gemak van hun tools te krijgen, vaak uw data (model artifacts, trainingssnippets, logs) naar hun cloud moet sturen. Dat is een absolute no-go voor streng gereguleerde sectoren.
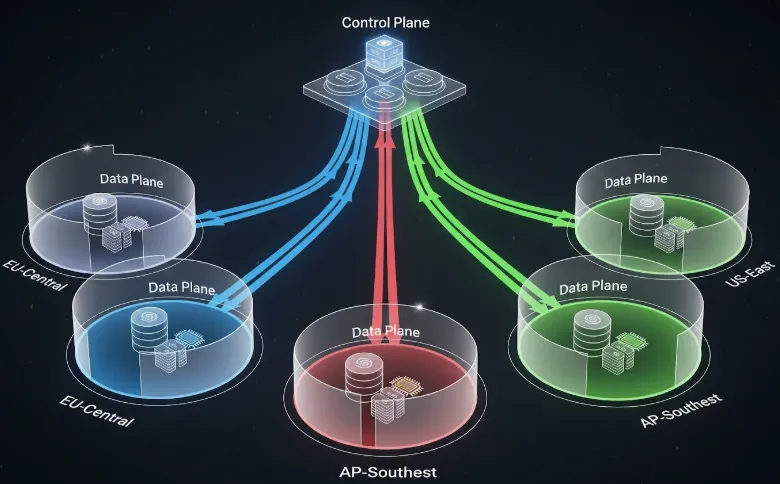
TrueFoundry werkt anders. Ze hanteren een strikte scheiding tussen het Control Plane (hun SaaS-beheerinterface) en het Data Plane (uw eigen cloudaccounts).
Zie het zo: TrueFoundry is de luchtverkeersleiding. Zij vertellen de vliegtuigen waar ze heen moeten en wanneer ze moeten landen. Maar u bent eigenaar van de luchthaven, de hangars en de vliegtuigen zelf. TrueFoundry heeft de lading in het vliegtuig nooit daadwerkelijk in bezit.
Wanneer u een Kubernetes-cluster (EKS, GKE, AKS) verbindt met TrueFoundry, installeert u in feite een agent. Die agent neemt contact op met het TrueFoundry Control Plane voor instructies, maar alle daadwerkelijke dataverwerking en -opslag vindt plaats binnen uw vooraf gedefinieerde netwerkperimeter.
Hier is een op hoofdlijnen weergegeven overzicht van die relatie.
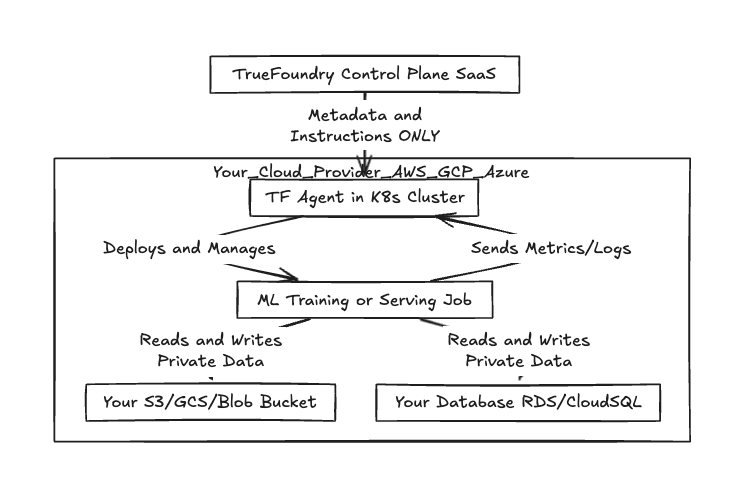
Afb. 1: Workflow van de scheiding tussen Control Plane en Data Plane
Zoals hierboven weergegeven, blijven het zware werk en de daadwerkelijke data-I/O volledig binnen de grenzen van uw cloudomgeving. Het enige dat over de lijn teruggaat naar TrueFoundry is metadata – jobstatus, metrieken over brongebruik en configuratiespecificaties.
Hoe vertaalt dit zich naar een praktijksituatie waarin u een team in de EU heeft dat wettelijk gezien geen klantgegevens op Amerikaans grondgebied mag laten komen?
TrueFoundry gebruikt een concept genaamd "Workspaces". Een Workspace is een logische groepering van bronnen die gekoppeld is aan een specifiek onderliggend compute-cluster en artifact storage-integratie.
Om residency af te dwingen, richten we afzonderlijke clusters in in onze vereiste geografische regio's.
We herhalen dit proces voor us-east-1 met een "US-Prod" workspace.
Wanneer een EU data scientist een model wil implementeren, krijgt deze alleen toegang tot de "EU-Prod" workspace. Wanneer zij een training job starten of een service implementeren, zorgt het control plane van TrueFoundry ervoor dat de compute plaatsvindt op het Frankfurt-cluster en dat de resulterende model weights worden opgeslagen in de Frankfurt S3-bucket. Het platform kan de data fysiek nergens anders neerzetten, omdat die workspace niet weet dat er andere infrastructuur bestaat.
Hieronder ziet u een vergelijking van hoe data wordt verwerkt in een typische beheerde ML SaaS versus deze architectuur.
Tabel 1: Dit is de vergelijking van dataverwerkingsmodellen
In een volwassen organisatie eindigt u met een hub-and-spoke-model. U heeft één gecentraliseerd TrueFoundry control plane dat uw platform engineering team één centraal overzicht geeft voor eenvoudig beheer, maar de daadwerkelijke uitvoering is geografisch gesplitst.
Deze isolatie is cruciaal. Het betekent dat zelfs als een ontwikkelaar per ongeluk probeert een job verkeerd te configureren, de infrastructuurbeperkingen datalekkage tussen regio's voorkomen.
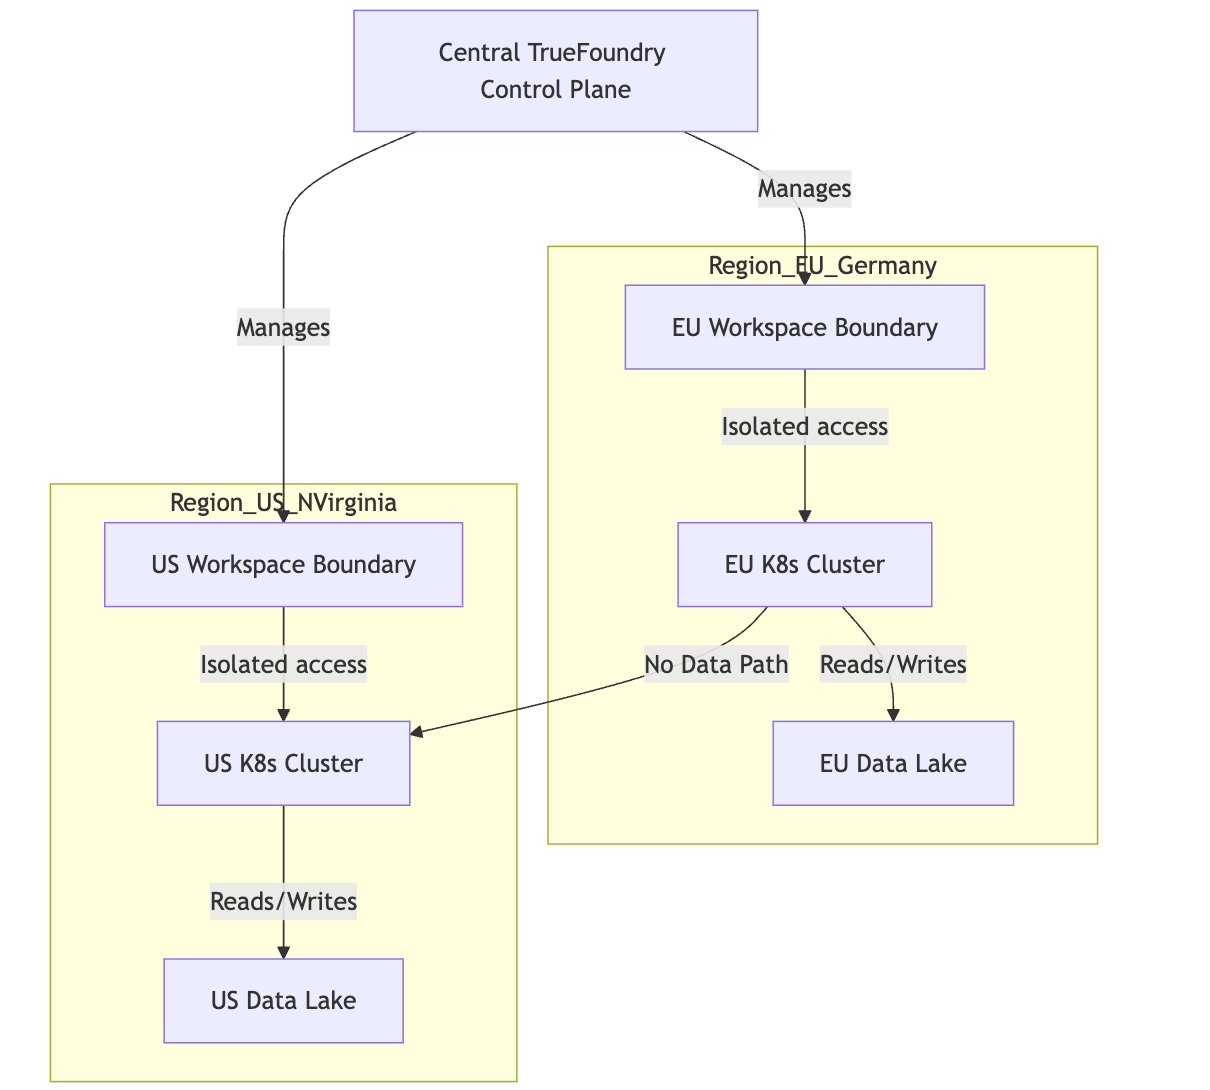
Afb. 2: Diagram van Multi-Regio Isolatie met behulp van Workspaces
Data residency is zelden opwindend werk, maar het is wel fundamenteel. Als u het verkeerd doet, doet de rest er niet meer toe.
Het mooie van de architectuur van TrueFoundry is dat het niet probeert zelf een "veilige databunker" te zijn. In plaats daarvan respecteert het de bunkers die u al heeft gebouwd in AWS, Azure of GCP. Het stelt ons in staat om onze data scientists een moderne, Heroku-achtige implementatie-ervaring te bieden zonder voortdurend met ons InfoSec-team te moeten strijden om uitzonderingen. We definiëren de perimeter één keer, koppelen TrueFoundry eraan vast en maken ons geen zorgen meer over onbedoelde data-egress.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox

















