



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het essay van Anthropic uit september 2025 over context engineering herdefinieerde de discipline: van het kiezen van de juiste woorden voor een enkele prompt naar het beslissen welke informatie in elke stap van het werk van een agent in het contextvenster moet staan. Deze post gaat over de infrastructuur die die beslissingen uitvoert op de gatewaylaag. Sessietracking, conversatiecompactie en prefix-caching zijn de bouwstenen op gatewayniveau waarmee context engineering daadwerkelijk in productie kan draaien — niet de strategie (die hoort bij de agent), maar het substraat dat de strategie afdwingbaar maakt over duizenden langlopende runs.
Vrijdagmiddag bij Northwind. Maya, staff engineer in het platformteam, meent het Slack-kanaal "#agent-help: code-review is failing on big PRs" te openen. Ze herleidt de fout naar PR #4127 — een refactor van 600 regels. De agent voerde 23 tool calls uit: las vier bestanden, voerde de testsuite twee keer uit, bevroeg de linter, haalde coverage op. Bij beurt 24 gaf het model een antwoord terug dat dezelfde alinea drie keer herhaalde en midden in een zin eindigde.
De sessieweergave van de gateway toont de 'smoking gun'. Tegen de tijd dat het misging, was de request payload gegroeid tot meer dan 185K tokens bij een model met een context van 200K — de twee testsuite-runs alleen al hadden elk tientallen duizenden tokens toegevoegd. De agent merkte nooit dat de ruimte opraakte; hij bleef toolresultaten toevoegen aan de conversatie-array totdat het aandachtsbudget van het model instortte.
De oplossing is meestal geen slimmer basismodel. Het is infrastructuur die voorkomt dat de agent zijn contextbudget uitput — door "we hebben per ongeluk het contextvenster gevuld" te veranderen in "de gateway heeft gecompacteerd rond de drempel van 150K, en de agent ging gewoon door." Deze post gaat over hoe die infrastructuur werkt.
In veel applicaties uit de 2023-periode betekende prompt engineering het kiezen van de juiste bewoordingen, voorbeelden en volgorde om een enkele reactie goed te krijgen. Context engineering, zoals Anthropic het formuleerde in hun essay van september 2025, is de opvolger — het vraagt welke configuratie van context waarschijnlijk het gewenste gedrag van het model oplevert gedurende de gehele run van een agent, niet alleen bij één call.
De verschuiving is van belang omdat langlopende agents status opbouwen. Elk toolresultaat, eerdere modelreactie en vervolgvraag van de gebruiker bevindt zich wel of niet in het contextvenster. Modelgedrag verslechtert — contextrot, in de woorden van Anthropic — ruim voordat de nominale contextlimiet is bereikt, waarbij de exacte degradatiecurve varieert per model, taak en waar de relevante informatie zich in het venster bevindt. De agent moet dus beslissingen nemen: wat te behouden, wat samen te vatten, wat te negeren, waarvoor de volle prijs te betalen en wat te cachen. Die beslissingen horen bij de agent. De mechanica die ze uitvoert, hoort bij de gateway — de laag die, in TrueFoundry's AI Gateway, al op elke call zit: een request taggen met een conversatie-ID, berekenen welk deel van de context de system prompt is versus de groeiende geschiedenis, het compactie-eindpunt aanroepen bij een drempelwaarde, en de prefix-cache aanspreken in plaats van te betalen voor dezelfde system prompt van 12K tokens bij elke call. De agent bepaalt de gewenste contextconfiguratie; de gateway implementeert die configuratie efficiënt. De rest van deze post behandelt de mechanica.
Een enkele agent-run bestaat uit vele provider calls. Een code-review-agent die één PR verwerkt, kan er 10–30 maken — één om te plannen, meerdere om bestanden te lezen, meerdere om tests uit te voeren, één om de review op te stellen, één om te reviseren na een toolfout. Zonder sessiemetadata ziet de trace-store 30 losse requests; mét metadata ziet de trace-store een conversatie van 30 beurten die end-to-end kan worden afgespeeld.
De conventie is een header die door de agent wordt ingesteld bij de buitenste call. In TrueFoundry's AI Gateway is dit de X-TFY-CONVERSATION-ID header — het X-TFY- prefix is het namespace van TrueFoundry, gekoppeld aan de X-TFY-METADATA header uit de post over kostentoewijzing. Beschouw de specifieke naam als een illustratieve gatewayconventie in plaats van een industriestandaard; de equivalente header zou elke naam kunnen hebben, het gaat erom dat de waarde zich voortplant door de span-boom:
HTTP — applicatie tagt elke beurt van een multi-turn agent met een conversatie-ID
Wat de gateway per sessie registreert: de geordende reeks provider calls in de conversatie met hun trace-ID's; cumulatieve input-, output-, cache-read- en cache-write-tokens, zowel per beurt als over de gehele conversatie; de metadata-velden van elke call (waarbij het schema voor kostentoewijzing uit de vorige post wordt doorgevoerd); en referenties naar trace-ID's in plaats van de volledige tekst — het gerenderde contextvenster blijft bij de provider, het sessierecord blijft klein.
Dit is essentieel voor debugging. Een agent van 20 beurten die faalt bij beurt 15 is niet te debuggen als 20 geïsoleerde requests. Het moet debugbaar zijn als een reeks — beurt 14 produceerde een toolresultaat dat het slechte gedrag van beurt 15 veroorzaakte; de input van beurt 13 zat al op 95% van de contextlimiet. De sessieweergave voegt 20 traces samen tot één bevraagbare tijdlijn met cumulatieve tokenaantallen, het latentieprofiel en cache-hitpercentages per beurt.
Het contextvenster van een coding-agent groeit volgens een voorspelbaar patroon. Neem voor het onderstaande vereenvoudigde model een system prompt van 12K tokens (tooldefinities, stijlalgoritmen, voorbeelden) bij beurt 0 aan, en dat elke opeenvolgende beurt ongeveer 6K gerenderde tokens toevoegt — een toolresultaat plus het antwoord van de assistent en overhead per beurt. Dat geeft een lineaire stijging van ongeveer 6K per beurt (echte runs zijn wisselvalliger; zie de opmerking onder de tabel):
Wat er gebeurt als het venster volraakt, is niet per se een directe fout — het is kwaliteitsverlies. De nauwkeurigheid van het model bij het ophalen van informatie en het volgen van instructies neigt al ver voor de nominale limiet af te nemen. Wat nog erger is: het model geeft geen enkel signaal dat de kwaliteit is achteruitgegaan — het produceert zelfverzekerde, goed geformatteerde output die simpelweg onjuist is. Tegen de tijd dat het venster vol is, is de kans groter dat het model hallucineert, zichzelf herhaalt, instructies mist of verkeerd geformatteerde tool calls retourneert. Deze degradatie is een glijdende schaal, geen abrupte klif, en waar het begint varieert per model, taak en waar de relevante tokens zich bevinden — maar de operationele implicatie is hetzelfde: de infrastructuur moet ingrijpen voordat het gedrag instort, niet erna. (De bovenstaande tabel is een illustratief lineair model; echte coding-agent runs zijn meestal wisselvalliger — een enkele grep door een grote codebase of een uitgebreide test-run kan in één beurt 20K tokens toevoegen.)
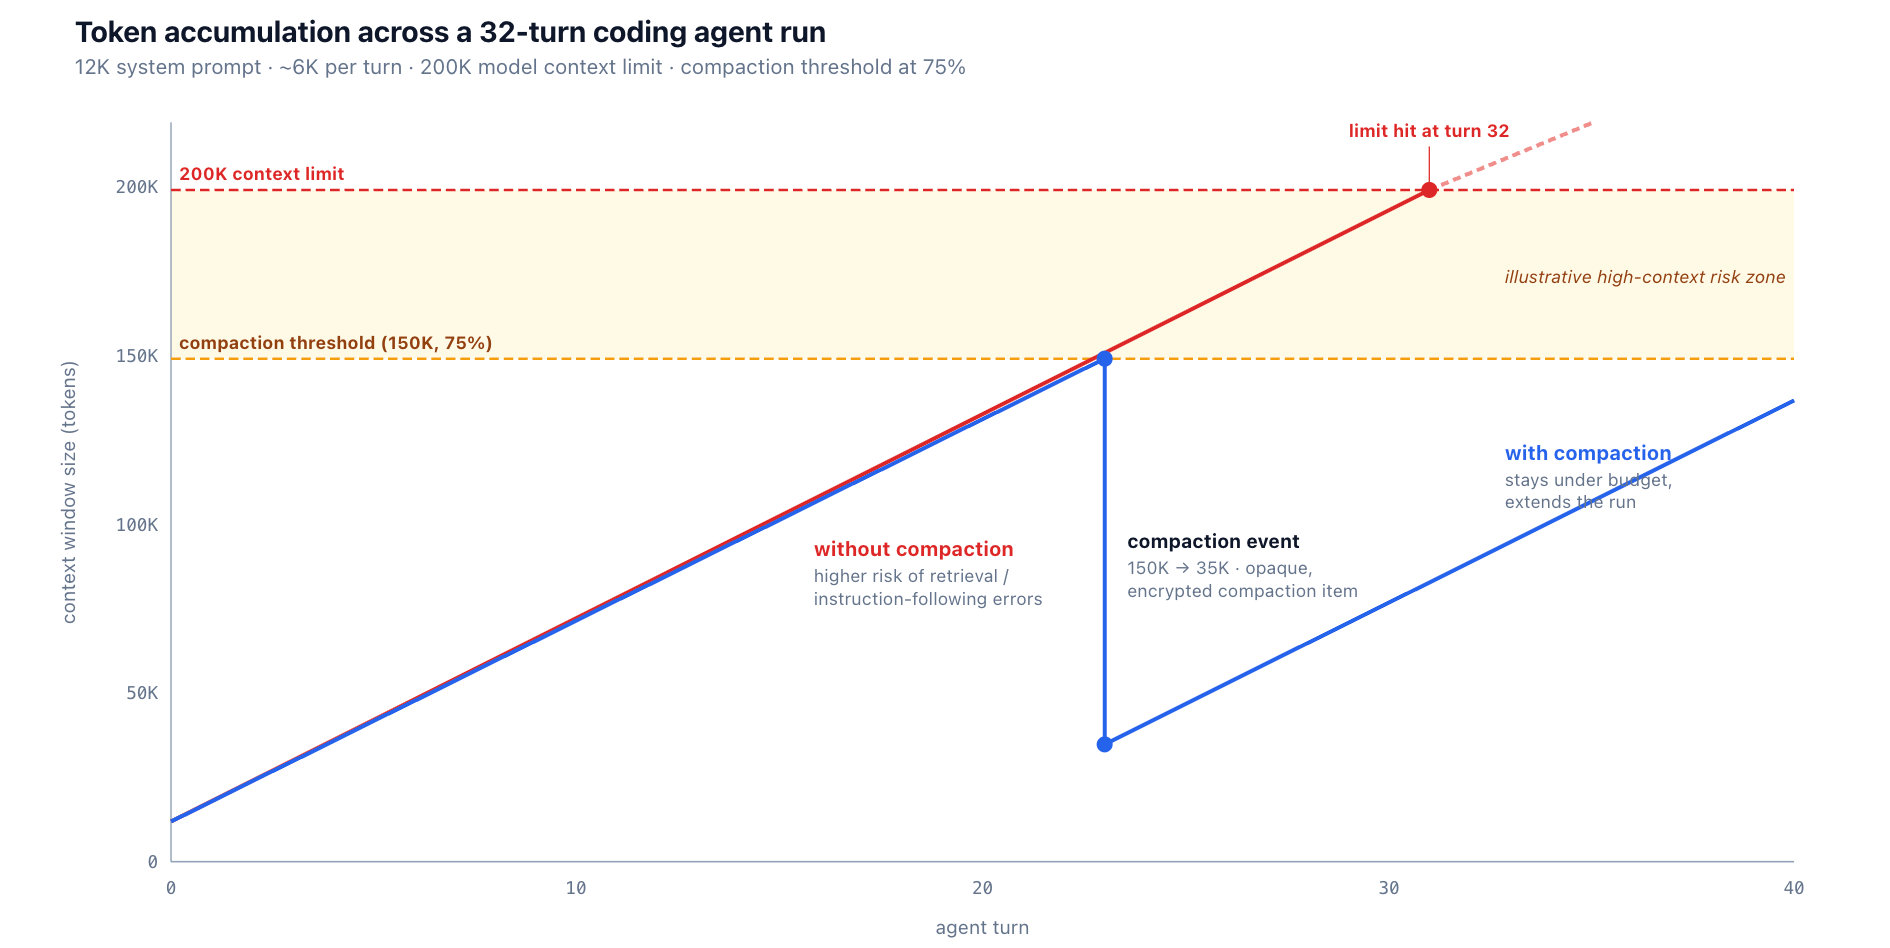
De agent kan ervoor kiezen om nooit zo groot te worden — oude toolresultaten opschonen, samenvattingen naar schijf schrijven, sub-agents uitvoeren voor elke tool call met een schone context. Dat zijn reële strategieën en die horen bij de agent. De rol van de gateway is om het alternatief — compactie — eenvoudig genoeg te maken om consistent toe te passen: routen, observeren, de token- en latentie-effecten toewijzen, en beleid afdwingen rond het moment van activeren. In TrueFoundry's AI Gateway komen de tokenaantallen per beurt die deze tabel werkelijkheid maken voort uit dezelfde sessie-rollup die de fout in de inleiding aan het licht bracht — de accumulatie is iets wat je kunt zien stijgen, niet iets wat je pas ontdekt nadat het model vastloopt.
De OpenAI Responses API ondersteunt compactie als een 'first-class' bouwsteen, in twee modi.
Standalone (expliciet). De applicatie detecteert de contextgroei, roept POST /v1/responses/compact aan met de volledige conversatie als input, en ontvangt een nieuw gecompacteerd contextvenster. De volgende /responses call gebruikt dat geretourneerde venster in plaats van de eerdere conversatiegeschiedenis — ongewijzigd doorgegeven, omdat het de status bevat die het model nodig heeft om door te gaan (en mogelijk enkele eerdere items naast het compactie-item behoudt).
Python — expliciete compactie wanneer de applicatie daartoe beslist
Server-side (automatisch). De applicatie voegt context_management toe met een compact_threshold in de oorspronkelijke /responses request. Wanneer het aantal gerenderde tokens mid-stream de drempelwaarde overschrijdt, compacteert de server in-band, stuurt een geëncrypteerd compactie-item in de response-stream en vervolgt de inference zonder een afzonderlijke round-trip.
Python — automatische server-side compactie via context_management
Het compactie-item zelf is ondoorzichtig (opaque) voor de client. Je kunt het niet teruglezen, bewerken of de inhoud ervan inspecteren. Het draagt de status en de redeneerstappen over die het model nodig heeft om door te gaan en is aanzienlijk kleiner dan de oorspronkelijke conversatie. Het is ZDR-compatibel wanneer store=false is ingesteld op de oorspronkelijke request.
Twee patronen voor ketenberekening (chaining) zodra compactie heeft plaatsgevonden. Staatloze input-array chaining: voeg output-items (inclusief het compactie-item) toe aan de volgende input-array, waarbij items vóór het meest recente compactie-item worden weggelaten om requests klein te houden. previous_response_id chaining: geef alleen het nieuwe bericht van de gebruiker door in de volgende request en laat de server de eerdere status afhandelen. Het eerste geeft de applicatie expliciete controle over de payload; het tweede draagt dit over aan de server. Voor ZDR-gevoelige workloads is staatloos met store=false het standaardpatroon. Hoe dan ook blijft compactie een provider-functie; TrueFoundry's gateway routeert de call en registreert deze op de sessietijdlijn, zodat de tokendaling een observeerbare stap is die je kunt toeschrijven aan de compactie-call in plaats van een onverklaarbare dip in de conversatie-array.
Voor de meeste productie-agents zijn de dominantste kosten niet de groeiende conversatie — het is de system prompt die ongewijzigd bij elke call wordt meegestuurd. Een system prompt van 12K tokens bij een Claude Sonnet 4.6-tarief ($3 per miljoen input-tokens) kost $0,036 per call zonder caching. Bij 1.000 calls per uur is dat $36/uur, puur voor de niet-veranderende instructies. Over een heel jaar kost dit onderdeel voor één enkele productie-agent al snel ongeveer $315.000.
Prefix-caching aan de providerzijde is de oplossing. Anthropic biedt dit via cache_control breekpunten in de prompt; OpenAI past het automatisch toe bij prefix-matches van 1.024 tokens of langer. Omdat de match plaatsvindt op het exacte prefix, is de praktische regel bij beide providers hetzelfde: plaats de stabiele inhoud (system prompt, tooldefinities) vooraan en de variabele inhoud (de beurt van de gebruiker) achteraan, zodat de cachebare kop byte-identiek blijft over calls heen. De economische voordelen bij Anthropic zijn expliciet: cache-reads worden gefactureerd tegen 10% van het normale input-tarief ($0,30 per miljoen voor Sonnet 4.6); de eerste call die de cache aanmaakt betaalt een toeslag van 25% voor de 5-minuten TTL, of 100% voor de 1-uur TTL.
JSON — Anthropic cache_control breekpunt op de system prompt
De financiën bij een system prompt van 12K × 1.000 calls/uur met een warm-hit-percentage van 85% (cache miss op het koude pad, cache read op het warme pad):
ComponentBerekeningKosten per uur Ongecached uitgangspunt 1.000 × 12.000 × $3/M $36,00 Warme cache-reads (85%) 850 × 12.000 × $0,30/M $3,06 Koude cache-writes (15%) 150 × 12.000 × $3,75/M $6,75 Gecached totaal $9,81 Effectieve korting ~73%
Een daling van $36/uur naar $9,81/uur is het soort verschil dat prompt-prefix caching de eerste optimalisatie maakt waar de meeste teams naar grijpen bij langlopende agent-workloads. De werking volgt het economische kernprincipe van prompt-caching: stabiele context moet worden hergebruikt in plaats van bij elke request opnieuw te worden verwerkt — de gateway maakt dit operationeel eenvoudig afdwingbaar. De cache-read- en cache-write-tokens komen terecht in hetzelfde verbruik per call dat TrueFoundry's gateway al toewijst voor kosten. De bovenstaande korting is dus iets wat je kunt bevestigen op basis van je eigen verkeer in het kostentoewijzingsoverzicht uit de vorige post, en niet slechts een schatting vooraf.
Compactie voegt latentie toe; cache-reads niet. Deze asymmetrie vormt de productieheuristieken.
Een standalone call naar /v1/responses/compact is een synchrone round-trip — het moet de gehele input lezen, een compactie-operatie aan de providerzijde uitvoeren met de bijbehorende latentie en kosten, en het gecompacteerde venster retourneren. Voor een input van 150K tokens kan dat merkbare latentie toevoegen; meet dit op je eigen traces voordat je drempelwaarden kiest. De agent staat gedurende die tijd stil.
Server-side compactie is beter, maar niet gratis. De compactiestap vindt plaats in-stream tijdens de volgende /responses call, dus de TTFT voor die call bevat zowel de compactie-overhead als de normale inference-tijd. Als compactie bij elke overschrijding van de drempelwaarde bij een drukke agent wordt geactiveerd, wordt de voor de gebruiker zichtbare TTFT bimodaal: de meeste beurten zijn snel, enkele zijn merkbaar traag. Omdat TrueFoundry's gateway de latentie van elke call op de sessietrace registreert, is dat bimodale patroon direct zichtbaar in de request-traces weergave — de trage beurten zijn de beurten die de compactie-overhead dragen, wat je in staat stelt de drempelwaarde op basis van echte cijfers aan te passen in plaats van te gokken.
Twee heuristieken die van belang zijn in productie:
Compact proactief, niet reactief. Als compactie pas activeert bij de daadwerkelijke contextlimiet, heeft de agent zijn laatste paar beurten al doorgebracht in de zone met verhoogd risico waarin de kwaliteit neigt af te nemen. Stel de drempelwaarde ruim onder de limiet in — typisch op 75% — zodat de agent daar minder tijd doorbrengt. Voor een model met een context van 200K is dat een drempel van 150K.
Compact geen korte conversaties. Voor een taak van 5 beurten die een piek bereikt bij 30K tokens, wegen de kosten van de compactie-overhead zwaarder dan de baten — de kosten van de round-trip zijn reëel, zelfs als de inference klein is. Een redelijke ondergrens: compact nooit onder ~75K tokens of vóór beurt 10, afhankelijk van wat het eerst komt. Daaronder is zelfs de slechtst denkbare doorgifte van de volledige context goedkoper dan een compactie round-trip.
Een praktische standaard voor een productie-agentplatform: compact_threshold op 75% van de contextlimiet van het model, met een minimale omvangsbeveiliging op ~75K tokens, toegepast via server-side compactie met staatloze chaining.
Compactie is bovendien slechts één hulpmiddel uit een reeks, en niet altijd het juiste. De keuze hangt af van de vorm van de taak:
Deze methoden vullen elkaar aan in plaats van te concurreren — een productie-agent cached vaak zijn system prompt, haalt informatie op uit een corpus, schrijft notities naar schijf en compacteert de resterende conversatie. De rol van de gateway is bij al deze methoden hetzelfde: elk van hen observeerbaar en toewijsbaar maken, niet het kiezen van een methode voor de agent.
Het verband tussen de context engineering-principes en de concrete gateway-bouwstenen is rechtstreeks:
De gateway neemt geen context engineering-beslissingen. Het maakt ze implementeerbaar, debugbaar en uniform over de providers waarmee de agent communiceert — en dat is precies waar een AI-gateway zoals die van TrueFoundry voor dient: één centrale plek waar sessiegroepering, inzicht in het tokenbudget en kostentoewijzing identiek worden toegepast, of de agent nu met OpenAI of met Anthropic communiceert.
Moeten we de Responses API gebruiken om compactie te krijgen?
Voor de API-native server-side versie wel. Chat Completions heeft geen ingebouwde compactie-bouwsteen — applicaties moeten dit zelf bouwen (gewoonlijk: de eerdere conversatie samenvatten met een afzonderlijke model-call en de samenvatting doorgeven). De Responses API biedt compactie als een expliciete operatie met de ondoorzichtige compactie-item-semantiek die het ZDR-veilig maakt.
Hoe verhoudt compactie zich tot prompt-caching?
Als het statische system/developer/tool-prefix byte-identiek blijft en vóór de gecompacteerde geschiedenis staat, zou compactie de cache-hits op dat prefix niet moeten verstoren — cache-hits vereisen een exacte prefix-match, dus de ongewijzigde kop van de prompt komt nog steeds overeen. Wat verandert is de cachebaarheid van het conversatiegeschiedenis-gedeelte: vervolgrequests moeten een nieuw cache-item opbouwen tegen het prefix van na de compactie. Dit is een praktische reden om niet al te vaak te compactueren — elk compactie-event invalideert de cache van het conversatiegedeelte, hoewel het grotere gedeelte van de system prompt ongemoeid blijft.
Kan de gateway compactueren over meerdere providers heen?
Nee. Compactie vindt plaats aan de providerzijde en het compactie-item is ondoorzichtig en providerspecifiek — je kunt niet compactueren met OpenAI en hervatten met Anthropic. De gateway kan compactie-calls routen en de geretourneerde items weergeven in de sessieweergave, maar de voortzetting moet bij dezelfde provider blijven.
Wat als de agent sub-agents gebruikt in plaats van compactie?
Sub-agents zijn een valide alternatief — een schone context per subtaak betekent dat elke subtaak nooit groter wordt dan zijn eigen subprobleem, en de orchestrator synchroniseert de outputs aan het einde. Sub-agents werken wanneer subproblemen duidelijk op te splitsen zijn; compactie werkt wanneer de agent continuïteit nodig heeft over vele turns van één verbonden taak. De twee sluiten elkaar niet uit.
Hoe verhouden sessie-token-aantallen zich tot de OTel-spans die we al vastleggen?
Één trace per provider call, één sessie per conversatie. De sessie is een verzameling over de traces van de conversatie; het geeft cumulatieve token-aantallen, het latency-profiel en cache hit rates weer over alle turns.
Waar past TrueFoundry in dit plaatje?
Het patroon in deze post is gateway-agnostisch: een gateway is de natuurlijke plek om sessiegroepering, zichtbaarheid van het token-budget per turn, toewijzing van cache-hits en de routing van provider-compactie-calls beschikbaar te maken, omdat het zich al op elk verzoek bevindt. De TrueFoundry AI Gateway biedt de sessie- en observability-laag waarop deze voortbouwen — gecentraliseerde tracing, metadata-tagging en de kostenattributie en budgethandhaving per trace zoals behandeld in eerdere posts, samengevoegd op conversatieniveau. Compactie en caching zelf zijn functionaliteiten van de provider; de bijdrage van de gateway is om ze te routen, hun token- en kosteneffecten toe te wijzen en een lange agent-run opvraagbaar te maken als één tijdlijn. (De specifieke header-naam X-TFY-CONVERSATION-ID wordt hier gebruikt als illustratieve conventie; zie de exacte primitives als functionaliteiten die een gateway kan bieden in plaats van een vast contract.) Het agent-platform bepaalt de contextstrategie; de gateway biedt de zichtbaarheid en de controls.
Als u vandaag de dag een langdurige agent in productie draait, is het inschakelen van prefix caching op de system prompt de maatregel met de hoogste impact. Voor OpenAI is dat automatisch en zijn er geen codewijzigingen nodig; voor Anthropic voegt u cache_control breakpoints toe rond de stabiele prefix en valideert u de schrijf/lees-economie op uw workload, aangezien cache-writes hun eigen prijsklasse hebben. In beide gevallen betaalt het de platforminvestering meestal binnen enkele weken terug. Compactie is de tweede stap, zodra de agent regelmatig 60–70% van de contextlimiet van het model overschrijdt. Sessietracking is de stap die beide bovenstaande zaken debugbaar maakt.
Northwind, Maya en PR #4127 zijn ter illustratie. De voorbeelden van compactie en prompt-caching weerspiegelen het gedocumenteerde gedrag van de OpenAI Responses API en Anthropic API vanaf mei 2026. Token-accumulatie, drempelwaarden, latency en cache-hit rates zijn representatieve workload-aannames, geen metingen — meet deze aan de hand van uw eigen agent-traces voordat u een productiebeleid instelt. Prijzen van providers en contextlimieten die worden geciteerd, zijn volgens de openbare tariefkaarten en modelpagina's van de providers op die datum.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















