



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Twee getallen bepalen de meeste gesprekken over Claude Sonnet 4.5 vs GPT-5. Anthropic prijst Claude Sonnet 4.5 op $3 per miljoen input-tokens en $15 per miljoen output-tokens. OpenAI prijst GPT-5 op $1,25 en $10. GPT-5 wint het gepubliceerde tarievenoverzicht ruimschoots.
Tarievenoverzichten zeggen echter weinig in productie. Een coding-agent die een mislukte taak twee keer opnieuw uitvoert, heeft de tokenbesparingen al verdampt. Een samenvattingspipeline met een stabiele prefix van 40.000 tokens gedraagt zich anders dan een agent die bij elke beurt de context herschrijft.
Beide leveranciers zijn inmiddels ook verder gegaan dan deze releases. OpenAI omschrijft GPT-5 als zijn vorige redeneermodel en verwijst ontwikkelaars naar GPT-5.6. Anthropic positioneert nu nieuwere Claude-modellen boven Claude Sonnet 4.5 voor veel ontwikkelbehoeften. Teams die een van beide modelnamen hardcoden, bouwen al vroeg migratieschuld op.
Beide modellen richten zich op geavanceerde generatieve AI-werkbelastingen, hoewel hun ontwerpfocus op verschillende punten ligt. Het lezen van de kaders van elke leverancier vertelt kopers meer dan een enkele leaderboard. De praktische beslissing tussen Claude Sonnet 4.5 vs GPT-5 begint bij de primaire use case.
Anthropic positioneerde Claude Sonnet 4.5 rond veeleisend coderingswerk, langlopende agents en computergebruik. De lanceringsnotitie omschrijft het als een belangrijke release voor real-world agents, waarbij de prijzen gelijk zijn gebleven aan de $3 en $15 van Claude Sonnet 4. De API-model-ID is `claude-sonnet-4-5-20250929`, een vastgezette snapshot in plaats van een bewegende pointer.
GPT-5 is het redeneermodel van OpenAI voor coding- en agentic taken in diverse domeinen, beschikbaar via zowel Chat Completions als de Responses API. De snapshot is `gpt-5-2025-08-07`. Het model accepteert tekst- en beeldinvoer en geeft tekst terug, met ondersteuning voor redeneertokens en een `reasoning.effort`-parameter die `minimal`, `low`, `medium` en `high` accepteert.
Één praktisch verschil valt direct op. GPT-5 ondersteunt geen fine-tuning of predicted outputs, volgens de modeldocumentatie van OpenAI. Claude Sonnet 4.5 biedt agentic controls, waaronder interleaved thinking via een beta-header voor tool-connected reasoning.
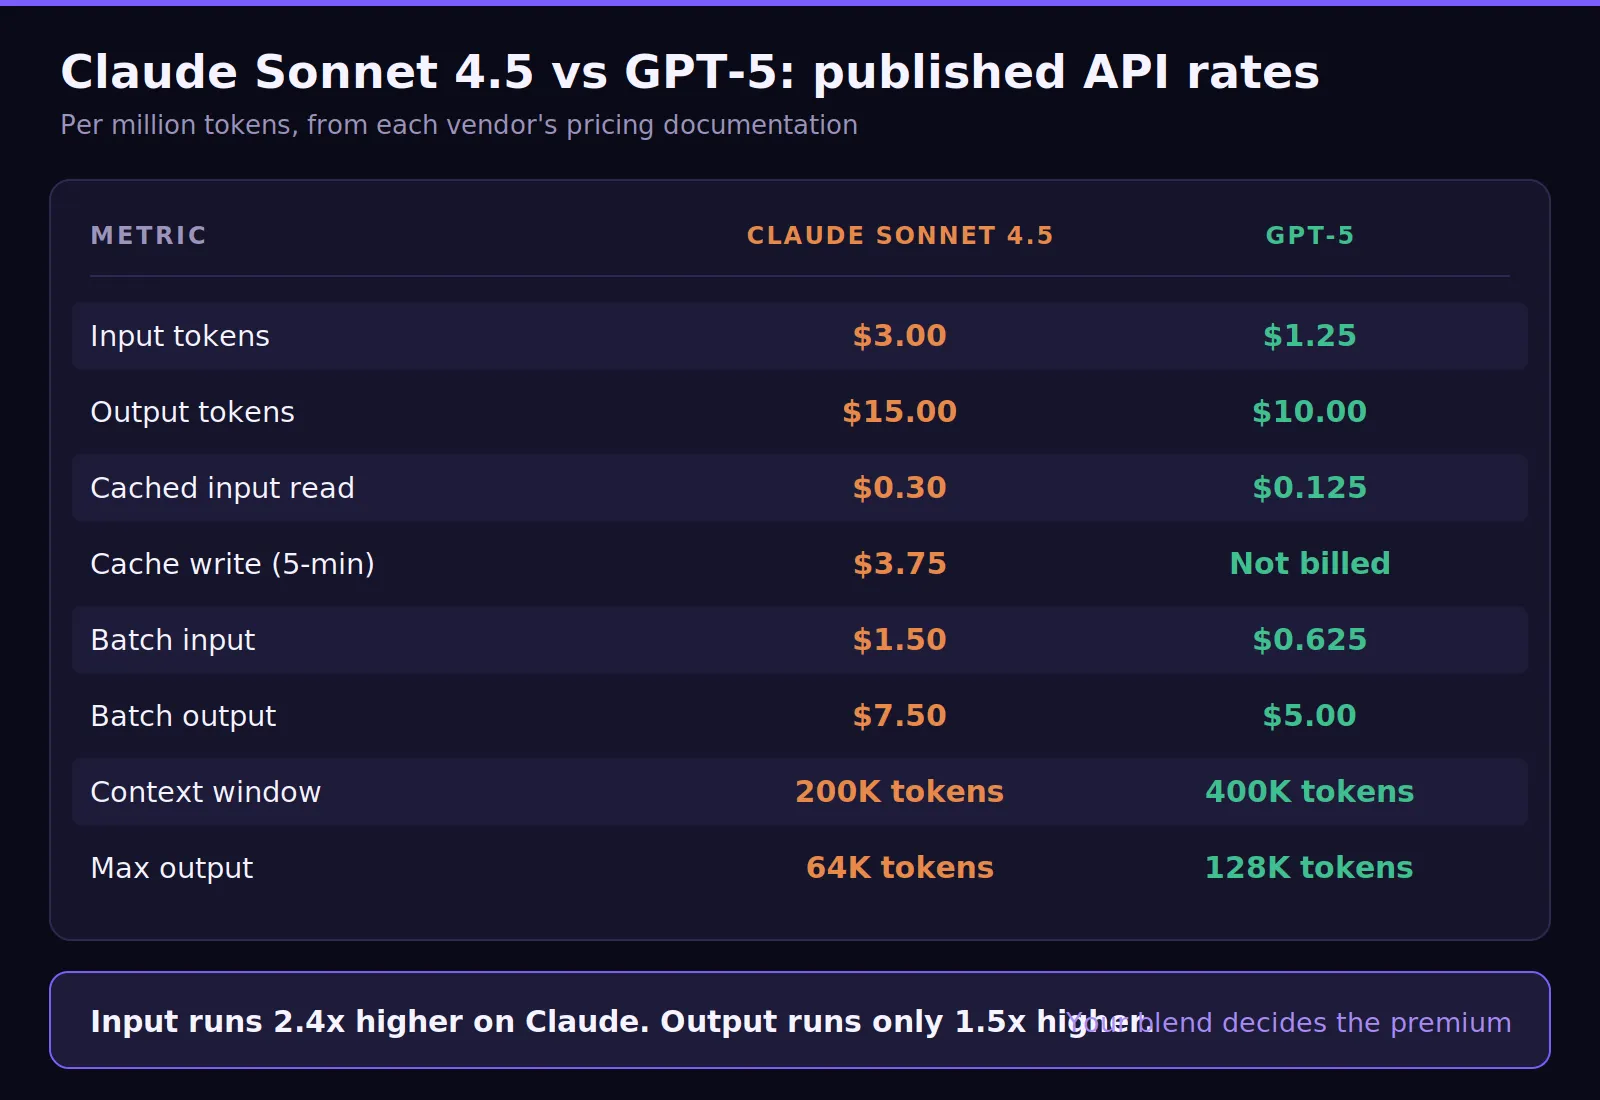
Prijzen zijn het punt waarop de twee modellen het duidelijkst uiteenlopen. Elk onderstaand tarief is afkomstig uit de door de leverancier gepubliceerde prijsdocumentatie. Kopers moeten de kosten echter nog steeds modelleren op basis van de specifieke werkbelasting, omdat inputkosten, outputlengte, cachegedrag en retries de uiteindelijke factuur beïnvloeden.
Twee verhoudingen zijn belangrijker dan de absolute cijfers. Input is 2,4x hoger bij Claude Sonnet 4.5. Output is 1,5x hoger. Omdat die verschillen afwijken, hangt de samengestelde opslag af van het aantal tokens dat uw werkbelasting verbruikt en genereert.
Neem 1.000 verzoeken van elk 30.000 input-tokens en 2.000 output-tokens, zonder caching. Claude Sonnet 4.5 kost $90,00 voor input en $30,00 voor output. GPT-5 kost $37,50 voor input en $20,00 voor output.
Dit leidt tot een vergelijking van $120,00 versus $57,50. Claude is in dat voorbeeld 2,09x zo duur. Het kostenvoordeel voor GPT-5 is duidelijk op het gebied van bruto token-economie, vooral voor high-volume support-, classificatie- en contentbeheer-workflows.
Serveert u nu 90% van die invoer uit de cache, dan daalt Claude Sonnet 4.5 naar $8,10 voor gecachete reads, $9,00 voor verse invoer en $30,00 voor output. GPT-5 komt uit op $27,13. De toeslag neemt af omdat caching de inputzijde verlaagt.
Cache-verantwoording is de valkuil die genoemd moet worden. Anthropic rekent voor cache-writes van vijf minuten 1,25x de basis-input. Het gepubliceerde tarievenoverzicht van OpenAI voor GPT-5 vermeldt geen afzonderlijke kosten voor cache-writes. Prijzen van responstokens en cache-churn kunnen de beste keuze dus veranderen..
Kosten beantwoorden één vraag. Of een AI-model de taak lang genoeg in het geheugen kan houden om deze te voltooien, beantwoordt een moeilijkere vraag. Bij Claude Sonnet 4.5 vs GPT-5 verdienen het contextvenster, de outputlimieten en de redeneer-instellingen een grondige analyse.
Het verschil in context wordt snel onderschat. GPT-5 accepteert twee keer zoveel invoer en levert twee keer de maximale output. Dat is van belang voor grote refactorings, pagina's tekst, complexe workflows en lange agent-sporen die als één grote taak binnenkomen.
Sonnet 4.5 antwoordt met een functie die GPT-5 mist. Het context-awareness-gedrag van Anthropic injecteert het resterende budget van het model rechtstreeks in het verzoek, als `<budget:token_budget>200000</budget:token_budget>` in de system prompt en een lopende `<system_warning>` na elke tool-call. De plannen van het model zijn gebaseerd op de werkelijk resterende capaciteit in plaats van een schatting.
Claude Sonnet 4.5 ondersteunt ook interleaved thinking met tools via een beta-header. Dit helpt bij complexe redeneertaken, diepere analyses, wetenschappelijke redeneringen, financiële analyses, wiskundige vraagstukken en agentic bedrijfsprocessen waarbij tool-resultaten de volgende stap beïnvloeden.
GPT-5 ondersteunt redeneerniveaus via de standaardmodus en hogere redeneer-instellingen. Dat geeft teams een extra manier om latency, analytische kwaliteit en kostenefficiëntie af te stemmen. Het juiste model blijft afhankelijk van de gemeten kwaliteit binnen de beoogde werkbelasting.
Benchmarks kunnen helpen bij de eerste selectie, hoewel ze interne testen niet vervangen. Artificial Analysis publiceert een Intelligence Index en modelvergelijkingen, terwijl andere bronnen ART-prestaties, analyse-intelligentie en gespecialiseerde redeneerscores behandelen. Beschouw deze als eerste signalen, niet als bewijs voor inkoop.
De positionering van Anthropic richt zich op software engineering, toolgebruik en langlopend agentic werk. Dat maakt Claude Sonnet 4.5 relevant voor agentic coding, codegeneratie, code-review en autonome uitvoering. Het model is vooral interessant wanneer kwaliteit het aantal review-cycli vermindert.
Behandel modelkwaliteit sowieso als werkbelasting-specifiek. Coding-benchmarks meten publieke taken, terwijl uw engineers binnen private repositories werken. Repository-conventies, dependency-graphs, de review-cultuur en teststructuren bepalen of Claude Sonnet superieure prestaties levert.
Voer beide modellen uit op dezelfde 20 interne tickets en beoordeel ze met een vaste rubriek. Tel mislukte pogingen, vervolg-prompts, tool-fouten en geaccepteerde pull requests. Een model dat meer kost per call kan nog steeds winnen door minder revisies nodig te hebben.
De meest relevante vergelijking is zelden een universeel leaderboard-resultaat. Een team kan voor de ene repo een duidelijke voorsprong voor Claude vinden en voor de andere voor GPT-5. Daarom moet het antwoord op Claude Sonnet 4.5 vs GPT-5 komen uit tests met echte werkbelastingen.
De gepubliceerde tokenprijzen van GPT-5 liggen lager dan die van Claude Sonnet 4.5 voor input, output, gecachete reads en batch-gebruik. Dat verandert de rekensom voor productie-werkbelastingen met een hoog volume. Support-automatisering, classificatie, kwaliteitscontroles voor natuurlijke taal en interne tooling neigen vaak naar GPT-5.
Het grotere contextvenster van 400.000 tokens helpt een andere categorie werkbelastingen. Documentverwerkingspipelines passen wellicht in één call in plaats van het opknippen en samenvoegen van reacties. Minder chunks kan betekenen: minder joins, minder storingen en minder operationele rompslomp.
Kosten alleen mogen de beslissing niet doorslaggevend bepalen. Outputkwaliteit, retry-gedrag, de cache-hitrate en menselijke reviews beïnvloeden de totale uitgaven. De kennis-cutoff van GPT-5 loopt bovendien achter op die van Claude Sonnet 4.5, wat van belang kan zijn voor nieuwere frameworks, API's en enterprise-workflows.
GPT-5 kan ook geschikt zijn voor een algemeen publiek en brede AI-platformgebruiksscenario's. Het kan vergelijkbare content ondersteunen bij support, samenvattingen, analytics en CMS-workflows. Voor grounding via Google Search kan Gemini 3 Pro, Cosmic AI of een ander gespecialiseerd model een afzonderlijke vergelijking worden.
De meeste teams benaderen de beslissing als één vaste keuze. Dat is meestal het verkeerde kader. De betere aanpak splitst per werkbelasting en vraagt zich vervolgens af of één model alles moet afhandelen. Dit maakt GPT-5 vs Claude Sonnet 4.5 operationeel nuttiger.
Kies voor Claude Sonnet 4.5 wanneer:
Kies voor GPT-5 wanneer:
Kies voor een beheerde meermodel-laag wanneer:
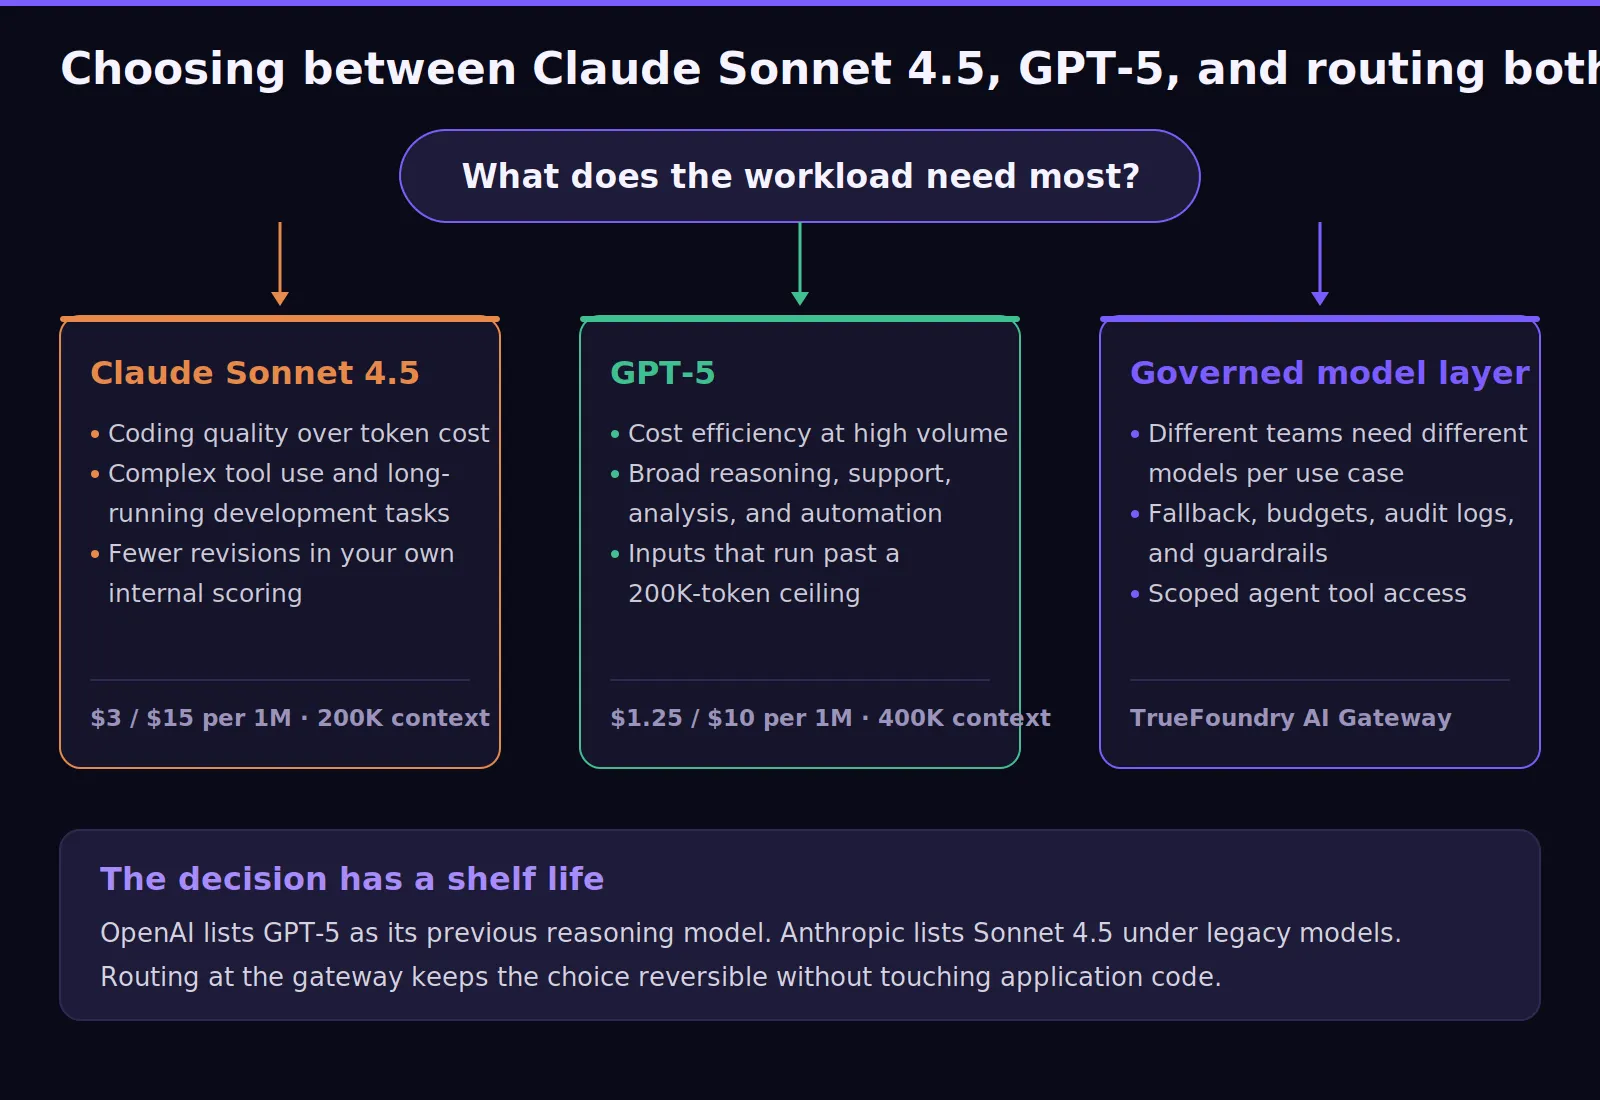
De bovenstaande vergelijking heeft een beperkte houdbaarheid. GPT-5 draagt nu al het stempel van een vorig model. Anthropic heeft nieuwere modellen uitgebracht voorbij Claude Sonnet 4.5. Het AI-landschap beweegt snel, en TrueFoundry houdt modelwijzigingen buiten de applicatiecode.
Teams kunnen Claude Sonnet 4.5 en GPT-5 afwegen op kwaliteit, kosten, latency en redeneerdiepte. De governancelaag blijft onafhankelijk van beide providers. Verschillende groepen kunnen vervolgens verschillende modellen inzetten voor coding, support-automatisering, analytics en interne copilots.
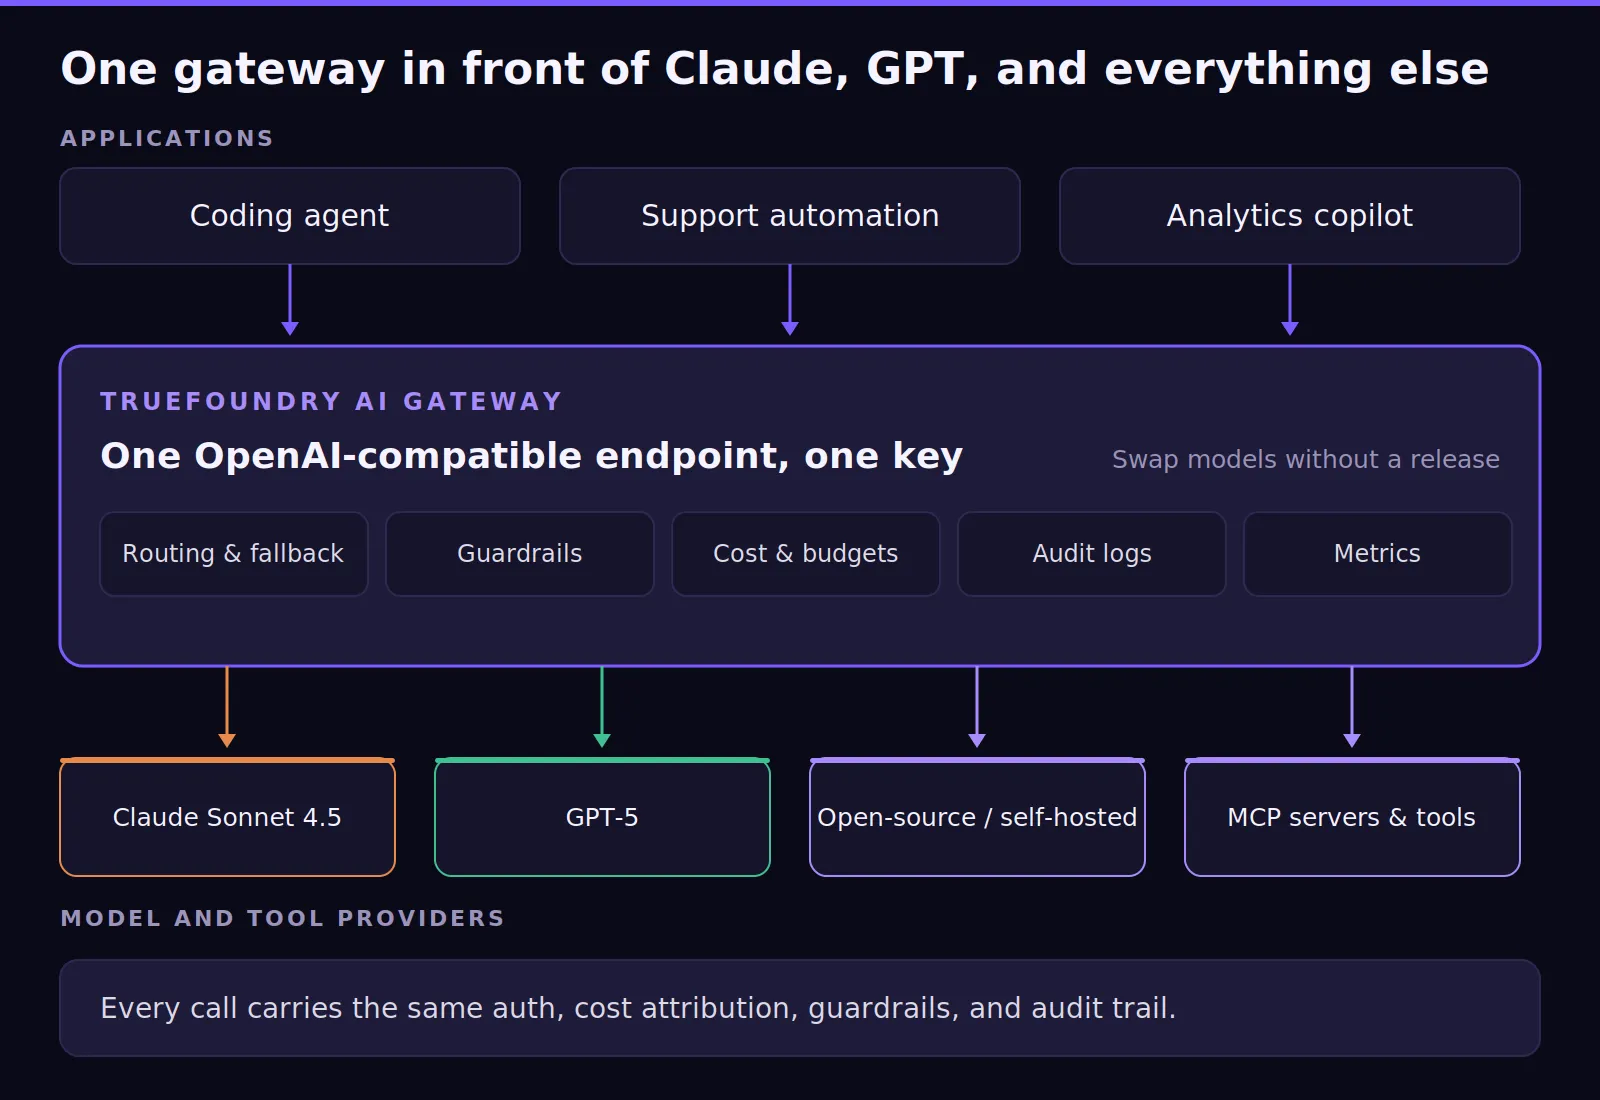
De AI Gateway bevindt zich tussen applicaties en modelproviders. Het biedt één OpenAI-compatibel eindpunt en past tegelijkertijd authenticatie, logging, guardrails en kostenbeheersing toe. Dezelfde laag kan Claude, GPT, open-source en self-hosted modellen beheren.
LLM Gateway voor multi-model routing. De LLM Gateway routeert verzoeken over providers via één enkele interface, zodat GPT-5 samenvattingen met een hoog volume kan afhandelen terwijl Sonnet 4.5 de coding- en agentic paden verzorgt. Een virtueel model geeft beide één stabiele naam en maakt het wisselen van doelen een configuratiewijziging in plaats van een release.
Regels worden op volgorde geëvalueerd en de eerste match wint. `retry_config` per doel vult tijdelijke storingen op voor hetzelfde model, terwijl `fallback_status_codes` het verzoek doorstuurt wanneer retries waarschijnlijk niet helpen. TrueFoundry detecteert ook een ongezond doel op basis van verzoeken, tokens en storingen per minuut, en zet dit tijdelijk aan de kant voor een cooldown.
MCP Gateway voor veilige tool-toegang. De MCP Gateway beheert hoe applicaties en agents toegang krijgen tot tools, API's, databases en bedrijfssystemen. Gesegmenteerde toegang is essentieel zodra een door Claude of GPT aangedreven agent gegevens kan ophalen, services kan aanroepen of workflows kan starten.
Agent Gateway voor governance op werkbelastingsniveau. De Agent Gateway voegt governance op werkbelastingsniveau toe aan autonome taken. Het helpt bij het beheren van meerstapsgedrag, uitvoeringslimieten, berichtenverkeer tussen agents en sessiebewuste tracing. Onbeheersbare lussen en onveilige acties worden telemetrie in plaats van verrassingen aan het einde van de maand.
Guardrails, kostenbeheersing en audit trails. Deze transformeren GPT-5 en Claude Sonnet 4.5 tot een beheerde productiebeslissing. Het Metrics Dashboard kan rapportages tonen over latency, time to first token, inferentiekosten, input-tokens, output-tokens, cache-statistieken en blokkades door budgetlimieten.
Deze functionaliteit maakt van de vergelijking een operationeel antwoord in plaats van een eenmalige mening. Het sturen van 10% van het verkeer naar een ander model en het meten van de kosten per opgeloste taak levert meer op dan het herlezen van een tarievenoverzicht. Het helpt teams ook om een weloverwogen beslissing te nemen.
Houd de modelkeuze flexibel terwijl de productie-governance consistent blijft. Boek een demo om te zien hoe TrueFoundry Claude, GPT, open-source en aangepaste modellen routeert via één beheerde AI Gateway.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Neither wins outright in Claude Sonnet 4.5 vs GPT-5. Claude Sonnet 4.5 remains useful for coding, tool use, and long-running agentic work. GPT-5 offers lower token pricing and a larger 400,000-token context window. Enterprises should test both models in internal use cases before making a choice.
Yes, GPT-5 is cheaper on every published base rate. GPT-5 lists $1.25 per million input tokens and $10 per million output tokens. Claude Sonnet 4.5 lists $3 per million input tokens and $15 per million output tokens. Actual cost still depends on retries, caching, and output length.
Yes, Claude Sonnet 4.5 is positioned around coding, Claude Code, tool use, and agentic coding workflows. It can be strong for code generation, code review, and complex repository tasks. Teams should validate it against private repositories because accepted pull requests and revision counts determine real cost.
Latency depends on workload shape, context size, model settings, and output length. Claude Sonnet 4.5 can be practical for production when quality reduces the need for retries. Enterprises should measure time to first token, time per output token, cache behavior, and cost per completed task before scaling production usage.
Ja, Claude Sonnet 4.5 ondersteunt redeneerworkflows via extended en interleaved thinking. Dit helpt bij complexe redeneertaken, wiskundig redeneren, wetenschappelijk redeneren, financiële analyse, en agentic werk dat met tools is verbonden. Het model houdt ook de resterende contextcapaciteit bij, wat agents helpt te plannen over langere taken.
Enterprises should use both when workloads differ by cost sensitivity, task complexity, and quality requirements. GPT-5 may handle high-volume analysis or support tasks. Claude Sonnet 4.5 may handle agentic coding or harder review workflows. A gateway routes each workload to its best fit without application changes.



Het laatste nieuws, artikelen en bronnen in je inbox



















