



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Veel LLM-calls in productie bestaan om één vraag te beantwoorden over een stuk tekst. Is dit een verzoek om terugbetaling? Hoe dringend is het? Hoe gefrustreerd is de klant? Decision models zijn gebouwd voor die taak. Ze beantwoorden getypeerde vragen en retourneren kansen in plaats van gegenereerde tekst: een ja/nee-kans, een keuze uit een vaste lijst, of een score op een schaal. TrueFoundry AI Gateway biedt ze nu aan op twee routes, POST /v1/decisions en POST /v1/systemone, over zeven providers.
U roept ze aan met de TrueFoundry API-sleutel die u al gebruikt en adresseert modellen als account-name/model-display-name. De gateway voegt de authenticatiegegevens van de provider in. Tracing, cost tracking, rate limits, budgetten en access control zijn op dezelfde manier van toepassing als voor elk ander model op de gateway.
Probeer de Decisions API op de TrueFoundry AI Gateway →
Twee routes die één providerlijst delen, zodat elk model van het type Decision op beide routes werkt:
/v1/decisions (alias /decisions) gebruikt het Decisions-formaat van OpenAI: een input plus een lijst van predicate-, choice- en score-vragen. /v1/systemone (alias /systemone) gebruikt het System One-formaat: een state plus een map van noul-, choice- en score-vragen, dezelfde bodies die TypeSafe Jev gebruikt.
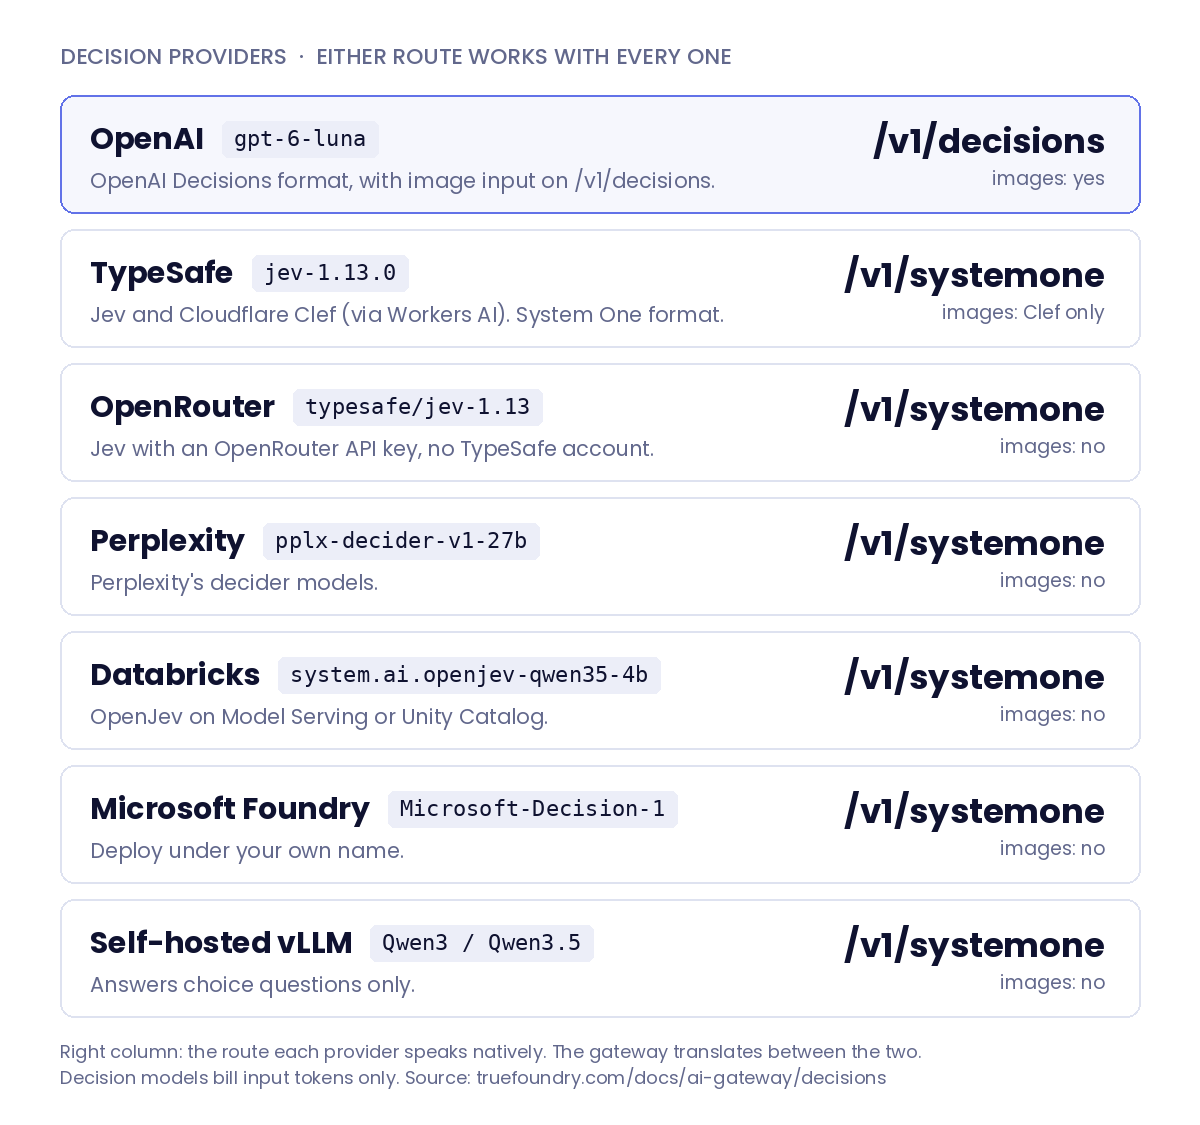
De twee formaten beschrijven hetzelfde idee in andere woorden. In System One is een ja/nee-vraag een noul en worden antwoorden gekoppeld aan de namen die u uw vragen geeft. In het formaat van OpenAI is het een predicate en komen antwoorden terug als een lijst in de volgorde van de vragen. De gateway voert de mapping per doel uit. Tekstgedeelten van een OpenAI input worden samengevoegd in de System One state. De criteria van een noul worden gevouwen in de instructies die OpenAI ziet. Een System One-vraag zonder instructies krijgt een generieke instructie wanneer deze naar OpenAI gaat, dat deze vereist.
Het resultaat is dat het wisselen van provider slechts een verandering van de model-string is. Richt een /v1/systemone-body op een OpenAI decision model en u krijgt nog steeds System One-antwoorden gekoppeld aan de vraagnaam. Richt een /v1/decisions-body op een TypeSafe Jev-model en u krijgt nog steeds antwoorden in de structuur van OpenAI.
Elk antwoord bevat waarschijnlijkheden. Een scorevraag met de niveaus rustig, licht geïrriteerd en boos retourneert de score, een betrouwbaarheid en een waarschijnlijkheid per niveau, zodat uw code eigen drempelwaarden kan toepassen in plaats van vrije tekst te parses.
TypeSafe was al bereikbaar via Custom Endpoints, die ruwe HTTP doorsturen naar de TypeSafe API. Dat pad blijft beschikbaar als een transparante proxy, maar het heeft geen cost tracking en u kunt niet van provider wisselen door het model te wijzigen. De nieuwe routes gebruiken modellen in uw catalogus, zodat u beschikt over access control, tracing, cost tracking, virtuele modellen en de mogelijkheid om van provider te wisselen zonder de request body te wijzigen.
Virtuele modellen zijn waar dit echt tot zijn recht komt. Een virtueel model waarvan de modeltypen decision bevatten, kan load balancing uitvoeren of een failover hebben over decision-doelen, inclusief een mix van OpenAI- en System One-providers. De gateway vertaalt elke poging naar het formaat van dat doel en vertaalt het succesvolle antwoord terug naar het formaat van de route die u heeft aangeroepen. Uw toepassing roept gedurende het hele proces één modelnaam aan.
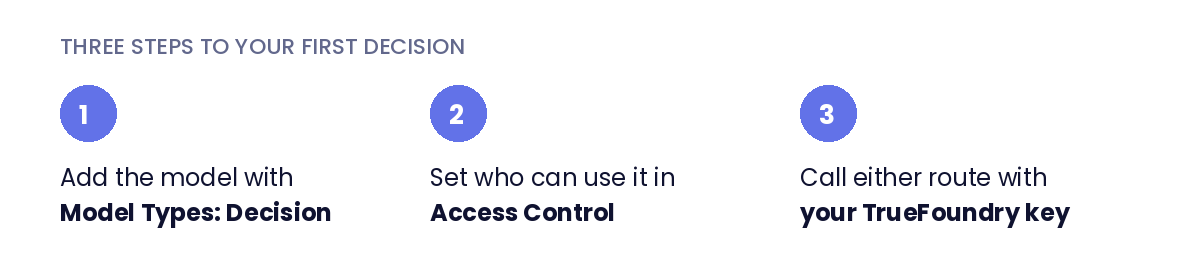
Stap 1: Voeg het provider-account en het model toe. Open in de gateway AI Gateway → Models, kies de provider en voeg de authenticatiegegevens toe. Voor TypeSafe is dat een TypeSafe API-sleutel, met een optionele base URL die naar Cloudflare Workers AI wijst. Voeg vervolgens het model toe met Model Types ingesteld op Decision; een chatmodel kan deze routes niet bedienen. Zet een versiegebonden model-ID vast waar de provider er een biedt (jev-1.13.0 in plaats van jev-latest) zodat betrouwbaarheidsdrempels stabiel blijven tussen releases, en stel de outputkosten in op 0.
Stap 2: Stel Access Control in zodat het model vanaf het eerste verzoek is afgestemd op de juiste gebruikers en teams.
Stap 3: Roep een van beide routes aan. Stuur uw TrueFoundry API-sleutel mee; de gateway voegt de upstream-authenticatiegegevens in. Stel GATEWAY_BASE_URL in zonder een afsluitende schuine streep.
Model-ID's zijn ingesteld in een namespace als account-name/model-display-name. Wijzig "model" naar een OpenAI decision model zoals openai-main/gpt-6-luna en OpenAI beantwoordt dezelfde body, nog steeds gekoppeld aan de vraagnaam. De versie in OpenAI-formaat van dit verzoek, en een afbeeldingvoorbeeld, staan in de Decisions API documentatie.
/v1/decisions, als inline data: URL's; gehoste URL's en bestand-ID's worden niet ondersteund. Andere providers ontvangen een 400 voordat ze worden aangeroepen. Cloudflare Clef, toegevoegd via een TypeSafe-account, accepteert wel afbeeldingen op het System One images-veld.choice-vragen en vereist een vLLM-build die vllm#59299 bevat (na v0.31.0).true als "true", of een keuze met één label of een score met één niveau verzonden naar OpenAI retourneren allemaal een 400 voordat er een provider wordt aangeroepen.{"type": "refusal", "name": ...}.Gebruik een decision model wanneer de output die u nodig heeft een label, een ja/nee of een score is die u gaat vergelijken met een drempelwaarde: het routeren van supporttickets, het markeren van inhoud, of het controleren van een document aan de hand van een regel. Het uitvoeren via TrueFoundry houdt de keuze van de provider in de gateway-configuratie, waar u deze kunt wijzigen zonder de request body aan te raken.
Probeer de Decisions API op de TrueFoundry AI Gateway →
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















