



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Beide zijn serverless GPU-platformen, beide schalen standaard naar nul, beide verwerken productieverkeer voor bekende bedrijven. Dit is een eerlijke strijd, maar ze hebben niet dezelfde opzet. Baseten heeft een platform voor model-serving gebouwd en dit verder uitgebreid. Modal heeft een algemeen computeplatform gebouwd waarin inference één van de zes producten is. Dat verschilt in de SDK, in wat er op de tarievenkaart staat en of je het in je eigen account kunt draaien.
Het meest nuttige hieronder is de prijsmethodologie, omdat gepubliceerde GPU-uurtarieven tussen deze twee niet vergelijkbaar zijn en de afwijking groot genoeg is om een beslissing te doen kantelen. Cijfers gecontroleerd op 25 september 2026.
Baseten is productie-inference voor open-source, custom en fine-tuned modellen, via Dedicated Deployments, per-token Model API's en Training (prijzen).
Opgericht in 2019 door Tuhin Srivastava (CEO), Amir Haghighat (CTO), Phil Howes en Pankaj Gupta. Financiering verliep via Series B, C, D en een $300M Series E op $5B, tot een $1.5B Series F op een $13B waardering op 22 juni 2026 (aankondiging); totaal opgehaald "meer dan $2B." De omzet groeide naar verluidt 20x jaar-op-jaar; ARR is niet gepubliceerd [VERIFY]. Klanten zijn onder meer Cursor, Notion, Harvey, HubSpot, OpenEvidence en Vercel.
Wat betreft een getal dat je wellicht voorbij hebt zien komen: persberichten eind september 2026 (Axios 22 sep, Bloomberg 23 sep) spreken over gesprekken rond een veel grotere ronde rond een gemelde $26B. Baseten heeft niets gepubliceerd. $13B is het laatste bevestigde cijfer en het cijfer dat we hanteren.
[SCREENSHOT: Baseten — het Dedicated Deployments dashboard dat replica states, autoscaling configuratie en latency percentielen toont voor een live model]
Baseten heeft ook Blaxel overgenomen, een bedrijf in agent-sandbox en microVM-infrastructuur, aangekondigd op 10 september 2026, voorwaarden niet bekendgemaakt (aankondiging) — een directe stap op het terrein van Modal's Sandboxes, pas twee weken oud zonder geleverde functionaliteit om te beoordelen.
Aanzienlijk beter voor: gereguleerde kopers die inference in hun eigen VPC nodig hebben, waar Modal geen equivalent voor heeft; iedereen met PHI, aangezien HIPAA in de gratis tier zit; teams die TensorRT-LLM-class optimalisatie willen zonder dit zelf te bouwen; en regio-gebonden of kleine GPU-workloads.
Modal noemt zichzelf “een cloud gebouwd voor AI. Geen GPU-cloud voor één enkel doel, maar een platform met de juiste primitieven” (Series C post). Producten: Inference, Sandboxes, Training, Notebooks, Batch, Core Platform. Die lijst is het argument — inference is slechts één onderdeel.
Opgericht in 2021 door Erik Bernhardsson en Akshat Bubna; het oprichtingsjaar komt van TechCrunch, niet van een Modal-pagina [VERIFY]. Het team heeft een eigen bestandssysteem, container-runtime, scheduler en image builder gebouwd, wat terug te zien is in de cold-start cijfers. Financiering verliep via seed, Series A en een $87M Series B op $1.1B, tot een $355M Series C op $4.65B post op 21 mei 2026; totaal “meer dan $466M.” Modal publiceert wat Baseten niet doet — “het overschrijden van $300 miljoen aan geannualiseerde omzet”, en dat “Sandboxes al meer dan een derde van onze omzet genereren”. Klanten zijn onder meer Cognition, DoorDash, Suno en Ramp.
[SCREENSHOT: Modal — het app dashboard dat container aantallen, GPU-utilisatie en cold-start timing toont voor een gedeployde Function]
[SCREENSHOT: Modal — de prijzenpagina met de GPU-tabel naast de afzonderlijke CPU en geheugen posten]
Aanzienlijk beter voor: alles wat geen model server is — sandboxes, onvertrouwde code, RL-omgevingen, batch, notebooks. Python-ergonomie. Grote GPU's, niet-regiogebonden, piekgevoelige workloads. GPU-diversiteit, aangezien L40S, A100 40GB en B300 geen Baseten-equivalent hebben. En init-zware cold starts die worden gedomineerd door JIT en imports in plaats van het laden van gewichten.
De Eerlijke weergave van cold starts: ze lossen verschillende helften van hetzelfde probleem op. Baseten richt zich op de overdracht van gewichten en telt deze overdracht niet mee voor de facturatie. Modal richt zich op de processtatus met snapshot-herstel, wat expliciet niet helpt bij het laden van gewichten. Als je cold start bestaat uit 140GB aan gewichten, is de benadering van Baseten relevant; als het gaat om imports, JIT en CUDA graph capture, is die van Modal dat.
Methodologie. Baseten publiceert per-minuut tarieven voor all-in instantie-SKU's — de GPU wordt geleverd met een vaste hoeveelheid vCPU en RAM. Modal publiceert per-seconde tarieven voor alleen de GPU, waarbij CPU en geheugen afzonderlijk worden gefactureerd. Om een eerlijke vergelijking te maken, rekenen we beide om naar per-uur (Baseten x60, Modal x3600), en tellen we vervolgens bij het GPU-tarief van Modal de CPU en het geheugen op die Baseten bundelt, tegen Modal's eigen tarieven: $0.04716 per fysiek core-uur (één core = twee vCPU) en $0.007992 per GiB-uur. Vermenigvuldigingsfactoren voor regio-binding en non-preemptible zijn niet meegenomen; het toevoegen daarvan maakt Modal nog duurder. Bronnen: baseten.co/pricing, docs.baseten.co/deployment/resources, modal.com/pricing.
Voor L40S en A100 40GB is er geen Baseten-SKU om mee te vergelijken.
De conclusie: “Modal is 40% goedkoper op H100” valt terug naar ongeveer 19% zodra je vergelijkbare CPU en geheugen meerekent, is vrijwel gelijk op A100 80GB, en draait om op kleine GPU's, waar Baseten 9-22% goedkoper is. Voeg daar regio-binding of de 3x non-preemptible vermenigvuldigingsfactor aan toe, en Baseten is definitief voordeliger bij elke gegarandeerde workload.
Een aandachtspunt bij het benchmarken: Modal's basis-instelling gpu="A100" kan stilzwijgend worden geupgraded naar 80GB, en gpu="H100" kan uitkomen op een H200. Zet dit vast met gpu="H100!".
1. De tarievenkaart is niet de uiteindelijke rekening. Teams schatten een budget op basis van een GPU-uurtarief, en krijgen vervolgens te maken met CPU, geheugen, opslagvolumes, vermenigvuldigingsfactoren voor regio's en een 3x tarief voor sandboxes. Baseten's gebundelde model is eenvoudiger te voorspellen; Modal's gespecificeerde model sluit nauwer aan op het werkelijke verbruik. Geen van beide is vergelijkbaar zonder bovenstaande berekening.
2. Regioselectie betekent geen data residency. Modal kan een container vastzetten op eu-west, maar slaat je logs, duurzame opslag en elke payload boven 2 MiB nog steeds op in de VS. Als een toezichthouder hiernaar vraagt, is de containerregio niet het afdoende antwoord.
3. De model server is slechts een onderdeel van het systeem. Je hebt ook te maken met commerciële model-API's, authenticatie, kostentoewijzing, rate limits, guardrails en een audit trail. Geen van beide platformen biedt die laag volledig, waardoor het inrichten daarvan alsnog bij jouw team ligt.
Een helder antwoord in plaats van een gezochte vergelijking tussen drie partijen. Baseten en Modal zijn hosted inference-clouds. TrueFoundry draait binnen je eigen cloudaccount. Een ander type koper, een ander probleem.
Zij beantwoorden de vraag: “hoe kan ik dit model serveren zonder zelf GPU's te beheren.” TrueFoundry beantwoordt de vraag: “we hebben al GPU-capaciteit, aangegane verplichtingen of te maken met regelgeving, en we hebben een platform nodig op onze eigen infrastructuur.” Als de eerste vraag op jou van toepassing is, kies dan een van hen — Baseten's self-hosted modus komt daar het dichtst bij in de buurt.
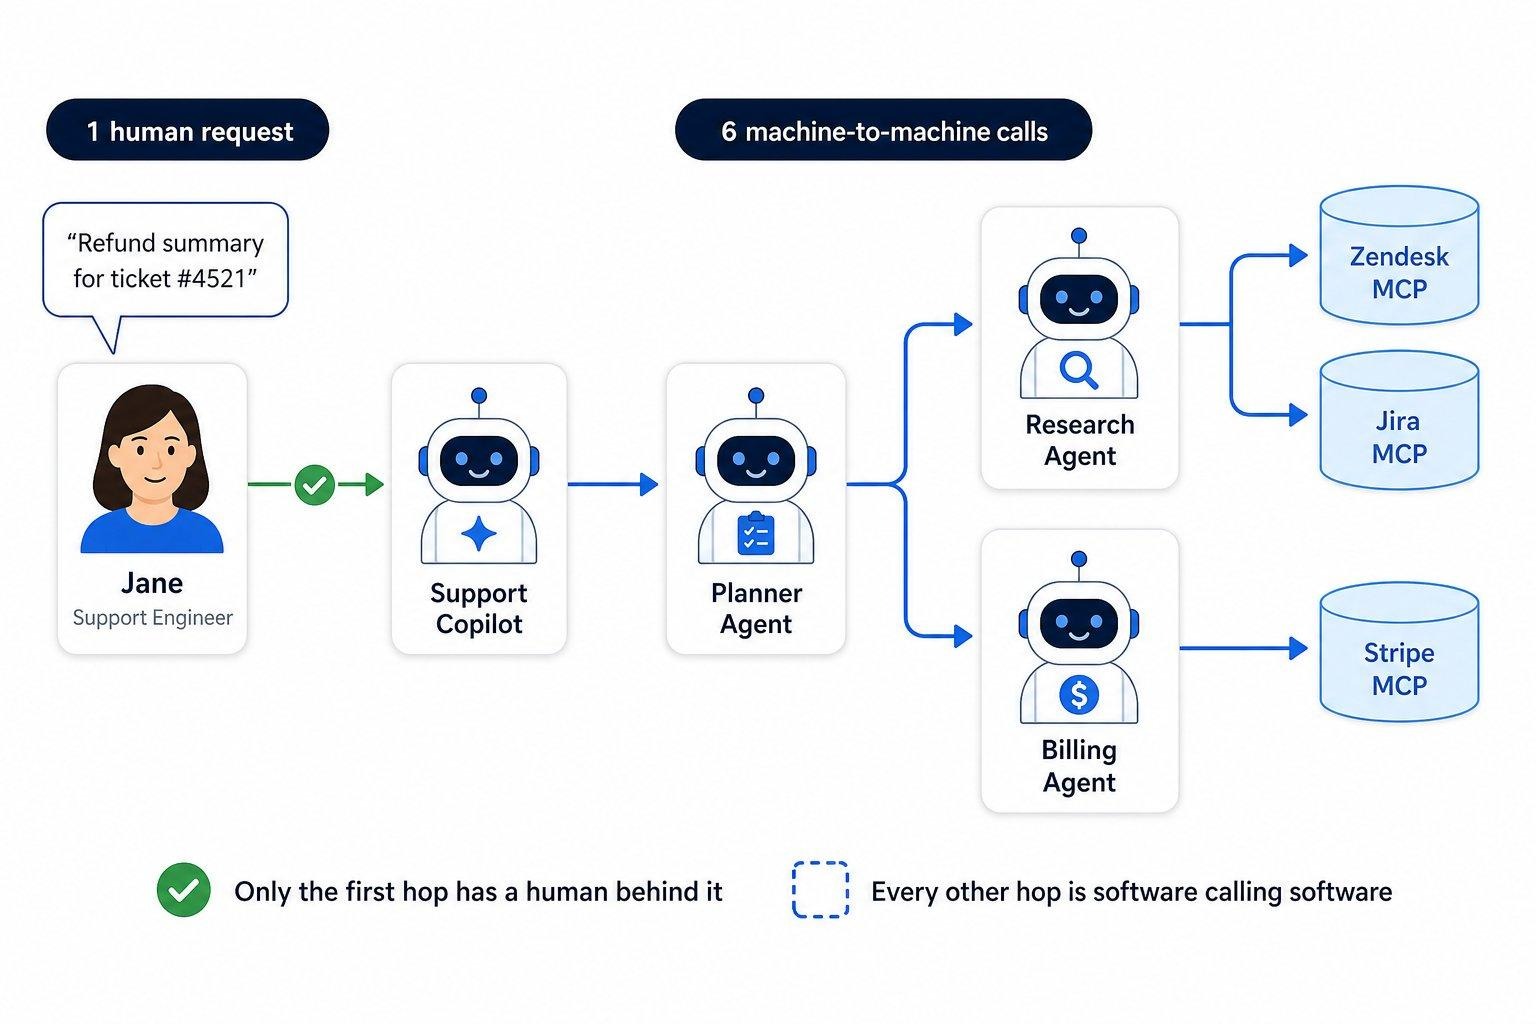
TrueFoundry wordt uitgerold als SaaS over meer dan 12 regio's op drie clouds, of self-hosted in je VPC via Helm en OpenTofu/Terraform, op-premises, of air-gapped. Bij self-hosted blijft al het LLM-verkeer binnen je eigen infrastructuur en bevindt TrueFoundry zich niet in het actieve datapad. Serving ondersteunt vLLM, SGLang, Triton, TorchServe, MLflow en LitServe, plus een model registry, autoscaling op CPU, RPS of cron, en fractionele GPU's via time-slicing en MIG — wat van belang is wanneer je eigenaar bent van de hardware en een volledige H100 voor een klein model verspilling is.
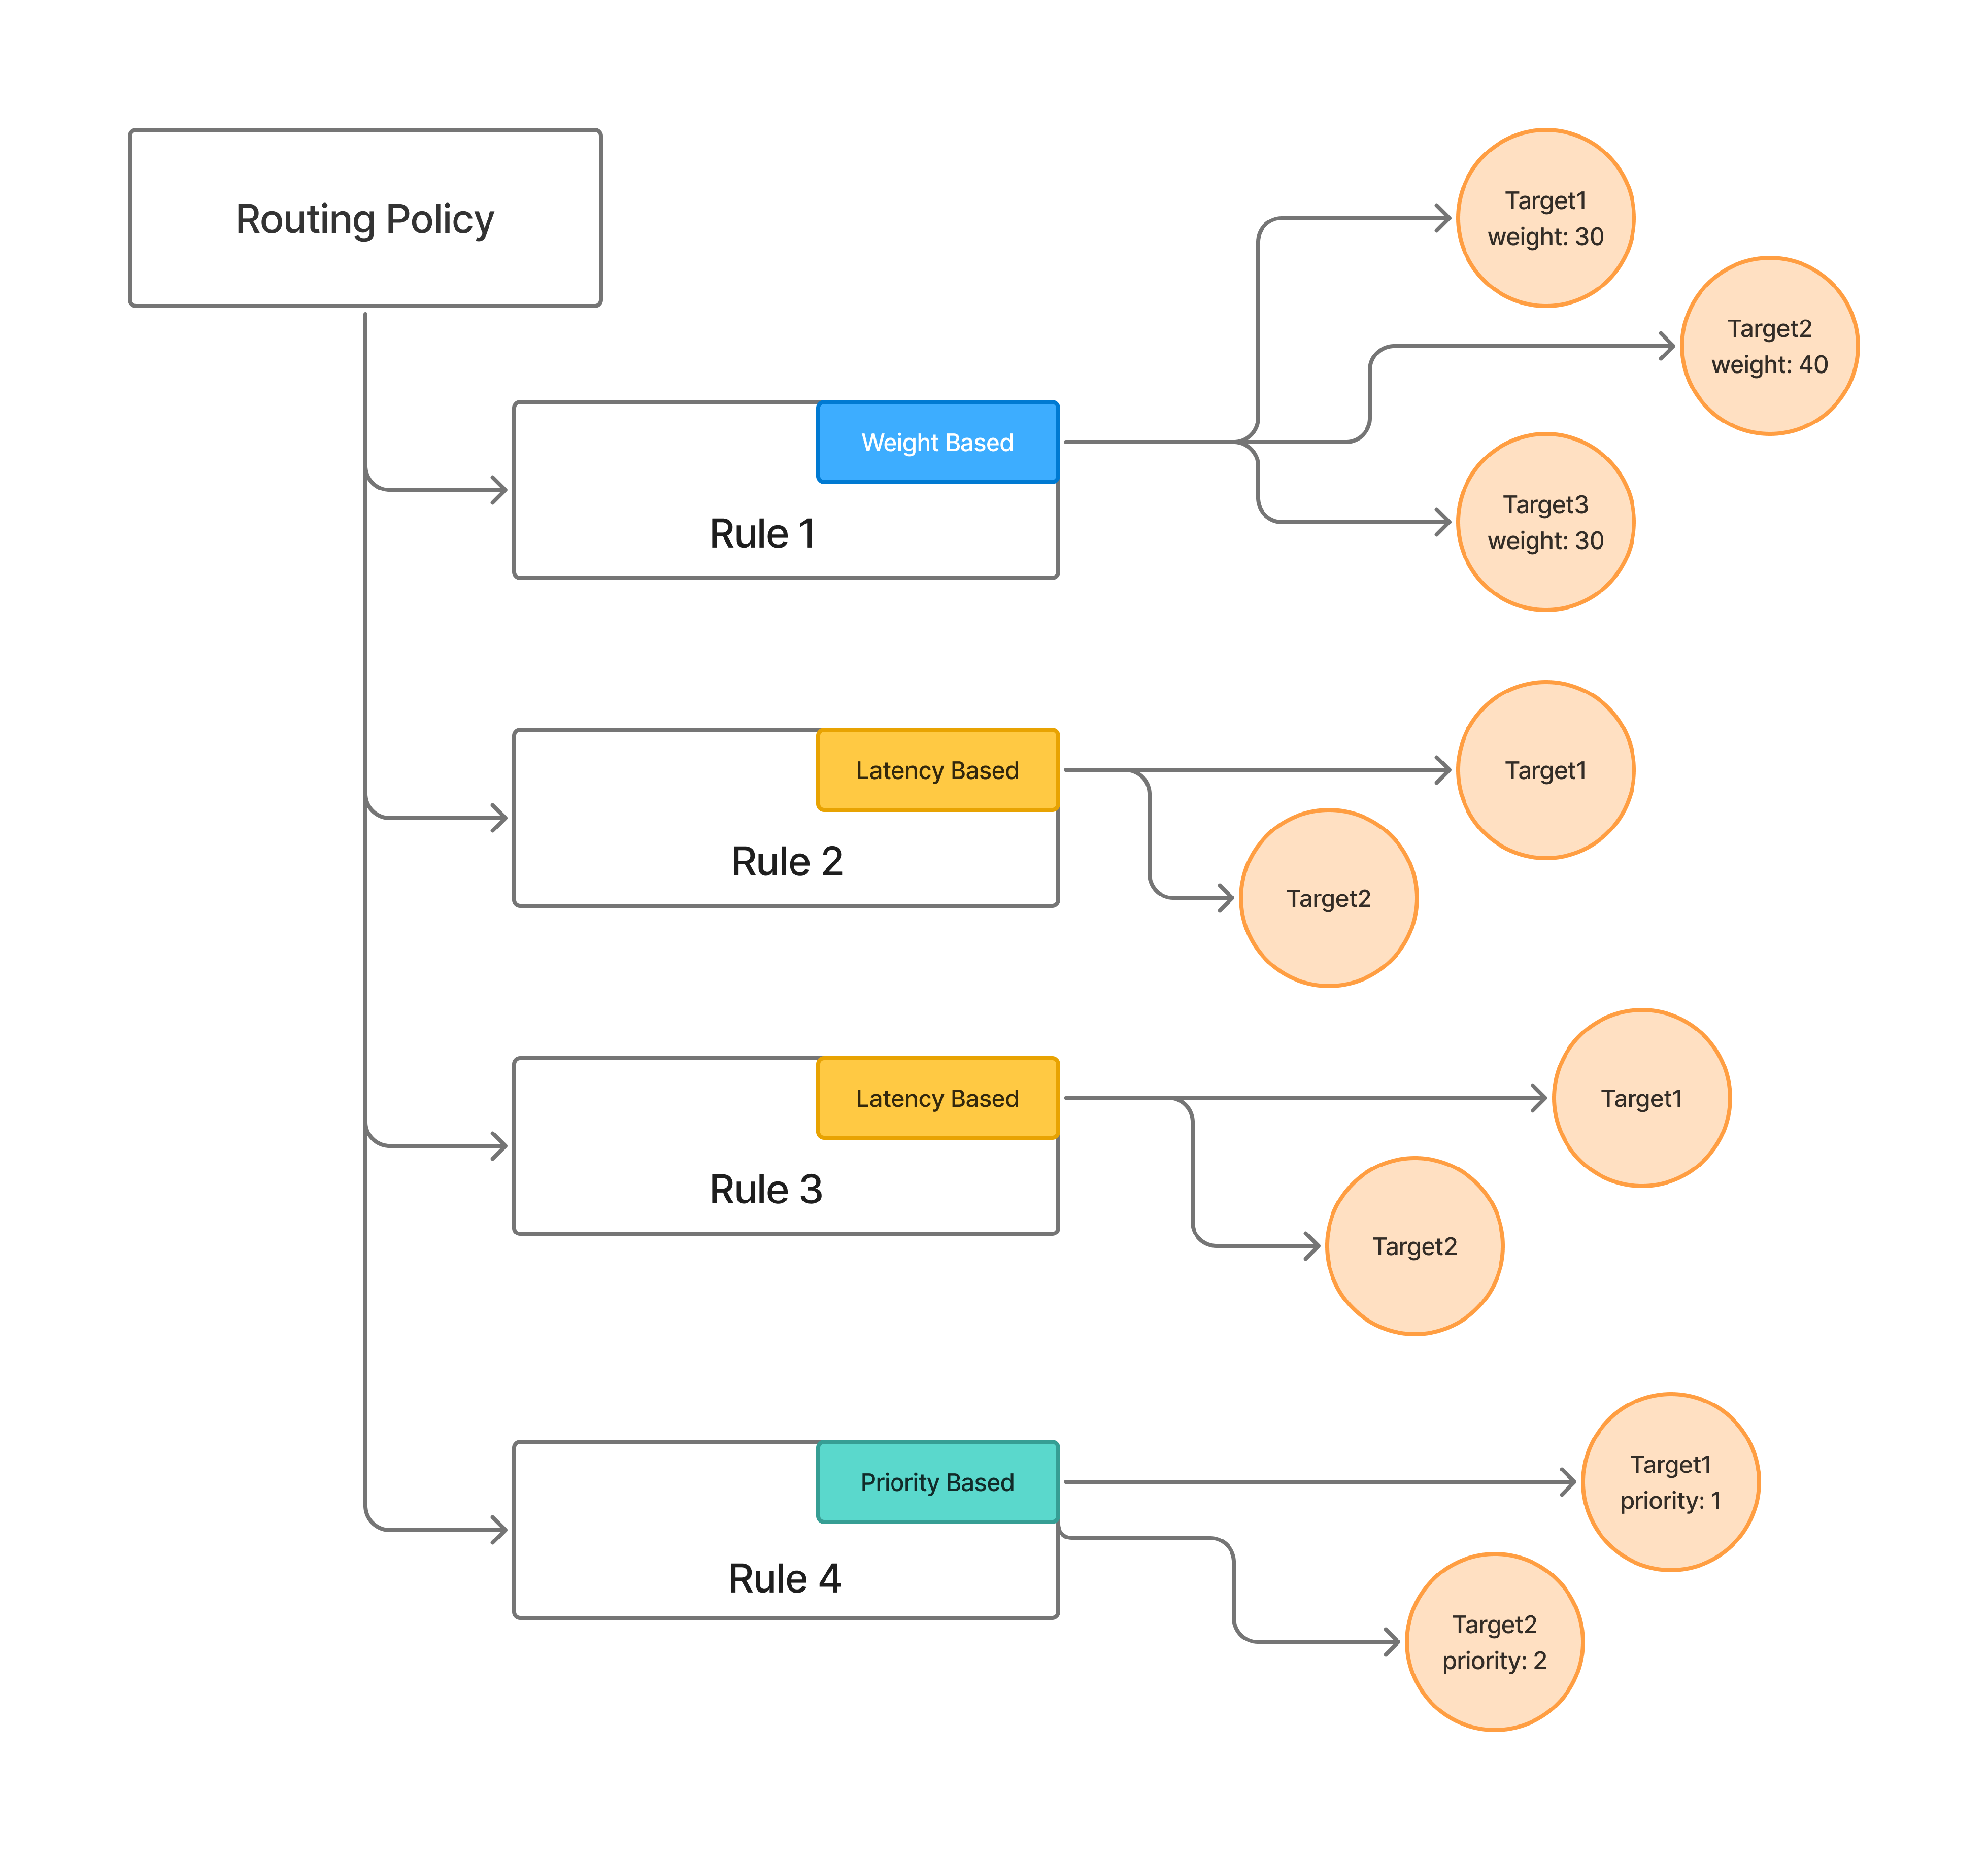
De andere helft is de AI Gateway, waar self-hosted en hosted inference niet langer gescheiden uitdagingen zijn. Het ontsluit 1.000+ LLM's achter één OpenAI-compatibele API, voegt ongeveer 3-4 ms latency toe en verwerkt 350+ RPS op 1 vCPU. Hierdoor zitten je Baseten-endpoint, je Modal-endpoint en je OpenAI-sleutel achter één interface met gedeelde kostentoewijzing, rate limits en audit trail. Auto Routing is de knop voor kostenbeheersing: over 550 prompts verlaagde het routeren op basis van complexiteit de kosten met 69% met behoud van 98% van de kwaliteit, waarbij de gemiddelde latency daalde van 7,6s naar 4,0s.
Eerlijke beperking: TrueFoundry is geen serverless GPU-marktplaats — je brengt je eigen capaciteit mee. Als je geen GPU's hebt en deze ook niet wilt aanschaffen, kies dan voor Baseten of Modal.
Baseten en Modal zijn beide sterke oplossingen. De vergelijking ontloopt elkaar nauwelijks op het punt waar de meeste mensen als eerste naar kijken — de prijs — maar verschilt aanzienlijk op de punten die bepalend zijn voor de uiteindelijke selectie.
Als de workload in je eigen VPC moet draaien, of als je verplichtingen hebt rondom PHI, of als je TensorRT-LLM wilt gebruiken zonder zelf de engine te beheren, of wanneer je gebruikmaakt van kleine, regiogebonden GPU's, dan is Baseten het juiste antwoord. Als je naast inference ook behoefte hebt aan sandboxes, batch-verwerking en notebooks, of wanneer Python-ergonomie de hoogste prioriteit heeft, kies dan voor Modal.
Wat wij niet zouden aanraden, is een keuze maken op basis van enkel het gecommuniceerde GPU-uurtarief. Dat is tussen deze twee partijen niet direct vergelijkbaar. Na een juiste correctie verandert een schijnbaar voordeel van 40% naar 19%, naar een gelijke stand, of slaat het door naar de andere aanbieder.
Ligt de harde randvoorwaarde bij het feit dat de workload binnen de infrastructuur moet blijven die je al bezit en betaalt, dan is geen van beide hosted platformen het antwoord. Dat is een vraagstuk op het gebied van een control plane, en dat is waar wij de oplossing voor bouwen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



It depends on the GPU, and the published rates mislead. On headline numbers Modal looks 37-40% cheaper on H100 and A100 80GB. Add the CPU and memory Baseten bundles and the H100 gap narrows to about 19%, A100 80GB is parity, and on T4 and A10 Baseten is 9-22% cheaper. Modal’s pinning and non-preemptible multipliers push further toward Baseten, and its $250/mo Team fee is fixed cost Baseten does not charge.
Starter $0/mo with $30/mo free compute; Team $250/mo with $100/mo free compute; Enterprise custom. Compute is per second and itemised: GPU at its own rate, CPU at $0.04716 per physical core-hour, memory at $0.007992 per GiB-hour. Sandbox and Notebook compute is 3x the Function rate, and pinning and non-preemptible capacity carry multipliers.
Basic is $0/month pay-as-you-go with no platform fee, including SOC 2 Type II and HIPAA; Pro and Enterprise are on quote. GPU compute bills per minute against all-in instance SKUs bundling vCPU and RAM — $6.4998/hr for an H100 80GB. Per-token Model API rates are published; the free-credit amount is not.
Containers boot in roughly a second, and Memory Snapshots deliver 3-10x faster restores per Modal’s docs. The “100x” figure in Modal’s Series C post is not supported by its own documentation, so plan against 3-10x. GPU snapshots are Alpha and do not speed up loading weights from storage.
Not confirmed. The last valuation Baseten has published is $13B, from a $1.5B Series F on 22 June 2026. Press reports in late September 2026 describe talks around a larger round, but that is talks-stage reporting and the company has published nothing.



Het laatste nieuws, artikelen en bronnen in je inbox



















