



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
AWS Bedrock dient als een beheerde laag voor toegang tot foundation models binnen de AWS VPC-grens. Voor engineeringteams neemt het de operationele overhead weg van het provisioneren van GPU-instances of het beheren van Kubernetes-clusters voor inference. De dienst biedt directe toegang tot modellen zoals Claude 3.5 Sonnet, Llama 3 en Amazon Titan via één uniforme API.
De AWS Bedrock-prijzen zijn echter geen vast tarief. Het werkt als een complex menu waar de uiteindelijke kosten afhankelijk zijn van modelvariatie, tokenverdeling, regionale verkeerscapaciteit en de operationele overhead van ondersteunende diensten zoals CloudWatch en OpenSearch. Dit rapport ontleedt de bedrijfseconomische aspecten van AWS Bedrock, identificeert waar de kosten pieken op schaal, en analyseert de architecturale afwegingen tussen beheerde inference en self-hosted alternatieven met platforms zoals TrueFoundry.
Voordat we inzoomen op de gedetailleerde kosten, is het belangrijk om het algemene prijsmodel van AWS Bedrock te begrijpen. AWS Bedrock volgt een puur op gebruik gebaseerde prijsbenadering zonder voorafgaande platform- of abonnementskosten.
U betaalt niet om de dienst in te schakelen. In plaats daarvan wordt u voornamelijk gefactureerd voor model-inference, gemeten via tokens of gegenereerde outputs. De prijs per eenheid varieert echter aanzienlijk afhankelijk van de provider van het foundation model; een Anthropic-model kost aanzienlijk meer dan een Meta- of Mistral-model, zelfs als het aantal tokens identiek is.
De prijzen van AWS Bedrock worden gedreven door hoe modellen bronnen verbruiken tijdens inference. Hoewel de meeste tekstmodellen per token factureren, verschillen multimodale modellen.
U moet onderscheid maken tussen Input Tokens en Output Tokens. Input-tokens bestaan uit de prompt-payload, inclusief systeeminstructies, gebruikersvragen en — heel belangrijk — opgehaalde context uit RAG-pipelines. Output-tokens vormen het gegenereerde antwoord.
De operationele werkelijkheid dicteert dat output-tokens aanzienlijk duurder zijn, omdat de rekenkosten van generatie (next-token prediction) hoger zijn dan het verwerken van input-context. Zo betaalt u voor Claude Sonnet 4.5 in us-east-1 $3,00 per miljoen input-tokens maar $15,00 per miljoen output-tokens — een vermenigvuldigingsfactor van 5x. Voor multimodale modellen zoals Amazon Titan Image Generator verschuift de facturering naar een prijs per afbeelding, berekend op basis van resolutie en het aantal stappen.
Fig 1: Het Kostenvermenigvuldigingseffect
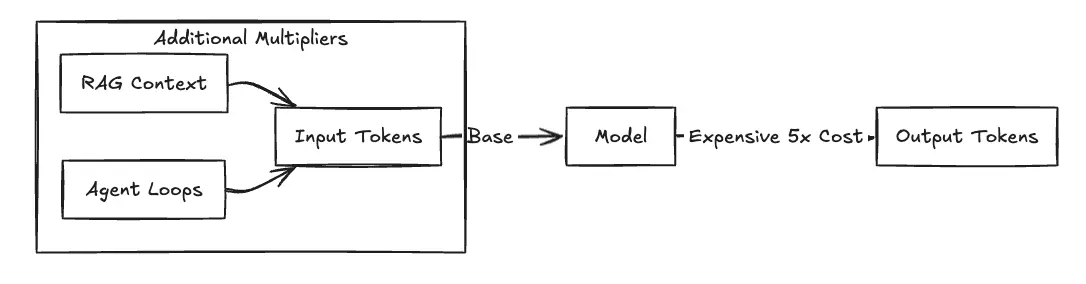
AWS Bedrock-prijzen zijn niet alleen "betalen per token". Teams moeten kiezen tussen twee prijsmodellen die flexibiliteit inruilen voor gegarandeerde capaciteit.
Fig 2: Ontleding van de Totale Factuur
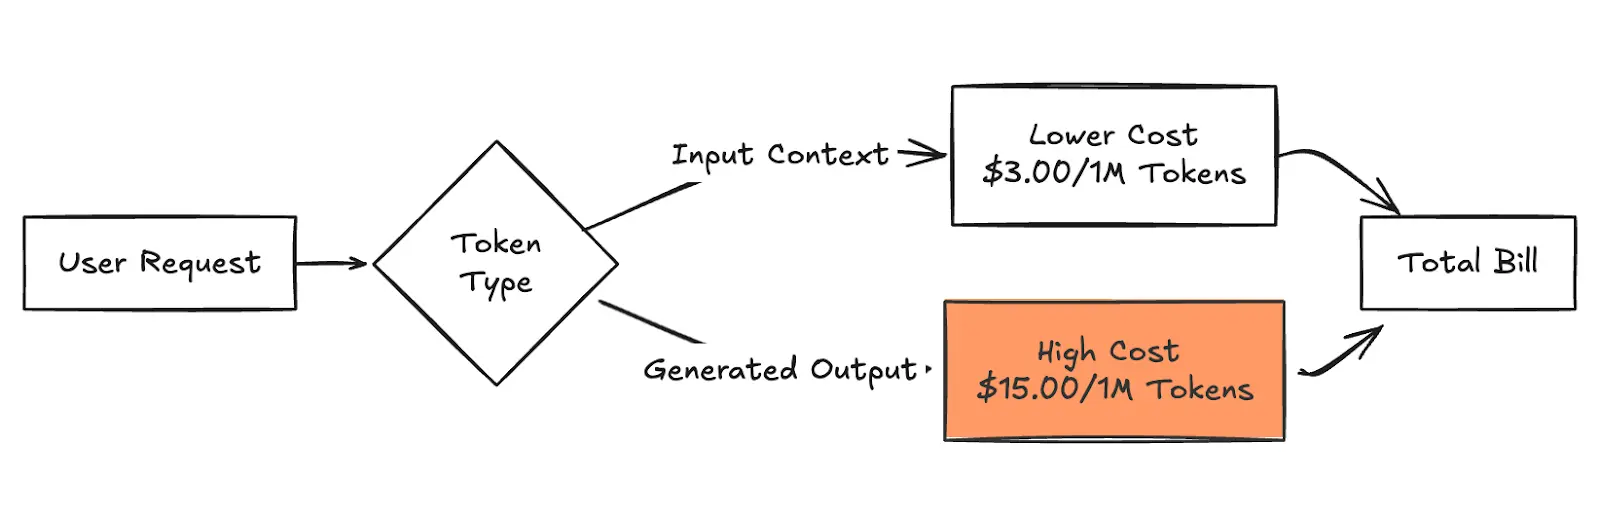
De prijzen weerspiegelen de On-Demand-tarieven van AWS Bedrock voor Anthropic Claude 3.5 Sonnet in de regio us-east-1 vanaf januari 2026. Prijzen kunnen variëren per regio of modelversie.
On-Demand pricing is de standaardoptie voor de meeste AWS Bedrock-gebruikers. Het biedt flexibiliteit maar brengt operationele risico's met zich mee. U wordt strikt gefactureerd per 1.000 verwerkte tokens, wat perfect is voor wisselende verkeerspatronen of vroege experimenten waarbij het gebruik piekgevoelig is. De keerzijde is echter de betrouwbaarheid. AWS hanteert throttling-limieten, wat betekent dat uw verzoeken tijdens piekuren te maken kunnen krijgen met throttling.
Provisioned Throughput pricing is ontworpen voor teams die gegarandeerde modelbeschikbaarheid op schaal nodig hebben. Het brengt voorspelbaarheid met zich mee, maar vereist een financiële commitment. In plaats van per token te betalen, koopt u een toegewezen modeleenheid om inference-capaciteit te reserveren en een specifieke doorvoercategorie te garanderen.
Het addertje onder het gras is dat u een vast uurtarief betaalt, ongeacht of u nul verzoeken verstuurt of de eenheid maximaal belast. Dit model werkt zoals een reserved instance; het vereist doorgaans een commitment van 1 tot 6 maanden, wat uw vermogen beperkt om snel van model te wisselen als er volgende week een betere versie uitkomt.
In tegenstelling tot OpenAI, waar u één leverancier betaalt, is Bedrock een marktplaats. Prijsstrategieën verschillen per leverancier.
Amazon Titan-modellen zijn AWS-native foundation models die zijn ontworpen voor algemene AI-workloads. Omdat het first-party modellen zijn, zijn ze meestal lager geprijsd dan alternatieven van derden. Dit maakt ze geschikt voor kostengevoelige productiecases zoals het genereren van embeddings of eenvoudige classificatie, waarbij "goed genoeg" prestaties tegen een lage prijs het doel zijn.
AWS Bedrock biedt ook toegang tot modellen van externe providers zoals Anthropic, Cohere en AI21 Labs. De prijzen zijn hier over het algemeen hoger vanwege de geavanceerde mogelijkheden en de externe licenties. Houd rekening met de kostenpremie op modellen met een hoog redeneervermogen zoals Claude 4.5 Sonnet, waar output-tokens aanzienlijk duurder zijn. De kosten kunnen hier snel oplopen voor chat-intensieve toepassingen waarin het model "nadenkt" of lange, gedetailleerde antwoorden genereert.
Uw applicatie-ontwerp heeft net zo veel invloed op uw factuur als het prijskaartje van het model.
De basistokenprijs is vaak slechts het topje van de ijsberg. Real-world AI-toepassingen maken gebruik van "Knowledge Bases" en "Agents", die hun eigen afzonderlijke metingen hebben.
Fig 3: De Aanvullende Kostenstapel
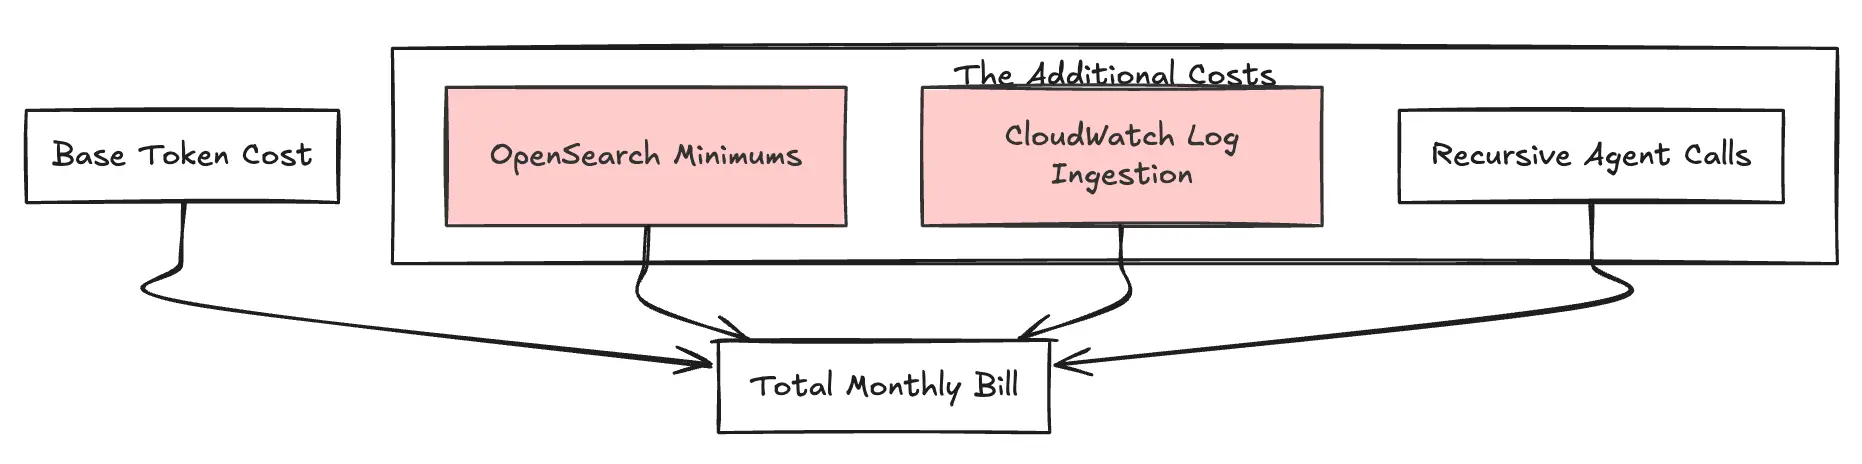
Bedrock Knowledge Bases abstraheren de RAG-pipeline, maar provisioneren infrastructuur op de achtergrond. Meestal start dit een OpenSearch Serverless vector store op. Engineeringteams zien de minimale bodemkosten vaak over het hoofd: OpenSearch Serverless vereist minimaal 2 OCU's (OpenSearch Compute Units) voor redundantie in productie. Bij ~$0,24 per OCU/uur (in us-east-1) resulteert dit in een basislijn van ongeveer $350/maand (voor een standaard redundante setup) alleen al voor het bestaan van de index, zelfs bij nul zoekverkeer.
"Agents" voeren meerdere stappen uit om één gebruikersvraag te beantwoorden (Nadenken → Zoeken → Samenvatten). Het effect is dat een enkele gebruikersvraag 10x zoveel tokens kan veroorzaken als u verwachtte vanwege deze interne lus en redeneersporen. U betaalt voor de input en output van elke tussenliggende gedachte, wat een vermenigvuldigingseffect op uw factuur creëert.
Auditeerbaarheid is verplicht voor enterprise AI, maar de integratie van Bedrock met CloudWatch Logs is zeer gedetailleerd. Het legt de volledige prompt- en respons-payloads vast. CloudWatch-ingestie in regio's zoals us-east-1 kost $0,50 per GB, en opslag voegt daar nog eens $0,03 per GB aan toe. Tekstgeneratietoepassingen met een hoog volume kunnen eenvoudig honderden gigabytes aan loggegevens genereren, wat ongemerkt een aanzienlijke overhead aan de maandelijkse factuur toevoegt.
Veel teams onderschatten de prijzen van AWS Bedrock tijdens vroege experimenten omdat de variabelen moeilijk te isoleren zijn. Tokengebruik varieert sterk op basis van gebruikersgedrag; de ene gebruiker stelt een eenvoudige vraag, terwijl een andere een PDF van 50 pagina's plakt om samen te vatten. Bovendien experimenteren ontwikkelaars graag, en het overstappen van Claude Haiku naar Claude Sonnet verandert uw prijscategorie onmiddellijk, vaak zonder dat Finance het doorheeft tot het einde van de maand. Tot slot werken AWS-budgetten op accountniveau, waardoor het erg moeilijk is om te zien "Hoeveel heeft de Marketing Bot uitgegeven versus de Engineering Bot?" zonder complexe tagging-strategieën.
Ondanks de complexiteit werken AWS Bedrock-prijzen goed voor bepaalde scenario's. Als u al gestandaardiseerd bent op AWS, is de "native integratie"-belasting het waard voor de beveiligings- en compliancevoordelen zoals IAM en PrivateLink. Voor toepassingen met wisselend verkeer die onregelmatig of onvoorspelbaar worden gebruikt, is het On-Demand-model perfect omdat u niets betaalt wanneer de app stilstaat. Hiermee kunnen beginnende projecten snel starten zonder GPU's of Kubernetes-clusters te beheren, om zo de product-market fit te valideren voordat de kosten worden geoptimaliseerd.
Naarmate AI-workloads volwassener worden, stuiten teams vaak op structurele beperkingen. Bij hoge volumes (miljoenen verzoeken) wordt de toeslag per token duur vergeleken met het bezitten van de rekencapaciteit. Fine-tuning op Bedrock vereist vaak de aanschaf van Provisioned Throughput, wat de instapdrempel drastisch verhoogt vergeleken met het fine-tunen van Llama 3 op uw eigen GPU. Bovendien ontbreekt het in omgevingen met meerdere teams aan gedetailleerde budgethandhaving op applicatieniveau, wat leidt tot een "tragedy of the commons"-gebruik waarbij één team het gedeelde budget uitput.
TrueFoundry biedt een alternatief architecturaal patroon voor teams die tegen het plafond van de bedrijfseconomische grenzen van Bedrock aanlopen. In plaats van de model-API met een opslag te huren, orchestreert TrueFoundry de implementatie van open-source modellen (Llama 3, Mistral, Qwen) rechtstreeks op uw eigen AWS EC2- of EKS-clusters.
Dit ontgrendelt de mogelijkheid om gebruik te maken van AWS Spot Instances. Door inference uit te voeren op Spot-capaciteit — ongebruikte AWS-rekencapaciteit die beschikbaar is tegen hoge kortingen — kunt u de bruto inference-kosten met 60-70% verlagen vergeleken met On-Demand Bedrock-tarieven. TrueFoundry beheert het operationele risico van Spot-onderbrekingen door de terugval naar On-Demand-instances te automatiseren als Spot-capaciteit wordt teruggevraagd, wat betrouwbaarheid garandeert zonder de lock-in van 6 maanden bij Provisioned Throughput.
Dit is een feitelijke vergelijking gericht op de economische aspecten van het aanbieden van modellen.
Naarmate de adoptie van AI groeit, wordt het duidelijk hebben van de prijzen essentieel voor duurzame schaalvergroting. AWS Bedrock-prijzen zouden u niet moeten dwingen te kiezen tussen innovatie en faillissement.
TrueFoundry geeft u de macht om uw AI-uitgaven te beheren, biedt gedetailleerd inzicht in elk model en de flexibiliteit om workloads uit te voeren op de meest kosteneffectieve infrastructuur die beschikbaar is.
De prijzen van AWS Bedrock variëren per foundation model en tokengebruik. Hoewel model-inference bij lage volumes toegankelijk is, wordt model-inference op grote schaal kostbaar vanwege opslagen voor beheerde diensten. TrueFoundry maakt betere kostenoptimalisatie mogelijk door modellen uit te voeren op AWS Spot Instances, wat uw totale maandelijkse kosten aanzienlijk verlaagt vergeleken met de tarieven van Bedrock.
Ja, de kosten van AWS Bedrock volgen een pay-as-you-go prijsmodel. U wordt gefactureerd voor elk aantal verwerkte tokens voor input-tokens en output-tokens. Voor zware generatieve AI-toepassingen lopen deze kosten snel op. TrueFoundry biedt een voordeligere aanpak door gebruik te maken van bruto rekencapaciteit-tarieven op uw eigen infrastructuur.
De prijzen van Amazon Bedrock omvatten geen permanente gratis modus. Hoewel een nieuw AWS-account algemene credits kan bieden, brengt Bedrock kosten voor model-inference direct in rekening. TrueFoundry helpt Bedrock-kosten te minimaliseren door u in staat te stellen goedkopere spot-instances te gebruiken voor uw specifieke use-cases en batch-jobs.
Er bestaat geen speciale gratis laag voor AWS Bedrock. Gebruikers betalen voor al het gebruik van tekstgeneratie en afbeeldinggeneratie. Om onvoorspelbare AWS Bedrock-kosten te vermijden, stappen teams over op TrueFoundry, dat gebruikmaakt van autoscaling en batch-inference om de kosten van generatieve AI effectiever te beheren dan de beheerde dienst.
TrueFoundry is een superieur alternatief voor deze volledig beheerde dienst. Hiermee kunt u elk aangepast model (zoals Mistral AI) of een Amazon Titan-model implementeren in uw eigen cloud. In tegenstelling tot Bedrock vereenvoudigt het kostenbeheer door spot-instances en data-automatisering te gebruiken, waardoor een vendor lock-in voor het importeren van aangepaste modellen wordt vermeden.
Er is geen gratis versie van Amazon Bedrock; u betaalt voor toegang tot elk foundation model. Voor een betere waarde op de lange termijn stelt TrueFoundry u in staat om open-source modellen uit te voeren met prompt-caching en modeldistillatie op uw eigen hardware, wat de instapdrempel voor de adoptie van generatieve AI drastisch verlaagt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















