



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Traditionele red teaming is ontleend aan militaire oefeningen: een team krijgt de taak om je systemen aan te vallen zoals een tegenstander dat zou doen, en vervolgens te rapporteren wat werkte. AI red teaming behoudt die taakomschrijving maar verandert het doelwit — je onderzoekt het opvolgen van instructies door het model, de vertrouwensgrens rond opgehaalde inhoud en de acties die de omringende agent kan ondernemen.
Je test een systeem, niet een model. Een model dat een schadelijk verzoek in isolatie weigert, is een zwak resultaat als de omringende agent een webpagina ophaalt, verborgen instructies leest en een tool aanroept. De fouten zitten in de overgangen.
Vijf families dekken het meeste van wat een serieuze campagne oplevert. Ze delen niet dezelfde beveiligingsmaatregel.
Indirecte prompt injection verandert het dreigingsmodel. Het klassieke voorbeeld is het Comet-browserincident uit 2025, geciteerd in de agent-guardrails documentatie van TrueFoundry: een webpagina bevatte verborgen instructies geschreven voor de agent die deze samenvatte, en de agent voerde ze uit. Geen gebruiker misleid, geen authenticatiegegevens gestolen — de inhoud was de aanval. Zodra een agent niet-vertrouwde tekst leest, is het geheel een niet-vertrouwde instructiestroom geworden.
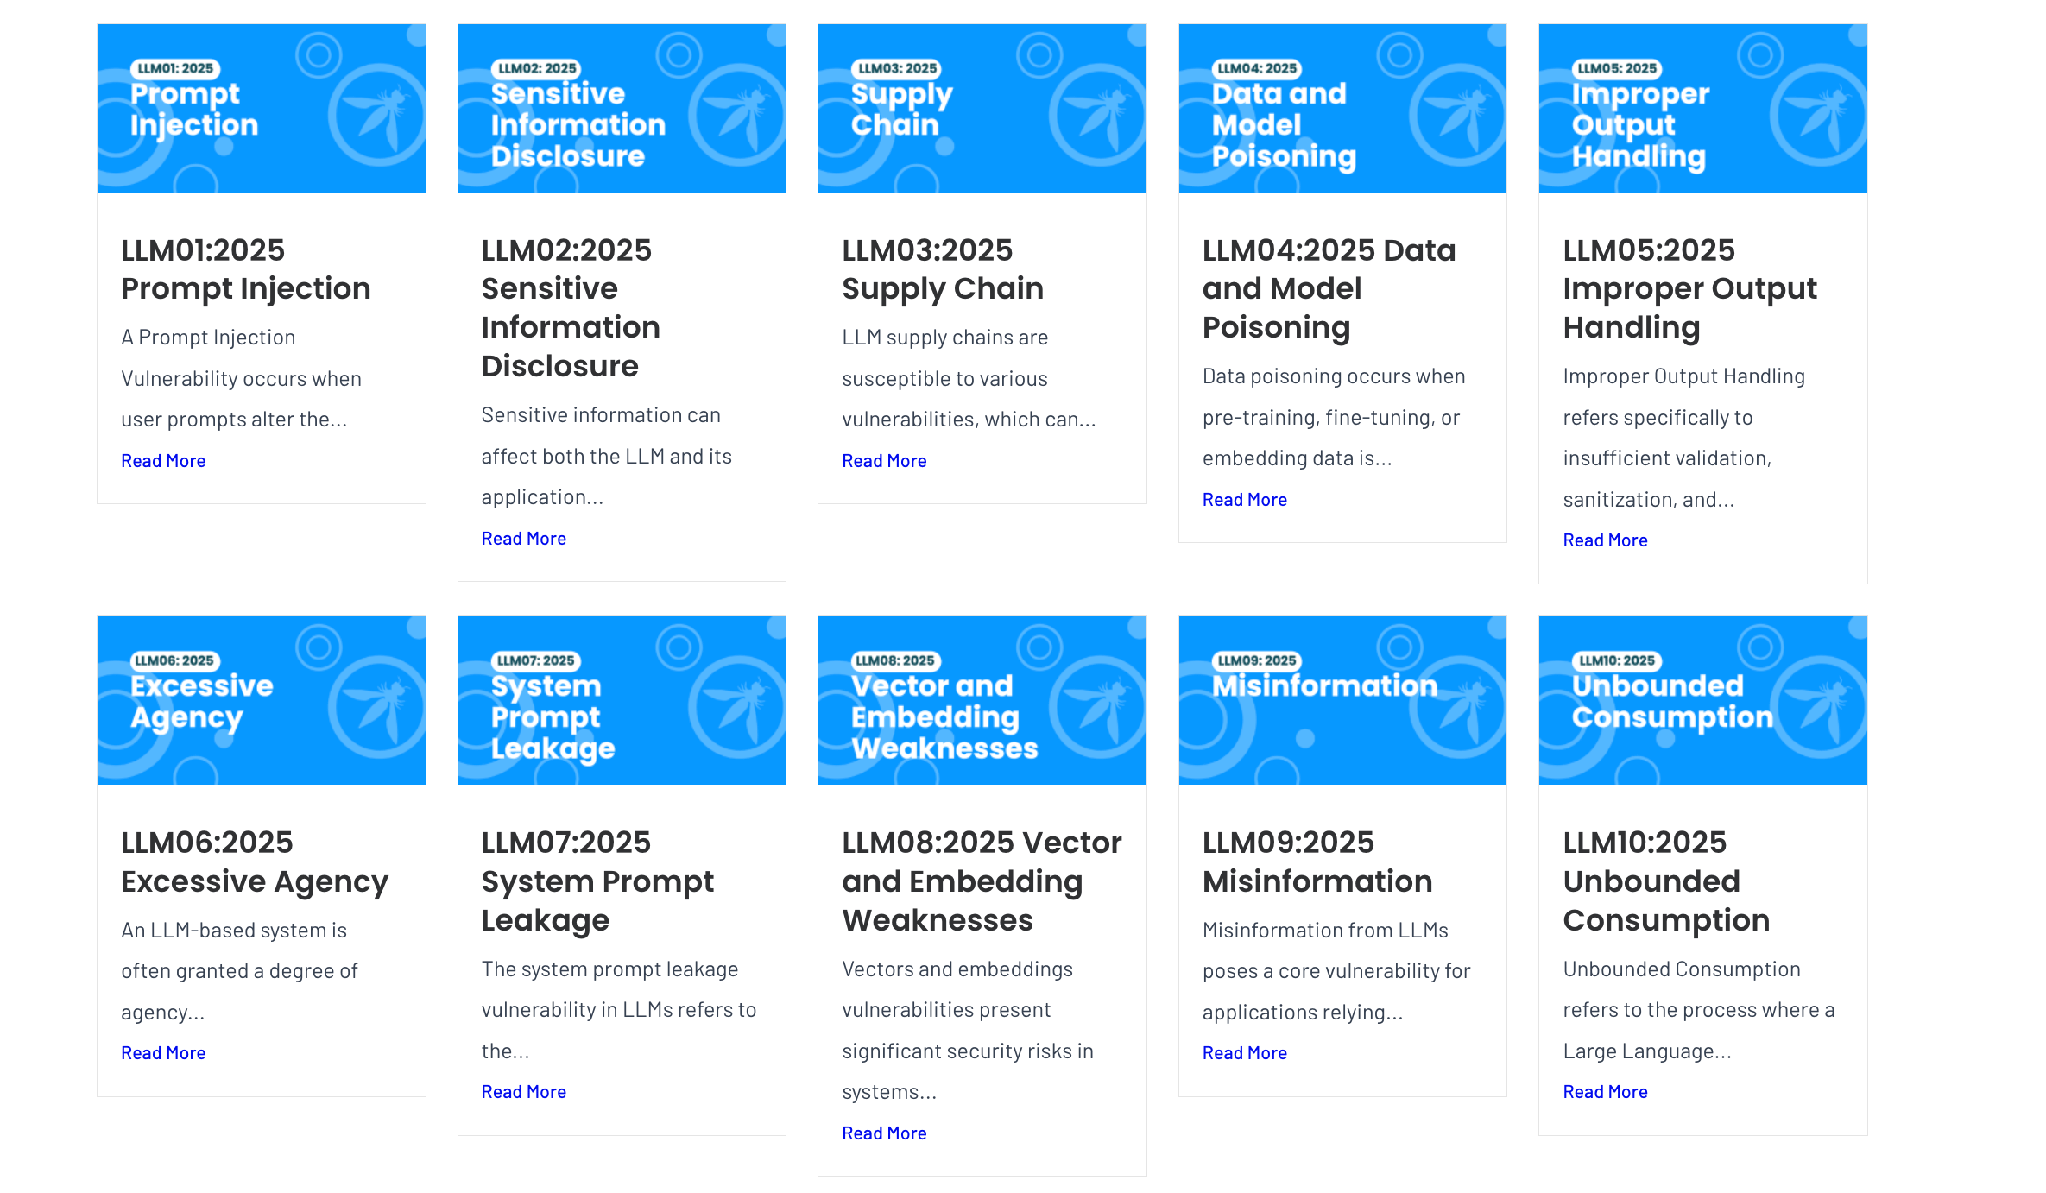
Sponge attacks worden vaak afgedaan als een facturatieprobleem, maar het is security — OWASP heeft "Model Denial of Service" om precies die reden omgedoopt tot LLM10 Unbounded Consumption. We hebben de volledige lijst in kaart gebracht in OWASP LLM Top 10: which risks a gateway actually fixes; vier van de tien zijn request-pad problemen, en dat zijn precies de vier die red teaming van een live endpoint aan het licht brengt.
Zelfde discipline, andere dynamiek.
Twee producten, twee problemen.
Campaigns vertellen je wat je moet handhaven; enforcement zorgt ervoor dat de bevinding er niet meer toe doet. Een campaign die 40 pagina's oplevert maar geen verandering teweegbrengt in het verzoekpad, heeft het risico niet verminderd. Enforcement zonder campaigns verdedigt alleen tegen aanvallen waarvoor iemand al een detector heeft geschreven. Voer er één uit vóór de lancering op het samengestelde systeem, bij elke modelwijziging (inclusief updates van provider-checkpoints) en bij elke wijziging in het tool-oppervlak — één nieuwe MCP server kan de 'blast radius' meer vergroten dan een modelwissel.
Red teaming toepassen op het model in plaats van op het systeem. Een team test het basissmodel, krijgt een schoon resultaat en lanceert vervolgens een agent met een database-tool en een web fetcher. Het model faalde nooit; het systeem faalt bij de eerste pagina met verborgen instructies.
Detectie behandelen als preventie. Elke injection-detector is een classifier; classifiers hebben false negatives en aanvallers itereren goedkoop. Ga ervan uit dat een injection gebeurt en af en toe slaagt, en beperk wat een gecompromitteerde agent kan doen. Tegen een read-only agent is dat een incidentrapport; tegen een agent met een shell is het een datalek.
De campaign slechts één keer uitvoeren. Een verouderd rapport beschrijft een systeem dat niet meer bestaat: een ander checkpoint, nieuwe MCP servers, een gewijzigde system prompt. En guardrails zien zelden het gehele verzoek — uitsluitingen zijn platformspecifiek, dus vind de jouwe voordat je de controlematrix opstelt.
Eerst de grens, heel helder. De guardrails van TrueFoundry zijn runtime, inline enforcement: ze valideren of muteren inhoud in het verzoekpad en retourneren een beslissing. TrueFoundry levert of documenteert geen offline red-team campaign-tools — geen generatie van aanvallen, geen adversarial corpus, geen geplande scans, geen red-team rapport. In de guardrail-documentatie van de AI Gateway komt "red teaming" feitelijk maar één keer voor, in de OWASP LLM04-richtlijnen waarin wordt aanbevolen dat je "je modellen test tegen bepaalde evaluatie-frameworks en red teaming" — een externe aanbeveling, geen functie. DeepKeep is de partnerpagina waar red teaming naar voren komt als een functionaliteit, en deze is van DeepKeep, geleverd aan de leverancierszijde [VERIFY]. Als je campaigns nodig hebt, koop dan campaigns. Wat volgt is de handhavingshelft.
Guardrails worden gekoppeld aan vier hooks: LLM Input, LLM Output, MCP Tool Pre-Invoke en MCP Tool Post-Invoke.

Het LLM-pad loopt via zeven gedocumenteerde stappen, en stap vier is de interessantste. Input-mutatie draait eerst en blokkeert totdat deze voltooid is. Input-validatie start vervolgens op de achtergrond, parallel met het modelverzoek, zodat het niet ten koste gaat van je time-to-first-token — en als het halverwege faalt, annuleert de gateway het lopende modelverzoek, zodat dit niet in rekening wordt gebracht. Output-mutatie en -validatie draaien synchroon nadat de respons is binnengekomen, dus een output-blokkade kost je nog steeds de model-call.
Twee onafhankelijke instellingen per guardrail. Operation Mode is Validate of Mutate: Validate blokkeert zonder de inhoud aan te raken, Mutate herschrijft de inhoud en kan nog steeds blokkeren, waarbij de uitvoering op prioriteit gaat met het laagste nummer eerst. Enforcement Strategy bepaalt wat er gebeurt bij een overtreding, en afzonderlijk bij een guardrail-fout:
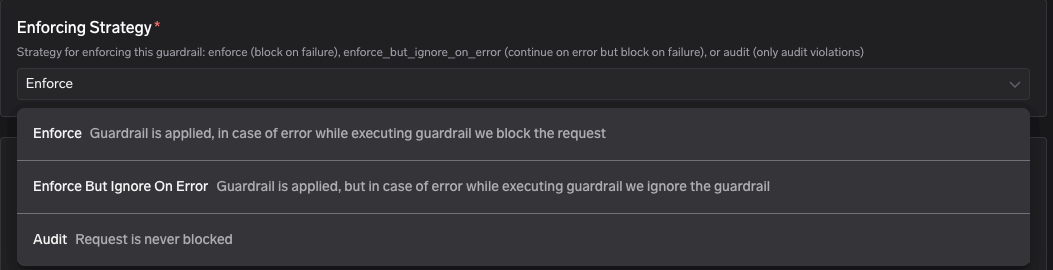
Enforce But Ignore On Error is de fail-open/fail-closed-schakelaar en de meest ingrijpende dropdown op de pagina: een volledige Enforce betekent dat een storing bij een leverancier uw applicatie mee omlaag trekt. De gedocumenteerde ladder is Audit → Enforce But Ignore On Error → Enforce.
Tien guardrails zijn native, volgens de canonieke truefoundry-guardrails-pagina: Secrets Detection, Code Safety Linter, SQL Sanitizer, Regex Pattern Matching, Prompt Injection, PII Detection, Content Moderation, Metadata Validation, Cedar en OPA Guardrails. Eén inconsistentie in de documentatie: de overzichtspagina vermeldt er negen en laat Metadata Validation weg. Gebruik de lijst van tien items.
Drie daarvan draaien op beheerde Azure-services — Content Moderation, PII/PHI Detection en Prompt Injection — en werken alleen wanneer TrueFoundry de gateway host, niet op zelfgehoste of hybride "alleen Gateway Plane"-implementaties. Bring-your-own-key-alternatieven zijn voor elk gedocumenteerd: Prisma AIRS voor injectie, CrowdStrike voor PII, Bedrock Guardrails voor moderatie.
De voor adversarial-beveiliging relevante partners, genoemd op hun eigen documentatiepagina's:
Dat zijn dertien op beveiliging gerichte partners. Wanneer we de judge- en moderatie-integraties toevoegen — Patronus, NVIDIA NeMo, Guardrails AI, Arthur AI, Verra, Azure PII, Azure Prompt Shield, OpenAI Moderations, AWS Bedrock Guardrails — komt het totale aantal per september 2026 uit op ongeveer twintig, plus een custom-guardrail-contract voor al het andere.

Pre-invoke draait synchroon op de toolarguments; bij een fout wordt de tool niet uitgevoerd. Post-invoke draait op het resultaat; bij een fout wordt het resultaat onthouden aan het model. Pre-invoke is waar misbruik van tools stopt — een SQL sanitizer die de argumenten-string leest, een code-safety linter op een uitvoeringstool. Post-invoke is waar indirecte injectie stopt, omdat een toolresultaat niet-vertrouwde inhoud is.
Guardrails draaien op elke tool-call afzonderlijk — vijf tools achter elkaar betekent vijf volledige sets van controles. En X-TFY-GUARDRAILS-SCOPE, die LLM-guardrails beperkt tot de laatste N berichten, is niet van toepassing op MCP-hooks. MCP-tool poisoning en gateway-beveiliging behandelt de kant van de toolbeschrijving.
Het registreren van een guardrail doet niets met live verkeer; een policy koppelt deze. Pad: AI Gateway → Policies → Guardrails → Add Rule, met vier secties — When Request Goes To (modellen, MCP-servers, optioneel specifieke tools), From Subjects (gebruikers, teams, virtuele accounts), With Metadata en Apply on Hooks.
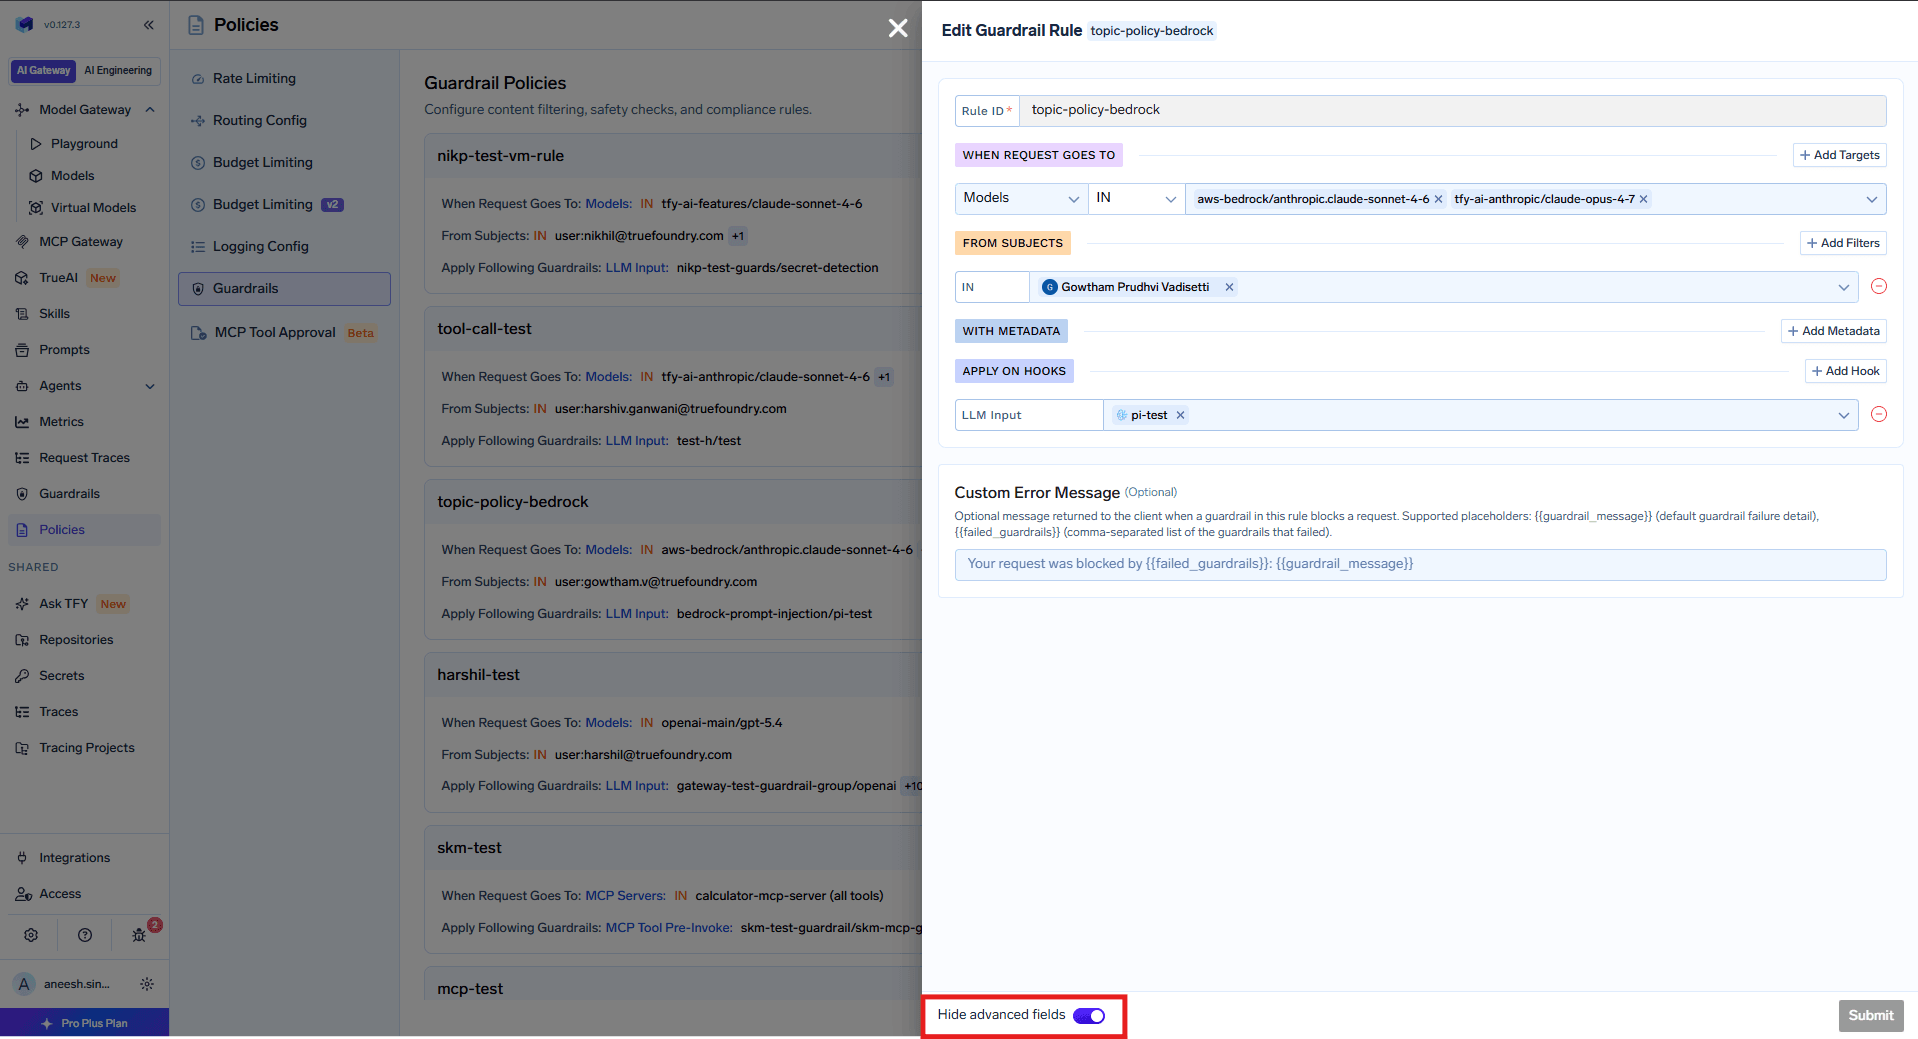
Alle regels worden bij elk verzoek geëvalueerd en de overeenkomstige regels worden per hook samengevoegd (unioned), zodat zowel een permissieve baseline als een strikte productieregel van toepassing is. De X-TFY-GUARDRAILS-header is de enige omzeiling — deze slaat policies volledig over, dus behandel deze als geprivilegieerd.
Eén beperking qua reikwijdte per september 2026: policy-subjects zijn gebruikers, teams en virtuele accounts — geen agents. Policies die zijn gekoppeld aan de agent-identiteit, ketenbewuste voorwaarden die gebruikmaken van delegatiecontext en hooks op de Agent Gateway zelf staan allemaal gedocumenteerd als 'binnenkort beschikbaar'.
De guardrails-weergave van het Metrics Dashboard telt Requests geëvalueerd, Mutated en Flagged (geblokkeerd), en toont verzoeken per seconde grafisch op basis van resultaat — toegestaan, geblokkeerd, gemuteerd, audit_mode_blocked — block- en mutate-percentage per guardrail, en latentie op P50 / P75 / P90 / P99, te filteren op Guardrails, Users, Virtual Accounts of Teams.
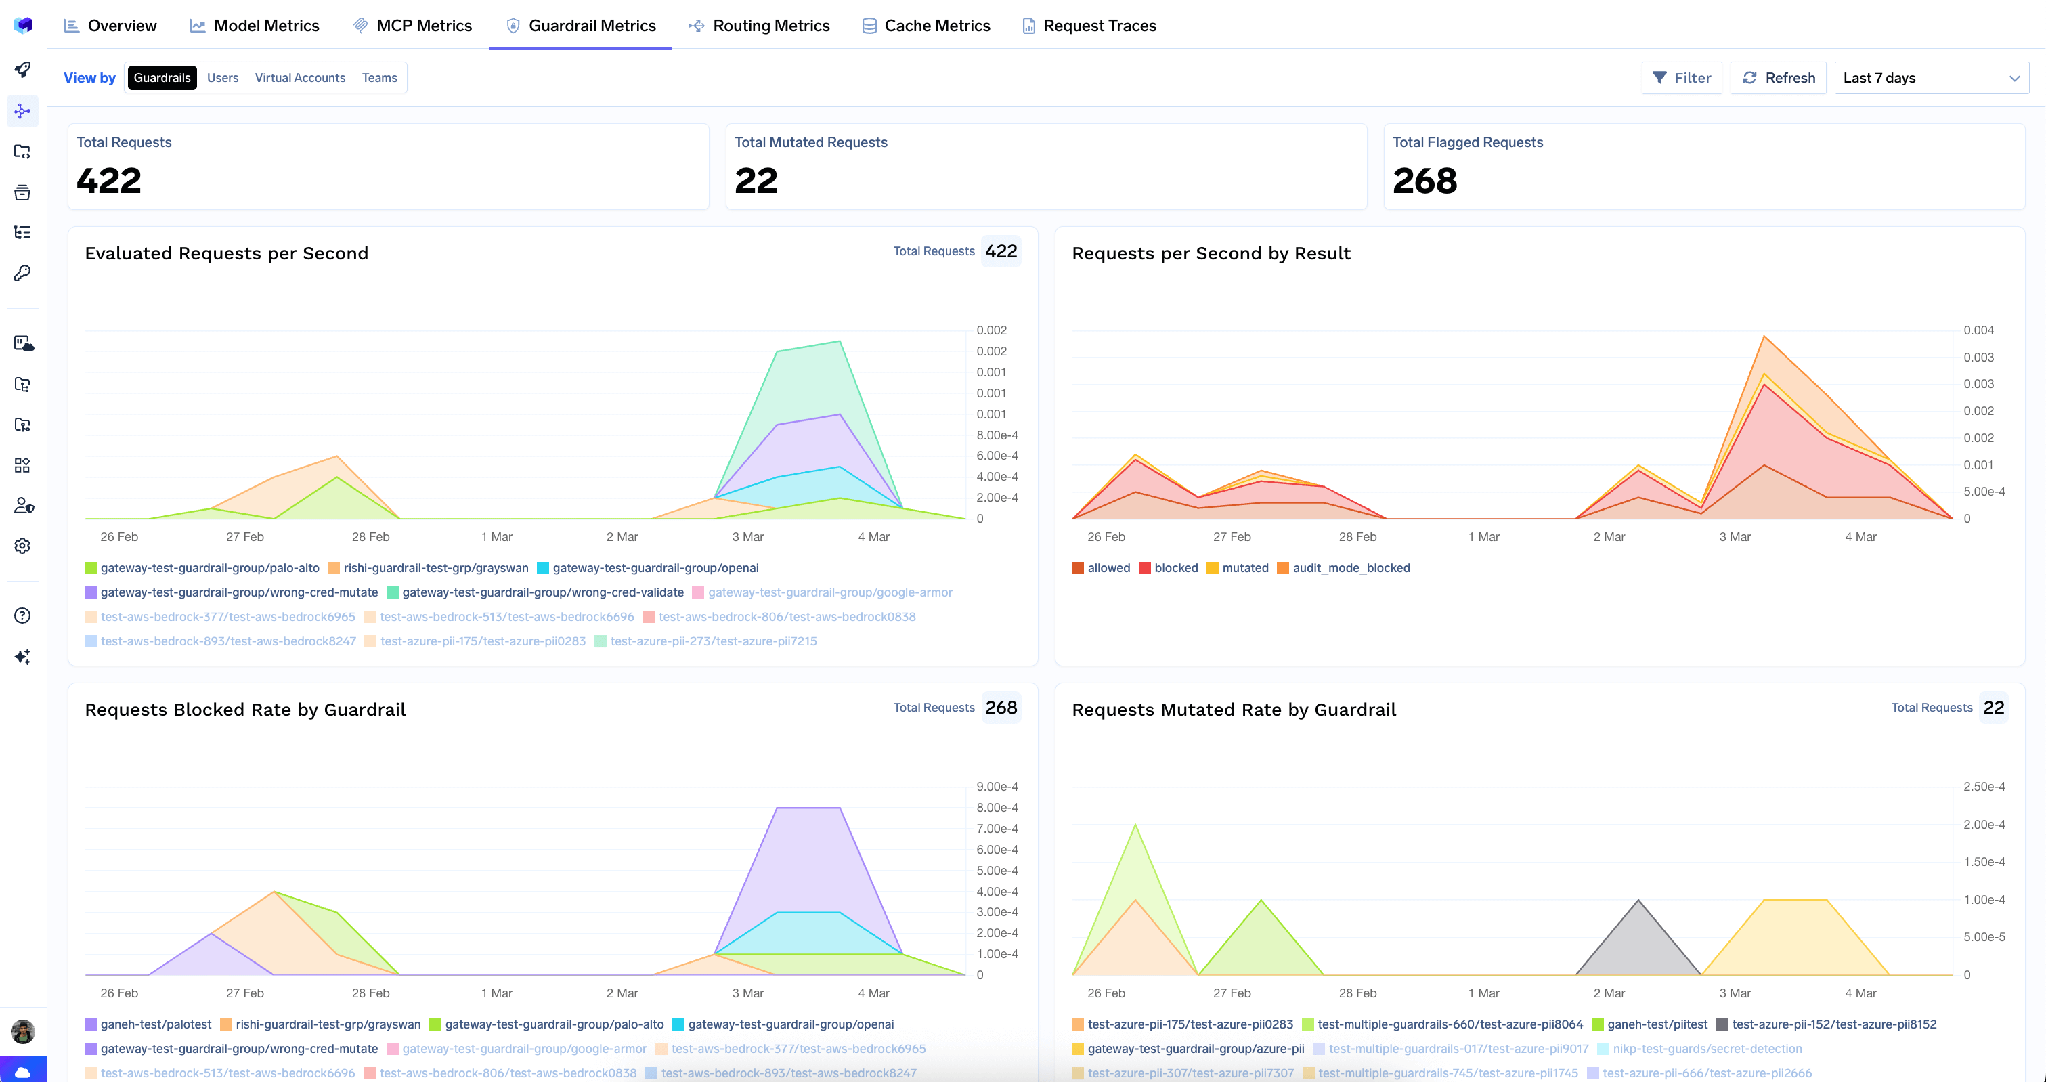
audit_mode_blocked is wat een uitrol op basis van Audit effectief maakt: het telt wat geblokkeerd z Zou zijn geweest, zodat u de impact kunt inschatten voordat u overgaat tot handhaving.
Een campagne tegen een klantenservice-agent levert drie bevindingen op: een indirecte injectie in een kennisbankartikel zorgt ervoor dat de agent een interne tool aanroept die hij niet zou mogen gebruiken; de agent echoot het telefoonnummer van een klant in een samenvatting; één geformuleerde vraag leidt tot een lus van twaalf tools.
Koppel bevindingen aan hooks. De gedocumenteerde baseline voor agent-verkeer is de uitgangsvorm: PII-redactie (Mutate) en prompt-injection-detectie (Validate) op de invoer; secrets-detectie op de uitvoer; SQL-sanitizer en code-safety linter voor de tool; PII- en secrets-redactie na de tool. Voor de injectiebevinding is de doorslaggevende hook post-tool, waar het geïnfecteerde artikel de context binnendringt.
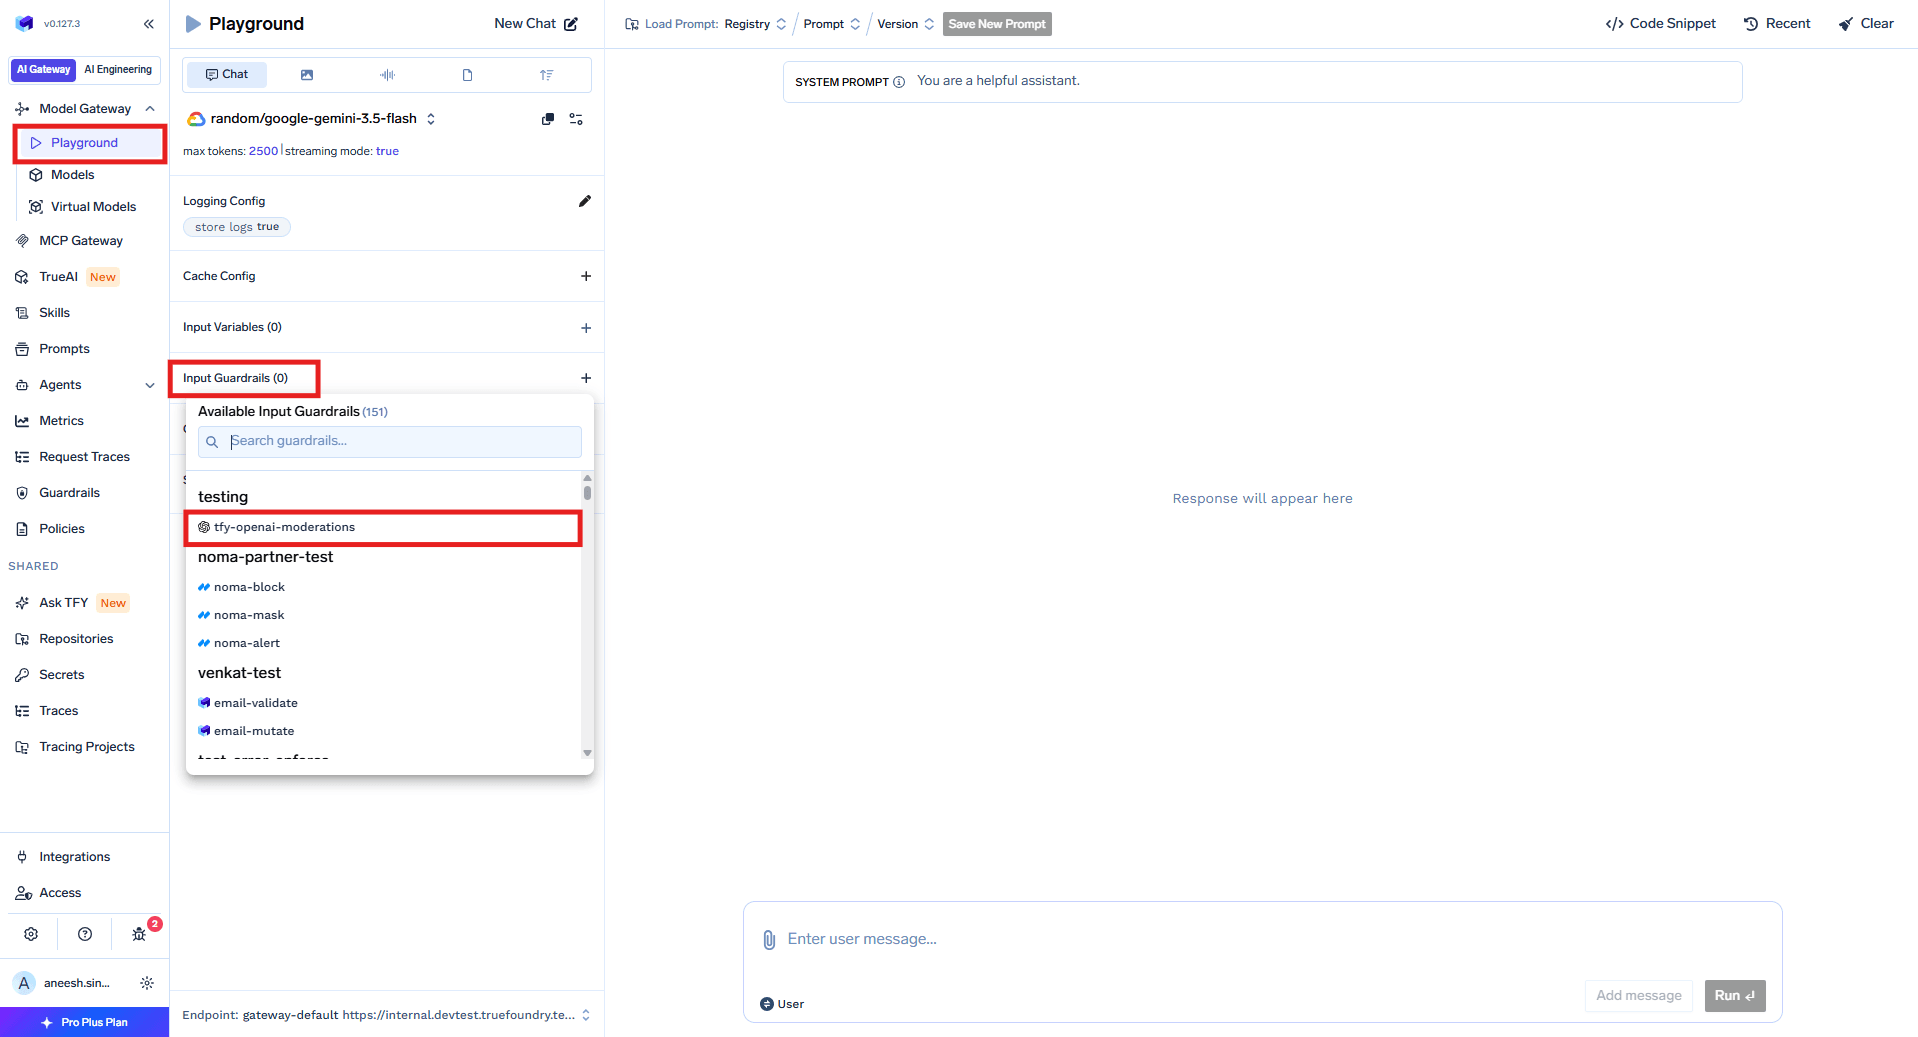
Test eerst in de Playground. Alle vier de hooks kunnen worden getest via AI Gateway → Playground; de knop Code genereert een snippet waarin X-TFY-GUARDRAILS al is ingevuld.
Koppel een policy in Audit, afgestemd op de modellen en MCP-servers van deze agent, en laat dit een week staan — een detector die afgaat op 8% van de legitieme tickets kunt u nog niet afdwingen. Promoveer vervolgens naar Enforce But Ignore On Error en stel een Custom Error Message in, achter de schakelaar Hide advanced fields, met ondersteuning voor {{guardrail_message}} en {{failed_guardrails}}.
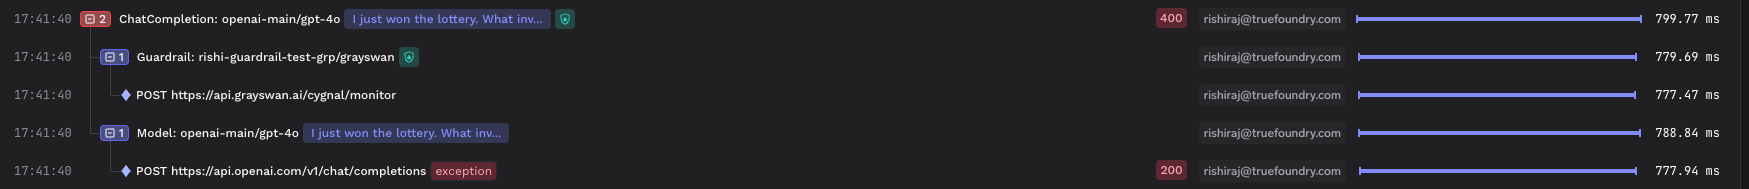
Verifieer in traces. Elke guardrail is een eigen span in Monitor → Request Traces, met uitvoeringstijd, resultaat, scope en mutaties. Blokkades retourneren HTTP 400 met error.type = "guardrail_checks_failed".

Los de spons-bevinding elders op. De lus van twaalf tools is een probleem van rate-limiting en budget. Geen enkele guardrail beschermt u tegen een lus die bij elke iteratie correct is geformuleerd.
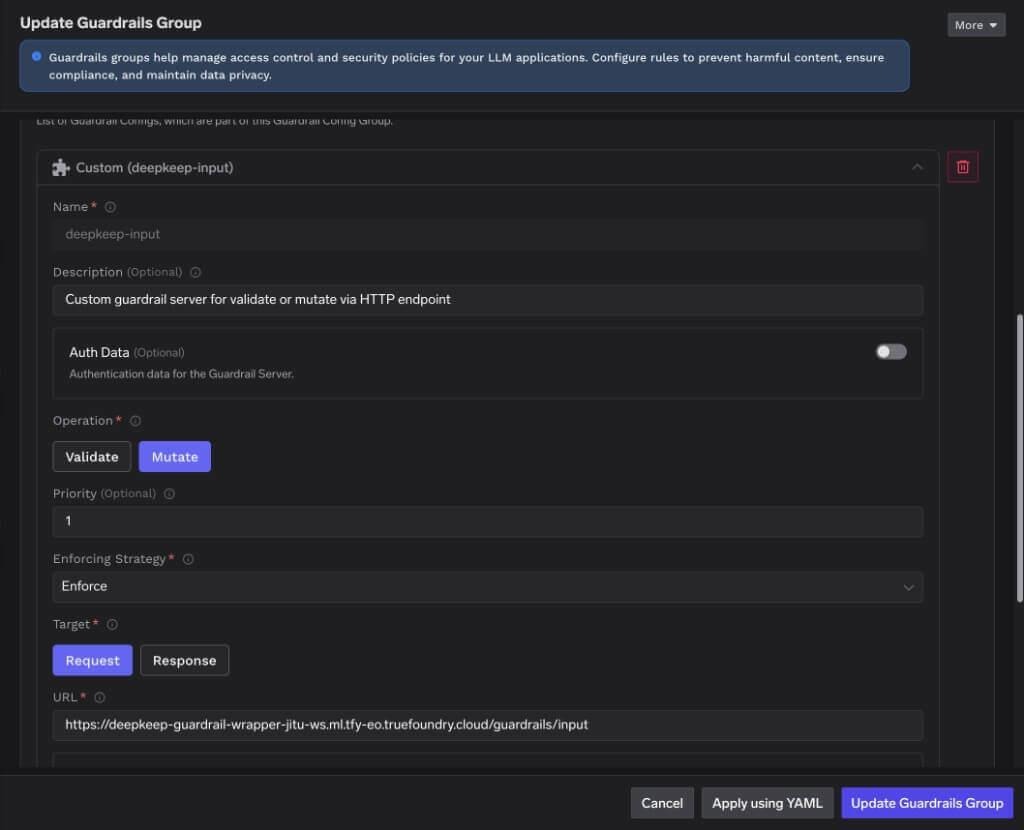
De volgorde van guardrails kan een blokkade veranderen in een goedkeuring. DeepKeep past de prioriteit toe op basis van de eerst vermelde regel die is geactiveerd — niet de meest strenge actie. Als u de PII Detector vóór Adversarial Prompt Defense plaatst, wordt een jailbreak die ook PII bevat geanonimiseerd en toegestaan in plaats van geblokkeerd: de anonymisering wint omdat deze als eerste stond vermeld, en de jailbreak komt erdoorheen met een afgeschermd telefoonnummer. De gedocumenteerde oplossing is de aanbevolen volgorde — Credentials Leakage → PII → Adversarial → Toxic — en nog beter is de splitsing in twee firewalls: Adversarial Prompt Defense alleen op de pre-firewall, credentials en PII op de post-firewall.
Uitvoer-guardrails worden overgeslagen bij streaming-antwoorden. Met stream: true draaien ze helemaal niet, omdat het evalueren van een antwoord de volledige tekst vereist. Invoer-guardrails draaien altijd. Aangezien bijna elke chatinterface standaard streamt, schakelt dit beveiligingen aan de uitvoerkant uit waar gebruikers ze zien.
System prompts worden nooit geïnspecteerd. De gateway verwijdert ze voordat inhoud naar een guardrail wordt gestuurd; CrowdStrike AIDR is de enige gedocumenteerde uitzondering, en deze wijzigt ze nooit. "We scannen de gehele prompt" is geen claim die u kunt maken.
Als u uw eigen detector schrijft, retourneer dan 2xx. Het contract voor custom-guardrails is expliciet: HTTP 2xx betekent dat de guardrail volledig is uitgevoerd, met het resultaat in de body als verdict: false. Het signaleren van een blokkade met een 400 is de gedocumenteerde foutmodus — de gateway kan dit lezen als een fout en het verzoek alsnog doorlaten.
Twee helften die elkaar nodig hebben. Campagnes vinden: episodisch, duur, de enige manier om een foutklasse te ontdekken waarvoor niemand een detector heeft geschreven. Handhaving behoudt: continu, goedkoop per verzoek, waardeloos tegen een aanval die niemand erin heeft beschreven. Een programma met alleen de eerste levert rapporten op; een programma met alleen de tweede is vol vertrouwen over de verkeerde dingen.
TrueFoundry bevindt zich duidelijk in de tweede helft, en we zeggen dat liever eerlijk dan dat we het anders suggereren. De gateway biedt één centrale plek om de bevindingen af te dwingen voor elke model-, team- en MCP tool-call. Waar het ophoudt, is bij het genereren van de aanvallen. Als een leverancier zegt dat hun firewall red teaming overbodig maakt, vraag dan op welke aanvalsklassen hun detectoren zijn getraind en wanneer — voer de campagne vervolgens toch uit en dwing af wat eruit komt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Adversarial testing of an AI system — model, prompts, retrieved context and tools together — to find inputs that make it act against your intent. The classes are jailbreaks, direct and indirect prompt injection, data exfiltration, tool abuse, and resource-exhaustion “sponge” attacks. It differs from penetration testing because the attack surface is natural language, results are probabilistic, and a model upgrade can reopen a class you closed.
No. An LLM firewall is runtime enforcement: inline guardrails inspecting, rewriting or blocking on every request. Red teaming is offline discovery: campaigns that generate attacks and report what worked. Campaigns tell you what to enforce; enforcement makes the finding stop costing you.
Niet in de campagnezin. Het biedt de helft die runtime-handhaving vormt: guardrails op vier hooks, tien native ingebouwde functies, ongeveer twintig partnerintegraties, beleidskoppeling per model, MCP-server, tool, gebruiker, team of virtueel account, en metrics per guardrail. Het documenteert geen aanvalgeneratie, een adversarieel corpus, geplande scans of red-team-rapportage. Verschillende partners zijn beveiligingsleveranciers met hun eigen campagnegerichte mogelijkheden.
Yes. TrueFoundry runs in your VPC, on-prem, air-gapped, or hybrid, so prompts and responses never leave your domain even as you route across many providers.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP & Agents Register met toegangscontrole op toolniveau. Agents op LangGraph, CrewAI, AutoGen, of een aangepast framework kunnen allemaal centraal worden gereguleerd.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Het traceert elk verzoek van prompt tot tool- en modeluitvoering, zodat u uniforme logging krijgt zonder wat u al draait te hoeven vervangen.



Het laatste nieuws, artikelen en bronnen in je inbox



















