



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Een betalings-API is eenvoudig te observeren omdat hij saai is. Dezelfde invoer leidt tot hetzelfde codepad, dus drie getallen — request-rate, foutpercentage, duur — vertellen je bijna alles. Wanneer er iets misgaat, lees je een stacktrace, en een stacktrace is een feit over het programma, geen gok naar de intentie.
Een agent doorbreekt elke aanname in die zin. Het model kiest het pad tijdens runtime, dus dezelfde invoer leidt niet tot hetzelfde codepad. Vaak is er helemaal geen foutmelding: de agent voltooit zijn taak, retourneert tekst en elke HTTP-call die hij maakte gaf een 200 terug. En wat er misging is meestal geen crash, maar een beslissing — hij koos de verkeerde tool, las een bestand dat hij al had opnieuw in, of bleef een zoekopdracht herhalen die nooit kon slagen.
De vraag verschuift dus: niet was hij online, maar waarom deed hij dat. En "waarom" is een eigenschap van de gehele reeks, niet van een afzonderlijke request — dat is waarom een dashboard er gezond uit kan zien terwijl je agent faalt. Een P99-latency van 900 ms over alle model-calls vertelt je niets over een run die er 140 heeft uitgevoerd.
De data heeft vier geneste niveaus, waarvan alleen de onderste twee lijken op een conventionele request.
De middelste twee niveaus bevatten de echte waarde, en dat zijn precies de twee die een request-scoped tracer niet modelleert. Die ziet een verzameling uitgaande calls zonder betekenisvolle parent, en kan je niet vertellen dat calls 11 tot en met 27 één turn waren die zeven keer hetzelfde probeerde.
Eén eigenschap maakt dit wezenlijk anders dan distributed tracing: elk niveau kan lussen (looping). Er is geen equivalent in een normale service-graph — A roept B aan roept C aan, en als A ooit zichzelf aanroept, heb je een bug. Bij een agent is een stap die besluit zichzelf opnieuw aan te roepen het normale geval, en de enige manier om een productieve lus te onderscheiden van een vastgelopen lus, is door de reeks te lezen.
Elk niveau heeft zijn eigen signalen nodig. Alles overal verzamelen levert data op zonder inzicht, dus dit is het minimum dat zijn waarde bewijst.
De laatste cel is het signaal met het hoogste rendement in agent observability, en bijna niemand legt het vast: dezelfde tool die twee keer wordt aangeroepen met dezelfde argumenten binnen één turn is een lus. Trivial zodra argumenten op de span staan. Onmogelijk op basis van geaggregeerde metrics.
Drie patronen dekken bijna elk incident in productie af.
1. De stille retry-loop. Een agent zoekt in een kennisbank, krijgt niets nuttigs, herformuleert, zoekt opnieuw — twintig keer. Elke zoekopdracht geeft 200 terug in 300 ms, dus dashboards voor request-rate en foutpercentages tonen alleen een kleine verkeerspiek en verder niets. Op sessieniveau is het onmisbaar: een turn-count van één, een tool-call count van twintig, een duur van twee minuten. De diagnose zit in geen enkele afzonderlijke span; het zit in de herhaling.
2. De tool die slaagt terwijl hij troep retourneert. Een tool voor het ophalen van documenten stuit op een reichtenbarrière en retourneert een nette 200 waarvan de body een HTML-inlogpagina is. Het model leest dit en rapporteert dat een dergelijk beleid niet bestaat. Nul fouten, nergens. De enige manier om dit te vangen is door het ruwe resultaat vast te leggen — wat verklaart waarom het vastleggen van resultaten, en niet alleen statuscodes, een basiseis is.
3. De 40x run. De mediane sessiekosten zijn $0,04; één sessie kostte $1,60, en er is niets misgegaan. Eén enkele stap las een groot bestand opnieuw in de context, dat bestand reisde mee in elke opeenvolgende turn, en de input-tokens stapelden zich op voor de rest van de run. Je vindt dit door sessies te sorteren op kosten en de token-aantallen per turn van de outlier te lezen totdat je de stapsgewijze verandering ziet. Nooit in een gemiddelde.
Het patroon in alle drie de gevallen: de anomalie is een relatie tussen stappen. Een tool die stappen onafhankelijk van elkaar opslaat, heeft precies datgene weggegooid wat je nodig hebt.
Dit is vast te leggen zonder je agent-code te instrumenteren, omdat handhaving en observatie op één plek plaatsvinden. Elke model- en tool-call gaat door een gateway, dus het traject wordt vastgelegd als een bijproduct van het bedienen ervan — niets hoeft te worden gereconstrueerd uit verspreide logs, en er is geen opt-out.
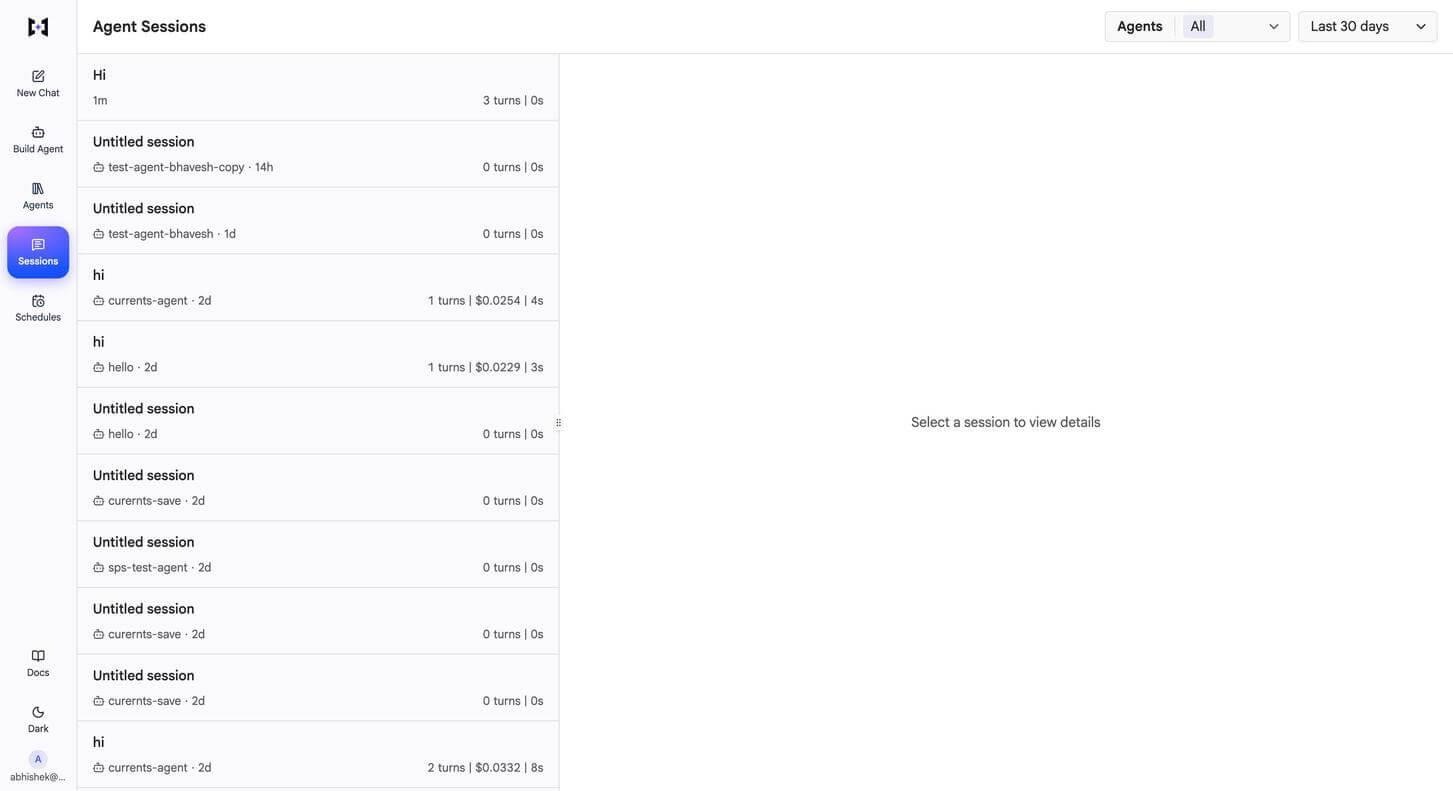
Voor agents op de TrueFoundry agent harness toont Sessions elke conversatie over alle agents heen — openingsbericht, agent, turn-count, kosten, duur. Genoeg om te scannen op dure of te lange runs zonder iets te hoeven openen, wat precies is wat foutmodus 3 vereist.
Het openen van een sessie biedt alle drie de zaken waar de hiërarchie om vraagt. Geaggregeerde metrics dekken turns, duur, kosten, tokens, context, tool-calls, sub-agents en fouten af. Een tijdlijn per gebeurtenistype verdeelt de run in segmenten voor systeem, gebruiker, model en tool-calls per turn — een turn gedomineerd door tool-call-kleuren is tool-gebonden, een turn gedomineerd door model-kleuren is model-gebonden, in één oogopslag zichtbaar in plaats van berekend. Daaronder bevindt zich het transcript, met tokens, duur en kosten per turn, en een uitvouwbaar agent steps-paneel waarin tool-calls op volgorde met hun resultaten worden opgesomd.
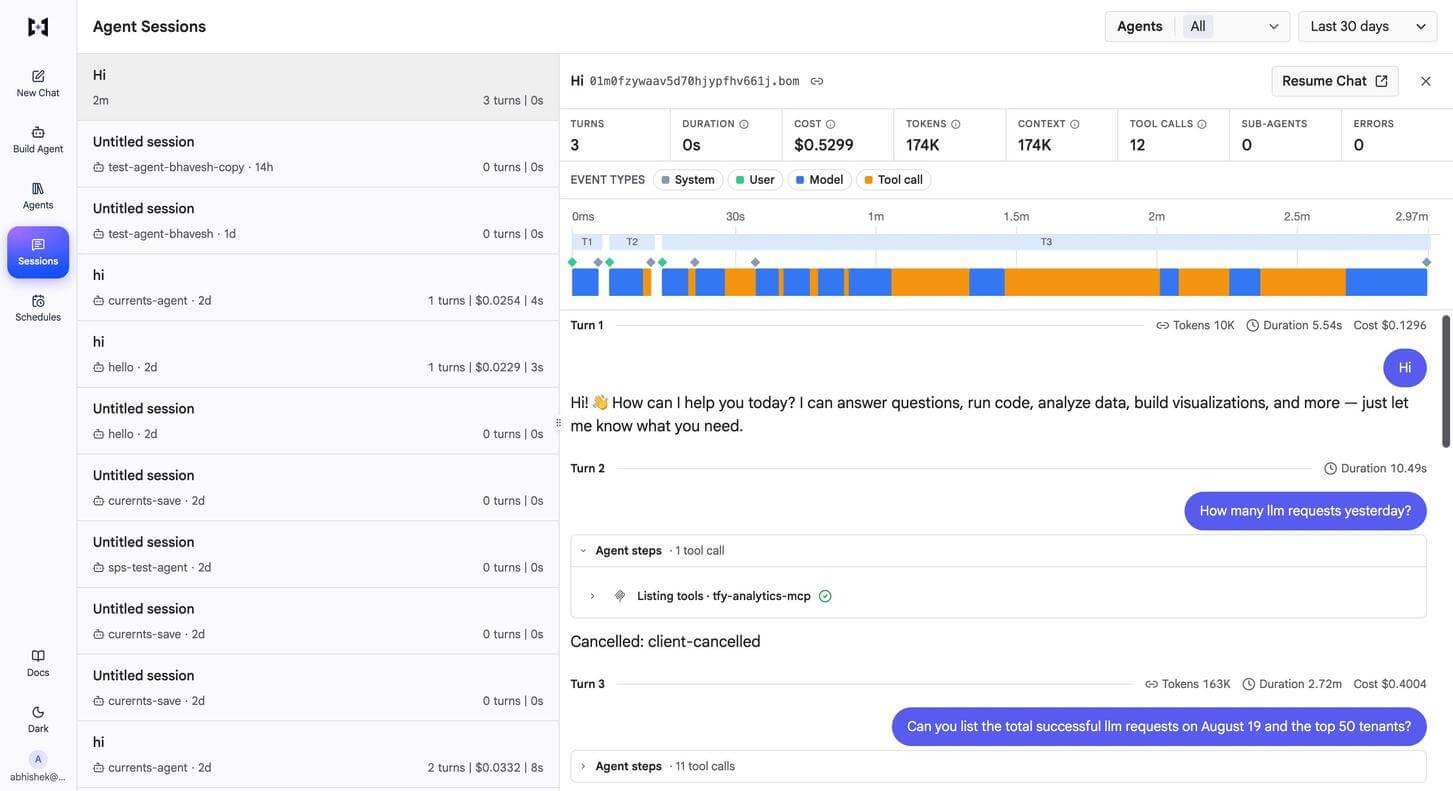
Die geordende stappenlijst is de plek waar een geannuleerde turn, een falende MCP-server of een leeg tool-resultaat zichtbaar wordt. Een sessie kan vanuit dezelfde weergave worden hervat als een live chat — de manier om een fix te verifiëren.
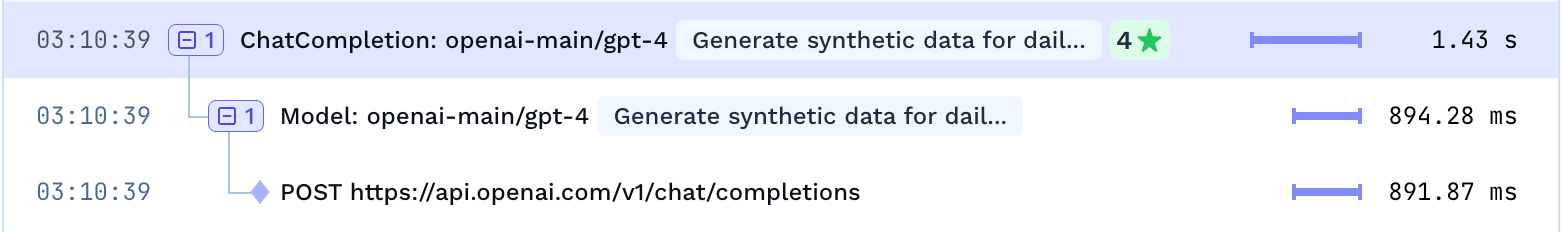
Eén niveau lager is een trace een echte span-hiërarchie, geen platte log. Eén enkele chat completion waaraan een PII-guardrail is gekoppeld, levert vijf spans op: een ChatCompletion root zonder parent, een Guardrail span eronder, de uitgaande call van de guardrail daaronder, een Model span, en de uitgaande call van het model daaronder.
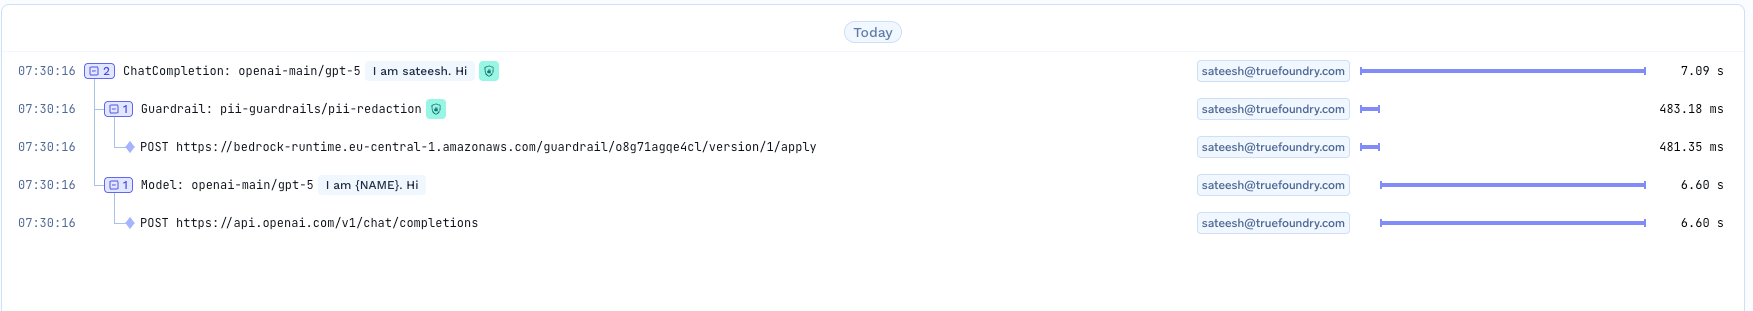
Span-attributen maken kosten en latency toewijsbaar in plaats van geschat. De root-span bevat tfy.model.metric.cost_in_usd, input_tokens, output_tokens, latency_in_ms, time_to_first_token_in_ms en inter_token_latency_in_ms, naast tfy.input, tfy.output en tfy.triggered_guardrail_fqns, en elke span registreert het subject dat deze heeft aangemaakt. Spans zijn opvraagbaar: client.traces.query_spans(...) met een trace_ids-filter en een tijdsvenster retourneert de gehele hiërarchie, gepagineerd — dit is hoe je van "deze sessie was duur" naar "deze span was duur" navigeert.
De uitvoering van een guardrail verschijnt als een eigen span met resultaat, latency en bevindingen, en ook geblokkeerde requests worden getracet — een geweigerde call is bewijsmateriaal, geen gat in de data.

Aggregaties bevinden zich in het Metrics Dashboard. Model Metrics bevat input- en output-tokens, aantal requests en totale kosten, plus doorvoer, foutpercentage en een uitsplitsing van fouten per fouttype. Latency wordt weergegeven op P50, P75, P90 en P99 over vier metingen — end-to-end latency, time to first token, inter-token latency, time per output token — wat van belang is omdat een trage eerste token en een trage token-stream verschillende oorzaken hebben.
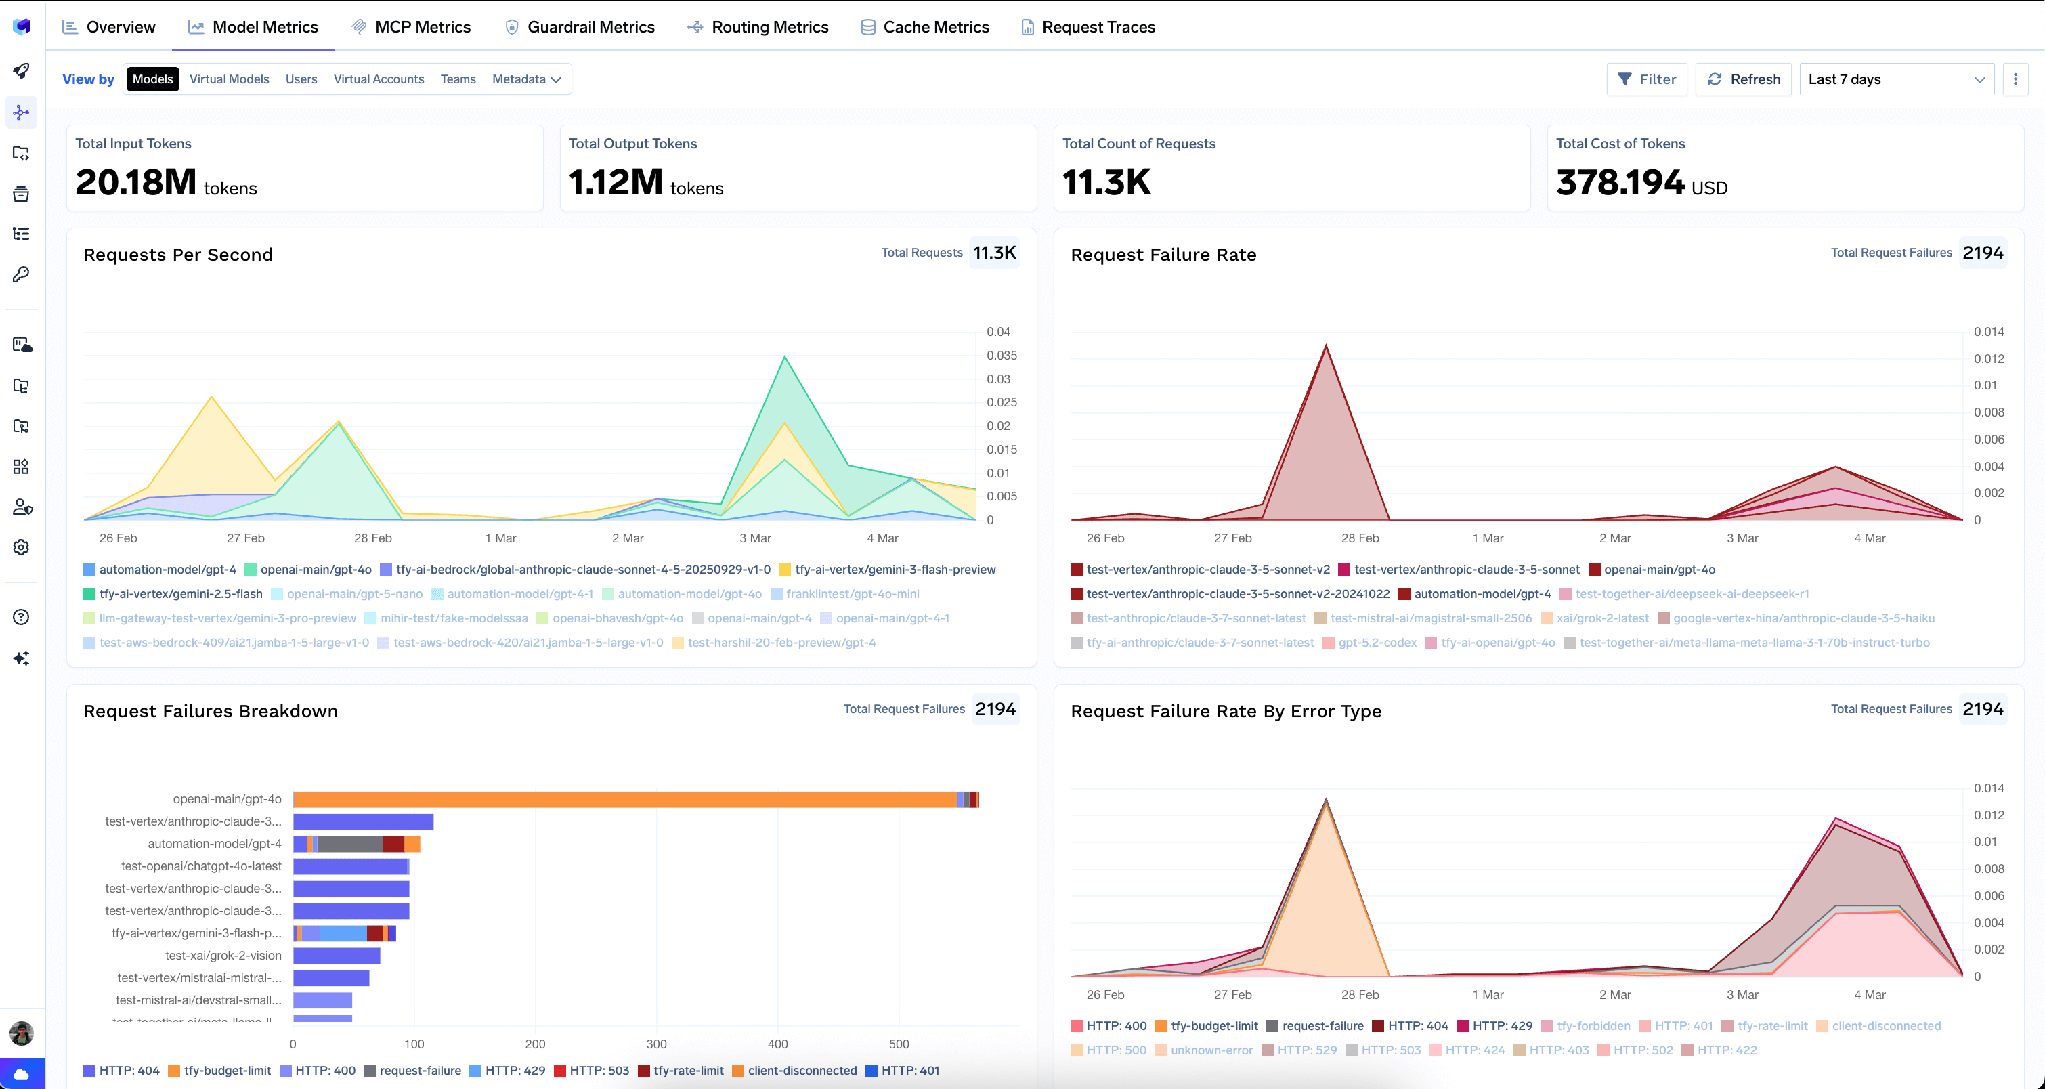
Elke grafiek kan worden aangepast via een View by-selector — models, virtual models, users, virtual accounts, teams, of aangepaste metadata-sleutels die als request-headers worden meegezonden. Plan vroegtijdig voor metadata: stuur een agentnaam of run ID mee en je krijgt kosten- en latency-weergaven per agent zonder iets te hoeven bouwen.
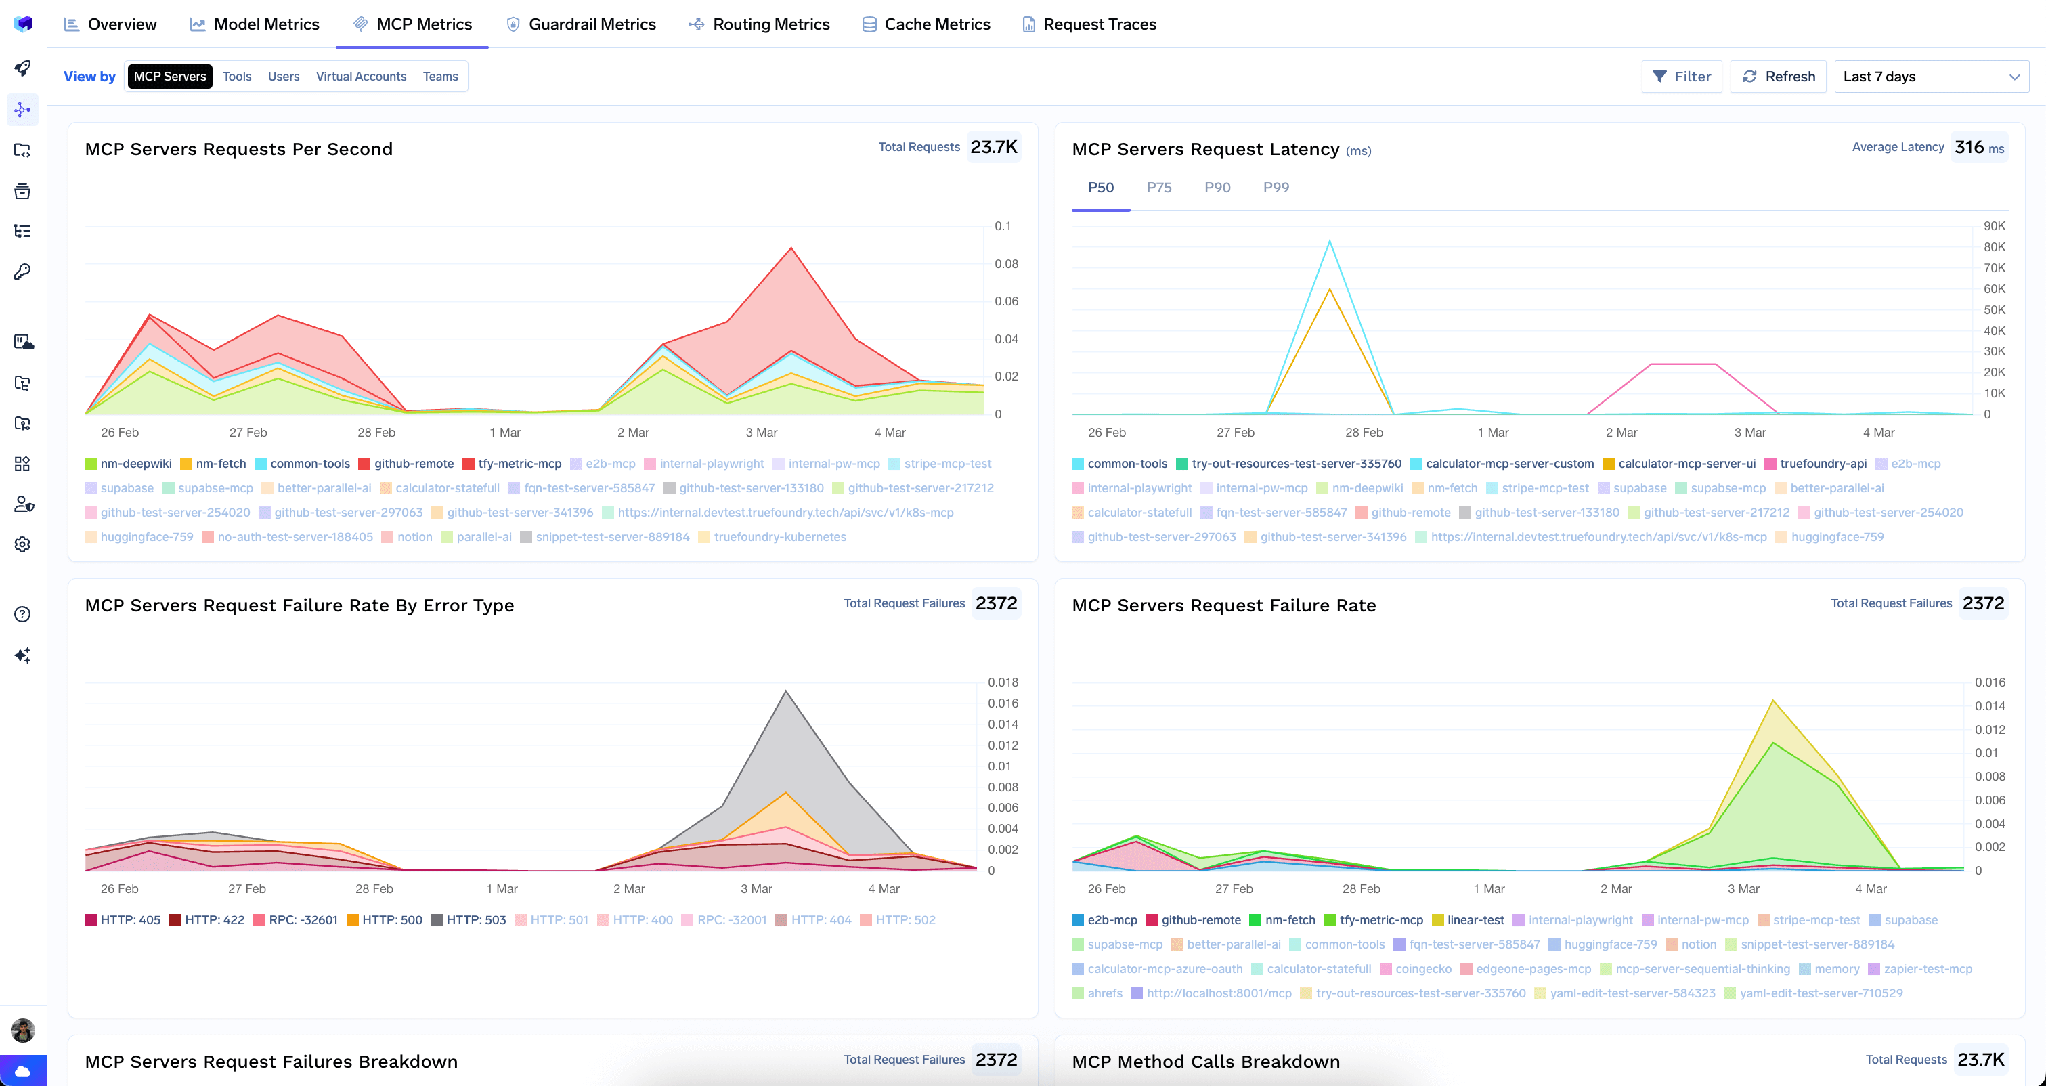
Tool-calls krijgen dezelfde behandeling via MCP-metrics — het gedeelte dat de meeste LLM-gerichte setups overslaan. De servers-weergave biedt doorvoer per server, latency-percentielen, foutpercentages en een fouten-uitsplitsing, plus een method calls breakdown over tools/list, tools/call, resources/list en de rest. Een agent die requests verspilt aan herhaalde tools/list-aanroepen heeft een discovery-probleem, geen taak-probleem.
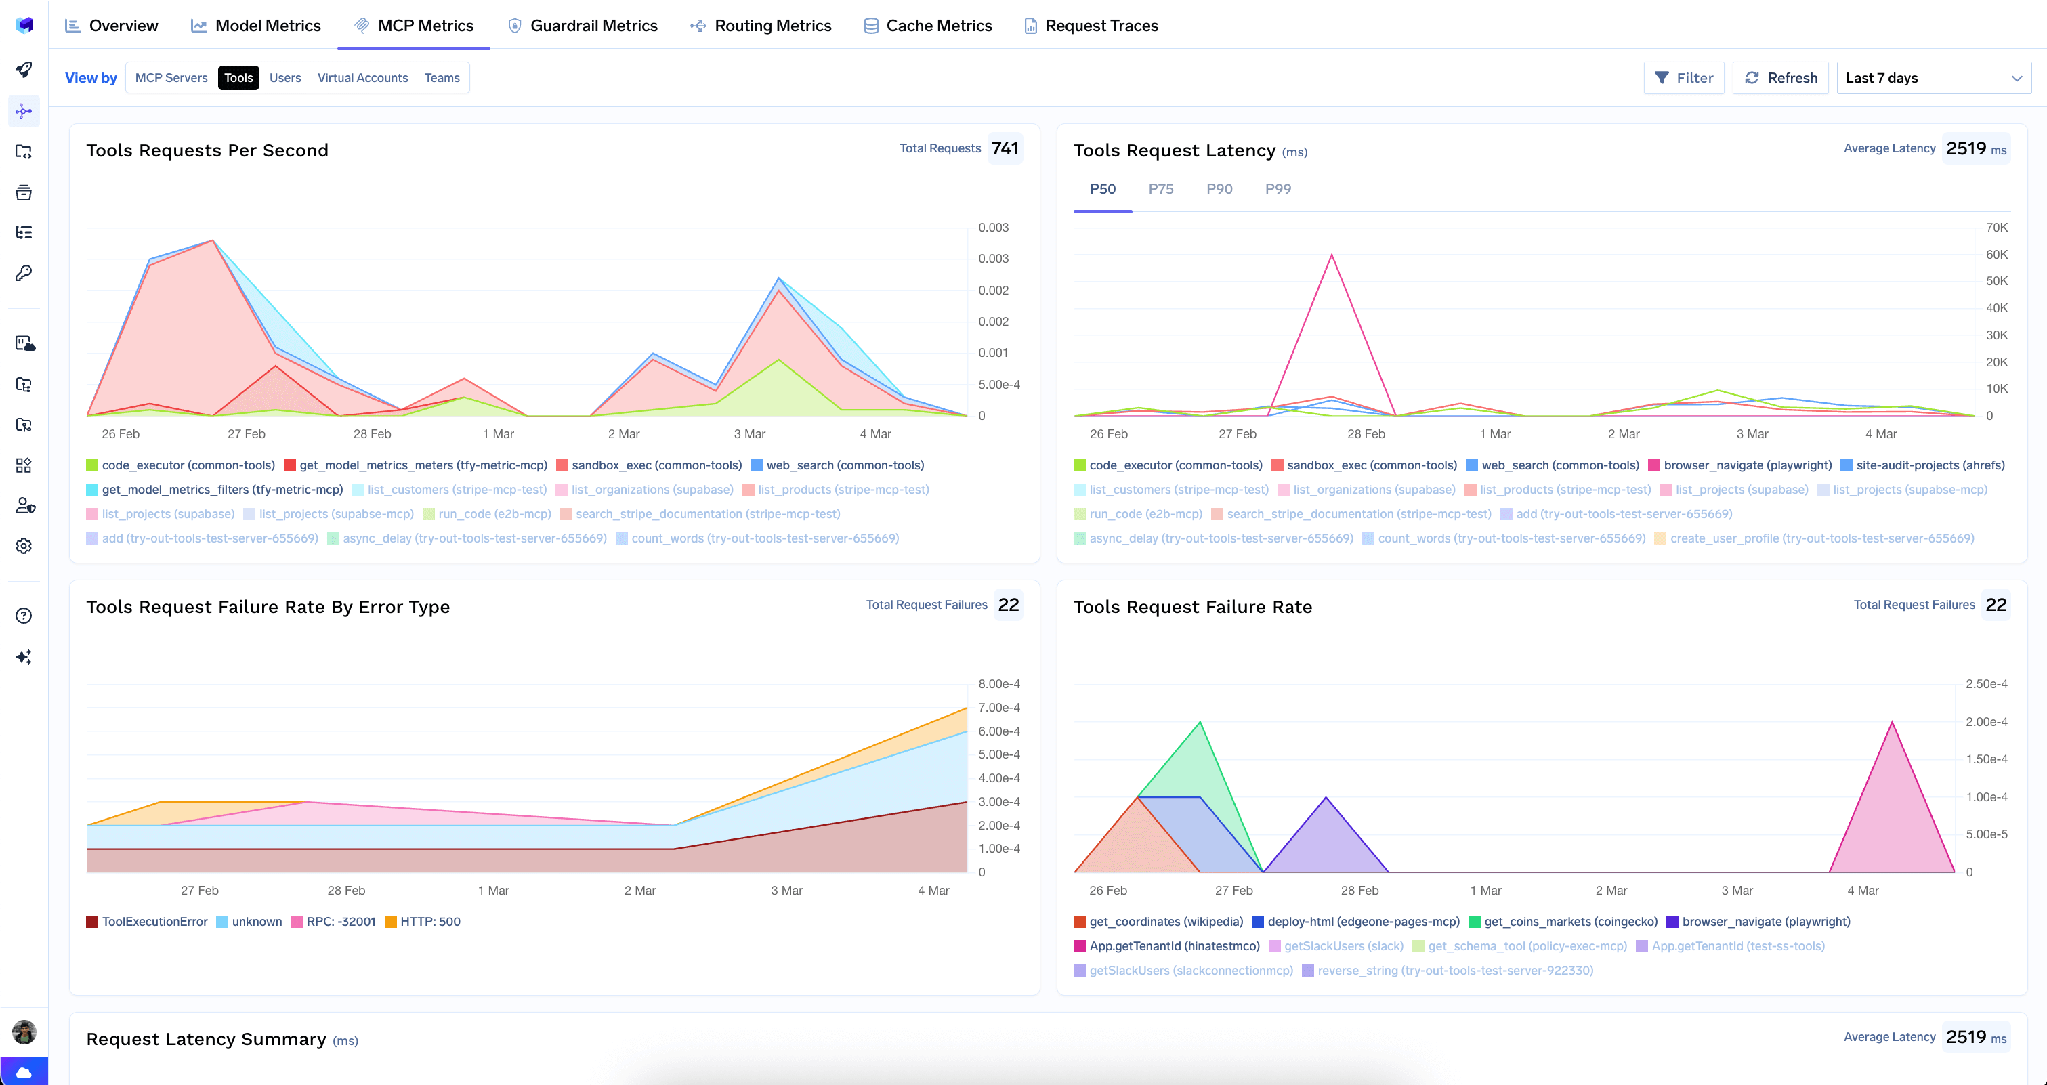
De Tools-weergave zoomt in op individuele tools over alle servers heen: requests per seconde, latency-percentielen, foutpercentage per fouttype, een vergelijkend latency-overzicht en tools gerangschikt op request-aantal. Die rangschikking is de snelste manier om een tool te spotten waar de agent zwaarder op leunt dan verwacht.
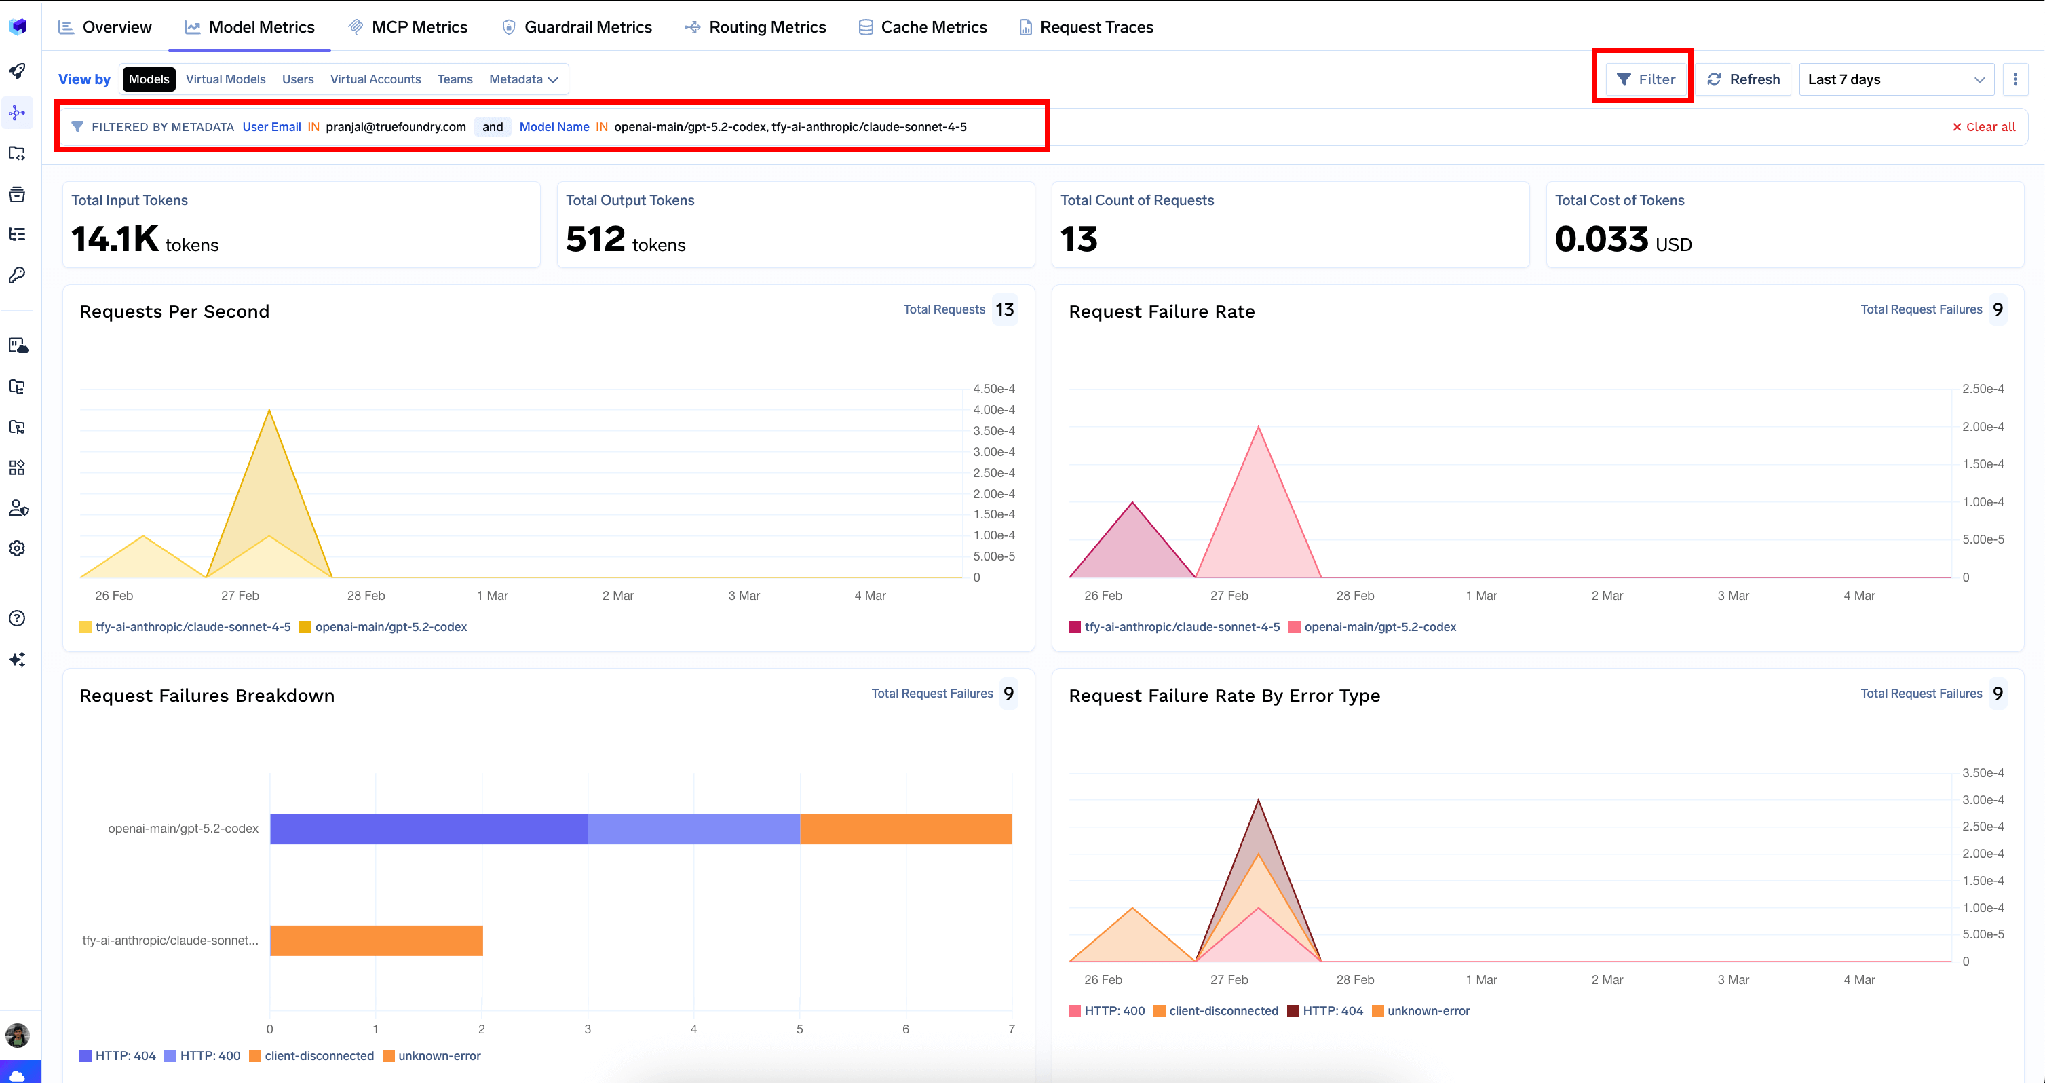
Filters blijven behouden over tabbladen heen, dus als je op het model-tabblad filtert op één gebruiker, blijft dat filter actief wanneer je overschakelt naar MCP — zo stel je vast of trage sessies worden veroorzaakt door het model of door een tool, zonder de query opnieuw te hoeven opbouwen.
Geregistreerde agents krijgen één dashboard dat request-aantallen, latency-percentielen, foutpercentages en gebruik in de loop van de tijd dekt — identiek of de agent nu draait op Bedrock, LangGraph of een aangepaste service.
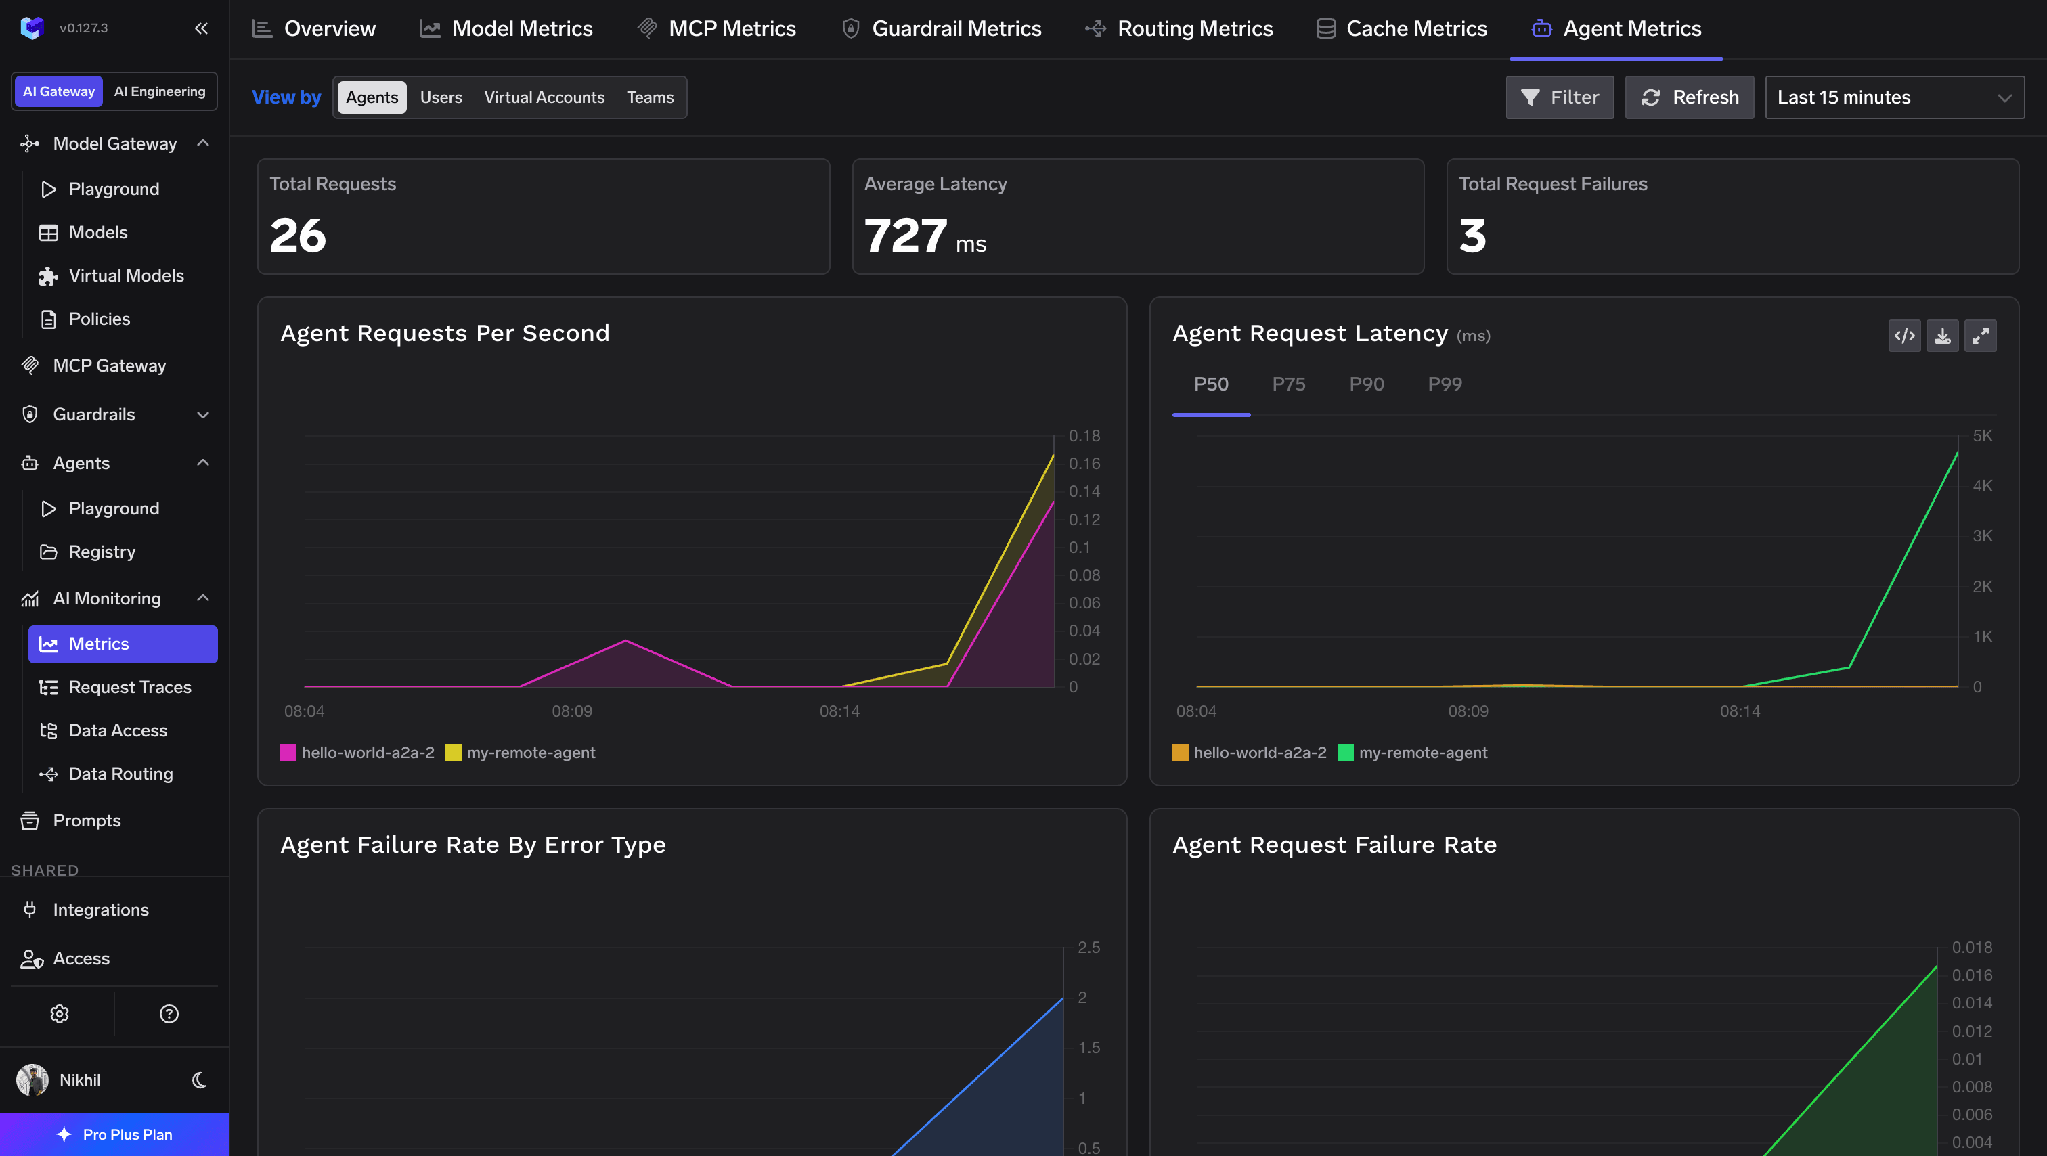
Dezelfde data is opvraagbaar: de metrics API biedt een agentMetrics-databron die distributie- of tijdsreeksresultaten retourneert, gegroepeerd op agentName, agentFramework of agentServerType, met percentielaggregaties op latencyMs. In multi-agent systemen legt Request Traces vast welke agent elke call heeft gemaakt en voor welke gebruiker deze handelde — de attributie die de tool-call van een sub-agent herleidbaar maakt naar een persoon.
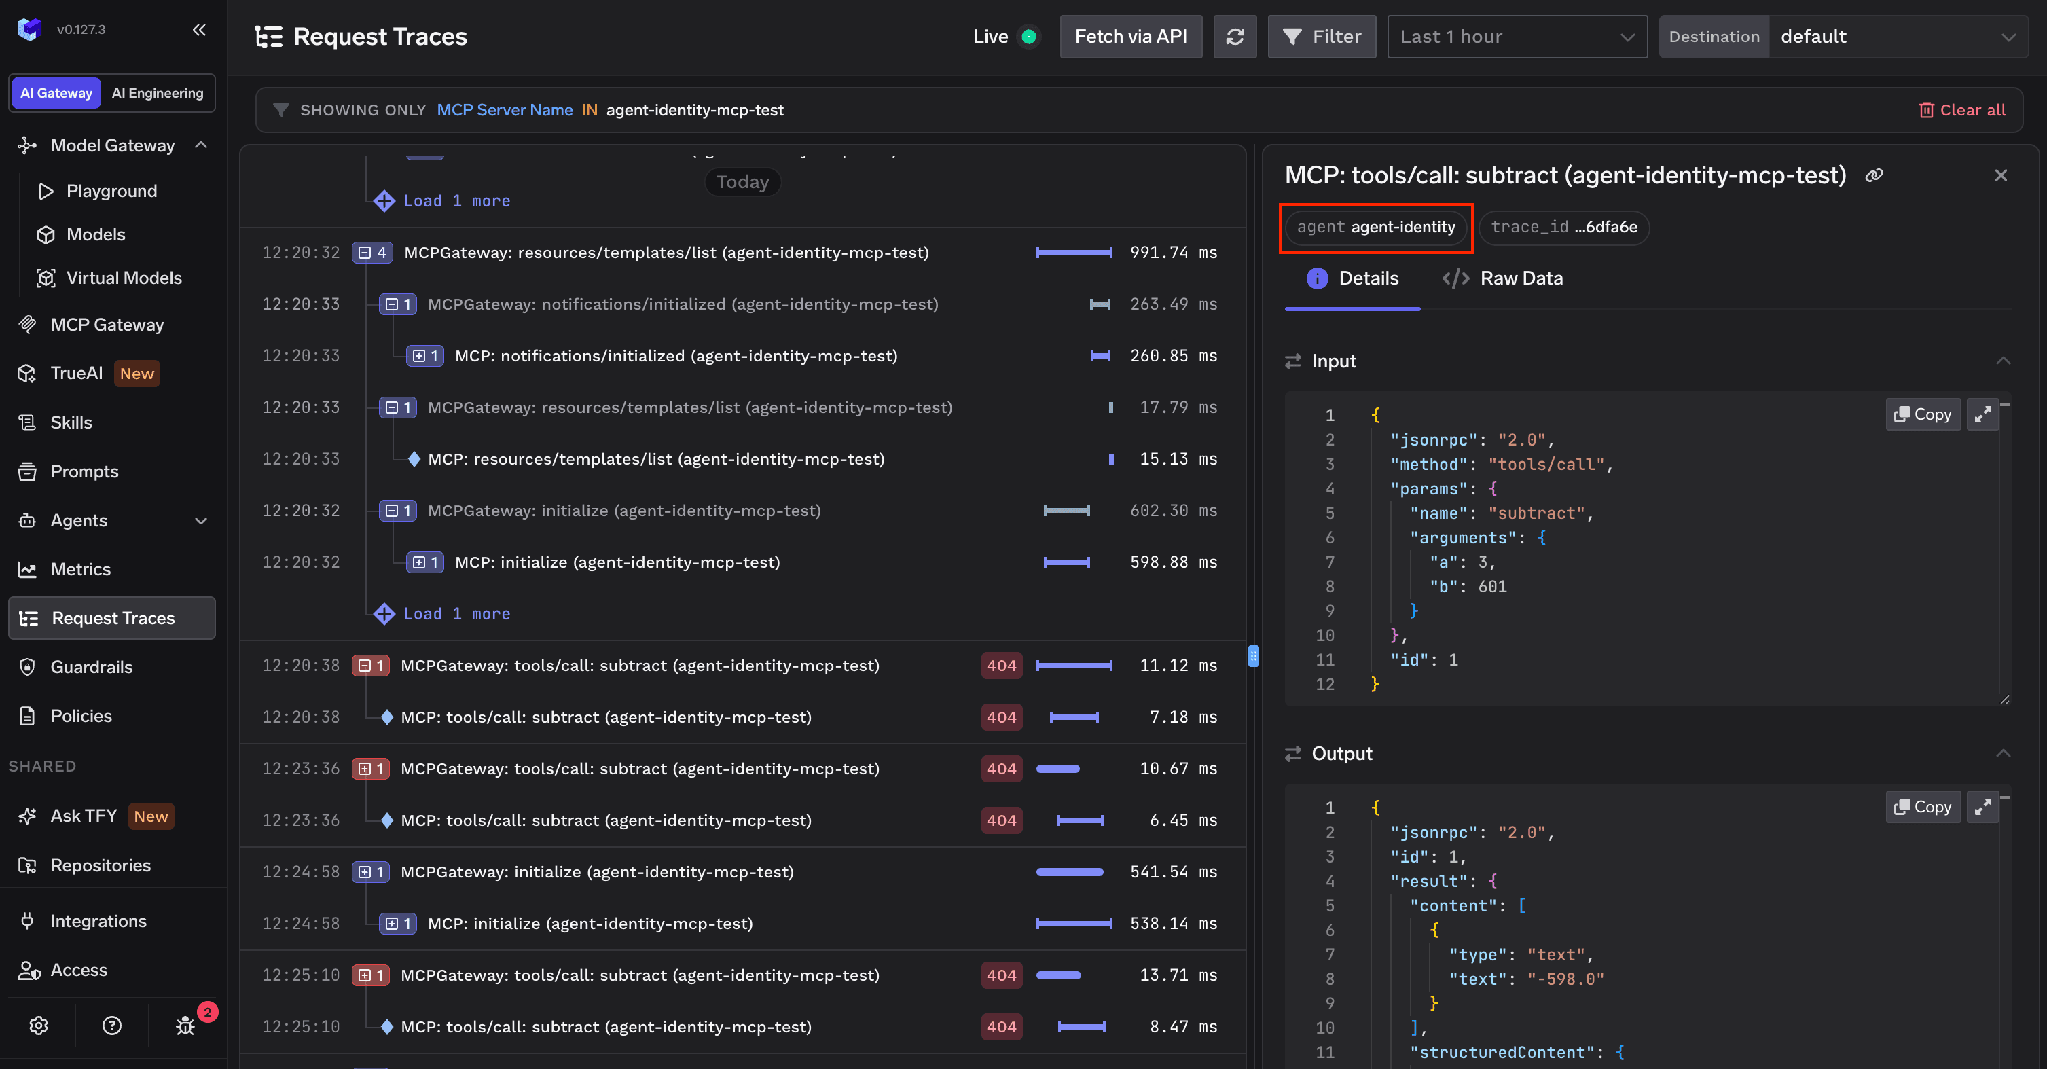
Eén eerlijke beperking: een volledige actor-chain weergave die gebruiker → agent → sub-agent → tool samenvoegt tot één visuele trace komt binnenkort beschikbaar, evenals drift-detectie, anomalie-alerts en het met één klik opschorten van een agent. Momenteel krijg je attributie per hop op elke trace, in plaats van de hele keten als één afbeelding.
Latency en kosten zijn meetbaar; antwoordkwaliteit is dat niet, en daarom hoort feedback thuis op de trace in plaats van in een afzonderlijke tabel. Elke gateway-response retourneert een x-tfy-feedback-target-id header. Post die naar /api/svc/v1/gateway-feedback met een beoordeling van 1 tot 5 en een optionele opmerking, en deze verschijnt naast de span en in de ruwe data onder tfyGatewayFeedbacks, bij te werken of te verwijderen via het geretourneerde ID. Het target ID heeft momenteel betrekking op de root span, dus feedback komt terecht op de request, niet op een sub-stap.
Koppel dat aan een duim-omhoog-knop in je product en afwijkende sessies krijgen een kwaliteitslabel, waardoor "deze run kostte 40x" verandert in "deze run kostte 40x en de gebruiker gaf het een 2."
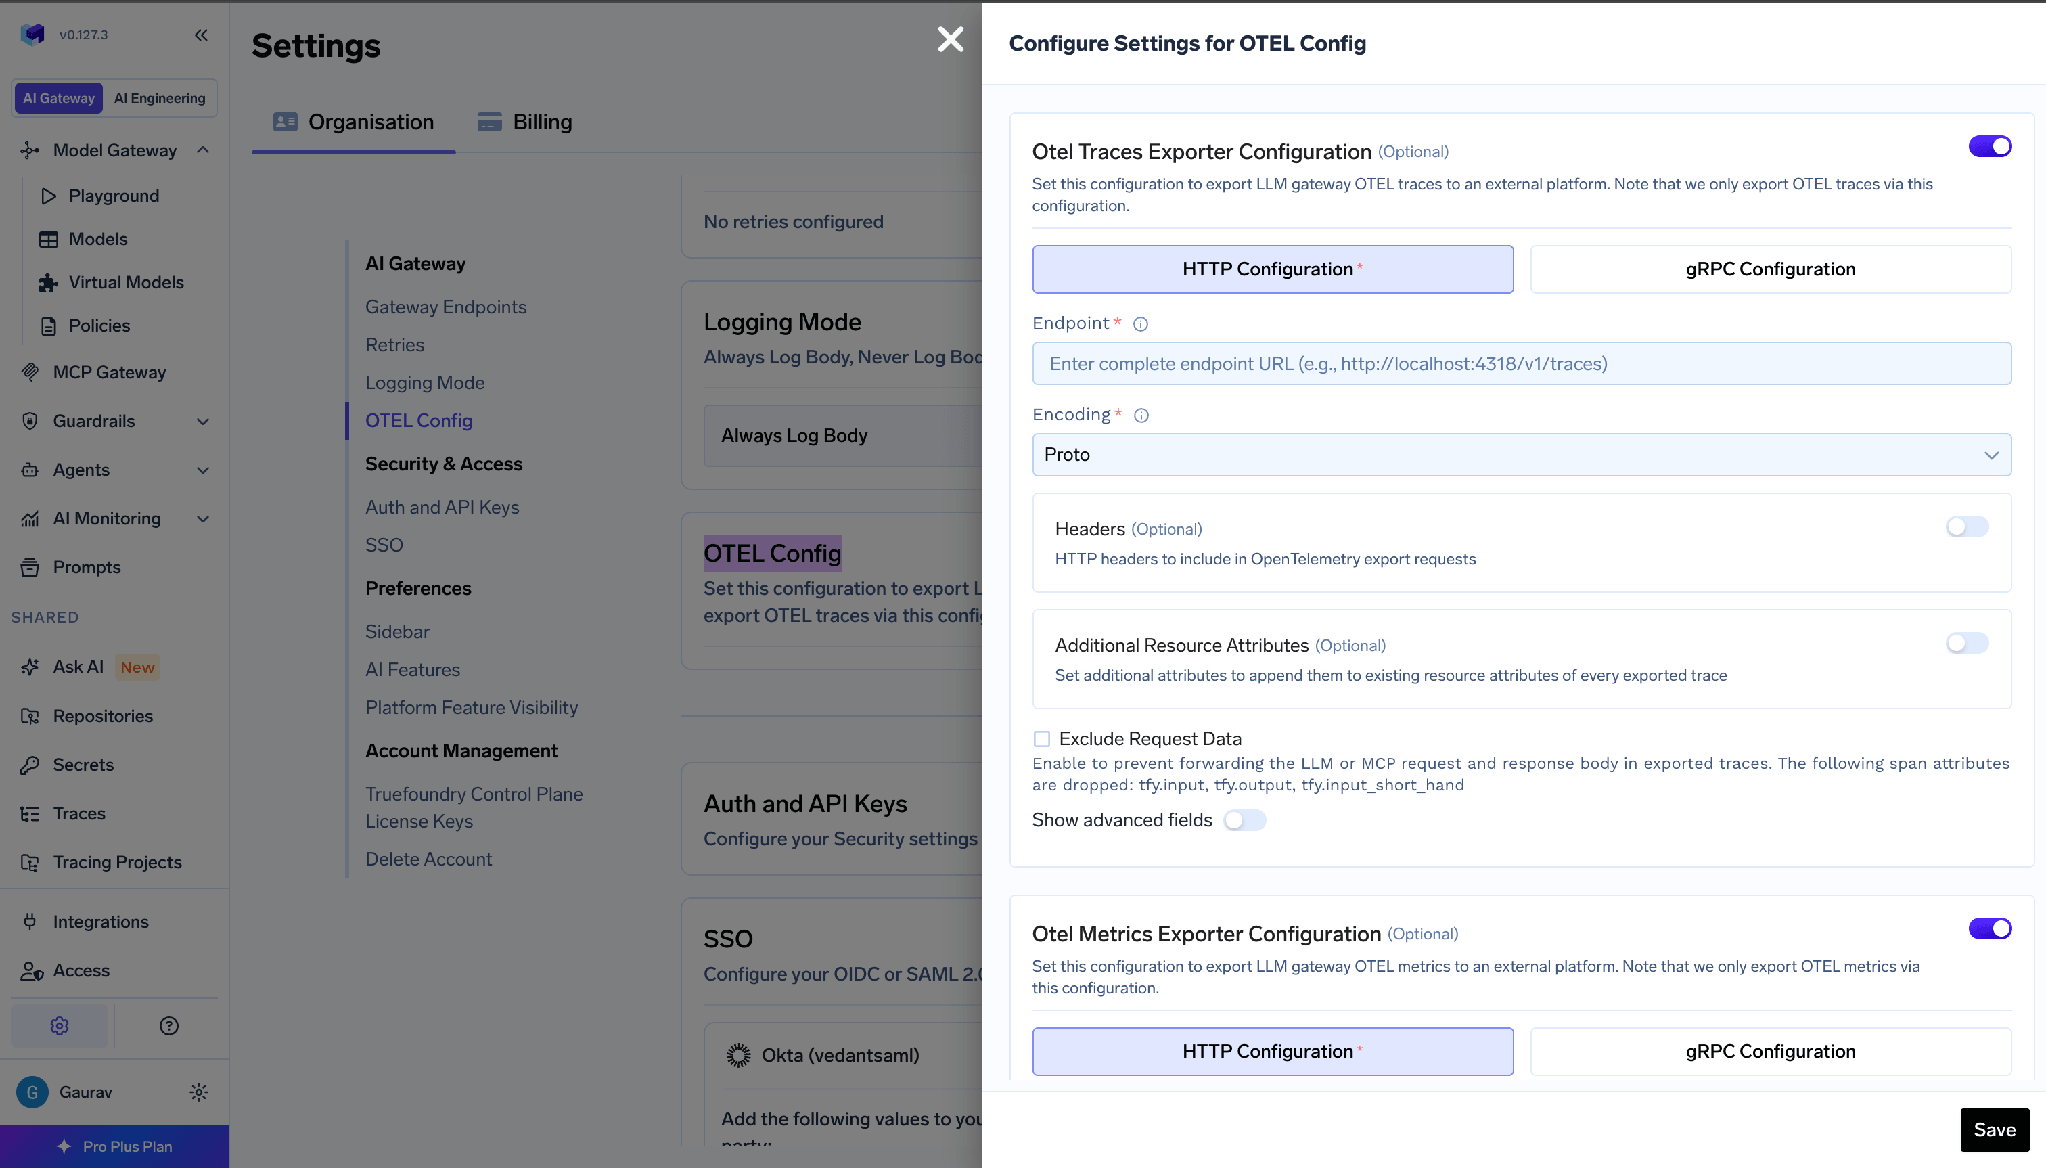
Niets hiervan vereist dat je afstapt van je huidige stack. De gateway is OpenTelemetry-compliant, en traces en metrics worden onafhankelijk geëxporteerd — beide geconfigureerd onder AI Gateway → Controls → Settings → OTEL Config, via HTTP of gRPC, met proto- of json-encoding en willekeurige auth-headers. Backends die delta-gecodeerde metrics verwachten, zoals Datadog en CloudWatch, hebben de Export Delta Metrics-schakelaar nodig plus een temporality-omgevingsvariabele op de gateway-deployment. Prometheus kan /metrics scrapen op self-hosted gateways.
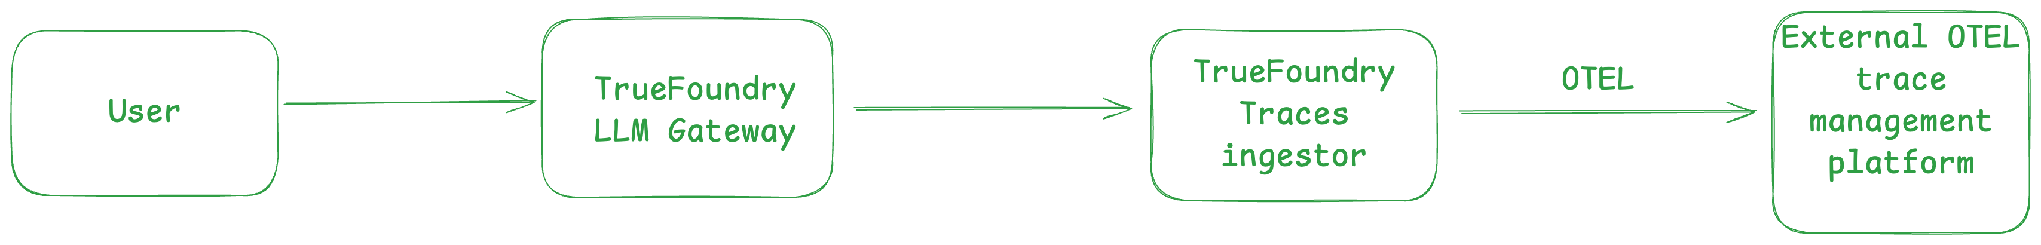
OpenTelemetry trace-flow: traces opgeslagen door TrueFoundry en geëxporteerd naar een externe backend
Export is een aanvulling, geen overdracht: TrueFoundry blijft traces in beide gevallen opslaan, zodat de sessie- en span-weergaven in het product beschikbaar blijven terwijl Grafana of Datadog dezelfde data ontvangt.
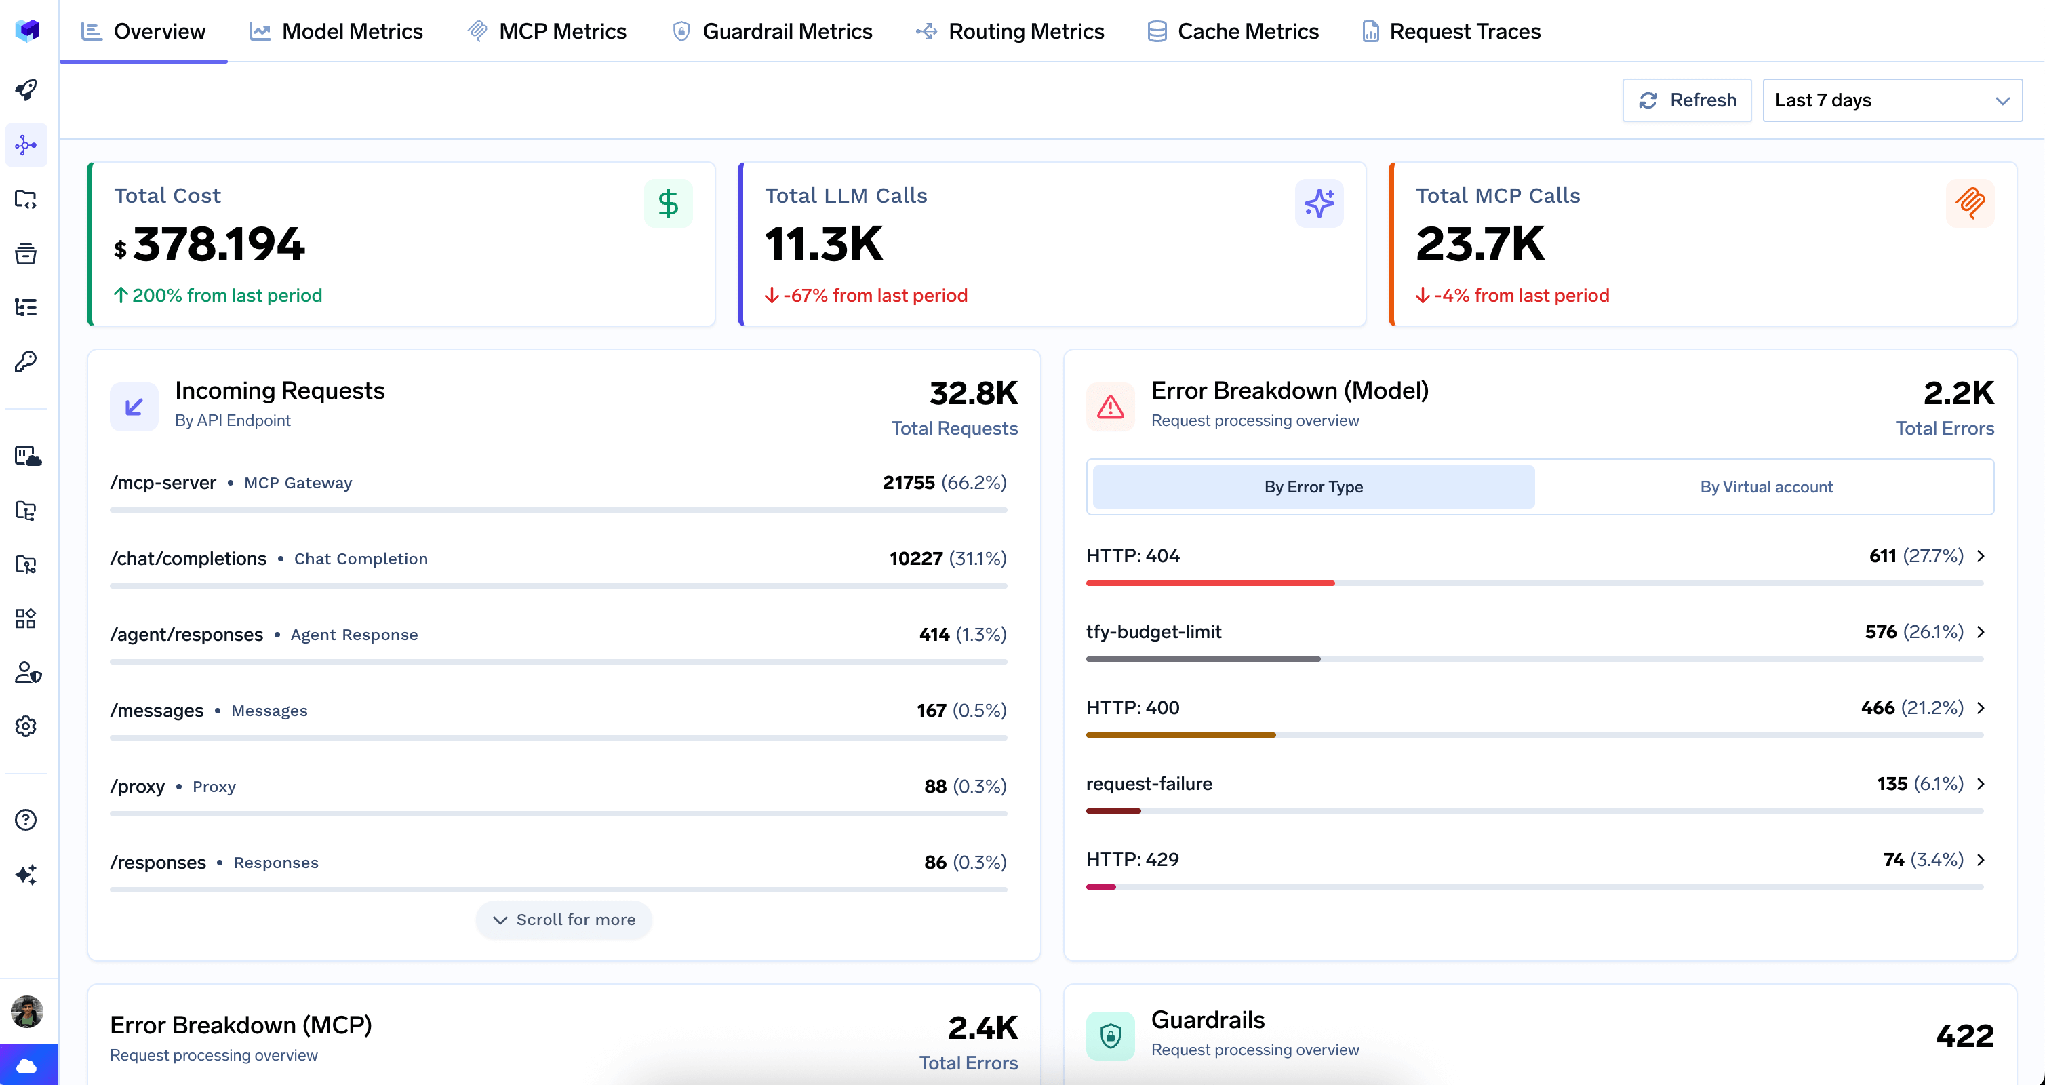
Support copilot, één week in productie. Finance vraagt waarom de rekening is verdriedubbeld.
Begin op sessieniveau. Sorteer op kosten. De mediaan is een paar cent; vier sessies kosten meer dan een dollar, allemaal met een aantal turns in de enkele cijfers — dit zijn dus geen lange gesprekken, het zijn individuele turns die te veel doen.
Open er een en lees de tijdlijn. Turn 3 is bijna volledig gekleurd als tool-call. Tool-calls: 31. Fouten: 0. Er is niets misgegaan, en dat is de reden waarom er geen alert is afgegaan.
Vouw agent steps uit voor turn 3. De geordende lijst toont één document-fetch tool die herhaaldelijk wordt aangeroepen, en de tokens per turn stijgen scherp vanaf turn 3 zonder weer te dalen — een groot document is de context binnengekomen en gebleven.
Bevestig op tool-niveau. In MCP metrics, Tools-weergave, staat die tool met kop en schouders bovenaan de rangschikking van het aantal requests en heeft deze de slechtste p90.
Los het op en verifieer. Of de oplossing nu een specifiekere tool is, paginering, of een prompt-wijziging die de agent vertelt dat hij het bestand al heeft, de verificatie is hetzelfde: filter de sessies voor die agent over de volgende dag en controleer of de kostenverdeling is afgevlakt. Als je feedback hebt gekoppeld, controleer dan of de outliers ook de slecht beoordeelde runs waren — dat is meestal het geval.
Vijf stappen, geen aangepaste instrumentatie, en elke stap was een vraag over het traject.
Agent-metrics bevatten standaard elke gateway-request. Rijen die niet via een agent zijn gegaan, retourneren null voor agentName, agentFramework en agentServerType, en verschijnen als null-buckets in de groupBy-output. IS_NULL wordt niet ondersteund op die drie velden, dus beperk het bereik met agentName IN [...] of een STRING_*-operator.
Trace- en metrics-export worden afzonderlijk geconfigureerd. De traces-exporter verstuurt alleen traces, de metrics-exporter alleen metrics. Het inschakelen van de een en aannemen dat de ander volgt, is een veelvoorkomende manier om met een half beeld te eindigen.
Plan metadata voordat je het nodig hebt. Aangepaste metadata-sleutels die als request-headers worden verzonden, worden een View by-dimensie in het dashboard. Het vooraf toevoegen van een agentnaam, omgeving of run ID kost niets; achteraf toevoegen betekent dat de data van het vorige kwartaal niet op die manier kan worden uitgesplitst.
De verleiding bij agent monitoring is om een agent vast te plakken op de dashboards die je al hebt, p99 en het foutpercentage in de gaten te houden, en te concluderen dat hij geobserveerd wordt. Dat werkt prima tot het eerste incident, wanneer je ontdekt dat de run die je budget heeft opgebruikt op elke hop een 200 retourneerde en op geen enkele grafiek verschijnt.
De oplossing is niet meer metrics, maar een andere eenheid van observatie. Leg het traject vast — sessie, turn, model-call, tool-call, met argumenten en resultaten op de spans — en de drie fouten die daadwerkelijk voorkomen worden inzichtelijk: een lus is een herhaalde call met identieke argumenten, een slecht tool-resultaat is zichtbaar omdat je het hebt bewaard, en een 40x run is de outlier die je bovenaan sorteert.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



Recording an agent’s full execution trajectory — sessions, turns, model calls and tool calls, with arguments, results, tokens, cost and latency — so you can answer why it behaved as it did. It differs from application monitoring in the unit of observation: a request has a start and an end, while a trajectory is a nested sequence in which any level can loop.
LLM observability is a subset covering the model call: prompt, completion, tokens, latency, cost. Agent observability adds everything around it — which tools ran, in what order, with what arguments and results, and how many times a turn went around before stopping. Most real failures live in that structure, not in a single completion.
Niet als model- en toolverkeer al via een gateway routeert, aangezien deze elke stap als bijeffect van het afhandelen ervan vastlegt. Instrumentatie op frameworkniveau via een SDK voegt interne redeneerstappen toe die de gateway nooit ziet, dus de twee zijn complementair, geen alternatieven.
Yes — VPC, on-prem, air-gapped, hybrid, or across multiple clouds, with no data leaving your domain.
Ja. Het omvat een MCP Gateway, een Agent Gateway, en een MCP & Agents Register met toegangscontrole op toolniveau. Agents op LangGraph, CrewAI, AutoGen, of een aangepast framework kunnen allemaal centraal worden gereguleerd.
Ja. De gateway is OpenTelemetry-compliant en sluit aan op Grafana, Datadog, Prometheus, of uw gewenste stack. Het traceert elk verzoek van prompt tot tool- en modeluitvoering, zodat u uniforme logging krijgt zonder wat u al draait te hoeven vervangen.



Het laatste nieuws, artikelen en bronnen in je inbox



















