



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
In de wereld van microservices hebben we de kunst van CI/CD geperfectioneerd. Unittests zijn deterministisch: assert(2 + 2 == 4). Als de tests slagen, kan de code veilig worden gedeployed.
In de wereld van Agentic AI bestaan "Unittests" niet op dezelfde manier.
Je kunt een agent niet simpelweg deployen omdat de code compileert. De prompt is een Hyperparameter van Gedrag. Een kleine aanpassing aan de system prompt ("Wees beknopter") kan een enorme regressie veroorzaken in het redeneervermogen ("De agent is gestopt met controleren op fouten omdat hij beknopt wilde zijn").
Om dit op te lossen, ondersteunt de TrueFoundry Agent Gateway Agent DevOps—een gespecialiseerde lifecycle management-laag die "Shadow Mode," "Online Evals" en "Canary Rollouts" naar de cognitieve stack brengt.
Laten we kijken naar een concreet voorbeeld van waarom standaard CI/CD faalt voor agents.
Het scenario: Je hebt een Customer Support Agent in productie. Hij is beleefd en behulpzaam. De Product Manager wil dat hij efficiënter wordt. De wijziging: Je werkt de System Prompt bij van "Je bent een behulpzame assistent" naar "Je bent een beknopte, directe assistent. Verspil geen woorden."
De standaard deployment:
De catastrofe: De agent interpreteert "direct" als "onbeschoft".
De Customer Satisfaction (CSAT)-score stort in. Je hebt je merk beschadigd omdat je een cognitieve verandering behandelde als een codeverandering.
De TrueFoundry Gateway ondersteunt Traffic Mirroring (Shadow Mode). In plaats van v1 te vervangen door v2, deployen we v2 naast v1.
De Gateway vergelijkt de outputs vervolgens asynchroon. Je kunt een "Auto-Eval" uitvoeren (met een Judge Model) om het verschil te beoordelen.
Het dashboard geeft een melding: "v2 Empathy Regression Detected." Je draait de deployment terug voordat één enkele klant het onbeschofte bericht ziet.

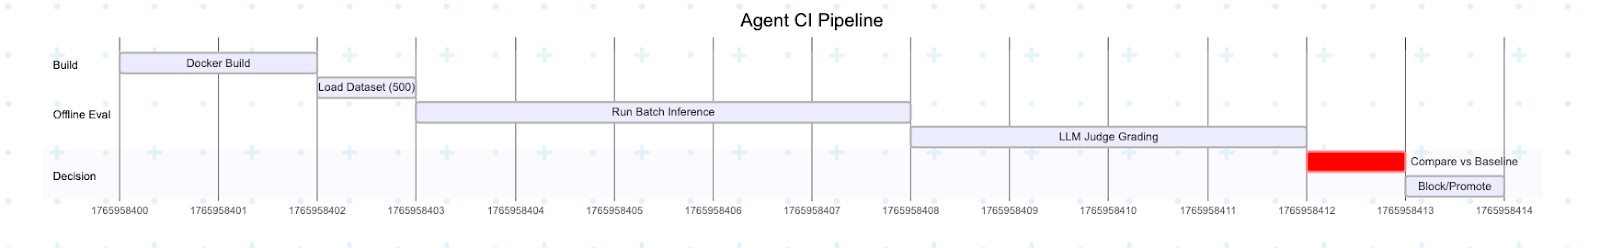
Voordat een agent überhaupt Shadow Mode bereikt, moet deze slagen voor de Evaluation Pipeline. Net zoals je pytest uitvoert voor code, moet je deepeval of ragas uitvoeren voor cognitie.
De TrueFoundry Registry behandelt "Evaluation Datasets" als eersteklas burgers.
Wanneer je een Pull Request pusht, start het CI-systeem de agent op en voert het de 500 vragen uit. Criteria voor slagen:
Als de "Beknopte Prompt" ervoor zorgt dat de "Faithfulness"-score met 10% daalt, faalt de build. "Merge Blocked: Agent creates hallucinations."
Zodra de agent slaagt voor CI en Shadow Mode, ben je klaar voor de echte wereld. Maar je omzeilt de knop niet direct naar 100%. Je gebruikt Canary Routing.
De Gateway maakt een "Virtual Service" die het verkeer splitst op basis van gewichten.
De Gateway automatiseert dit. Als de "Error Rate" piekt in de 10%-fase, kan de Gateway helpen om automatisch terug te rollen naar v1 en de on-call engineer op te roepen.
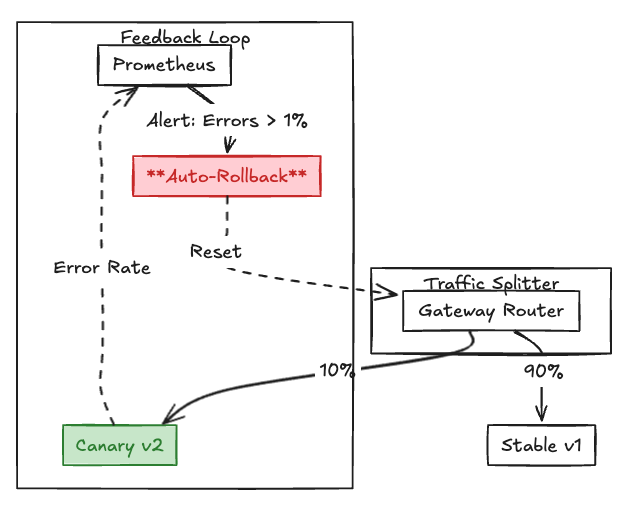
Fig 1: Een voorbeeld van een Canary Rollout
Een grote uitdaging in Agent DevOps is dat de Prompt en de Code vaak op verschillende plaatsen staan.
De TrueFoundry Agent Registry dwingt Immutable Artifacts af. Wanneer je deployt, bundelen we: Artifact ID = Hash(Code + Prompt + Model Config + Dependencies)
Je kunt de prompt van v1 in productie niet wijzigen. Je moet v1.1 aanmaken. Deze strikte versiebeheer zorgt voor Reproduceerbaarheid. Als er een incident optreedt, weet je precies welke combinatie van Code+Prompt dit heeft veroorzaakt.
Agent DevOps is de discipline van het toepassen van engineering-striktheid op probabilistische software. Door over te stappen van "Vibes-based Deployment" (het voelt sneller) naar "Metrics-based Deployment" (Shadow Mode bevestigde 5% hogere nauwkeurigheid), stelt TrueFoundry ondernemingen in staat om snel te innoveren op hun prompts zonder het vertrouwen van hun gebruikers te schaden.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















