



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Equipes corporativas comparam o Obot AI e o LiteLLM quando sua pilha de IA começa a superar as chamadas diretas de modelo. O LiteLLM costuma ser a escolha familiar para roteamento de múltiplos modelos, chaves virtuais, rastreamento de gastos, orçamentos e acesso compatível com OpenAI. O Obot AI entra na discussão quando o gerenciamento de servidores MCP, visibilidade de clientes de IA, identidade e governança de ferramentas se tornam importantes.
A verdadeira questão não é se uma ferramenta substitui a outra em todos os casos. O LiteLLM parte da camada de proxy de LLM. O Obot AI começa mais próximo da governança de MCP e do gerenciamento do ecossistema de IA corporativa. Uma equipe que já utiliza o LiteLLM sem problemas não tem motivos técnicos para mudar. Uma equipe sobrecarregada com servidores MCP não gerenciados em laptops de desenvolvedores não tem motivos técnicos para ficar.
O TrueFoundry torna-se relevante quando as equipes precisam que o roteamento de modelos, ferramentas MCP, fluxos de trabalho de agentes, orçamentos, guardrails e logs de auditoria sejam governados em conjunto, o que geralmente é o ponto em que dois gateways de código aberto começam a parecer dois projetos de conformidade separados.
Uma comparação útil entre LiteLLM e Obot AI começa com a intenção de migração. Algumas equipes querem substituir um servidor proxy. Outras querem adicionar governança de MCP em torno de agentes, ferramentas de codificação e clientes de IA internos. Isso representa diferentes motivações de compra.
A principal diferença é onde começa a opinião de cada projeto. A configuração do LiteLLM descreve principalmente os modelos e as regras para alcançá-los. O catálogo do Obot começa com servidores MCP e políticas que definem quem pode acessá-los. Ambos os projetos, desde então, expandiram-se para o território um do outro.
O LiteLLM agora oferece uma API única para mais de 140 integrações, juntamente com orçamentos, roteamento, guardrails e rastreamento de uso. Sua arquitetura de gateway de LLM continua sendo um cenário natural para comparar o roteamento consciente de modelos com uma abordagem de proxy geral. O próprio LiteLLM agora posiciona seu produto como um Gateway de IA que abrange tráfego de LLM, MCP e agentes.
Ambos os gateways possuem um ponto de entrada gratuito e de código aberto, portanto, o preço do software por si só não oferece uma comparação completa. O custo de propriedade também inclui infraestrutura, observabilidade, identidade, atualizações e operações de gateway.
O nível OSS do LiteLLM cobre mais de 140 provedores, usuários, equipes, orçamentos, limitação de taxa, fallbacks, registro de solicitações e métricas do Prometheus. A precificação corporativa é dimensionada pela capacidade anual de solicitações do gateway, arquitetura de implantação e requisitos de suporte. A versão corporativa adiciona SSO, SCIM, autenticação OIDC ou JWT, logs de auditoria, gerenciadores de segredos, suporte multirregional e SLAs de serviço.
Isso torna o LiteLLM mais fácil de avaliar quando as equipes já entendem o volume esperado de solicitações. A análise de precificação do LiteLLM da TrueFoundry fornece contexto adicional sobre infraestrutura e TCO corporativo.
O Obot também possui um caminho gratuito. Seu modelo de edição atual suporta até 100 usuários e dispositivos por padrão. A versão Community mantém esses limites enquanto adiciona opções de identidade como Microsoft Entra, Okta, JumpCloud e Auth0. A versão Enterprise remove esses limites e adiciona suporte formal.
A comparação deve, portanto, incluir hospedagem, bancos de dados, armazenamento de observabilidade, gerenciamento de chaves, requisitos de conformidade e esforço de engenharia. O LiteLLM requer PostgreSQL para recursos como chaves virtuais. O Obot requer infraestrutura para o gateway e cargas de trabalho MCP hospedadas.
Não totalmente. O Obot oferece suporte a acesso significativo a modelos, embora o LiteLLM continue mais focado em roteamento entre provedores.
O LiteLLM fornece uma interface unificada para muitos provedores de LLM. As aplicações utilizam uma URL base de gateway, uma chave e um nome de modelo configurado. O roteamento pode distribuir o tráfego entre provedores, regiões e credenciais, aplicando simultaneamente fallback e controle de custos.
O Gateway de LLM do Obot segue um modelo diferente. Ele expõe endpoints compatíveis com provedores para modelos da OpenAI e Anthropic, endpoints de Respostas Genéricas, AWS Bedrock e Azure. Uma chave de API do Obot com escopo de proxy de LLM substitui as credenciais diretas do provedor.
Os administradores aplicam então Políticas de Acesso a Modelos para controlar quais modelos cada usuário final pode visualizar e chamar. A lista de modelos retornada contém apenas as opções aprovadas. O gateway mantém as credenciais upstream dentro do Obot, em vez de distribuí-las entre as aplicações.
O Obot também pode configurar o Google Vertex como um provedor em outras partes da plataforma. No entanto, as rotas de gateway específicas para provedores externos atuais não expõem o Google Vertex.
O LiteLLM continua sendo o ponto de partida mais forte quando o fallback entre provedores e o roteamento de solicitações impulsionam a decisão. O Obot é mais forte quando a governança corporativa em torno de usuários, agentes, modelos e sistemas MCP é mais importante.
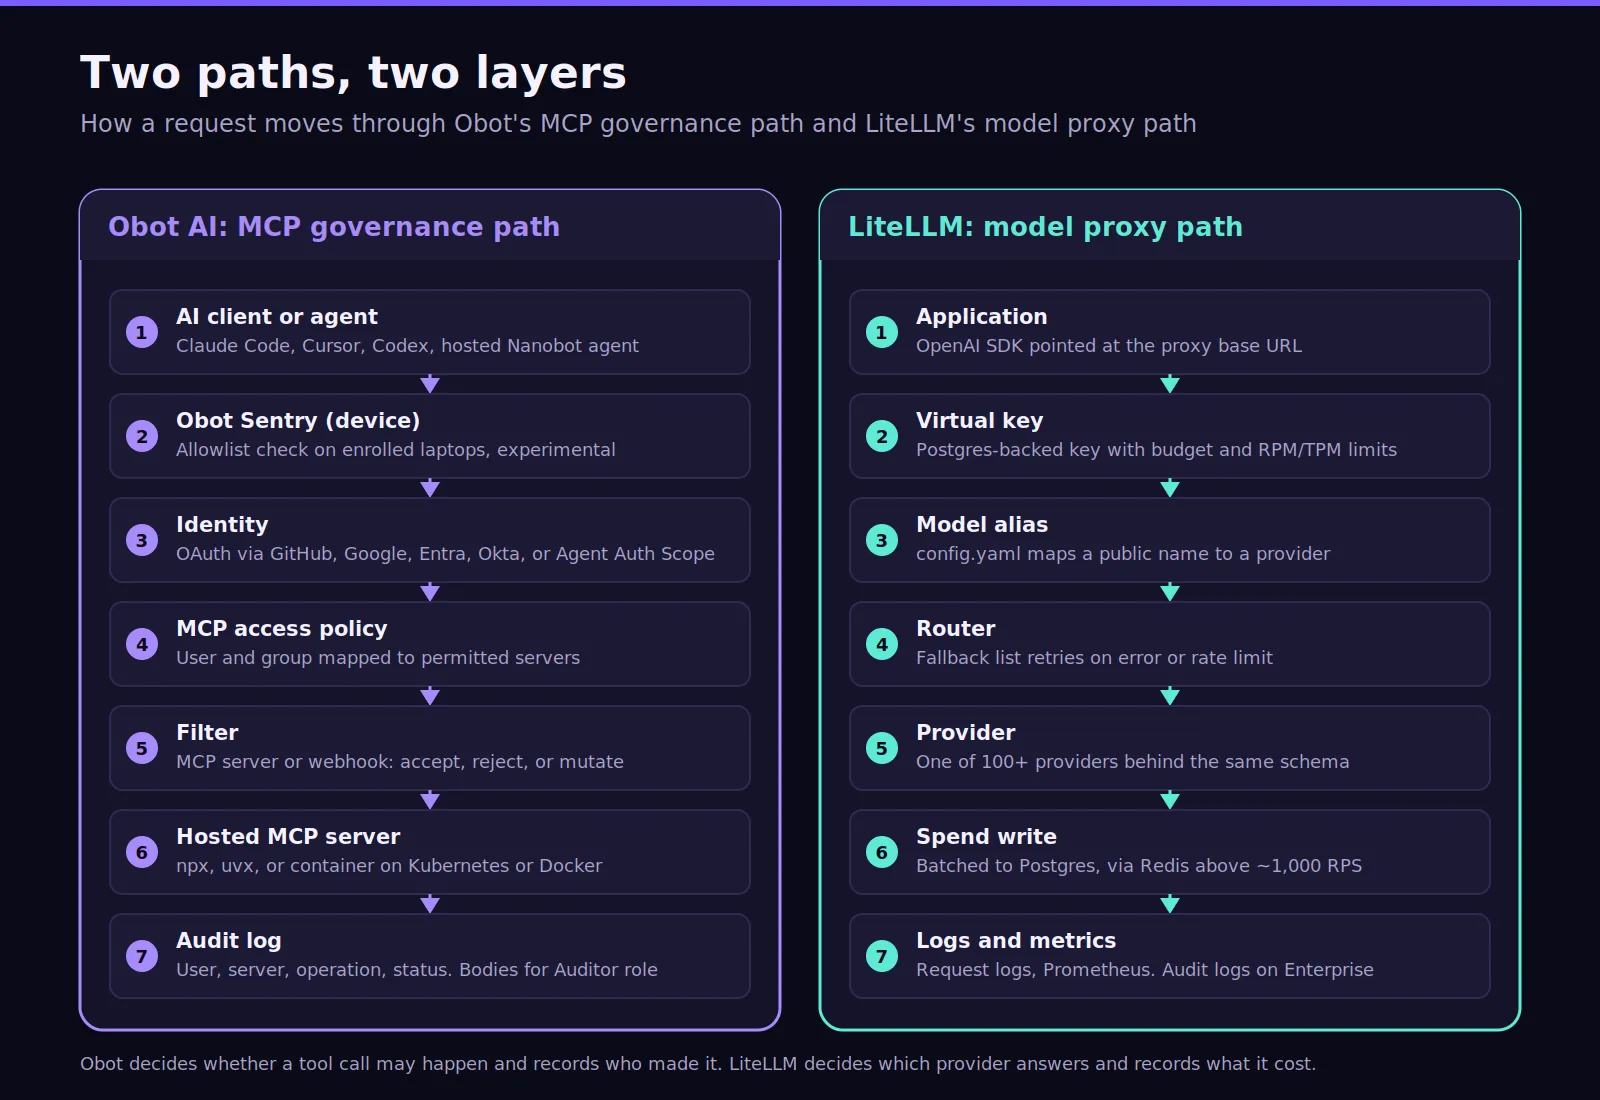
O LiteLLM é mais forte quando as aplicações geram principalmente tráfego de LLM. A decisão muda quando um agente de IA começa a chamar ferramentas, recuperar dados sensíveis ou agir em sistemas corporativos. O roteamento de modelos torna-se, então, uma camada de controle.
O LiteLLM merece crédito aqui, pois suas capacidades atuais são mais amplas do que comparações antigas sugerem. Sua camada MCP apresenta um endpoint fixo para servidores registrados. Os clientes autenticam-se usando o mesmo modelo de credencial de gateway, enquanto o acesso pode ser atribuído por chave ou equipe.
O gateway do LiteLLM também separa a autenticação do cliente dos fluxos OAuth upstream. Isso permite que a credencial do gateway permaneça distinta das credenciais OAuth do lado do servidor. Ferramentas de codificação como o Claude Code podem conectar-se tanto ao roteamento de modelos do LiteLLM quanto aos endpoints de MCP.
O Obot vai além nas operações de MCP. Seu MCP Gateway ponto de comparação é a hospedagem e a profundidade das políticas. O Obot pode executar cargas de trabalho MCP via npx, uvx, conteinerizadas e remotas, enquanto impõe autenticação e autorização.
As políticas de acesso do Obot mapeiam servidores aprovados para usuários específicos ou grupos de provedores de identidade. Filtros podem inspecionar chamadas de ferramentas individuais e, em seguida, aceitar, rejeitar ou modificar solicitações antes que elas prossigam. Filtros personalizados podem oferecer suporte a controles como mascaramento de PII, quando necessário.
O Obot Sentry também estende a governança para ferramentas de IA locais. O Gerenciamento de Dispositivos pode inventariar a atividade do Claude Code, Codex, Cursor e VS Code. Isso cria uma integração mais profunda quando a atividade local do desenvolvedor precisa aparecer ao lado dos eventos do gateway.
A observabilidade é outra divisão prática entre o LiteLLM e o Obot AI. Cada plataforma enxerga a camada que governa principalmente.
O LiteLLM rastreia gastos, orçamentos, uso por chave ou equipe, comportamento de solicitações, resultados de provedores e atividade do gateway. Ele pode atribuir o uso de tokens entre chaves, usuários, equipes, organizações, ferramentas, agentes e cargas de trabalho MCP.
O Obot foca mais em solicitações de MCP, atividade de clientes locais, chamadas de modelos, dispositivos e governança de plataforma. Seu sistema de auditoria correlaciona a atividade entre servidores MCP, provedores de modelos, cargas de trabalho hospedadas e dispositivos de usuário. Os administradores podem filtrar a atividade por usuário, servidor, ferramenta, provedor, modelo, cliente, dispositivo ou sessão.
Para as equipes de plataforma, a diferença é importante. A observabilidade de modelos responde qual modelo foi chamado e quanto custou. A observabilidade de MCP responde qual identidade acessou qual ferramenta e o que aconteceu depois.
Oanálise de observabilidade de gateway explica como a latência, os erros, os gastos, as políticas e os rastreamentos de modelos podem ser correlacionados na camada de gateway.
Migrar um proxy raramente é a parte mais difícil. O desafio é migrar as premissas que já estão incorporadas ao código da aplicação. Antes de mudar, as equipes devem verificar:
Três itens precisam de atenção especial. As aplicações LiteLLM podem usar aliases públicos, enquanto o Obot espera nomes nativos do provedor para rotas de gateway suportadas. Isso significa que os identificadores de modelo podem se tornar um trabalho de migração em todas as aplicações de produção.
O LiteLLM também possui um comportamento de fallback que não mapeia diretamente para o modelo de acesso a modelos do Obot. Variáveis de ambiente que contêm configurações e credenciais de provedores podem exigir atualizações à medida que a responsabilidade muda entre os gateways.
Os modelos principais também diferem. O LiteLLM usa credenciais de gateway que carregam orçamentos e acesso. O Obot pode emitir credenciais com escopo definido por meio da API do Obot, enquanto um token do Obot pode autenticar fluxos de trabalho de clientes suportados. Esses modelos de permissão não possuem um mapeamento um para um.
Portanto, as equipes podem manter o LiteLLM para modelos enquanto adicionam o Obot para MCP. Outra opção surge quando fluxos de trabalho de agentes exigem políticas em ambas as camadas. O TrueFoundry Gateway de Agentes fornece cotas de fluxo de trabalho, rastreamentos e identidade centralizada para agentes autônomos.
TrueFoundry serve como a camada de consolidação corporativa. Seu gateway de IA corporativo oferece roteamento, observabilidade, guardrails, orçamentos, aplicação de políticas e governança de modelos. Ele pode ser executado por meio de padrões de implantação SaaS ou controlados pelo cliente.
A plataforma suporta roteamento de provedor, fallback, limitação de taxa e visibilidade de custos em mais de 1.600 modelos. As políticas também podem existir como YAML, permitindo que as equipes revisem a governança por meio de controle de versão, em vez de manter controles independentemente dentro das aplicações.
As políticas de orçamento podem limitar o uso a usuários, equipes, aplicações, modelos ou ambientes. Isso proporciona uma aplicação em tempo real antes que chamadas LLM dispendiosas continuem.
name: budget-limiting-configtype: gateway-budget-configrules: - id: 'coding-agents-daily' when: subjects: ['team:platform'] metadata: environment: 'production' limit_to: 200 unit: cost_per_day budget_applies_per: ['user'] alerts: thresholds: [75, 90, 100] notification_target: - type: slack-bot notification_channel: 'budget-alerts-channel' channels: ['#ai-spend']Ultrapasse US$ 200 no dia e o gateway responderá com um erro 429 contendo `error_origin_level: rate_limit_budget`, com o ID da regra violada no cabeçalho `x-tfy-applied-rules`. O modo de auditoria rastreia a mesma regra sem bloquear, o que é a maneira segura de introduzir um limite para uma equipe que nunca teve um.
O MCP Gateway gerencia o acesso a ferramentas por meio de um registro central, RBAC por servidor, gerenciamento de tokens OAuth 2.0 com atualização automática e Virtual MCP Servers, que expõem um subconjunto curado de ferramentas de vários servidores como um único endpoint, sem a necessidade de uma nova implantação. As diretrizes de segurança (guardrails) são aplicadas às chamadas de ferramentas MCP no mesmo arquivo de política que rege as chamadas de LLM:
name: guardrails-controltype: gateway-guardrails-configrules: - id: github-tools-pii when: target: operator: or conditions: mcpServers: values: - github-mcp condition: in subjects: operator: and conditions: in: - team:platform llm_input_guardrails: [] llm_output_guardrails: [] mcp_tool_pre_invoke_guardrails: - pii/pii-detection mcp_tool_post_invoke_guardrails: []A camada MCP conecta a governança de modelos ao acesso a ferramentas, em vez de tratar as ferramentas apenas como mais uma preocupação de aplicação. Identidade federada, RBAC, OAuth 2.0, observabilidade e registro de servidores dão suporte a cargas de trabalho MCP corporativas.
Portanto, a TrueFoundry é uma opção de plataforma única quando produtos separados de proxy e MCP criam políticas duplicadas. As equipes também podem comparar essa arquitetura diretamente através da Comparação entre TrueFoundry e LiteLLM.
Escolha a TrueFoundry quando:
Atualmente, a TrueFoundry lista o plano Developer por US$ 0 mensais, o Pro por US$ 499 mensais, o Pro Plus por US$ 2.999 mensais e preços personalizados para Enterprise. O plano Enterprise oferece suporte a implantações de gateway e plano de controle em VPC e ambientes isolados (air-gapped)
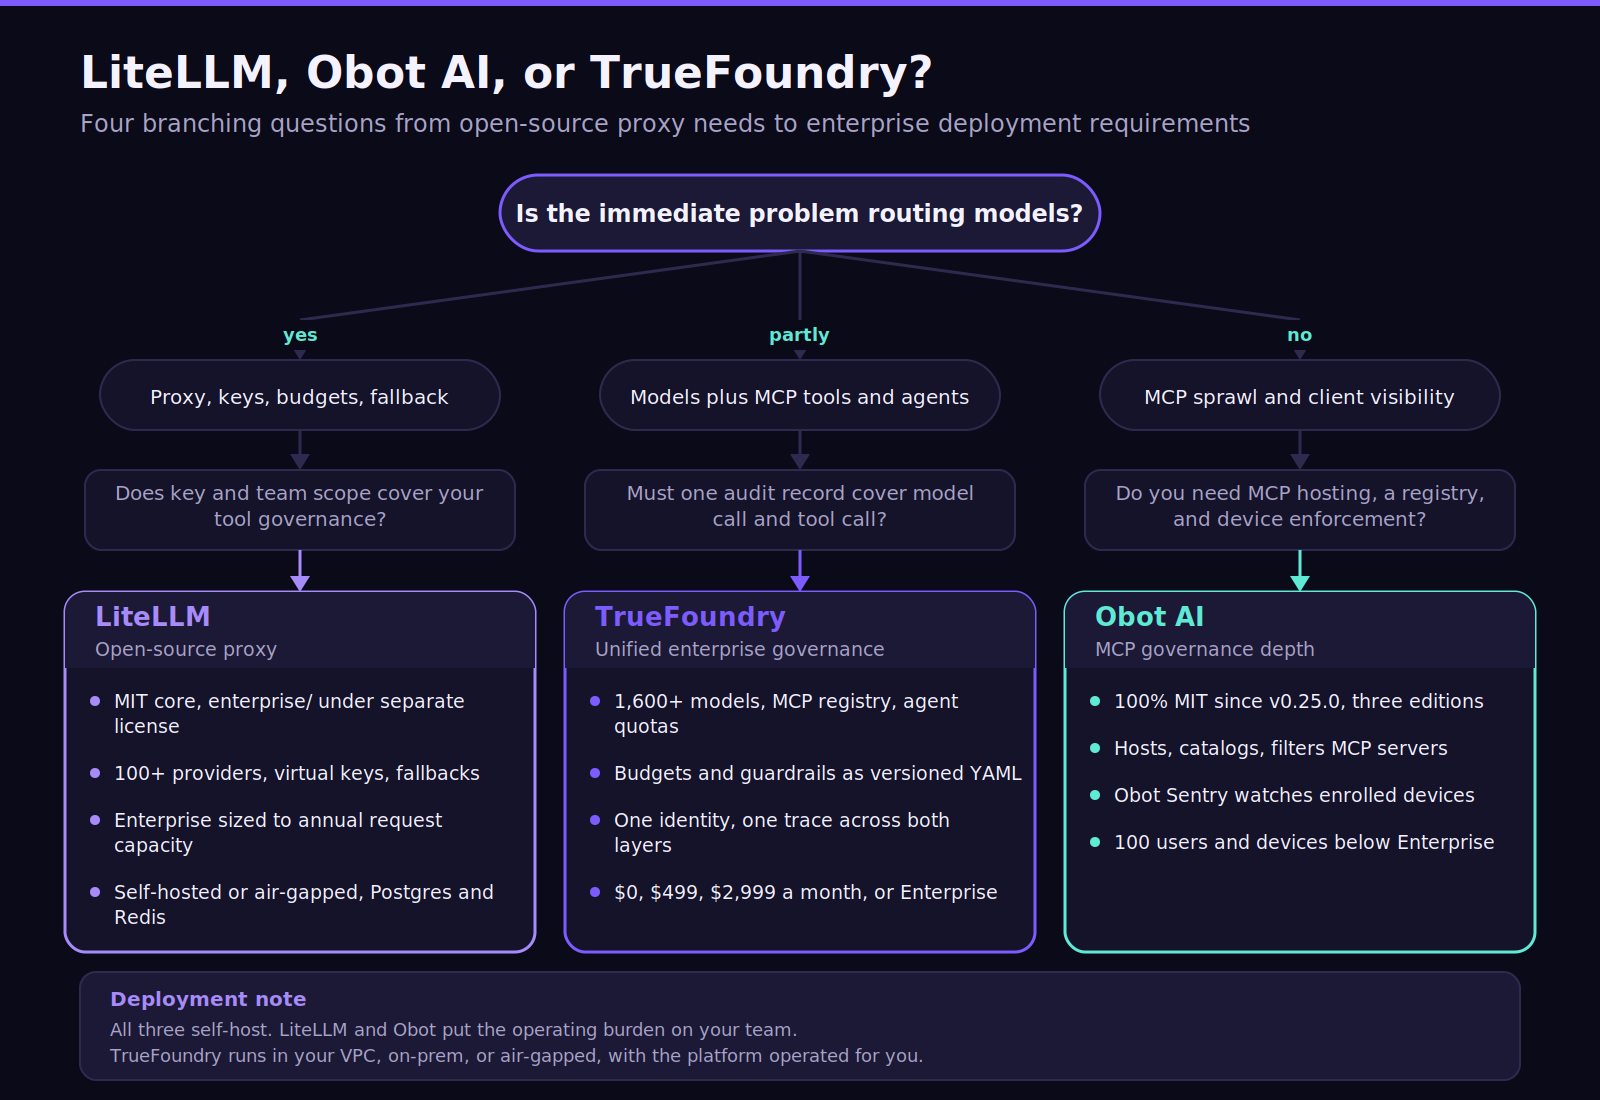
Escolha o LiteLLM quando o requisito imediato for acesso a modelos, roteamento de provedores, orçamentos, fallbacks e rastreamento de gastos. Ele continua sendo um forte candidato quando as cargas de trabalho de produção precisam principalmente de um gateway que entenda modelos.
Escolha o Obot AI quando a governança de MCP, visibilidade de clientes de IA, hospedagem de servidores, políticas de acesso a modelos e controles baseados em identidade forem os fatores decisivos. Ele é ideal para equipes que lidam com a proliferação de MCP e conexões de ferramentas de desenvolvedor não gerenciadas.
Escolha a TrueFoundry quando modelos, ferramentas, agentes, orçamentos, guardrails e observabilidade exigirem uma arquitetura de governança única. Essa abordagem oferece controle total sobre várias camadas de IA sem a necessidade de manter sistemas de políticas separados.
A decisão entre Obot AI e LiteLLM é, portanto, uma escolha de camada inicial. A resposta certa depende se o roteamento de modelos ou a governança de MCP é a restrição operacional imediata.
Equipes que consideram outro caminho de gateway de API, como o Kong Gateway ou o Kong AI Gateway, devem avaliar essa categoria separadamente. Essas plataformas partem de preocupações mais amplas de tráfego de IA e gerenciamento de API.
Agende uma demonstração gratuita hoje para ver como a TrueFoundry conecta a governança de modelos, MCP e agentes em ambientes de produção.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















