



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Pergunte a três equipes o que o roteador de LLM delas faz e você obterá três respostas sem nenhuma sobreposição. Uma executa o GPT-4o tanto no Azure quanto na OpenAI e quer que o tráfego sobreviva a uma queda. Outra recebeu a fatura e quer os 70% de requisições fáceis atendidos por algo mais barato. A terceira tem uma subsidiária alemã cujos prompts não podem sair da UE. As três precisam de configurações diferentes, e duas delas não aproveitariam nada do que a outra construiu.
Vale a pena definir a taxonomia com precisão, pois é isso que a maioria dos conteúdos sobre llm routing pula:
A pista está no que cada um lê para decidir. O balanceamento de carga lê o estado da infraestrutura, a seleção de modelo lê o corpo da requisição e o roteamento de dados lê metadados e identidade. Três entradas, portanto três recursos — e eles se compõem em vez de competir.
Este é o sentido mais antigo e menos interessante do termo, motivo pelo qual também é o mais confiável. Você tem várias maneiras de alcançar a mesma capacidade — azure/gpt-4o e openai/gpt-4o, ou duas implantações em regiões diferentes — e deseja distribuir as requisições entre elas para que nenhuma falha isolada seja a sua falha.
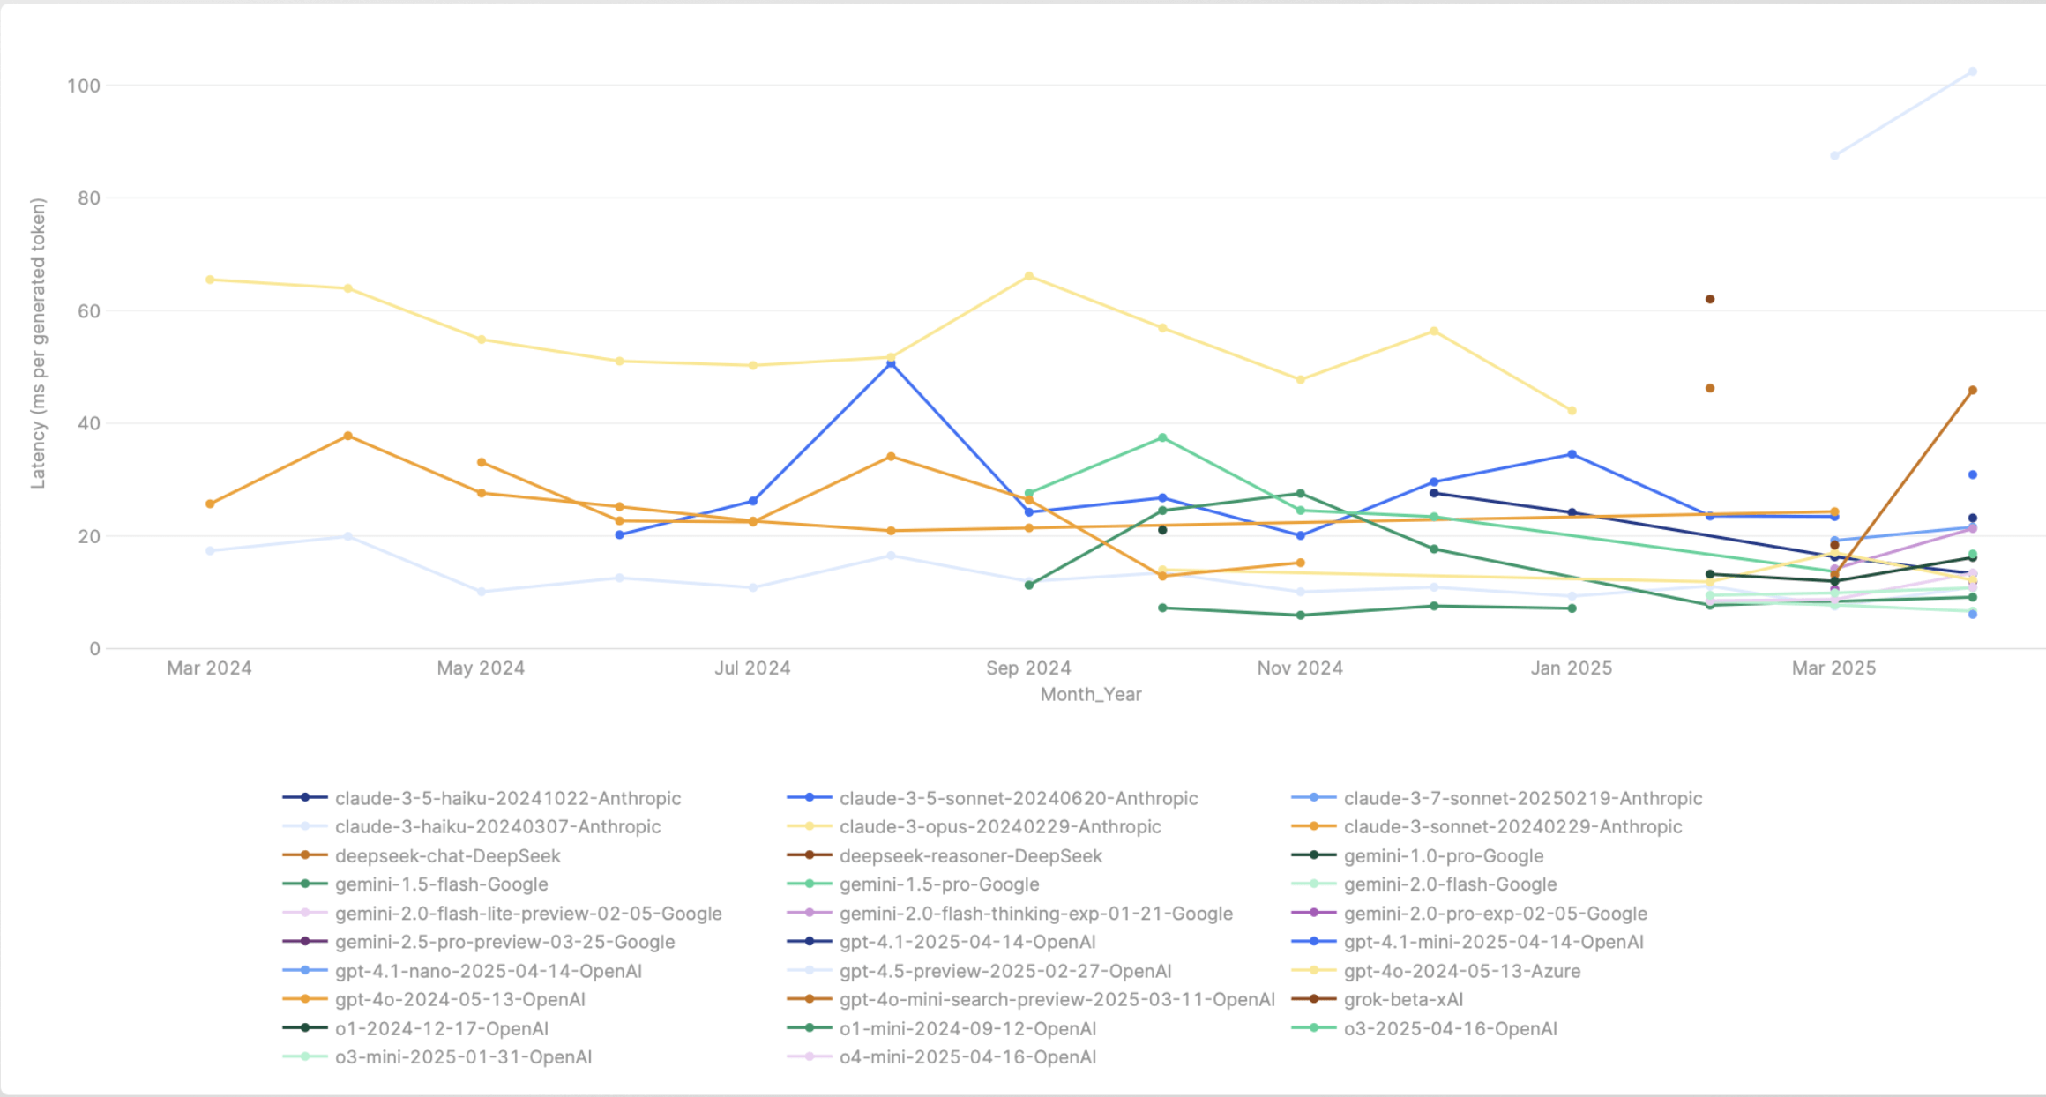
A premissa é que todo destino é equivalente em termos de exatidão. Qualquer um poderia atender à requisição; você está escolhendo com base em disponibilidade, capacidade e velocidade. É isso que torna o llm load balancing seguro para automatizar. E a latência do provedor não é estável o suficiente para ser ignorada — ela varia por modelo, região, provedor e hora do dia:
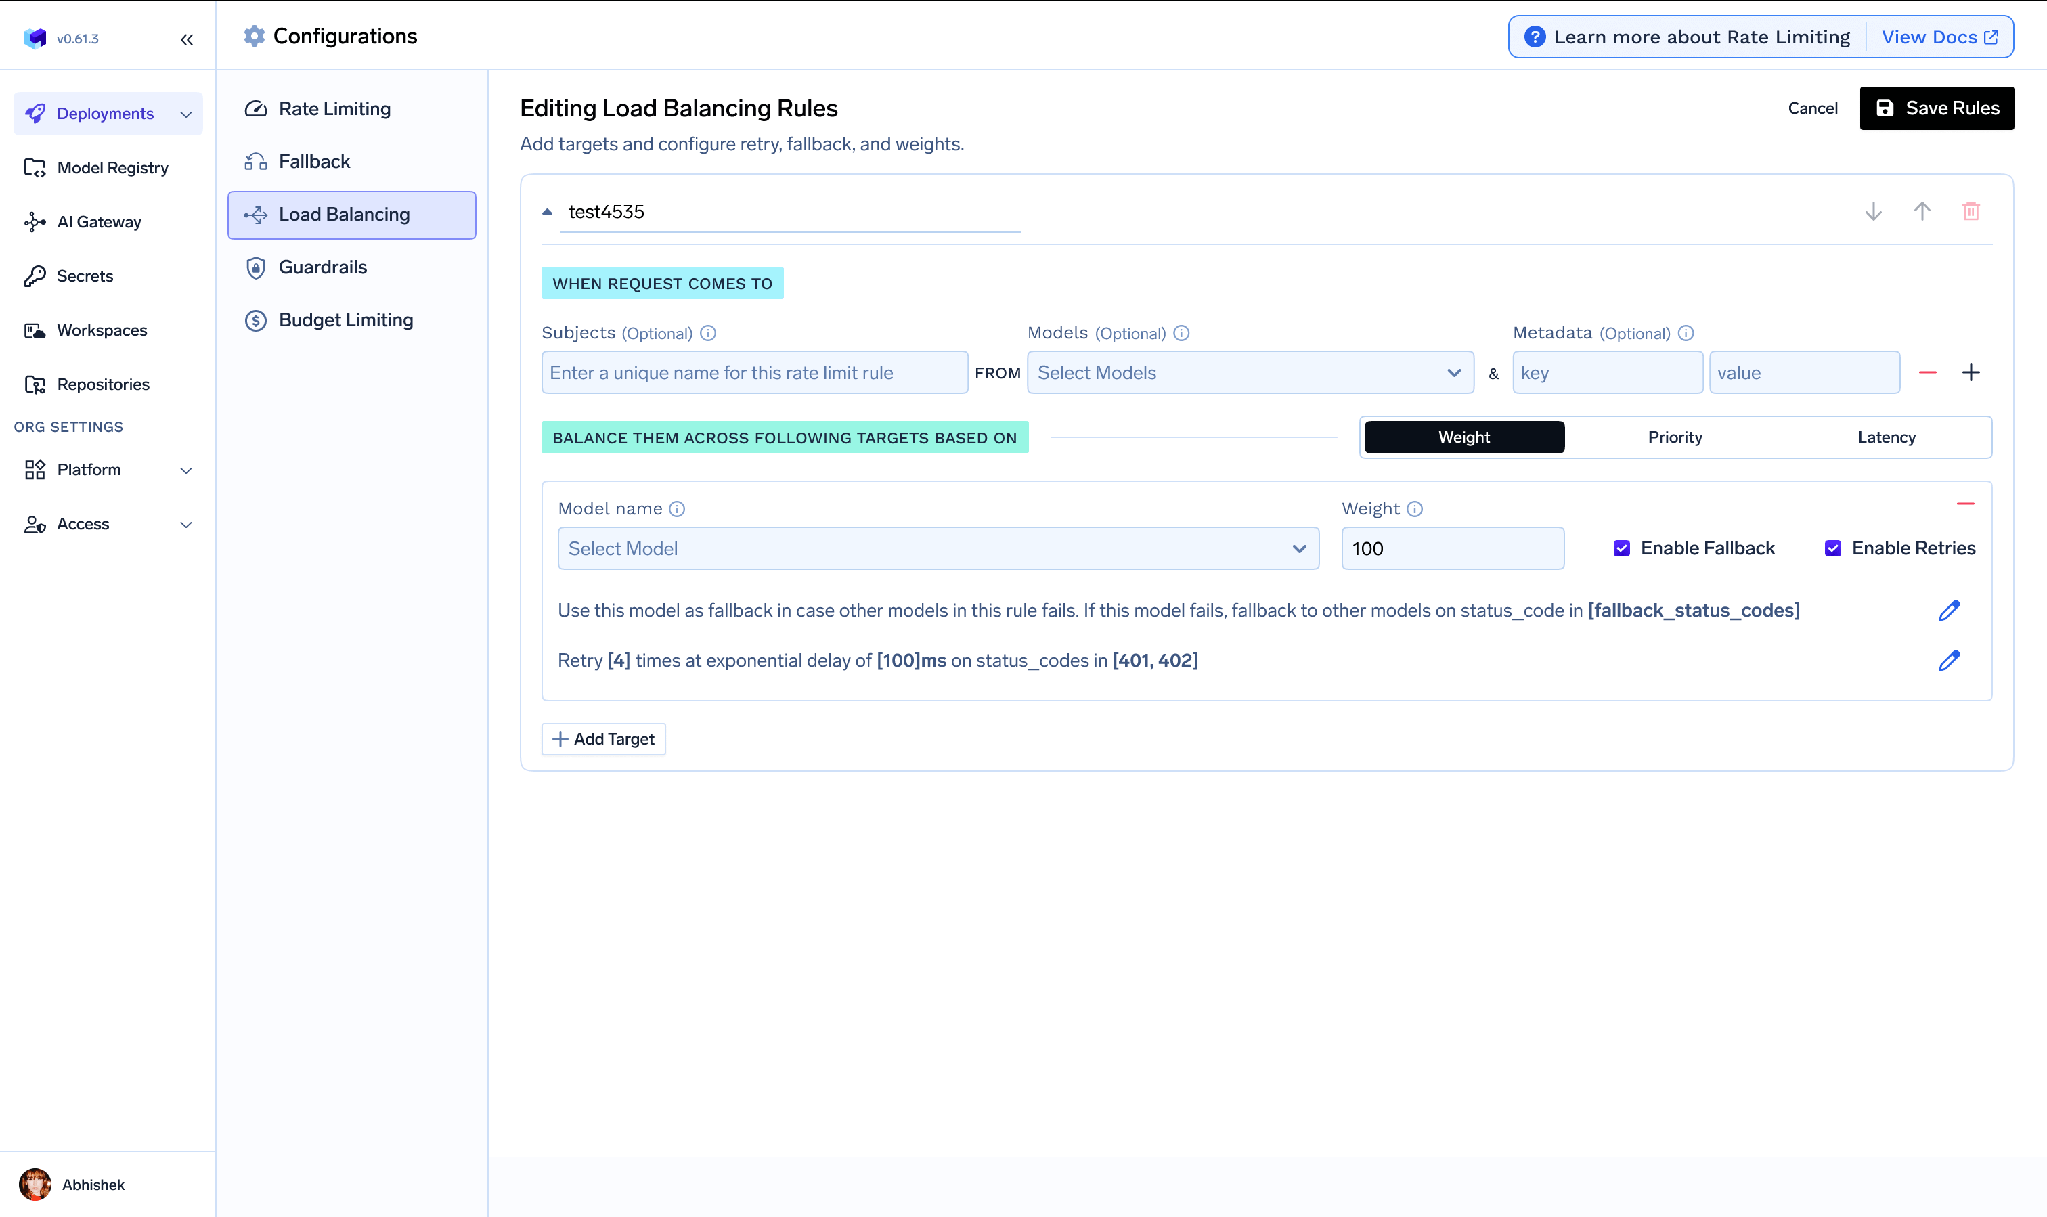
A TrueFoundry configura isso em um modelo virtual — um nome que sua aplicação chama, como my-group/production-chat, com uma estratégia de roteamento e uma lista de destinos reais por trás dele. Três estratégias se qualificam como balanceamento de carga:
Dois detalhes diferenciam essas estratégias de um round robin ingênuo.
O roteamento baseado em latência é fixo (sticky) por design. O gateway mede o tempo por token de saída de cada destino nos últimos 20 minutos e, em seguida, escolhe um destino por cliente (caller) que permanece fixo durante uma época de 10 minutos. Entre muitos clientes, o tráfego se distribui na proporção inversa da latência, mas qualquer cliente individual continua acessando o mesmo destino por tempo suficiente para que o cache de prompt traga benefícios. Você não precisa configurar isso; é assim que a estratégia funciona.
A saúde é monitorada continuamente. Um destino que retorna 5xx, 429, 401 ou 403 duas vezes em uma janela móvel de dois minutos é marcado como não saudável e movido para o final da lista, recuperando-se assim que esses erros expiram. O roteamento baseado em prioridade adiciona um limite de SLA opcional: um limite de tempo por token de saída ou tempo até o primeiro token que rebaixa o destino quando sua média móvel de três minutos o viola.
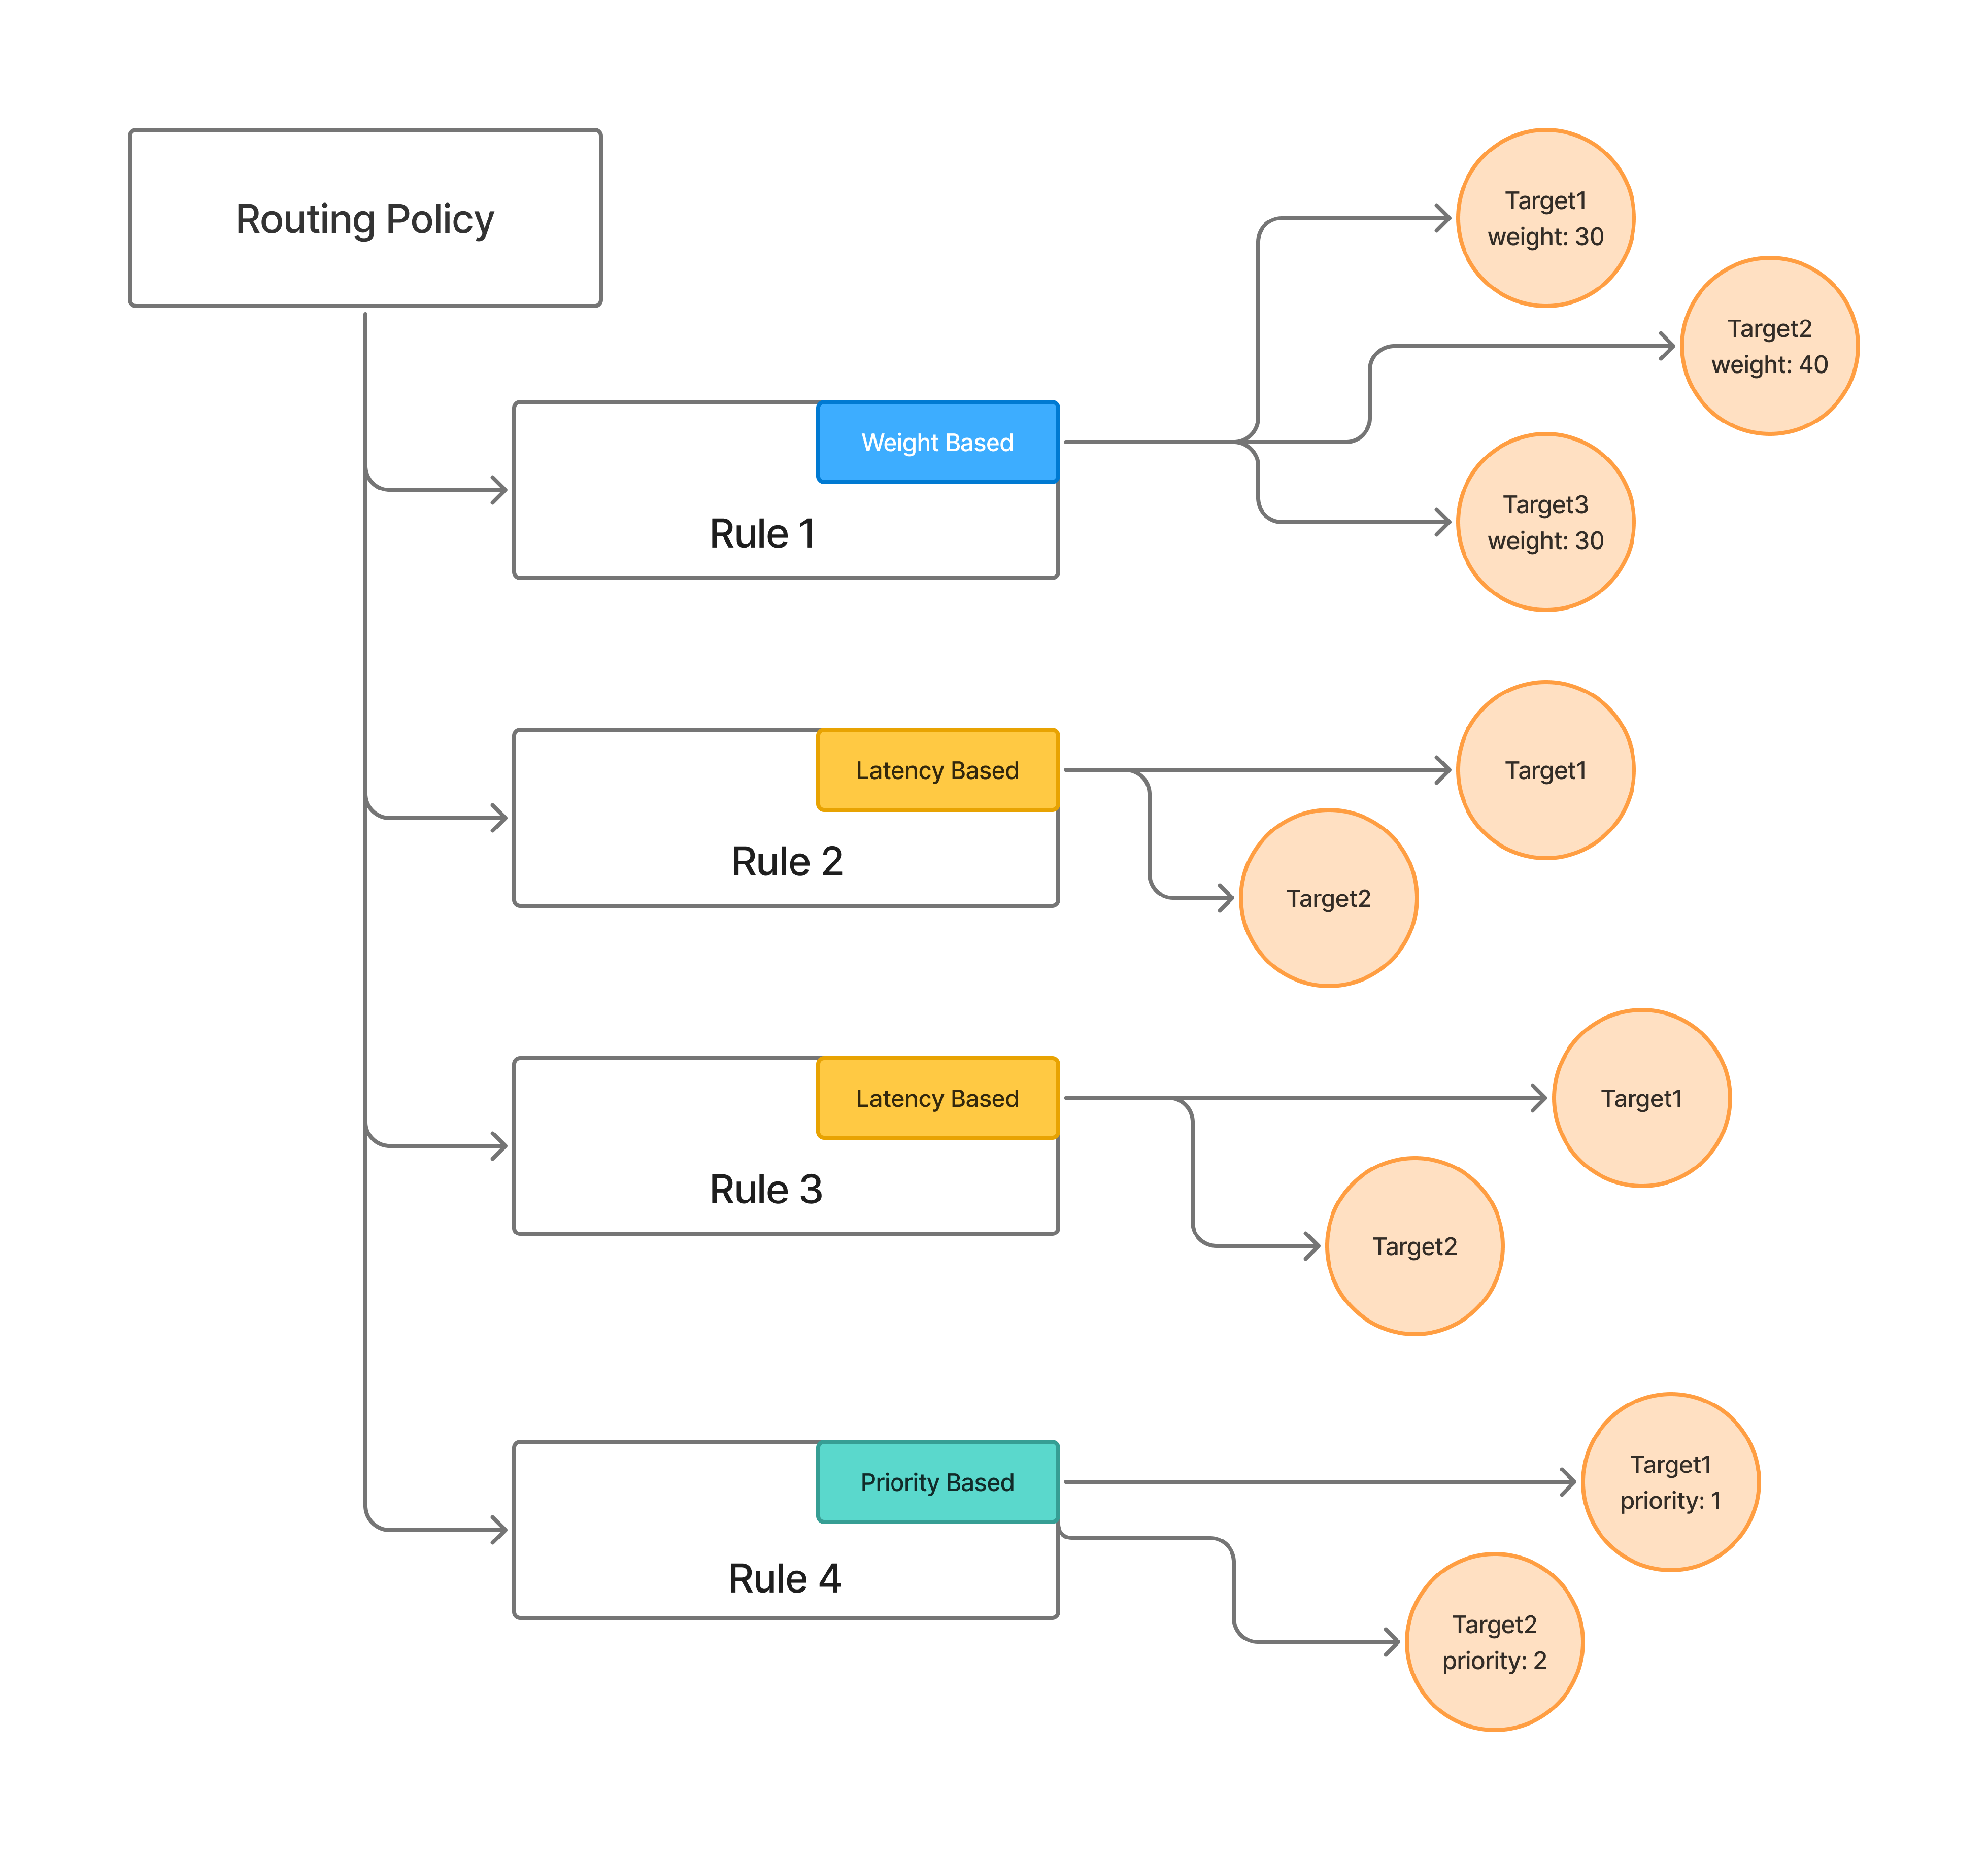
As regras também podem ser escritas no nível do tenant como YAML, avaliadas em ordem, onde a primeira correspondência vence:
Uma cadeia de prioridade que faz failover em limites de taxa (rate limits):

Este YAML fica em AI Gateway → Configs → Routing Config e pode ser mantido no Git e aplicado com tfy apply, para que as alterações de roteamento passem por revisão em PR. Um aviso: para novas configurações, a TrueFoundry recomenda usar modelos virtuais. O YAML continua funcional para implantações existentes, mas os modelos virtuais oferecem controle de acesso e propriedade mais claros.
Este é o sentido que faz as pessoas procurarem pelo melhor roteador de llm, e é um problema genuinamente diferente. Os destinos aqui não são intercambiáveis: um modelo barato e um modelo de ponta ambos responderão, mas não igualmente bem. O roteador está fazendo um julgamento de qualidade, não de capacidade.
A economia é difícil de contestar. O tráfego de produção não é uniformemente difícil — uma saudação, uma busca factual e uma requisição para projetar um rate limiter distribuído chegam ao mesmo endpoint, e atender a todas as três com seu modelo mais capaz significa pagar preços de topo de linha para a maioria simples.
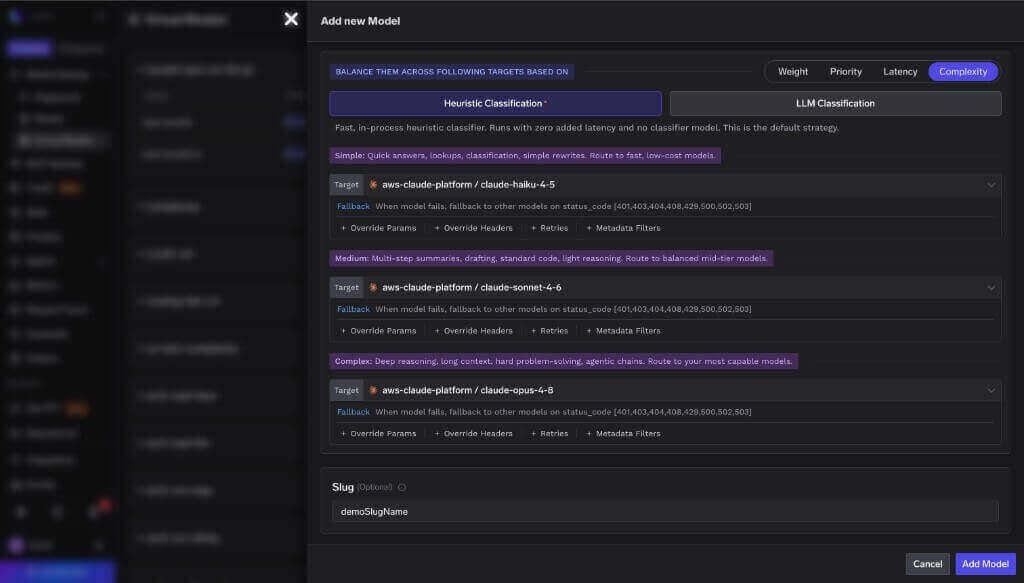
O Auto Routing da TrueFoundry classifica cada requisição em uma de três camadas e a envia para o destino que você configurou para essa camada. Sua aplicação continua chamando um único nome de modelo virtual.
Você escolhe Complexity como o tipo de roteamento ao criar o modelo virtual:
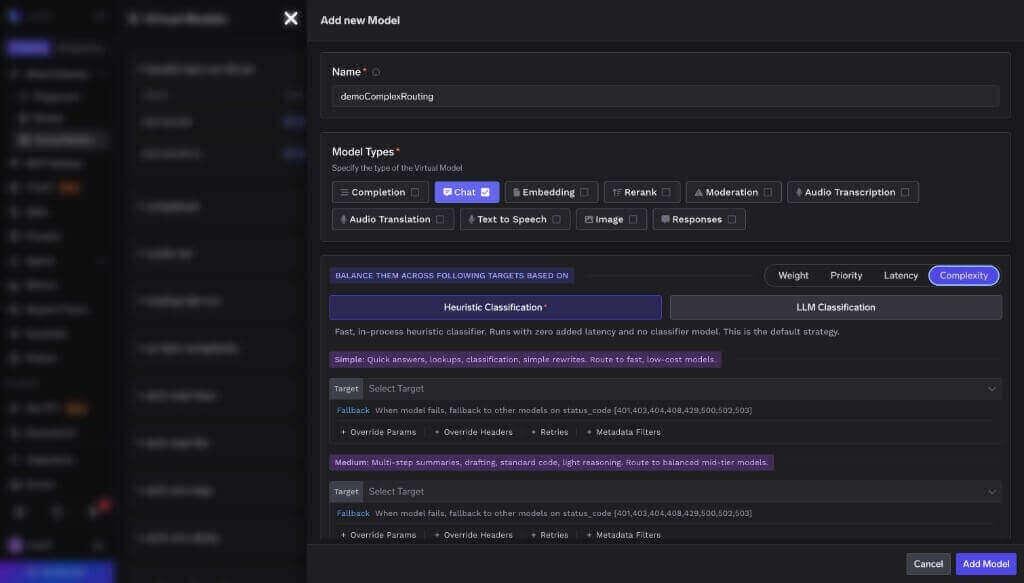
Em seguida, escolha como as requisições são classificadas. O modo Heuristic é o padrão: em processo, gratuito, sem latência adicional, totalmente determinístico. Ele pontua um conjunto fixo de sinais — palavras-chave de código, frases de raciocínio como “passo a passo”, vocabulário técnico, tamanho do prompt, estrutura em várias etapas. Duas frases de raciocínio distintas sempre roteiam para complex, independentemente do restante correspondido.
O classificador por LLM chama um modelo pequeno e rápido em vez disso, para tráfego onde a dificuldade não é sinalizada pelo vocabulário:
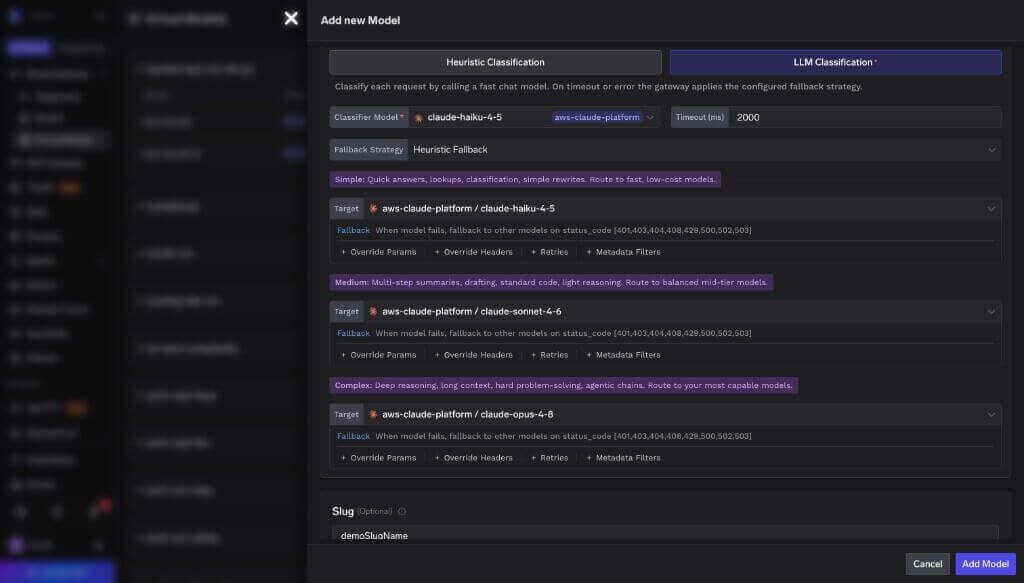
Seja consciente sobre esse custo. Cada chamada do classificador é uma requisição cobrável no gateway. Ela aparece nos seus logs, seus tokens são atribuídos ao mesmo tenant e sujeito que a requisição disparadora, e ela adiciona um salto antes que o modelo real seja chamado. A heurística é gratuita, mas genérica; o classificador é mais preciso em prompts ambíguos e você paga por isso duas vezes, em centavos e em milissegundos. Um fallback_strategy é obrigatório para que um timeout do classificador nunca faça a requisição falhar.
Por fim, atribua um modelo a cada camada:
A TrueFoundry comparou o Auto Routing enviando todas as requisições para um único modelo de ponta. As respostas foram avaliadas de forma determinística — código gerado executado contra testes unitários, matemática e múltipla escolha comparadas com gabaritos.
A latência média caiu de aproximadamente 7,6s para 4,0s, já que a maioria das requisições pula o modelo de raciocínio de ponta. [VERIFICAR — os números de latência não estão na documentação pública, que afirma apenas que o Auto Routing foi “mais rápido em média”.]
Leia os 98% de forma honesta. Não é uma afirmação de que rotear para uma camada inferior é gratuito. É a medida do que você abre mão: dois por cento de uma taxa de aprovação avaliada, comprados por cerca de dois terços da fatura. Em algumas cargas de trabalho essa é uma troca óbvia e em outras não, e é por isso que o número é publicado em vez de arredondado para “sem perda de qualidade”. Em comparação com um modelo de ponta de geração anterior, a economia fica próxima de 50%, e a heurística gratuita perde precisão em prompts curtos, porém difíceis. Medido em agosto de 2026.
O terceiro sentido não tem nada a ver com custo ou throughput. Uma requisição de uma subsidiária alemã pode precisar ser atendida por uma implantação na UE, e o registro dela pode precisar permanecer em um bucket na UE. Nenhum ajuste de peso expressa isso. Duas coisas são chamadas de roteamento de dados, e a TrueFoundry as implementa com recursos diferentes:
Para processamento, os destinos possuem um bloco metadata_match, e um destino permanece elegível apenas quando cada par corresponde aos metadados resolvidos da requisição. No gateway SaaS, cada requisição é etiquetada automaticamente com tfy_gateway_region e tfy_gateway_zone a partir de qualquer uma das mais de 12 regiões que a manipularam, portanto o cliente não envia nada:
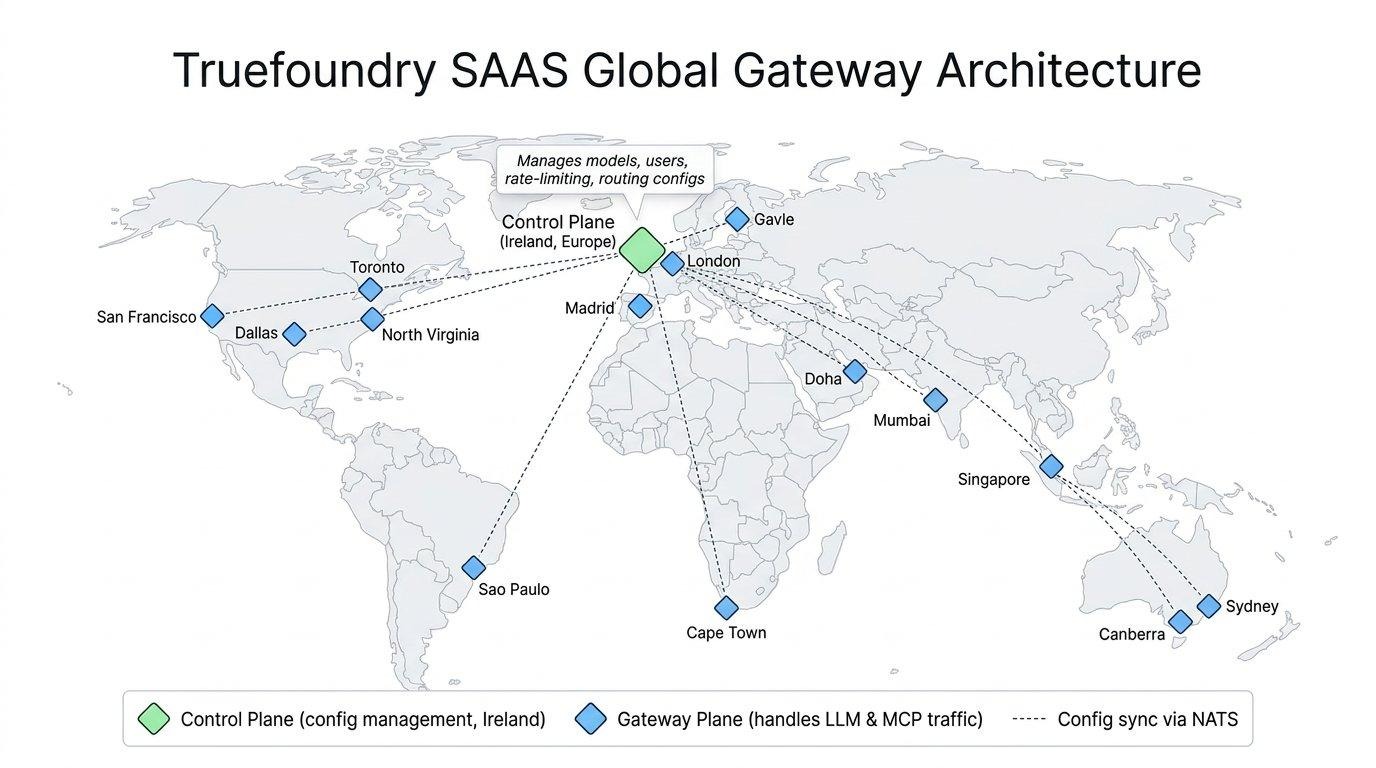
A filtragem ocorre antes que a ordem de balanceamento de carga seja calculada, para que um destino sem correspondência nunca participe. Essa ordenação é o ponto principal: o roteamento de dados restringe o conjunto de candidatos, o balanceamento de carga escolhe dentro dele.
Para armazenamento, há uma página separada de Data Routing em AI Gateway → Controls → Data Routing:
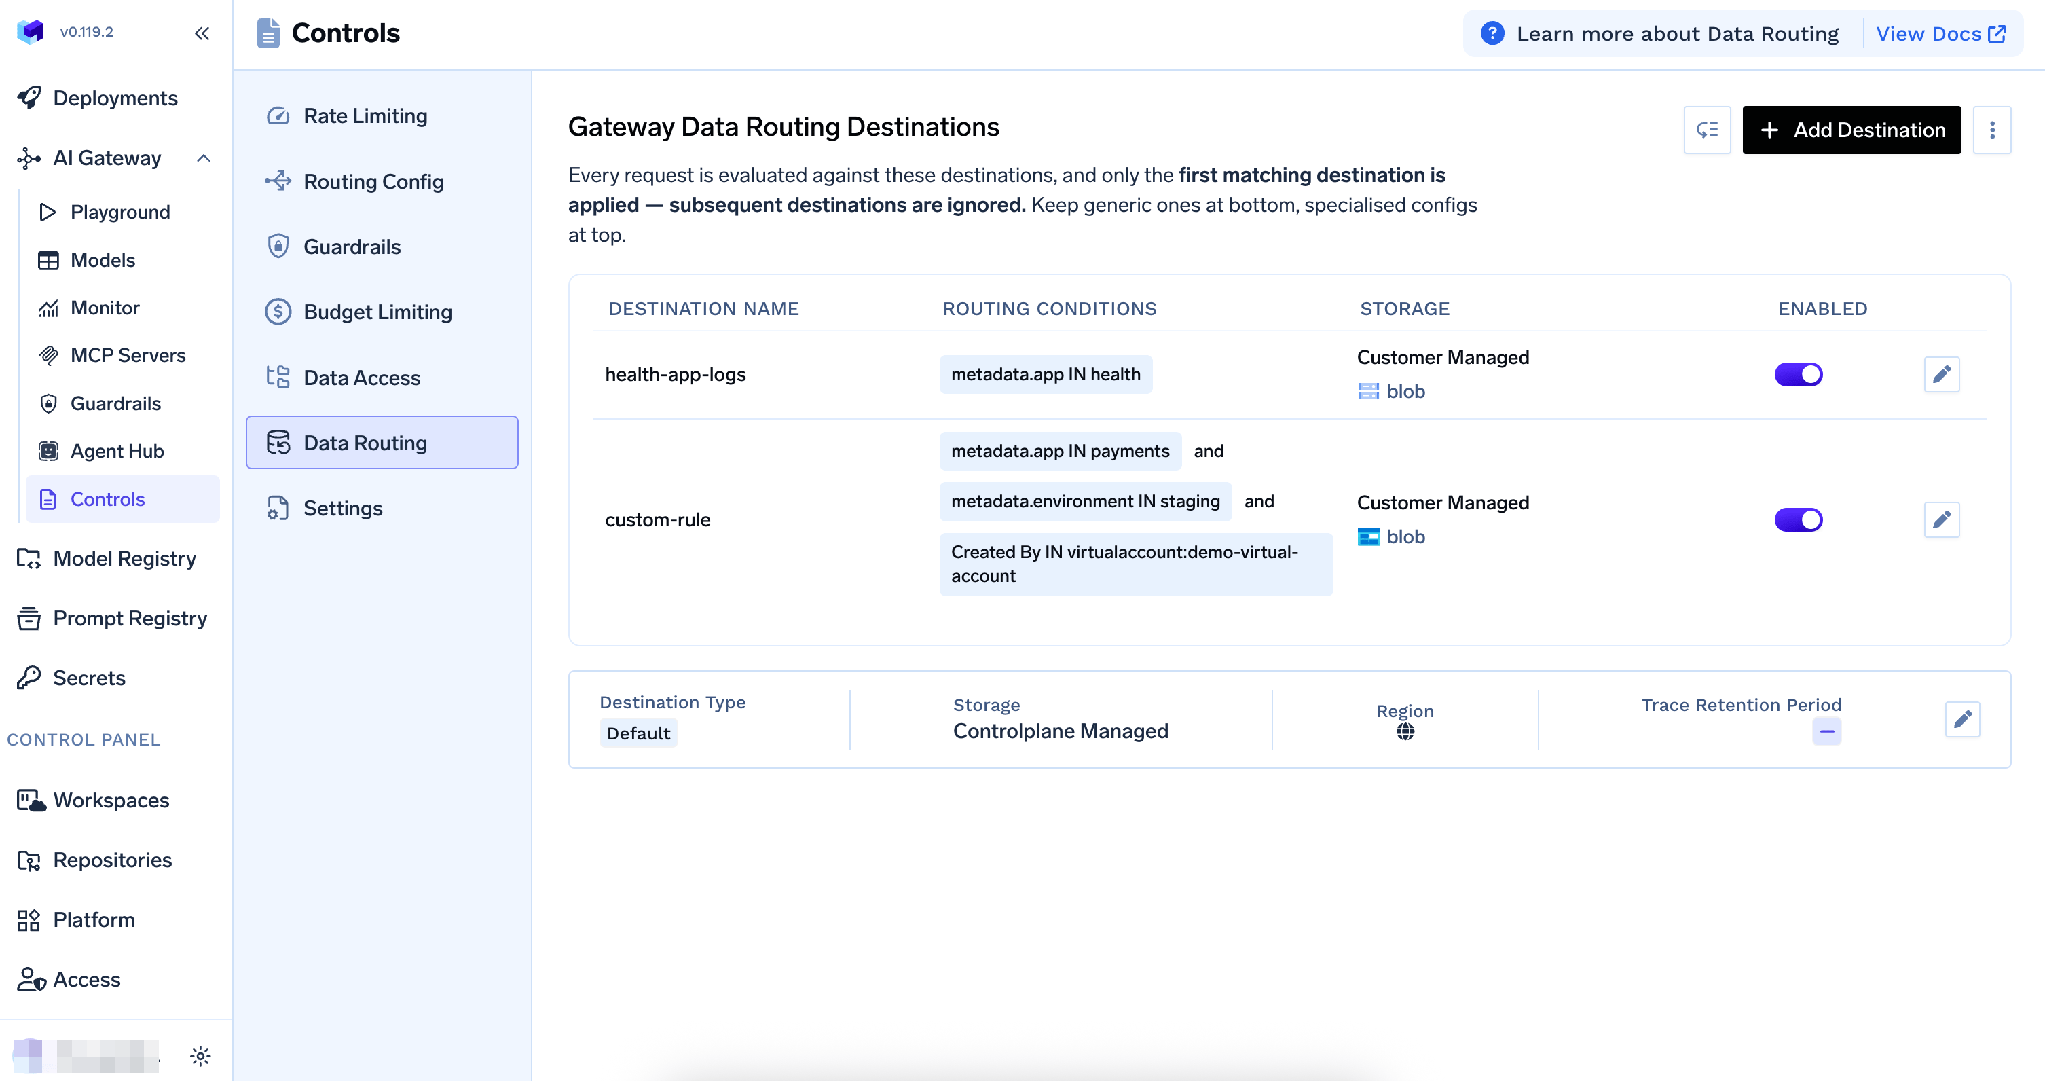
Destinos customizados são um recurso Enterprise e roteiam traces com base em condições — metadados definidos pelo usuário como metadata.app, ou quem criou a requisição. Os destinos são avaliados de cima para baixo, onde a primeira correspondência vence, portanto mantenha regras específicas acima das genéricas:
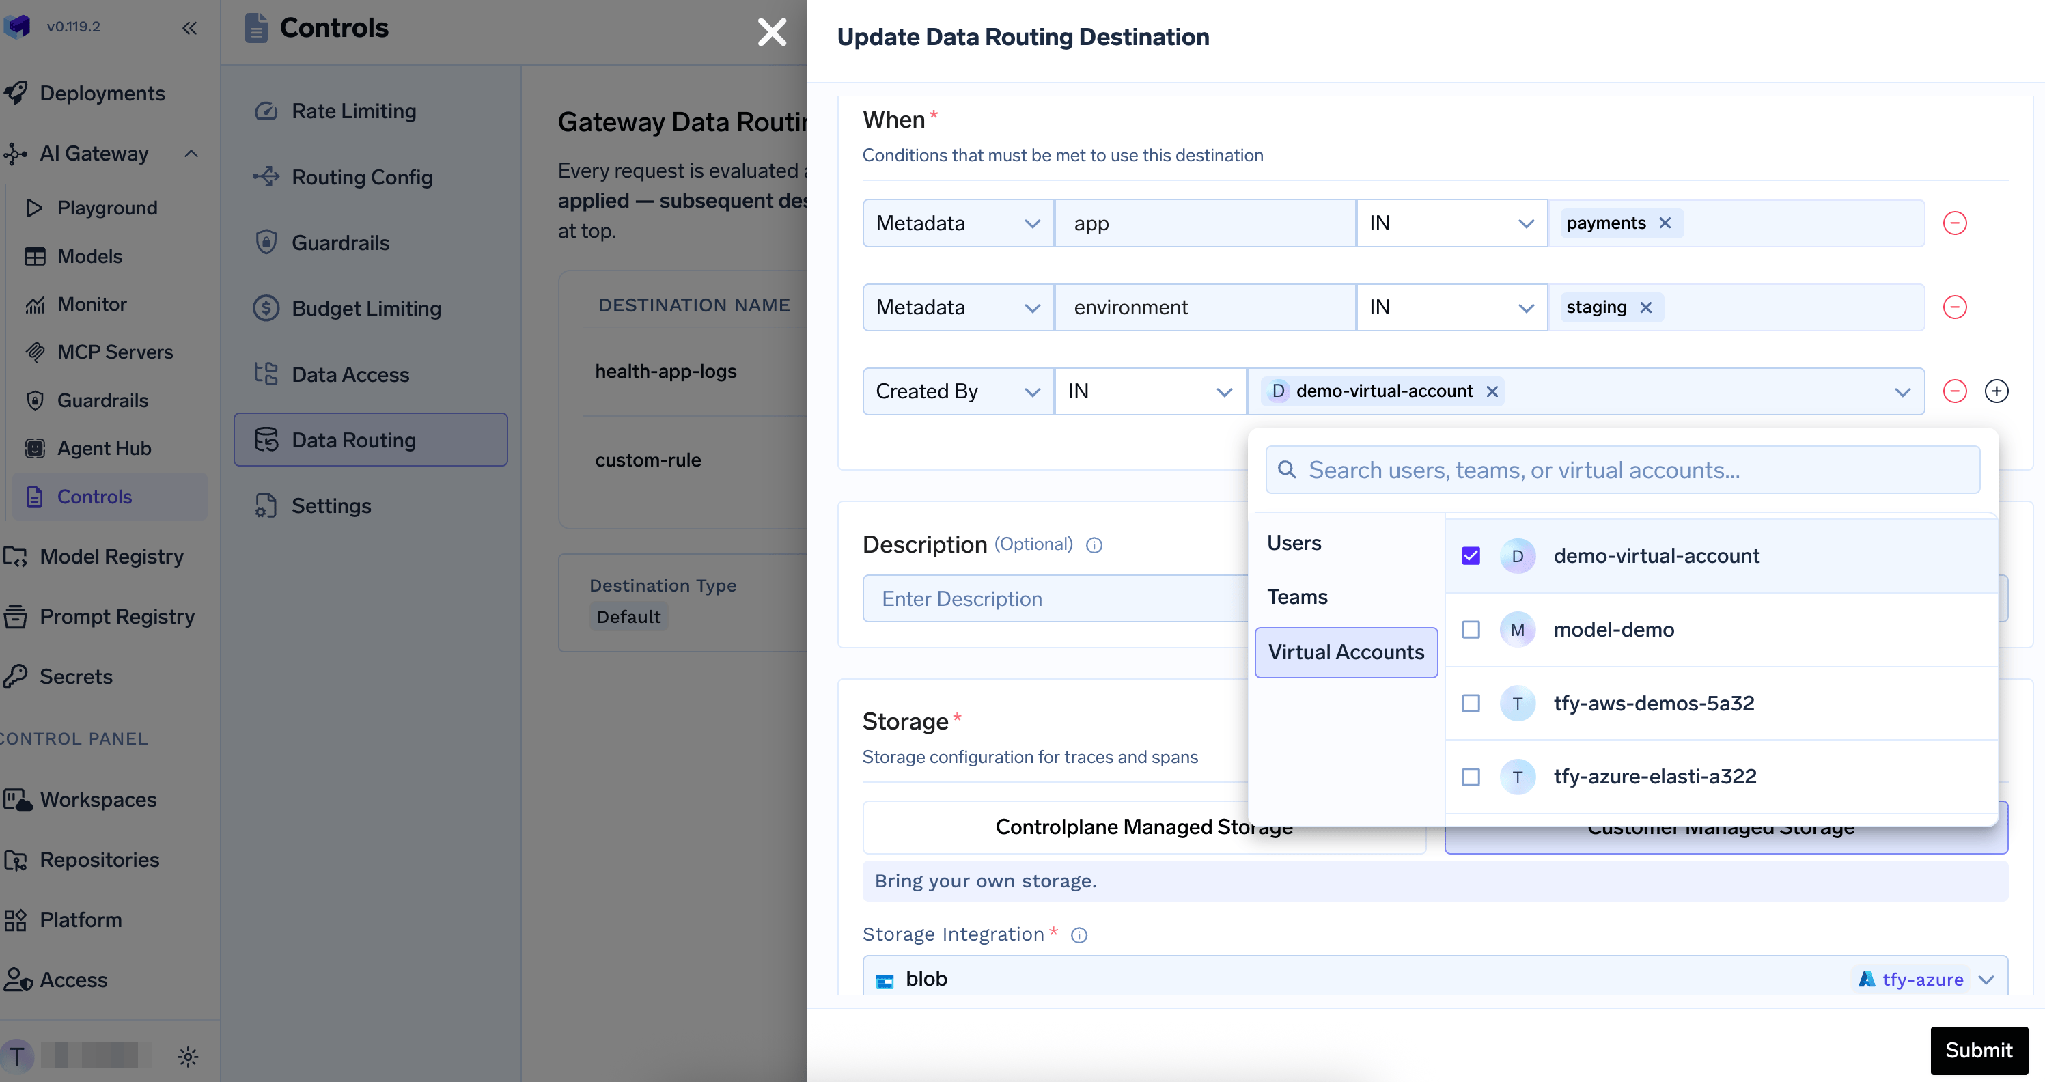
Cada destino é um armazenamento gerenciado pelo plano de controle, com uma região selecionável no SaaS para residência de dados, ou seu próprio bucket S3, GCS ou Azure Blob:
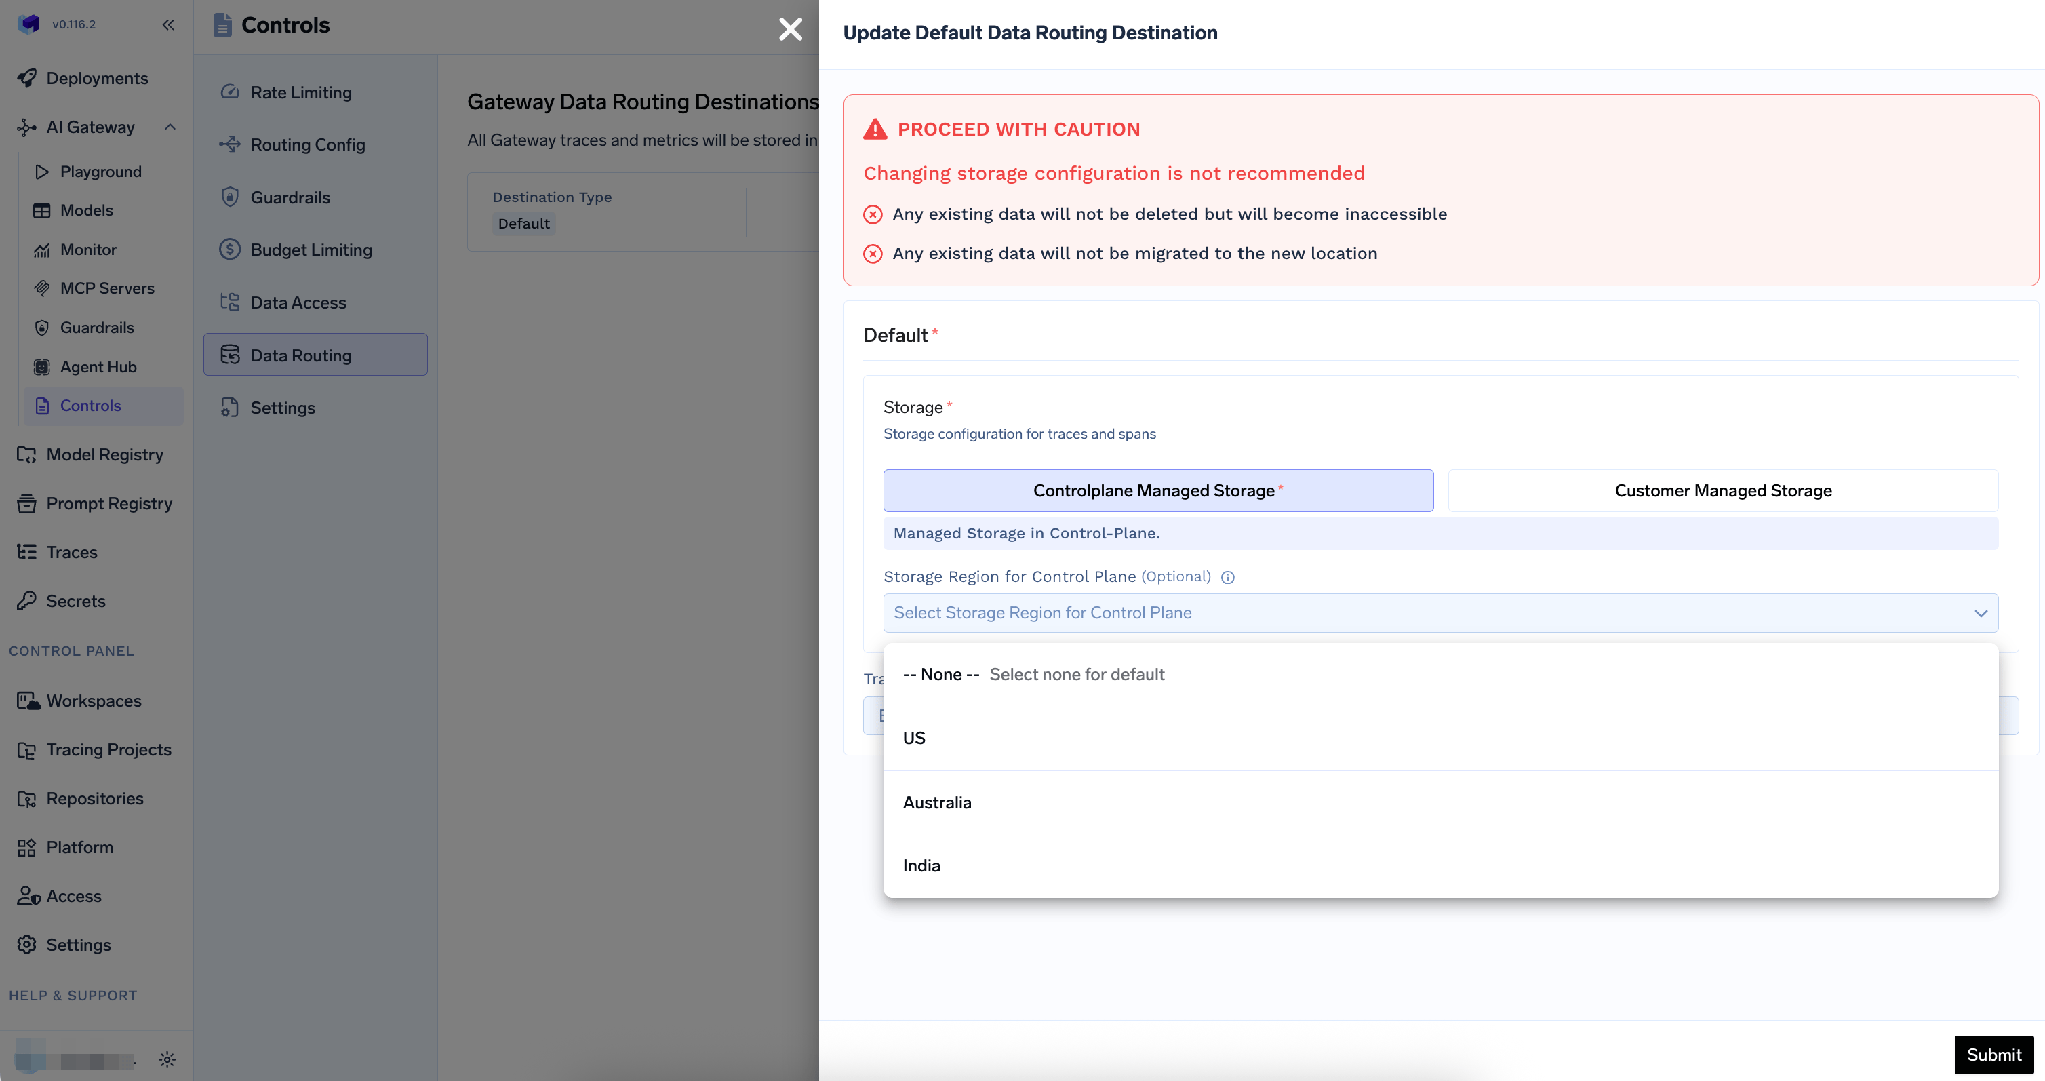
Existem dois limites a considerar ao projetar a solução. As métricas sempre vão para o destino padrão e são mantidas para sempre — apenas os traces podem ser roteados de forma customizada. E alterar uma configuração de armazenamento não migra nada: os dados existentes não são excluídos, mas ficam inacessíveis a partir da nova localização.
Resolvendo o problema errado. Uma equipe preocupada com gastos cria uma divisão ponderada entre três provedores. Os pesos não sabem quais requisições são difíceis, então a fatura mal se move. Uma equipe preocupada com quedas ativa o roteamento por complexidade e fica surpresa quando um incidente no provedor ainda a tira do ar. Defina o problema antes de escolher o mecanismo.
Assumindo que a perda de prioridade por falha é universal. No roteamento por peso, prioridade e latência, um destino que falha é rebaixado para o final da lista. No Auto Routing isso não acontece — a ordem dos destinos é sempre a ordem das camadas, e a cadeia de escalonamento é o caminho de failover. Tentativas por destino, códigos de status de fallback, limites de taxa e orçamentos ainda se aplicam; o comportamento de tempo de espera (cooldown) não.
Tratando um classificador como gratuito. A heurística realmente é. O classificador LLM é uma segunda chamada de modelo a cada turno não fixado, cobrada e rastreada como qualquer outra requisição. Frequentemente vale a pena — mas deve estar no seu modelo de custos, não na sua fatura como uma surpresa.
Rotear sem um limite de gastos. O roteamento consciente de custos reduz o custo médio por requisição; ele não limita o gasto total. Um loop descontrolado de agente desfaz um trimestre de economia. O roteamento de modelos é a inclinação, as regras de orçamento são o teto, e você quer ambos.
Um produto de suporte envia tudo para um modelo de ponta. A fatura está desconfortável, um provedor teve uma semana ruim no mês passado e o jurídico está perguntando onde as conversas dos clientes da UE são processadas. Todos os três tipos, uma única aplicação.
Passo um: seleção de modelo. Crie um modelo virtual support/assistant com roteamento Complexity. Aponte simple para um modelo pequeno e rápido, medium para um modelo intermediário, complex para o modelo de ponta e mantenha o classificador heurístico ativado. A aplicação muda uma única string — o nome do modelo.
O comportamento de múltiplos turnos não precisa de configuração. Cada turno é classificado, e a fixação avança apenas para cima: se o turno quatro for mais difícil, a conversa sobe; se o turno cinco for “obrigado”, ela permanece onde está. Uma fixação sobrevive a dez minutos de inatividade e é renovada a cada turno. Assim que uma conversa atinge complex, os turnos posteriores pulam totalmente a classificação.
Passo dois: balanceamento de carga dentro de uma camada. Dê à camada complex um segundo destino em um provedor diferente. Os destinos da mesma camada são tentados na ordem de declaração antes de escalonar, de modo que o modelo de ponta tenha um par para fazer failover. O painel permite um destino por camada, portanto esse formato exige o tfy apply ou a API.
Passo três: roteamento de dados. Adicione metadata_match: { tfy_gateway_region: EU } a um destino implantado na UE com uma regra genérica (catch-all) abaixo dele, e depois um destino de Data Routing enviando traces onde metadata.region for eu para um bucket na UE.
Passo quatro: o teto de gastos. Uma regra de orçamento limitada ao ID do modelo virtual limita os gastos, independentemente de como o roteamento se comporte:
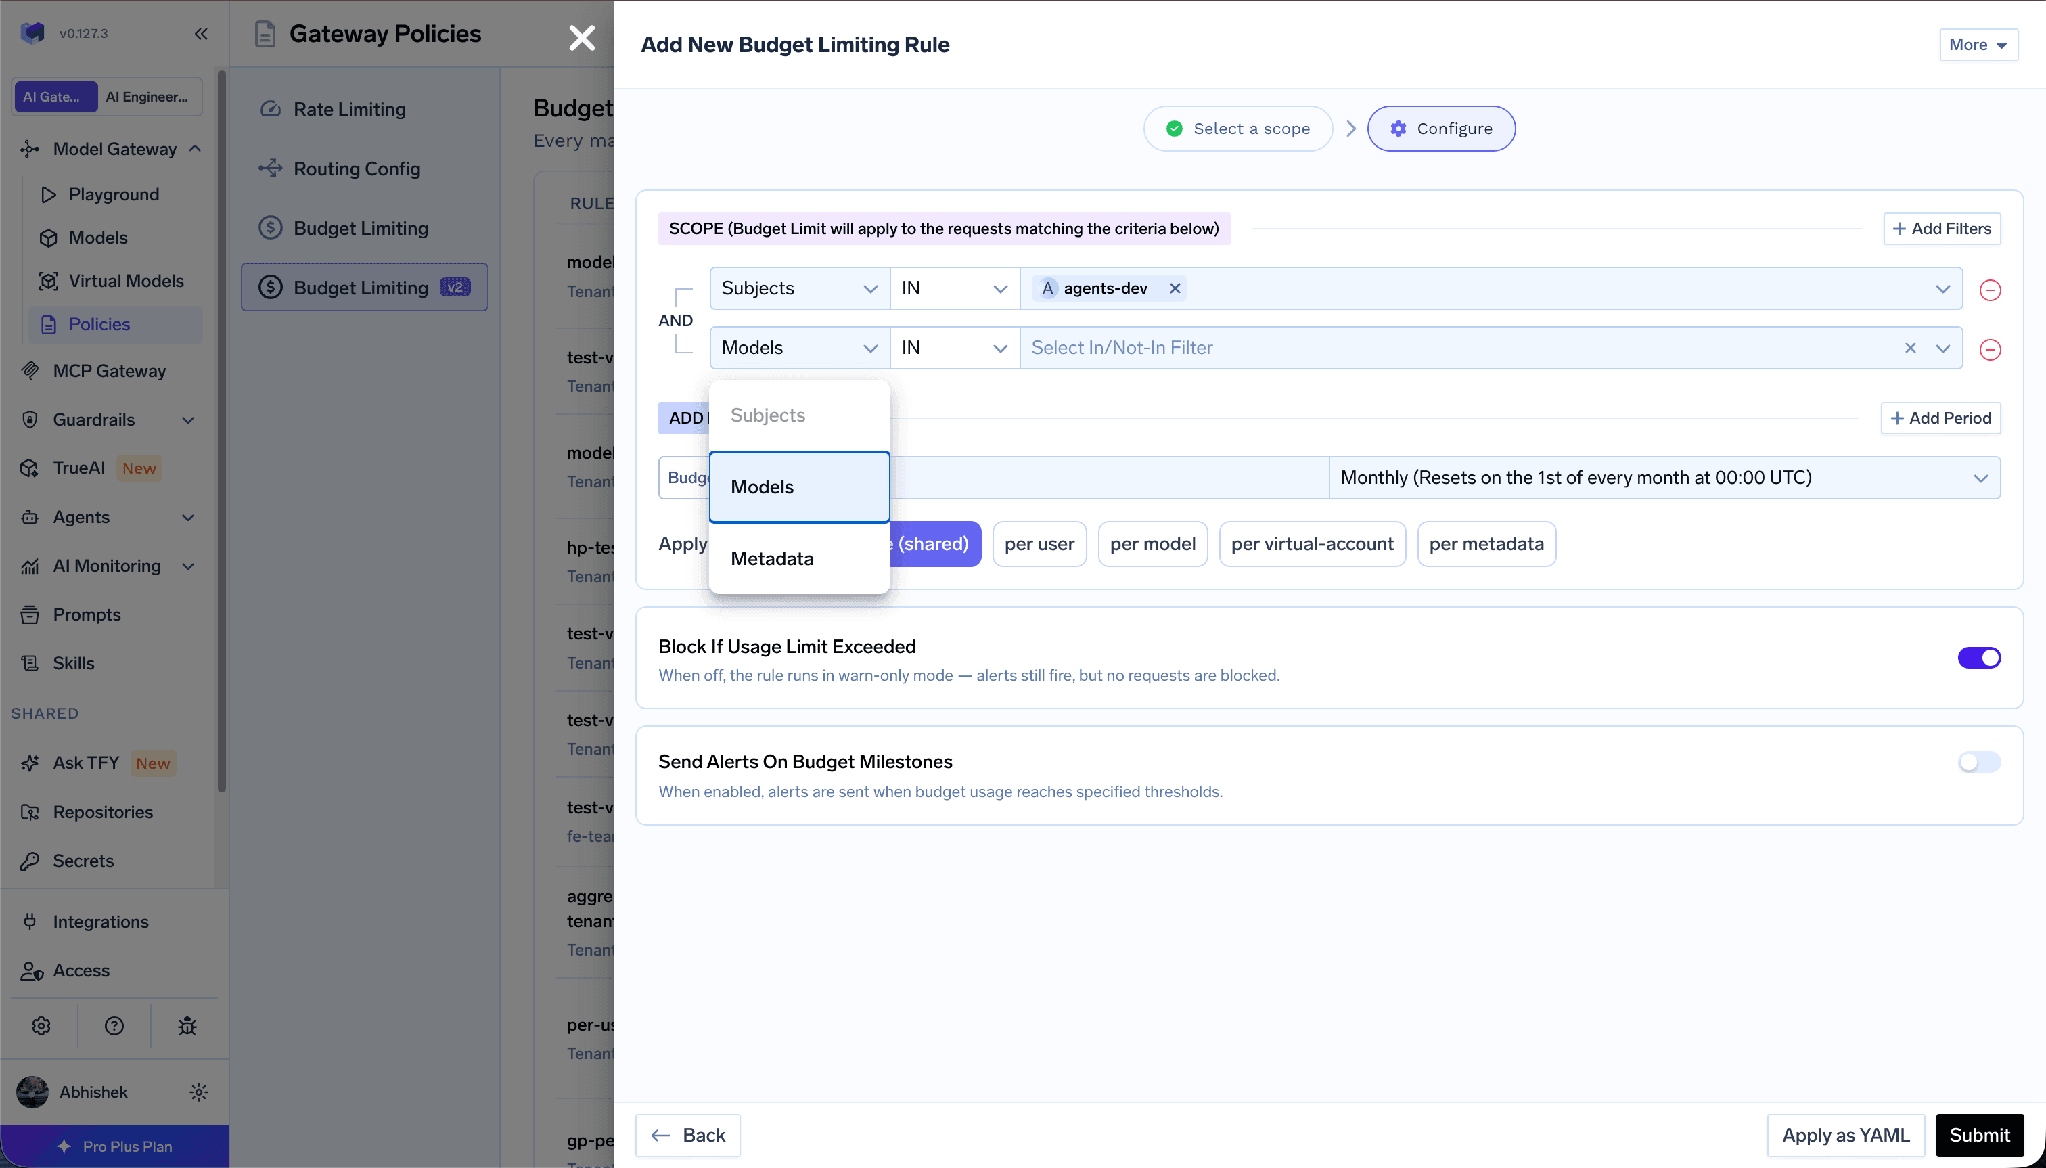
Filtros de escopo de regra de orçamento com condições de Subjects, Models e Metadata
Essa regra corresponde tanto ao ID do modelo virtual quanto ao destino concreto em que ele se resolve, e os dois se comportam de maneira muito diferente. Um orçamento de modelo virtual violado no modo de imposição (enforce) bloqueia toda a requisição antes que qualquer backend seja executado, e os destinos de fallback não são tentados. Um orçamento de destino concreto violado pula apenas esse destino, e o modelo virtual faz o fallback para outro. O mesmo recurso, mas com raios de impacto opostos.
Passo cinco: verifique. Cada resposta carrega x-tfy-applied-rules com a camada atendida, a causa e a cadeia ordenada completa, além de x-tfy-resolved-model nomeando o modelo que respondeu. O contador ai_gateway_complexity_routing_decisions_total se divide por decided_tier, resolved_tier e cause — multiplique a participação de tráfego de cada camada pela diferença de preço para obter sua economia real, não um valor de folheto.
O Auto Routing é exclusivo para modelos virtuais. Ele não é um tipo de regra válido no YAML de roteamento no nível do tenant e é rejeitado para tipos de modelo de embedding, imagem, áudio, rerank e moderação — apenas chat, completion e responses. Listas mistas também falham: declarar tanto chat quanto embedding é rejeitado no momento do salvamento.
O escalonamento cobre camadas que você nunca configurou. Com destinos apenas nas camadas simple e complex, qualquer coisa classificada como medium escalona para complex e o cabeçalho relata isso. Essa é uma configuração suportada de duas camadas — mas se decided_tier e resolved_tier continuarem divergindo por outro motivo que não seja o session_pin, uma camada está ausente ou mal configurada.
O classificador lê apenas duas mensagens. A última mensagem do usuário e a última mensagem do sistema ou desenvolvedor, limitadas a 8.000 e 2.000 caracteres. Turnos anteriores, respostas do assistente e mensagens de ferramentas são ignorados. A consistência ao longo de uma conversa vem da fixação (pinning), não da leitura do histórico.
“Roteador de LLM” parece uma categoria vaga porque são três categorias sob uma mesma etiqueta. O balanceamento de carga é uma ferramenta de disponibilidade e os destinos são intercambiáveis. A seleção de modelo é uma ferramenta de custo e os destinos definitivamente não são. O roteamento de dados é uma ferramenta de conformidade e restringe o conjunto antes que qualquer um dos outros possa votar.
Separados, cada um exige uma decisão simples. Você está perdendo requisições devido a quedas, pagando demais por requisições fáceis ou respondendo a perguntas sobre para onde os dados vão? O primeiro exige uma cadeia de prioridades, o segundo exige camadas de complexidade e o terceiro exige correspondência de metadados e um destino de armazenamento. A maioria das equipes precisa de um urgentemente e dos outros eventualmente.
E quando você recorrer à opção de custo, considere o valor publicado pelo que ele realmente é em ambas as direções. Sessenta e nove por cento de desconto é real. Assim como os dois por cento de qualidade que isso custou.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



Um LLM router fica entre a sua aplicação e os seus modelos e decide qual modelo ou implantação atende cada requisição. O termo abrange três funções distintas: balanceamento de carga entre destinos intercambiáveis, para vazão e failover; seleção de modelo entre um mais barato e um mais forte; e roteamento de dados, que restringe onde uma requisição pode ser processada e onde seus logs ficam. Cada uma lê entradas diferentes, então a primeira pergunta é de qual delas você precisa.
O roteamento por seleção de modelo, sim; o balanceamento de carga e o roteamento de dados, em geral, não. O Auto Routing do TrueFoundry registrou em benchmark 69% de economia de custos com 98% da qualidade preservada em 550 prompts avaliados, e até 80% em tráfego semelhante ao de produção. A economia depende do seu mix de tráfego: detalhe a métrica de decisões de roteamento por nível resolvido e multiplique a participação de cada nível pela diferença de preço.
Roteamento baseado em complexidade em um único modelo virtual com o classificador heurístico gratuito, porque não exige mudanças na aplicação nem gasto com classificador. Adicione uma cadeia de prioridade entre dois provedores assim que uma indisponibilidade tiver custado algo a você. Adicione roteamento de dados quando alguém perguntar para onde os dados vão.
Sim — em VPC, on-prem, air-gapped, híbrido ou em várias nuvens, sem que nenhum dado saia do seu domínio.
Cerca de 3 a 4 ms de sobrecarga, atendendo mais de 350 RPS em uma única vCPU, com mais de 1.000 LLMs compatíveis. A exceção é o classificador LLM opcional, que adiciona uma chamada real a um modelo antes de a requisição ser encaminhada.
Sim. O gateway é compatível com OpenTelemetry e se conecta ao Grafana, ao Datadog ou ao Prometheus. Cada chamada ao classificador LLM gera o seu próprio span, então a latência do classificador fica visível separadamente da do modelo servido.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















