October 12, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.


Published: October 8, 2026
Blazingly fast way to build, track and deploy your models!
Uma importante pesquisa de 2026 sobre a segurança de agentes LLM chega a uma conclusão que as equipes corporativas devem levar a sério: uma vez que um modelo pode usar ferramentas, reter estado e agir em nome de outra pessoa, a segurança deixa de ser apenas um problema de filtragem de prompts. Torna-se um problema de sistemas que abrange fluxo de informações, autoridade delegada e estado persistente.
A pesquisa parte de um fato arquitetural simples: um agente LLM faz mais do que gerar texto. Ele pode planejar, invocar ferramentas, navegar, executar código, atualizar estados e coordenar-se com outros agentes. Essas capacidades transformam as saídas do modelo em entradas para o fluxo de controle de software.
Isso altera o modo de falha. Uma instrução maliciosa oculta em uma página da web pode influenciar uma chamada de ferramenta posterior. O resultado de uma ferramenta envenenada pode se tornar contexto para outra decisão. Uma entrada de memória comprometida pode sobreviver à sessão original. Uma credencial delegada pode transformar um plano ruim em um efeito colateral real. Em um sistema multiagente, a mesma informação contaminada pode se propagar além do agente que a encontrou primeiro.
Portanto, a pesquisa estrutura a segurança de agentes em torno de três propriedades interativas:
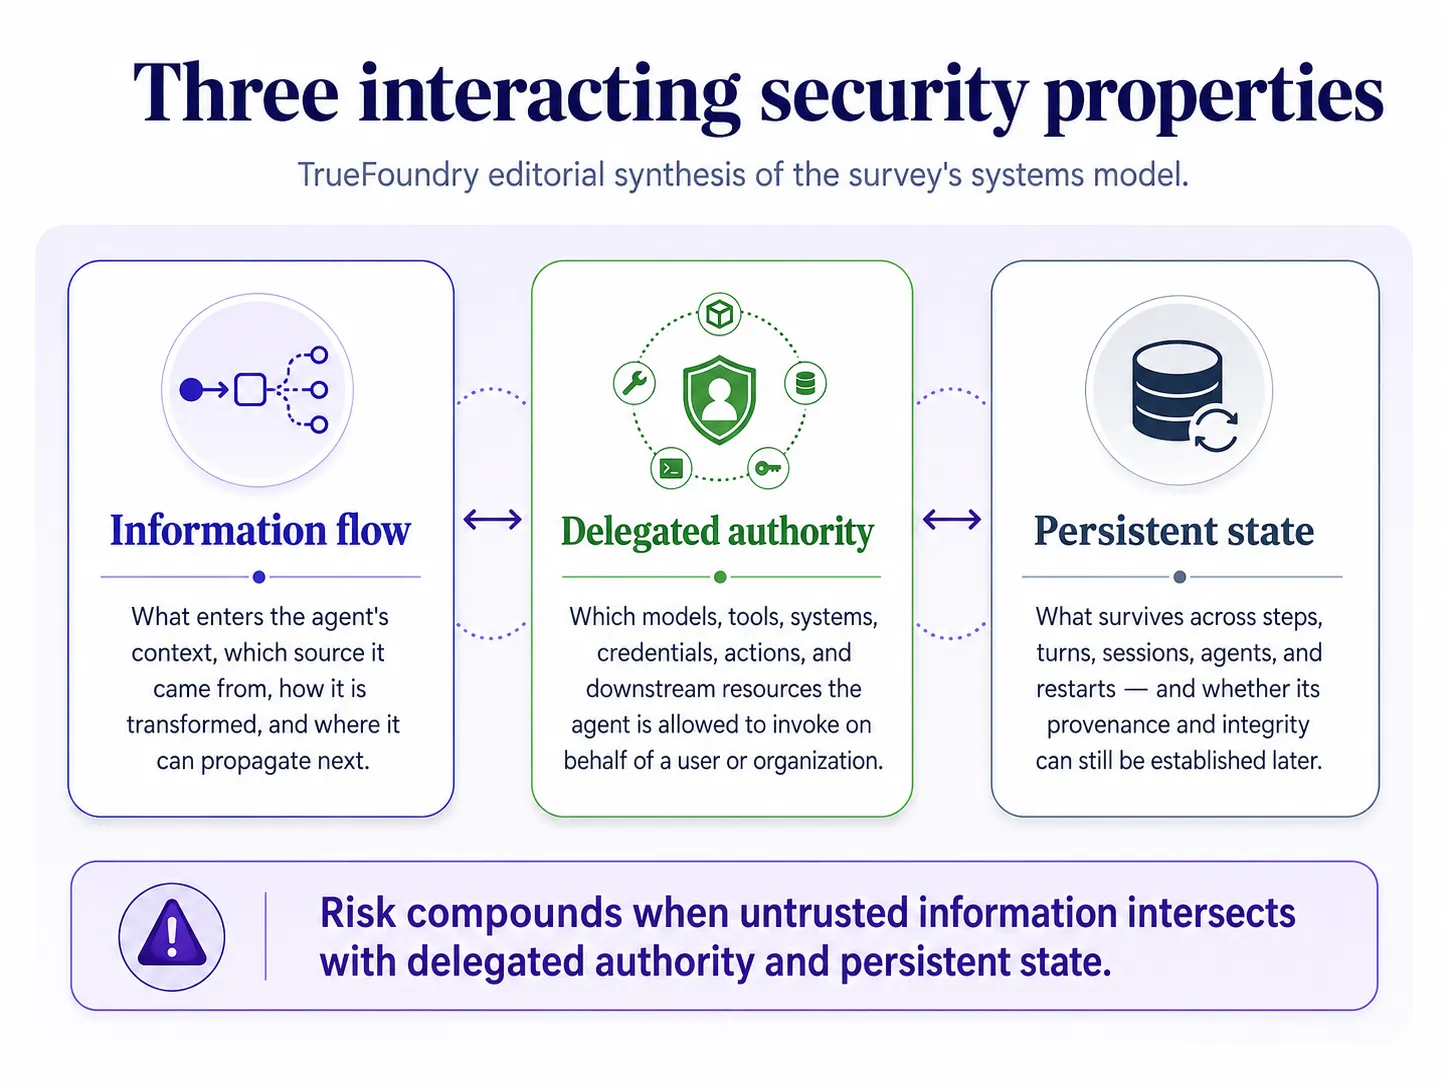
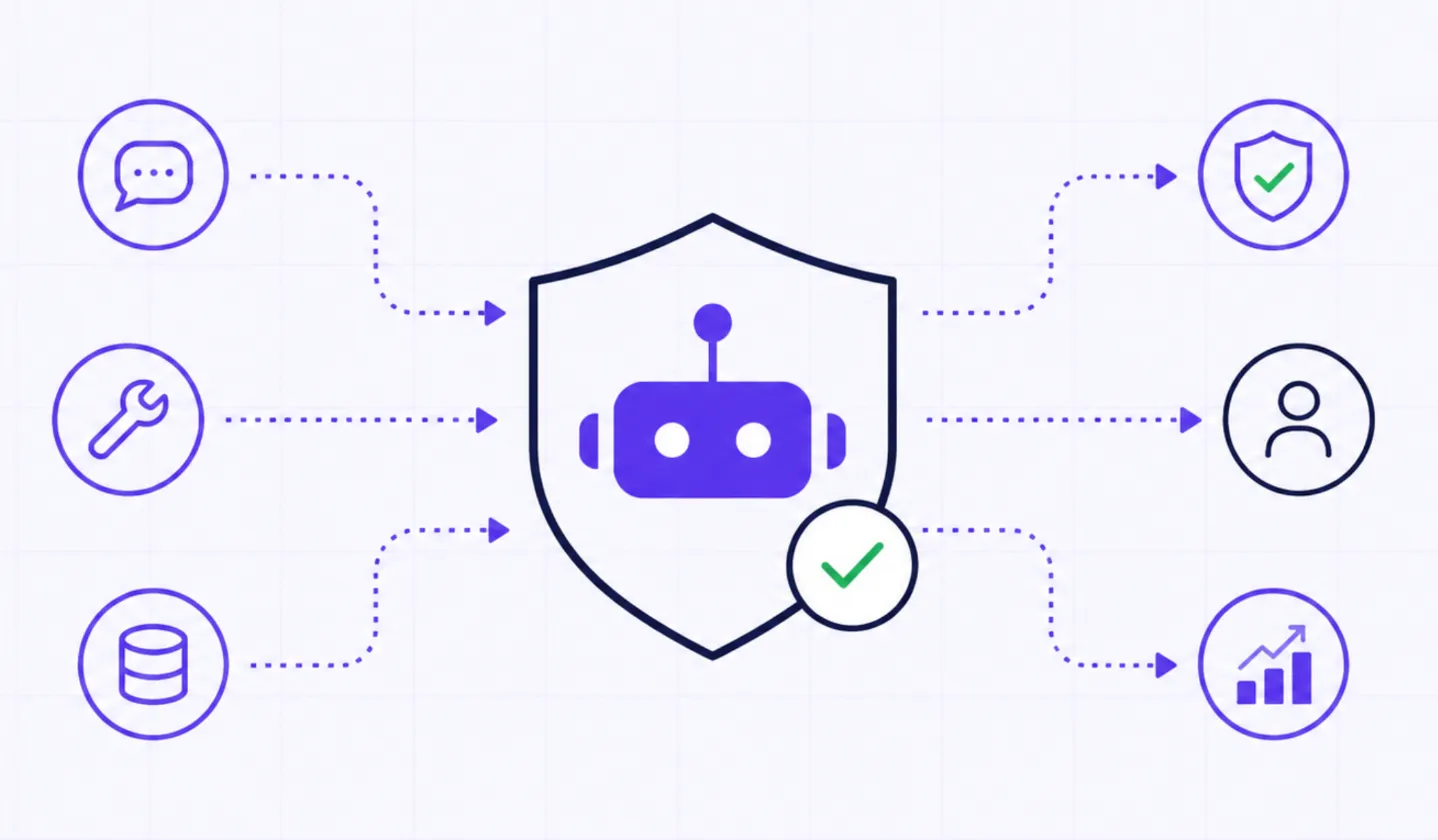
A implicação útil é que uma arquitetura de agente segura não deve perguntar apenas: "Bloqueamos o prompt malicioso?". Ela também deve perguntar: o que esse conteúdo poderia influenciar, que autoridade a trajetória resultante poderia exercer e que estado a trajetória poderia deixar para trás?
Ling e coautores utilizam uma estrutura baseada no ciclo de vida e orientada a sistemas, em vez de uma lista simples de nomes de ataques. Operacionalmente, é útil separar o caminho de ação principal — entrada, planejamento, decisão, execução de ferramenta e saída — de superfícies transversais como memória, monitoramento e coordenação multiagente, pois essas superfícies podem influenciar ou observar múltiplos estágios da execução.
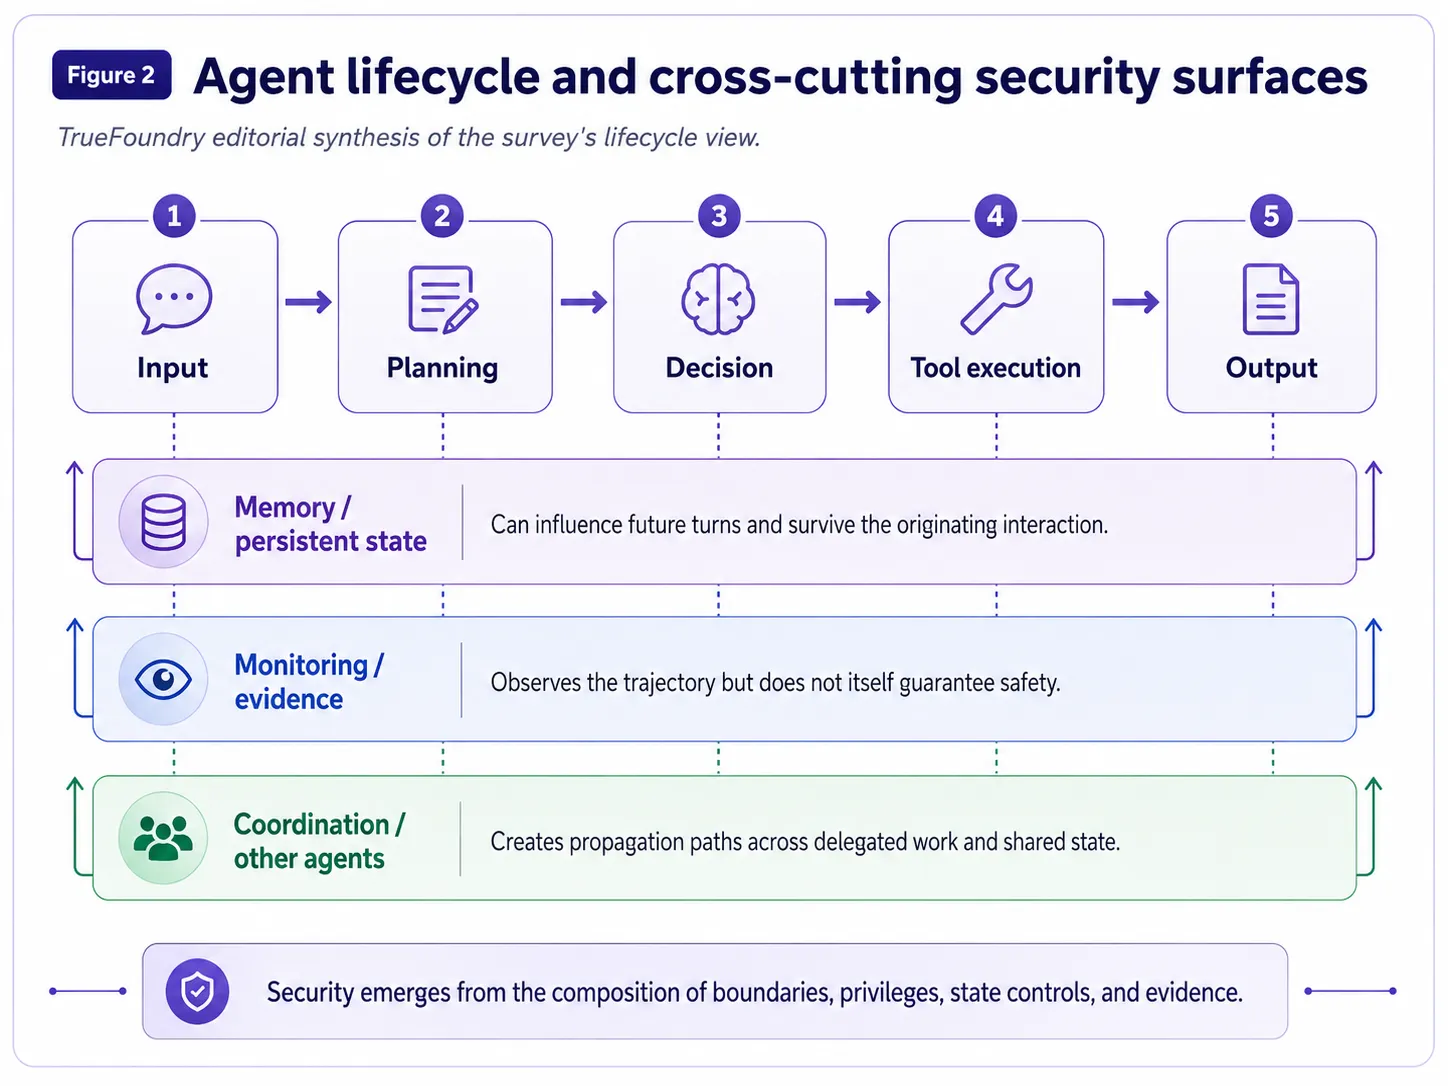
Essa perspectiva de ciclo de vida também explica por que as defesas podem ser "fracamente composicionais", como diz a pesquisa. Um filtro de conteúdo pode bloquear uma classe de texto malicioso, mas não fazer nada contra credenciais com privilégios excessivos. Um sandbox pode conter a execução de código, mas não impedir uma chamada de API autorizada. Um portão de aprovação pode impedir um efeito colateral, mas não uma gravação de memória envenenada. Um rastreamento pode tornar um incidente observável sem impedi-lo.
A segurança, portanto, emerge da composição de limites, privilégios, controles de estado e evidências.
O mapeamento de produto mais claro não é "a TrueFoundry resolve a segurança de agentes". É perguntar qual parte do modelo de sistemas da pesquisa cada camada pode governar de forma realista.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.





As últimas notícias, artigos e recursos enviados para sua caixa de entrada