



November 10, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Ambas são plataformas de GPU serverless, ambas escalam para zero por padrão e ambas executam tráfego de produção para empresas que você conhece. É uma disputa justa, mas elas têm naturezas diferentes. A Baseten construiu uma plataforma de servir modelos e a expandiu. A Modal construiu uma plataforma de computação geral onde a inferência é apenas um de seis produtos. Isso fica evidente no SDK, no que é contabilizado na tabela de preços e na possibilidade de executar em sua própria conta.
O ponto mais útil abaixo é a metodologia de precificação, porque as taxas horárias de GPU publicadas são incomparáveis entre as duas, e a margem de erro é grande o suficiente para mudar uma decisão. Dados verificados em 25 de setembro de 2026.
A Baseten oferece inferência em produção para modelos open-source, personalizados e ajustados (fine-tuned), por meio de Implantações Dedicadas, APIs de Modelo por token e Treinamento (preços).
Fundada em 2019 por Tuhin Srivastava (CEO), Amir Haghighat (CTO), Phil Howes e Pankaj Gupta. O financiamento passou pelas Séries B, C, D e uma Série E de US$ 300 milhões a US$ 5 bilhões, chegando a uma Série F de US$ 1,5 bilhão com valuation de US$ 13 bilhões em 22 de junho de 2026(anúncio); total captado "mais de US$ 2 bilhões". A receita teria crescido 20x ano a ano; o ARR não foi publicado [VERIFICAR]. Os clientes incluem Cursor, Notion, Harvey, HubSpot, OpenEvidence e Vercel.
Sobre um número que você pode ter visto: reportagens da imprensa no final de setembro de 2026 (Axios 22 de set, Bloomberg 23 de set) descrevem negociações em torno de uma rodada muito maior, próxima de um valor reportado de US$ 26 bilhões. A Baseten não publicou nada. US$ 13 bilhões é o último valor confirmado e aquele que usamos.
[CAPTURA DE TELA: Baseten — o painel de Implantações Dedicadas mostrando estados de réplicas, configuração de escalonamento automático e percentis de latência para um modelo em tempo real]
A Baseten também adquiriu a Blaxel, uma empresa de infraestrutura de microVM e agent-sandbox, anunciou 10 de setembro de 2026, termos não divulgados (anúncio) — um movimento direto para o território das Sandboxes da Modal, com duas semanas de existência e nada lançado para avaliação ainda.
Genuinamente melhor para: compradores em setores regulados que precisam de inferência em sua própria VPC, onde a Modal não tem equivalente; qualquer pessoa que lide com PHI, já que a conformidade com HIPAA está disponível no plano gratuito; equipes que desejam otimização de nível TensorRT-LLM sem precisar desenvolvê-la; e cargas de trabalho com GPUs pequenas ou restritas a regiões específicas.
A Modal se autodenomina “uma nuvem criada para IA. Não uma nuvem de GPU de propósito único, mas uma plataforma com as primitivas certas”(Post da Série C). Produtos: Inferência, Sandboxes, Treinamento, Notebooks, Batch, Plataforma Principal. Essa lista é o argumento — a inferência é apenas um item.
Fundada em 2021 por Erik Bernhardsson e Akshat Bubna; o ano de fundação vem do TechCrunch, não de uma página da Modal [VERIFICAR]. A equipe construiu seu próprio sistema de arquivos, runtime de contêiner, agendador e construtor de imagens, o que se reflete nos números de cold-start. O financiamento passou por rodadas seed, Série A e uma Série B de US$ 87 milhões com valuation de US$ 1,1 bilhão, chegando a uma Série C de US$ 355 milhões com valuation de US$ 4,65 bilhões em 21 de maio de 2026; total “acima de US$ 466 milhões”. A Modal publica o que a Baseten não publica — “ultrapassando US$ 300 milhões em receita anualizada”, e que “as Sandboxes já representam mais de um terço da nossa receita”Entre nossos clientes estão Cognition, DoorDash, Suno e Ramp.
[CAPTURA DE TELA: Modal — o painel do aplicativo mostrando contagem de containers, utilização de GPU e tempo de inicialização a frio para uma Função implantada]
[CAPTURA DE TELA: Modal — a página de preços mostrando a tabela de GPU ao lado dos itens de linha separados de CPU e memória]
Realmente melhor para: qualquer coisa que não seja um servidor de modelo — sandboxes, código não confiável, ambientes de RL, processamento em lote, notebooks. Ergonomia do Python. Cargas de trabalho com GPUs grandes, não fixas e com picos. Variedade de GPUs, já que L40S, A100 40GB e B300 não possuem equivalente no Baseten. E cold starts com inicialização pesada, dominados por JIT e importações em vez de carregamento de pesos.
A abordagem honesta sobre cold starts: eles resolvem metades diferentes do mesmo problema. O Baseten ataca a entrega de pesos e remove a transferência da contagem de faturamento. O Modal ataca o estado do processo com restauração de snapshot, o que explicitamente não ajuda no carregamento de pesos. Se o seu cold start envolve 140 GB de pesos, a abordagem do Baseten é a relevante; se for importações, JIT e captura de grafo CUDA, a do Modal é a ideal.
Metodologia. O Baseten publica tarifas por minuto para SKUs de instância all-in — a GPU vem com vCPU e RAM fixas. O Modal publica tarifas por segundo para o Apenas GPU, com CPU e memória cobrados separadamente. Para comparar itens equivalentes, converta ambos para o valor por hora (Baseten x60, Modal x3600) e, em seguida, adicione à tarifa de GPU da Modal a CPU e a memória que a Baseten inclui no pacote, usando as próprias tarifas da Modal: US$ 0,04716 por hora de núcleo físico (um núcleo = dois vCPUs) e US$ 0,007992 por hora de GiB. Multiplicadores de fixação (pinning) e instâncias não preemptíveis estão excluídos; adicioná-los torna a Modal ainda mais cara. Fontes: baseten.co/pricing,docs.baseten.co/deployment/resources,modal.com/pricing.
L40S e A100 40GB não possuem SKU da Baseten para ajuste.
A conclusão: "A Modal é 40% mais barata na H100" cai para cerca de 19% quando você adquire CPU e memória comparáveis, fica em quase paridade na A100 80GB, einverte-se em GPUs pequenas, onde a Baseten é de 9 a 22% mais barata. Adicione a fixação ou o multiplicador de 3x para instâncias não preemptíveis e a Baseten vence com folga em qualquer carga de trabalho garantida.
Um detalhe para quem faz benchmarks: o gpu="A100" básico da Modal pode ser atualizado silenciosamente para 80GB, e o gpu="H100" pode acabar em uma H200. Fixe isso usando gpu="H100!".
1. A tabela de preços não é a fatura. As equipes calculam o orçamento com base no número de GPUs por hora e, em seguida, somam os multiplicadores de CPU, memória, volumes, região e uma taxa de sandbox 3x. O agrupamento da Baseten é mais fácil de prever; a discriminação da Modal é mais fiel ao consumo. Nenhuma das duas é comparável sem o cálculo acima.
2. A seleção de região não é residência de dados. A Modal fixará um contêiner em eu-west e ainda armazenará seus logs, armazenamento durável e qualquer payload acima de 2 MiB nos EUA. Se um órgão regulador estiver perguntando, a região do contêiner não é a resposta.
3. O servidor de modelo é apenas parte do sistema. Você também tem APIs de modelos comerciais, autenticação, atribuição de custos, limites de taxa, guardrails e uma trilha de auditoria. Nenhuma das plataformas é essa camada, e adotar qualquer uma delas ainda deixa essa responsabilidade para você.
Uma resposta direta, em vez de uma disputa forçada entre três opções. Baseten e Modal são nuvens de inferência hospedadas. A TrueFoundry é executada na sua conta de nuvem. Comprador diferente, problema diferente.
Elas respondem à pergunta: "como sirvo este modelo sem operar GPUs?". A TrueFoundry responde: "já temos capacidade de GPU, gastos comprometidos ou um órgão regulador, e precisamos de uma plataforma em nossa própria infraestrutura". Se a primeira pergunta é a sua, compre uma delas — o modo auto-hospedado da Baseten é o que mais se aproxima.
O TrueFoundry pode ser implantado como SaaS em mais de 12 regiões em três nuvens, ou auto-hospedado em sua VPC via Helm e OpenTofu/Terraform, ou on-premise, ou em ambientes isolados (air-gapped). Na versão auto-hospedada, todo o tráfego de LLM permanece dentro da sua infraestrutura e o TrueFoundry não faz parte do caminho de execução. O serviço abrange vLLM, SGLang, Triton, TorchServe, MLflow e LitServe, além de um registro de modelos, escalonamento automático por CPU, RPS ou cron, e GPUs fracionadas via time-slicing e MIG — o que é importante quando você possui o hardware e um H100 inteiro para um modelo pequeno é desperdício.
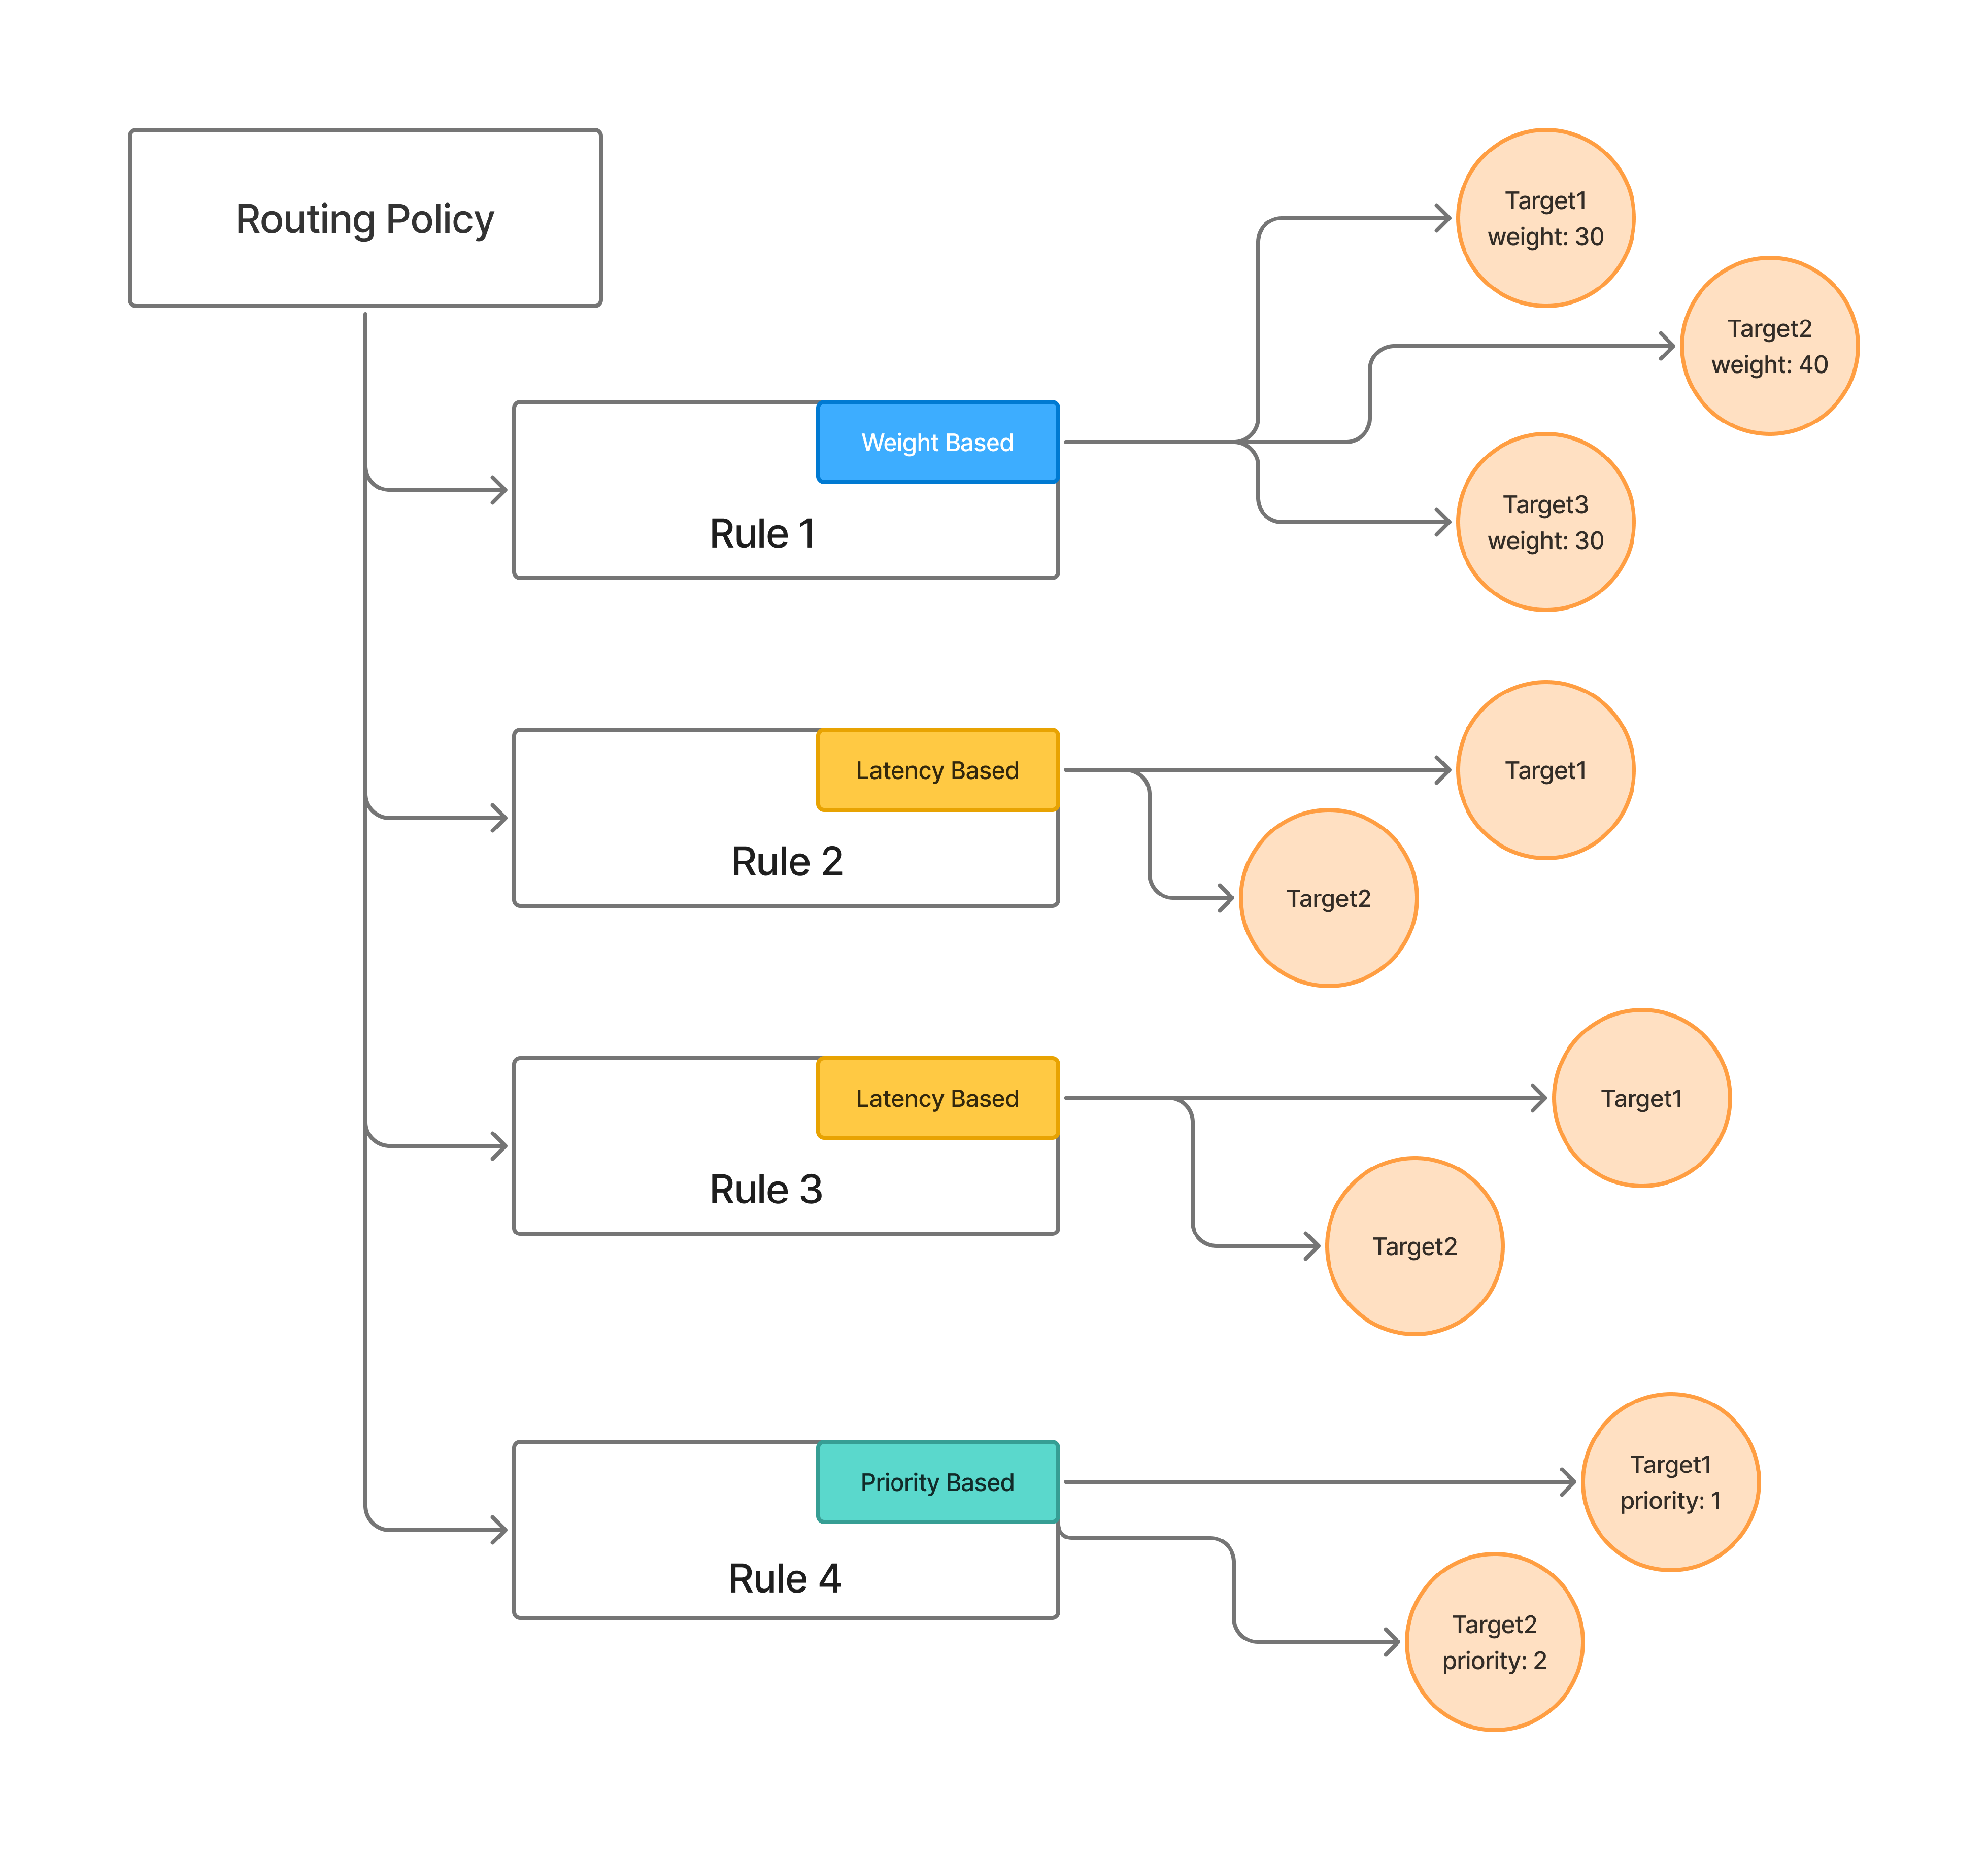
A outra metade é o Gateway de IA, onde a inferência auto-hospedada e a hospedada deixam de ser problemas separados. Ele centraliza Mais de 1.000 LLMs atrás de uma única API compatível com OpenAI, adicionando aproximadamente 3-4 msde latência e processamais de 350 RPS em 1 vCPU, para que seu endpoint Baseten, seu endpoint Modal e sua chave da OpenAI fiquem atrás de uma única interface com atribuição de custos compartilhada, limites de taxa e trilha de auditoria. O Roteamento Automático é a alavanca de custos: em 550 prompts, o roteamento por complexidade reduziu o custo 69%mantendo98% de qualidade, com a latência média caindo de 7,6s para 4,0s.
Limite honesto: o TrueFoundry não é um marketplace de GPU serverless — você traz a capacidade. Se você não tem GPUs e não deseja adquirir nenhuma, escolha o Baseten ou o Modal.
Baseten e Modal são ambas boas opções. A comparação é acirrada no critério que as pessoas verificam primeiro — preço — mas não é nada próxima nos critérios que realmente definem a contratação.
Se a carga de trabalho precisa ser executada em sua própria VPC, se você lida com PHI, se deseja TensorRT-LLM sem precisar realizar o trabalho de engine, ou se você utiliza GPUs pequenas e fixas, a Baseten é a resposta. Se você precisa de sandboxes, processamento em lote e notebooks junto com a inferência, ou se a ergonomia do Python é o que mais importa, a Modal é a escolha.
O que não faríamos é escolher com base na tarifa de GPU anunciada. Ela não é comparável entre as duas, e ao ajustá-la, uma vantagem aparente de 40% cai para 19%, para paridade ou até mesmo inverte a favor do outro fornecedor.
Se a restrição real é que a carga de trabalho precisa permanecer dentro da infraestrutura que você já possui e paga, nenhuma das plataformas hospedadas é a resposta. Esse é um problema de plano de controle, e é exatamente para isso que construímos nossa solução.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



Depende da GPU, e as tarifas publicadas enganam. Pelos números de tabela, a Modal parece de 37% a 40% mais barata em H100 e A100 de 80 GB. Some a CPU e a memória que a Baseten inclui e a diferença na H100 cai para cerca de 19%, a A100 de 80 GB fica em paridade, e em T4 e A10 a Baseten é de 9% a 22% mais barata. Os multiplicadores de pinning e de capacidade não preemptível da Modal pesam ainda mais a favor da Baseten, e a taxa Team de US$ 250/mês é um custo fixo que a Baseten não cobra.
Starter a US$ 0/mês com US$ 30/mês de computação gratuita; Team a US$ 250/mês com US$ 100/mês de computação gratuita; Enterprise personalizado. A computação é cobrada por segundo e de forma discriminada: GPU com tarifa própria, CPU a US$ 0,04716 por núcleo físico-hora e memória a US$ 0,007992 por GiB-hora. A computação de Sandbox e Notebook custa 3 vezes a tarifa de Function, e o pinning e a capacidade não preemptível têm multiplicadores.
O Basic custa US$ 0/mês no modelo de pagamento por uso, sem taxa de plataforma, incluindo SOC 2 Type II e HIPAA; Pro e Enterprise são sob cotação. A computação de GPU é cobrada por minuto com base em SKUs de instância completos, que agrupam vCPU e RAM — US$ 6,4998/h por uma H100 de 80 GB. As tarifas por token da Model API são publicadas; o valor do crédito gratuito, não.
Os contêineres iniciam em cerca de um segundo, e os Memory Snapshots oferecem restaurações de 3 a 10 vezes mais rápidas, segundo a documentação da Modal. O número “100x” na publicação da Modal sobre a Série C não é sustentado pela própria documentação, então planeje com 3 a 10x. Os snapshots de GPU estão em Alpha e não aceleram o carregamento de pesos a partir do armazenamento.
Não confirmado. A última avaliação que a Baseten publicou é de US$ 13 bilhões, de uma Série F de US$ 1,5 bilhão em 22 de junho de 2026. Reportagens do fim de setembro de 2026 descrevem conversas sobre uma rodada maior, mas são notícias em fase de negociação, e a empresa não publicou nada.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















