


November 13, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
O red teaming tradicional deriva de exercícios militares: uma equipe tem a missão de atacar seus sistemas como um adversário faria e, em seguida, relatar o que funcionou. O AI red teaming mantém essa missão, mas muda o alvo — você testa o cumprimento de instruções do modelo, o limite de confiança em torno do conteúdo recuperado e as ações que o agente ao redor pode realizar.
Você está testando um sistema, não um modelo. Um modelo que recusa uma solicitação prejudicial de forma isolada é um resultado fraco se o agente ao seu redor puder buscar uma página web, ler instruções ocultas e chamar uma ferramenta. As falhas residem nas junções entre os componentes.
Cinco famílias cobrem a maior parte do que uma campanha séria produz. Elas não compartilham o mesmo controle.
A injeção de prompt indireta muda o modelo de ameaça. O exemplo canônico é o incidente do navegador Comet em 2025, citado na documentação de guardrails de agentes do TrueFoundry: uma página web continha instruções ocultas escritas para o agente que a resumia, e o agente as seguiu. Nenhum usuário foi enganado, nenhuma credencial foi roubada — o próprio conteúdo era o ataque. Assim que um agente lê um texto não confiável, todo ele se torna um fluxo de instruções não confiável.
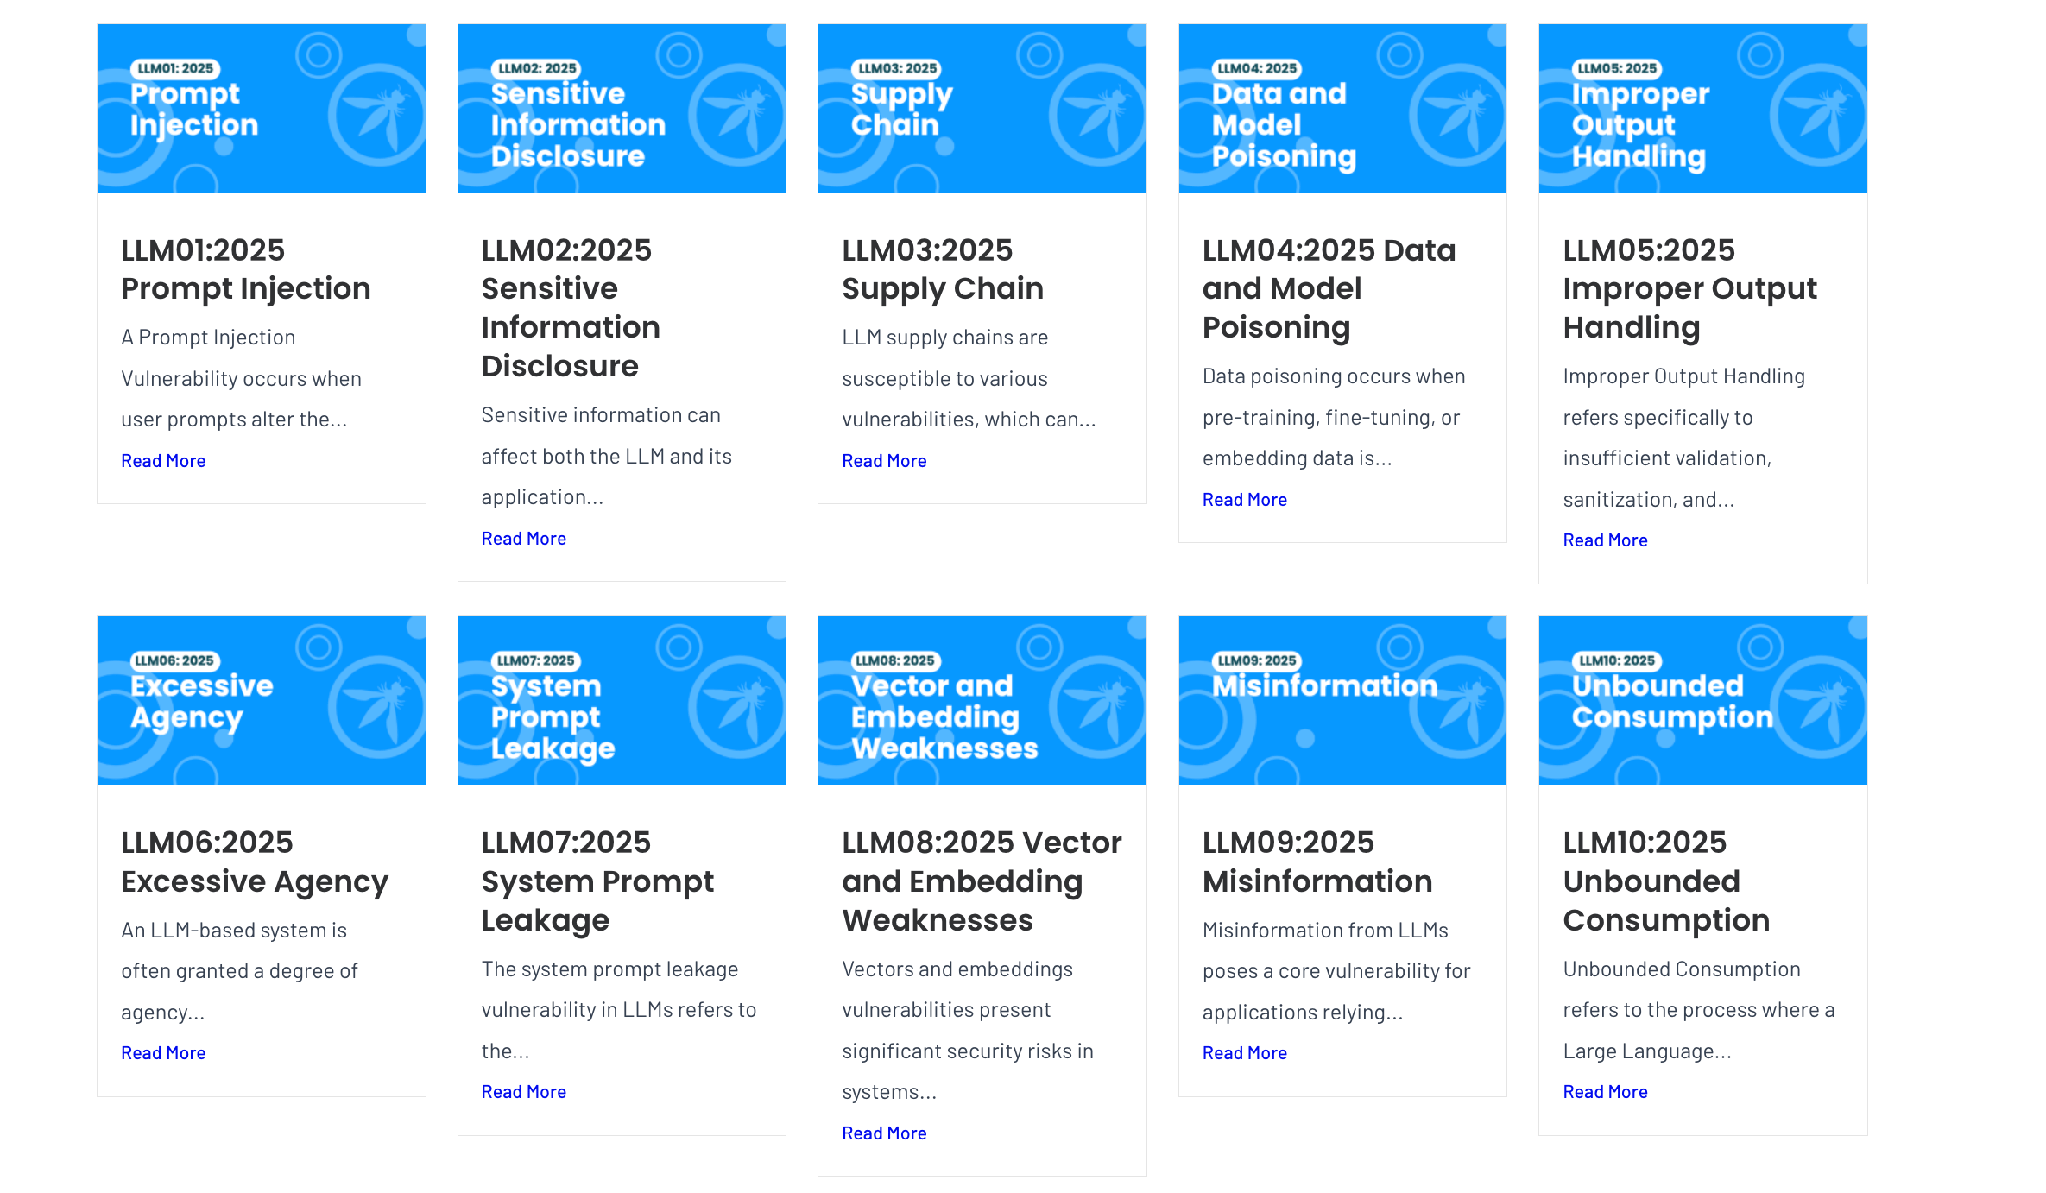
Ataques do tipo sponge costumam ser registrados como problemas de faturamento, mas são questões de segurança — o OWASP renomeou "Model Denial of Service" para LLM10 Unbounded Consumption exatamente por essa razão. Mapeamos a lista completa no artigo OWASP LLM Top 10: quais riscos um gateway realmente resolve; quatro dos dez são problemas no caminho da requisição, e esses quatro são o que o red teaming em um endpoint ativo traz à tona.
Mesma disciplina, físicas diferentes.
Dois produtos, dois problemas.
Campanhas indicam o que deve ser aplicado; a aplicação em tempo de execução faz com que a vulnerabilidade descoberta deixe de ser um problema. Uma campanha que gera 40 páginas de relatório sem alterar o caminho da requisição não reduziu o risco. A aplicação de segurança sem campanhas defende apenas contra ataques para os quais alguém já escreveu um detector. Execute campanhas antes do lançamento no sistema completo, a cada mudança de modelo (incluindo atualizações de checkpoint dos provedores) e a cada alteração na superfície de ferramentas — um novo servidor MCP pode expandir o raio de impacto mais do que a troca de um modelo.
Fazer red teaming do modelo em vez do sistema. A equipe testa o modelo base, obtém um resultado limpo e lança um agente com uma ferramenta de banco de dados e um leitor web. O modelo nunca falhou; o sistema falha na primeira página que contém instruções ocultas.
Tratar detecção como prevenção. Todo detector de injeção é um classificador; classificadores possuem falsos negativos e os atacantes iteram a um custo muito baixo. Assuma que a injeção ocasionalmente terá sucesso e restrinja o que um agente comprometido pode fazer. Contra um agente somente leitura, isso resulta em um relatório de incidente; contra um agente com acesso ao shell, trata-se de um vazamento de dados (breach).
Executar a campanha apenas uma vez. Um relatório antigo descreve um sistema que não existe mais: checkpoint diferente, novos servidores MCP, um system prompt alterado. Além disso, os guardrails raramente analisam a requisição inteira — as exclusões variam conforme a plataforma, portanto identifique as suas antes de desenhar a matriz de controle.
Primeiro, vamos definir o escopo com clareza. Os guardrails do TrueFoundry realizam aplicação inline em tempo de execução: eles validam ou alteram (mutam) o conteúdo no caminho da requisição e retornam uma decisão. O TrueFoundry não fornece nem documenta ferramentas para campanhas offline de red team — sem geração de ataques, sem corpus adversarial, sem varreduras agendadas ou relatórios de red team. Na documentação de guardrails do AI Gateway, a expressão "red teaming" aparece essencialmente uma vez, nas orientações sobre a OWASP LLM04 recomendando que você "teste seus modelos contra certas estruturas de avaliação e red teaming" — uma recomendação externa, não uma funcionalidade nativa. O DeepKeep é a página de parceiro onde o red teaming surge como um recurso, sendo uma capacidade do DeepKeep, entregue do lado do provedor. Se você precisa de campanhas, adquira soluções de campanhas. O que segue abaixo é a parte de aplicação de segurança.
Os guardrails se conectam a quatro hooks: LLM Input, LLM Output, MCP Tool Pre-Invoke e MCP Tool Post-Invoke.

O caminho do LLM é executado em sete etapas documentadas, e a quarta etapa é a mais interessante. A mutação de entrada é executada primeiro e bloqueia até ser concluída. A validação de entrada é então iniciada em segundo plano, em paralelo com a requisição ao modelo, para não impactar o tempo até o primeiro token (TTFT) — e, se falhar durante a execução, o gateway cancela a requisição em andamento para o modelo, evitando cobranças desnecessárias. A mutação e a validação de saída são executadas de forma síncrona após o recebimento da resposta, portanto, um bloqueio na saída ainda gera o custo da chamada ao modelo.
Existem duas configurações independentes por guardrail. O Operation Mode pode ser Validate ou Mutate: Validate bloqueia sem alterar o conteúdo; Mutate reescreve o conteúdo e ainda pode bloquear, executando por ordem de prioridade (números menores executam primeiro). A Enforcement Strategy determina o que acontece em caso de violação e, separadamente, quando ocorre um erro no guardrail:
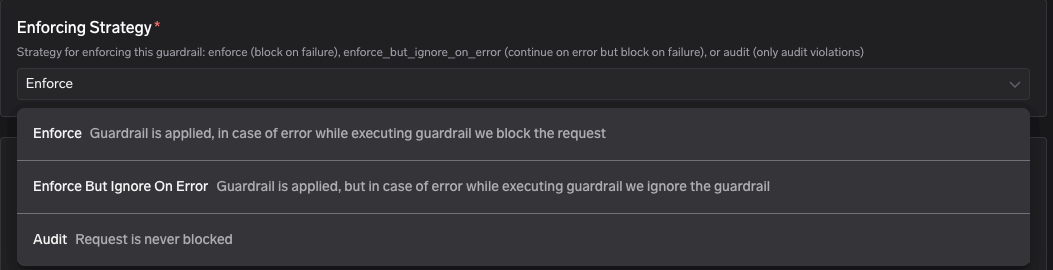
A opção Enforce But Ignore On Error é a chave para alternar entre fail-open e fail-closed, sendo a seleção mais crítica da página: a configuração Enforce total significa que uma indisponibilidade no provedor do guardrail derrubará sua aplicação. A progressão recomendada na documentação é Audit → Enforce But Ignore On Error → Enforce.
Dez guardrails são nativos, de acordo com a página oficial de guardrails do TrueFoundry: Secrets Detection, Code Safety Linter, SQL Sanitizer, Regex Pattern Matching, Prompt Injection, PII Detection, Content Moderation, Metadata Validation, Cedar e OPA Guardrails. Há uma inconsistência na documentação: a página de visão geral lista nove, omitindo Metadata Validation. Considere a lista de dez itens.
Três desses guardrails dependem de serviços gerenciados da Azure — Content Moderation, PII/PHI Detection e Prompt Injection — e funcionam apenas quando o TrueFoundry hospeda o gateway, não estando disponíveis em implantações self-hosted ou híbridas do tipo "Gateway Plane only". Alternativas no modelo Bring-Your-Own-Key (BYOK) estão documentadas para cada um: Prisma AIRS para injeção, CrowdStrike para PII e Bedrock Guardrails para moderação.
Os parceiros relevantes para segurança adversarial, listados em suas respectivas páginas de documentação, são:
Isso soma treze parceiros focados em segurança. Adicionando as integrações de avaliadores (judges) e moderação — Patronus, NVIDIA NeMo, Guardrails AI, Arthur AI, Verra, Azure PII, Azure Prompt Shield, OpenAI Moderations, AWS Bedrock Guardrails — o catálogo chega a cerca de vinte parceiros, além da opção de contrato customizado (custom-guardrail) para outras soluções.
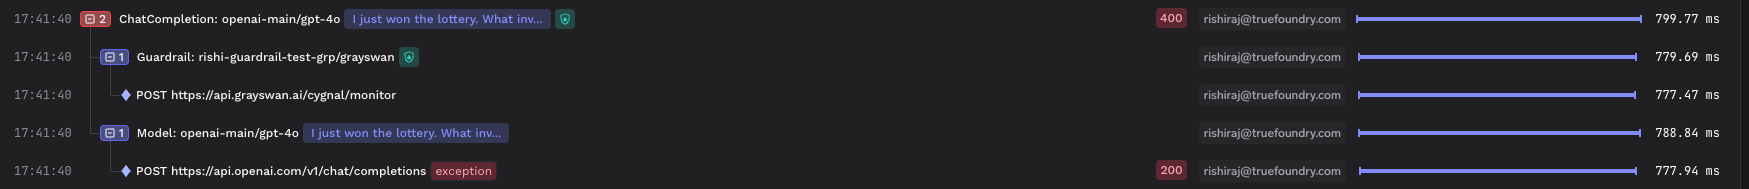

O hook Pre-invoke é executado de forma síncrona nos argumentos da ferramenta; se falhar, a ferramenta não é executada. O hook Post-invoke é executado no resultado; se falhar, o resultado é ocultado do modelo. O pré-invocação é onde o uso indevido de ferramentas é interrompido — como um higienizador de SQL lendo a string de argumento ou um linter de segurança de código analisando uma ferramenta de execução. O pós-invocação é onde a injeção indireta é neutralizada, já que o resultado de uma ferramenta deve ser tratado como conteúdo não confiável.
Os guardrails são executados separadamente para cada chamada de ferramenta — chamar cinco ferramentas em sequência significa passar por cinco conjuntos completos de verificações. O cabeçalho X-TFY-GUARDRAILS-SCOPE, que limita os guardrails do LLM às últimas N mensagens, não se aplica aos hooks do MCP. O artigo MCP tool poisoning e defesa via gateway cobre os detalhes de segurança no lado da descrição das ferramentas.
Registrar um guardrail não afeta o tráfego em tempo real; é a política que o ativa. O caminho é: AI Gateway → Policies → Guardrails → Add Rule, contendo quatro seções — When Request Goes To (modelos, servidores MCP e, opcionalmente, ferramentas específicas), From Subjects (usuários, equipes, contas virtuais), With Metadata e Apply on Hooks.
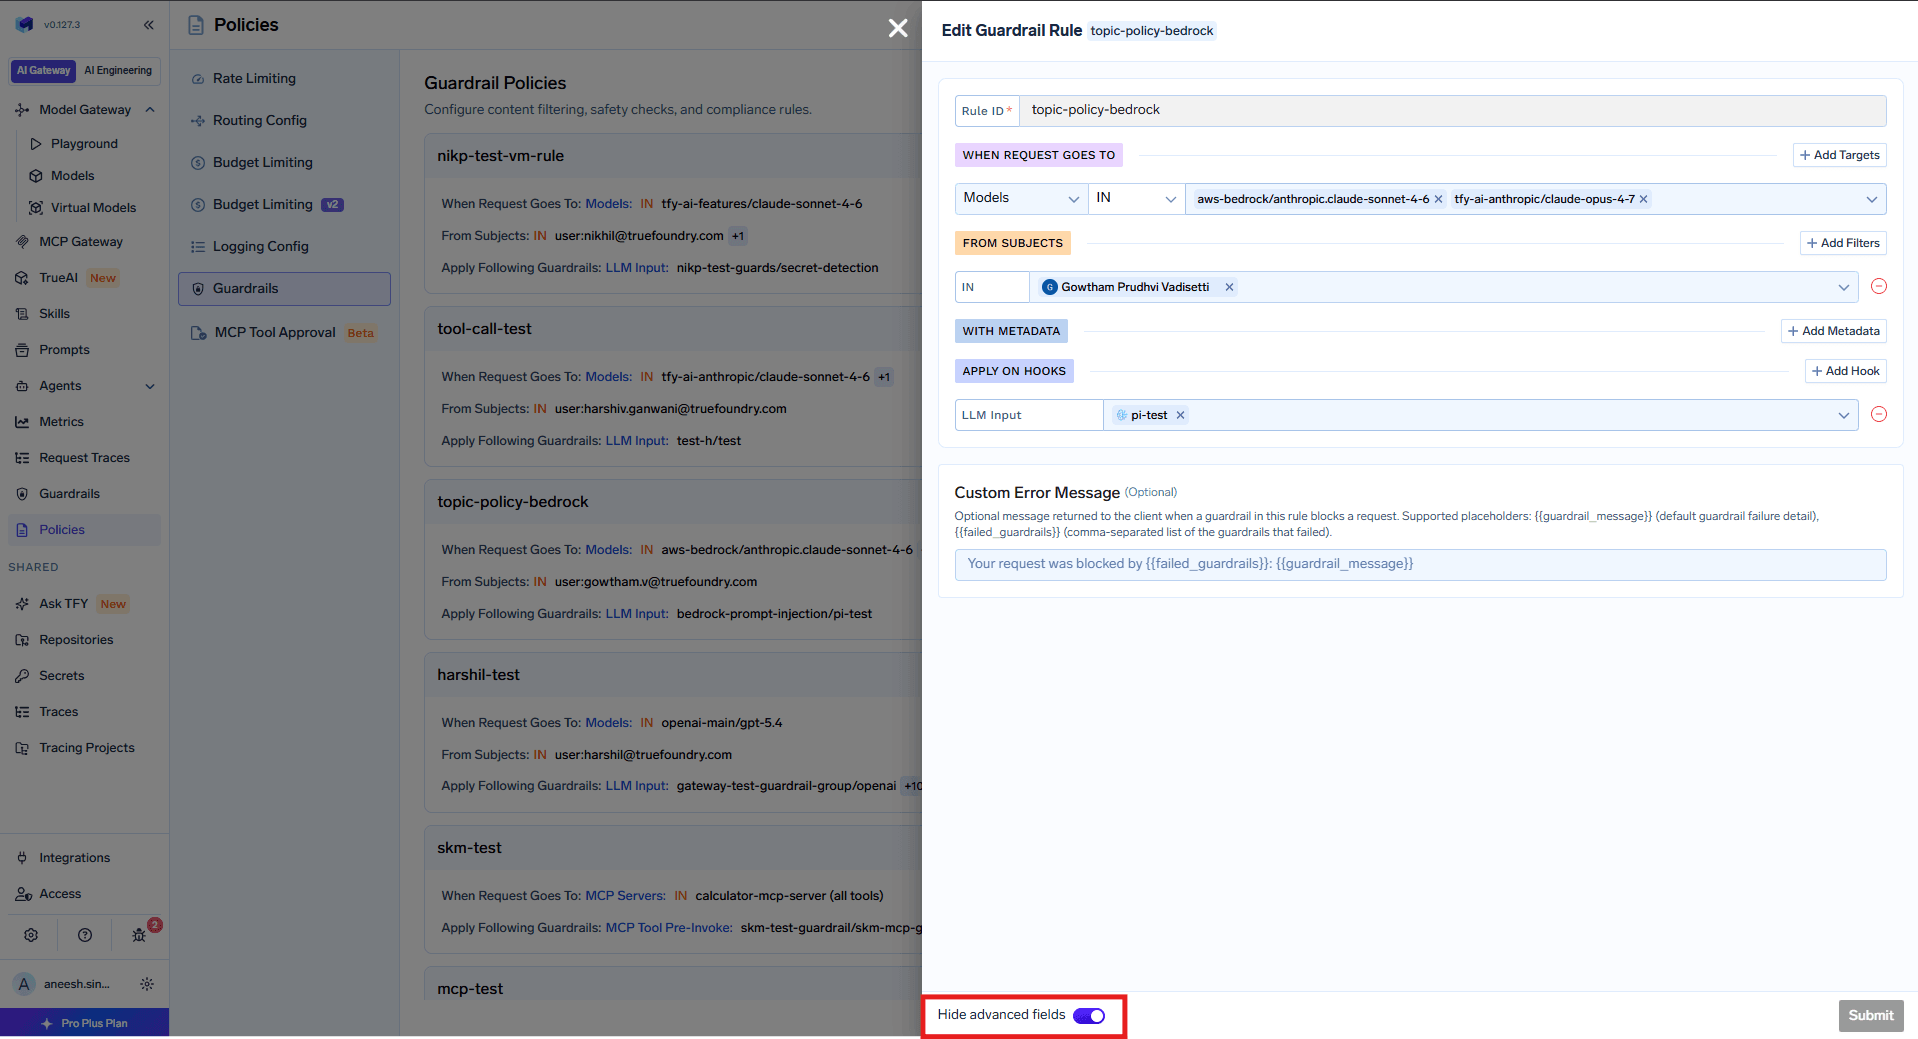
Todas as regras são avaliadas em cada requisição e as correspondências são combinadas (unioned) por hook. Assim, tanto uma regra de linha de base permissiva quanto uma regra de produção estrita serão aplicadas. O cabeçalho X-TFY-GUARDRAILS é a única exceção — ele ignora as políticas completamente, devendo ser tratado com privilégios elevados.
Uma limitação de escopo atual: os sujeitos das políticas são usuários, equipes e contas virtuais — não agentes. Políticas baseadas na identidade do agente, condições que consideram o contexto de delegação em cadeias de execução e hooks no próprio Agent Gateway estão documentados como recursos futuros.
A visualização de guardrails no Dashboard de Métricas contabiliza as requisições avaliadas, alteradas (Mutated) e sinalizadas/bloqueadas (Flagged). Ela exibe gráficos de requisições por segundo divididos por resultado — allowed, blocked, mutated, audit_mode_blocked —, além da taxa de bloqueio e mutação por guardrail e da latência nos percentis P50 / P75 / P90 / P99, com filtros por Guardrails, Usuários, Contas Virtuais ou Equipes.
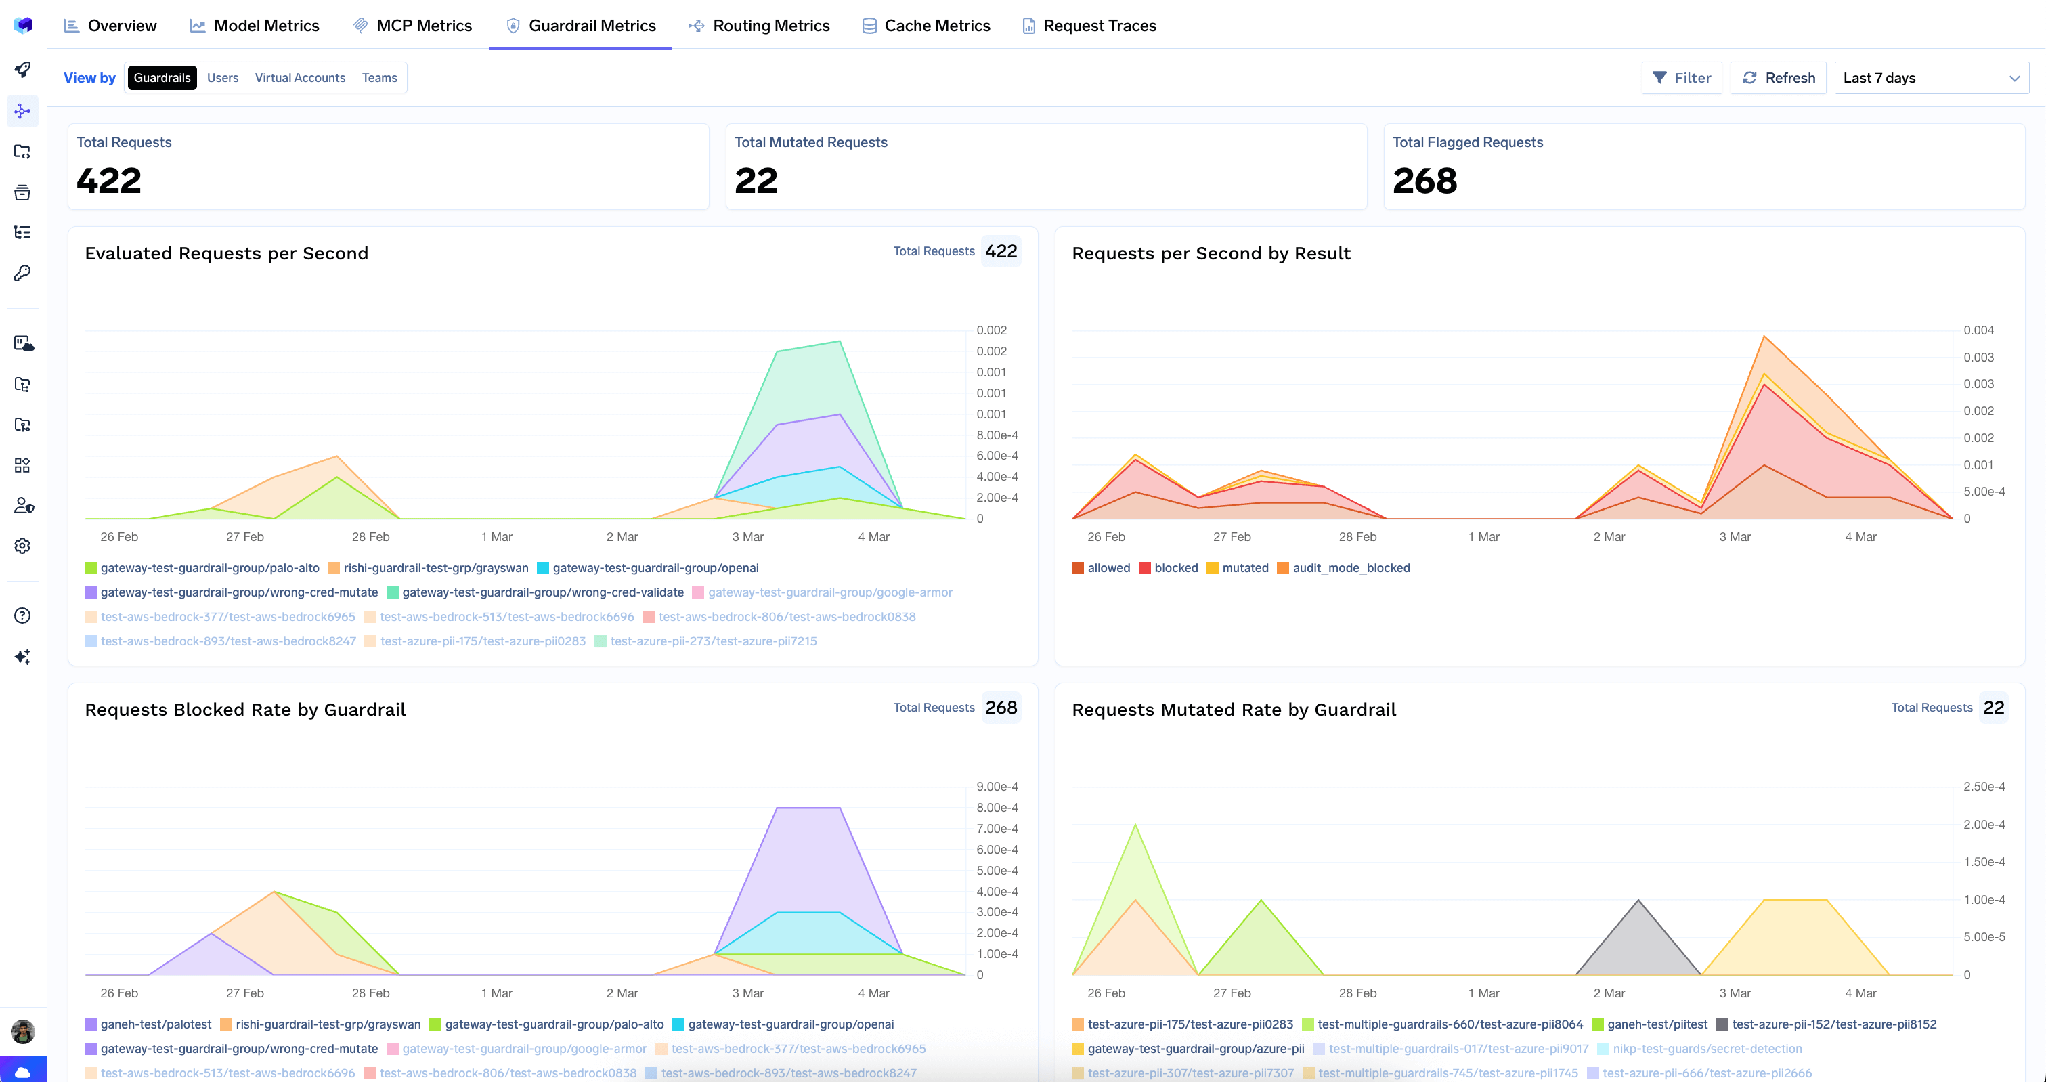
O indicador audit_mode_blocked é o que viabiliza a implantação inicial no modo Audit: ele mede o que teria sido bloqueado, permitindo dimensionar o impacto operacional antes de ativar a aplicação definitiva.
Uma campanha de red teaming contra um agente de suporte ao cliente identificou três vulnerabilidades: uma injeção indireta em um artigo da base de conhecimento faz o agente chamar uma ferramenta interna indevida; o agente replica o número de telefone de um cliente no resumo da conversa; e uma pergunta manipulada gera um loop de execução de doze ferramentas.
Mapeie as descobertas para os hooks. A linha de base documentada para o tráfego de agentes é o ponto de partida: ofuscação de PII (Mutate) e detecção de prompt injection (Validate) na entrada; detecção de segredos na saída; higienizador de SQL e linter de código no pré-ferramenta; e ofuscação de PII e segredos no pós-ferramenta. Para a vulnerabilidade de injeção encontrada, o hook principal de defesa é o pós-ferramenta, ponto em que o artigo comprometido entra no contexto.
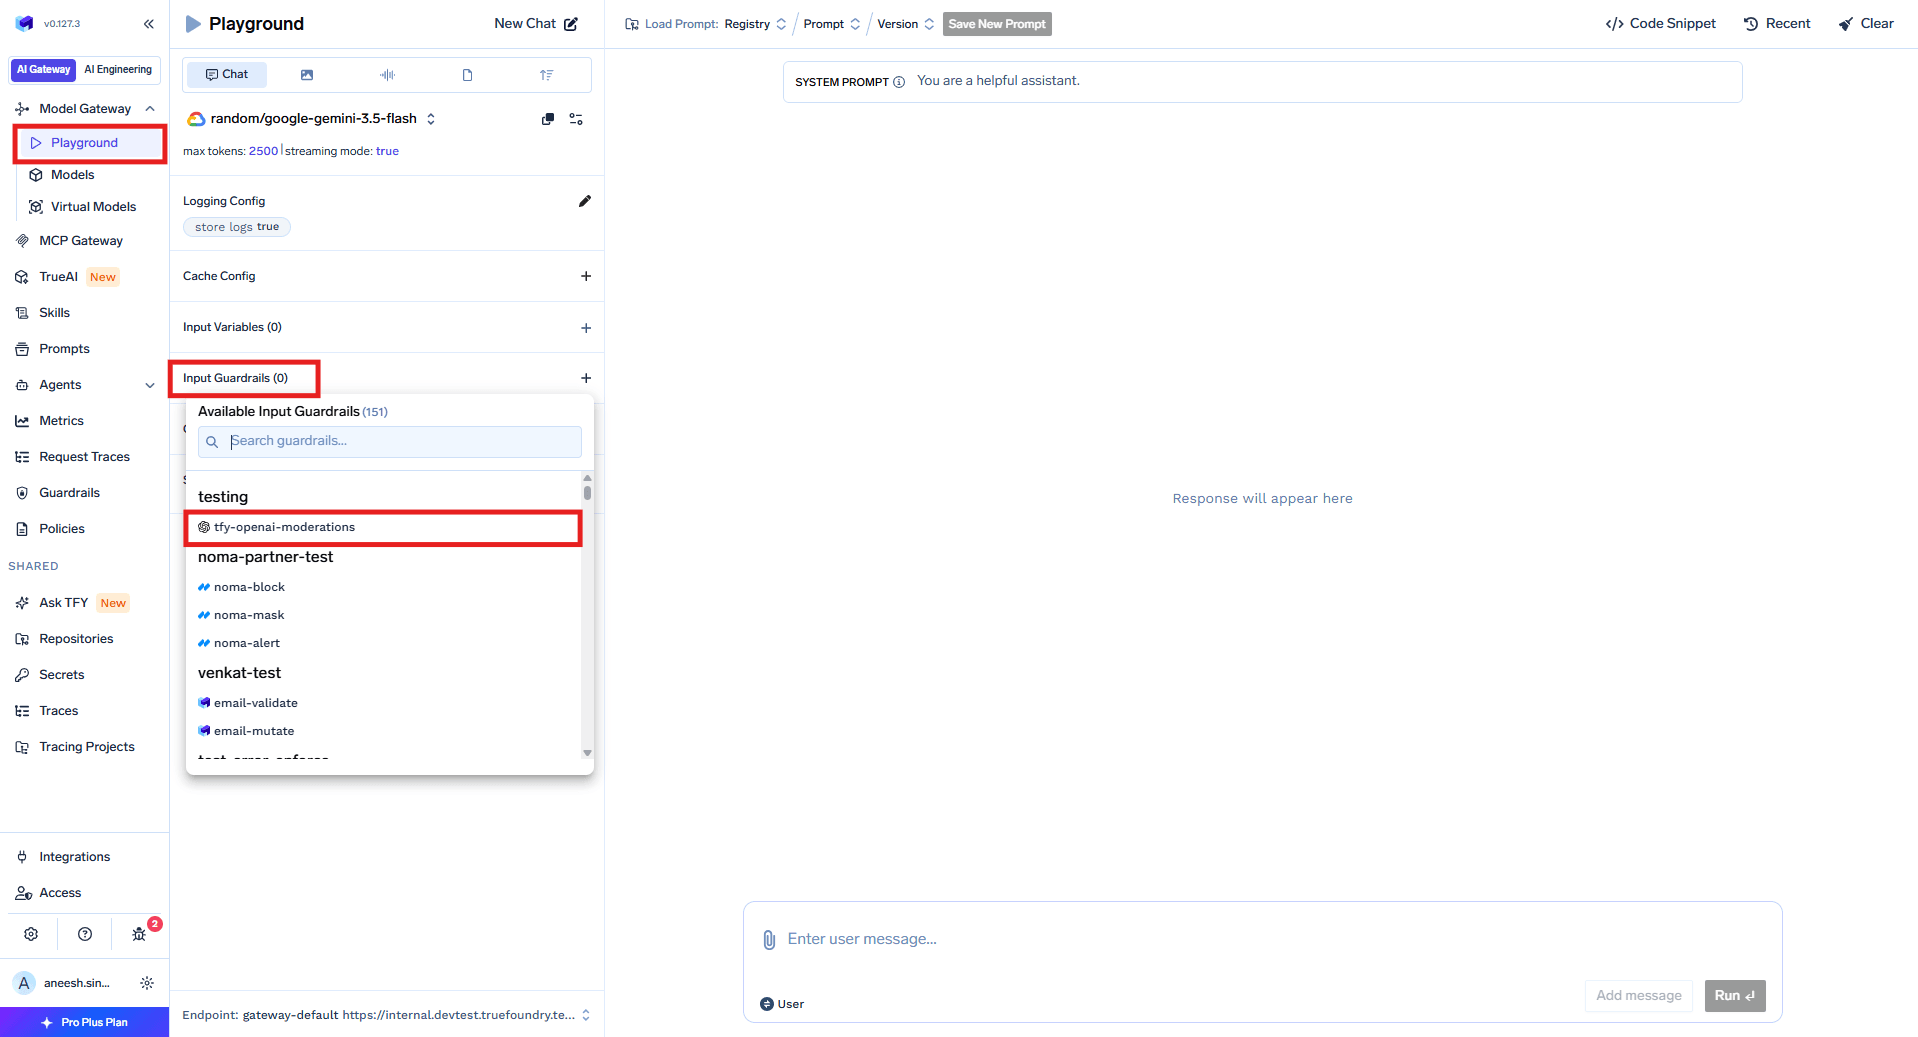
Teste no Playground primeiro. Todos os quatro hooks podem ser testados em AI Gateway → Playground; o botão Code gera um snippet com o cabeçalho X-TFY-GUARDRAILS já preenchido.
Vincule uma política no modo Audit, limitada aos modelos e servidores MCP deste agente, e monitore por uma semana — um detector que dispara em 8% dos tickets legítimos ainda não pode ser aplicado em modo de bloqueio. Em seguida, promova para Enforce But Ignore On Error e configure uma Custom Error Message (acessível na opção Hide advanced fields), que suporta as variáveis {{guardrail_message}} e {{failed_guardrails}}.
Verifique nos traces. Cada guardrail é representado como um span próprio na seção Monitor → Request Traces, detalhando tempo de execução, resultado, escopo e mutações realizadas. Os bloqueios retornam o código HTTP 400 com error.type = "guardrail_checks_failed".

Resolva a vulnerabilidade de consumo (sponge) em outra camada. O loop de doze ferramentas é um problema de limite de taxa e orçamento. Nenhum guardrail impedirá um loop cujas requisições individuais sejam válidas em cada iteração.
A ordem dos guardrails pode converter um bloqueio em uma autorização. O DeepKeep aplica a precedência pela ordem em que os guardrails estão listados entre os que dispararam — e não pela ação mais severa. Se você posicionar o PII Detector antes do Adversarial Prompt Defense, um jailbreak que também contenha PII será redigido/ofuscado e permitido, em vez de bloqueado: a redação prevalece por ter sido listada primeiro, e o ataque passa com o número de telefone ocultado por asteriscos. A solução recomendada é seguir a ordem indicada: Credentials Leakage → PII → Adversarial → Toxic. Uma abordagem ainda melhor é a separação em dois firewalls: Adversarial Prompt Defense apenas no firewall pré-execução, mantendo credenciais e PII no firewall pós-execução.
Guardrails de saída são ignorados em respostas via streaming. Com a opção stream: true, eles não são executados, pois a avaliação de uma resposta exige o texto completo. Os guardrails de entrada funcionam normalmente. Como a maioria das interfaces de chat utiliza streaming por padrão, isso desativa as defesas do lado da saída onde o usuário final as visualiza.
System prompts nunca são inspecionados. O gateway os remove antes de enviar o conteúdo para qualquer guardrail; a exceção documentada é o CrowdStrike AIDR, que analisa mas nunca os modifica. Portanto, a afirmação "nós analisamos o prompt completo" não se aplica ao sistema.
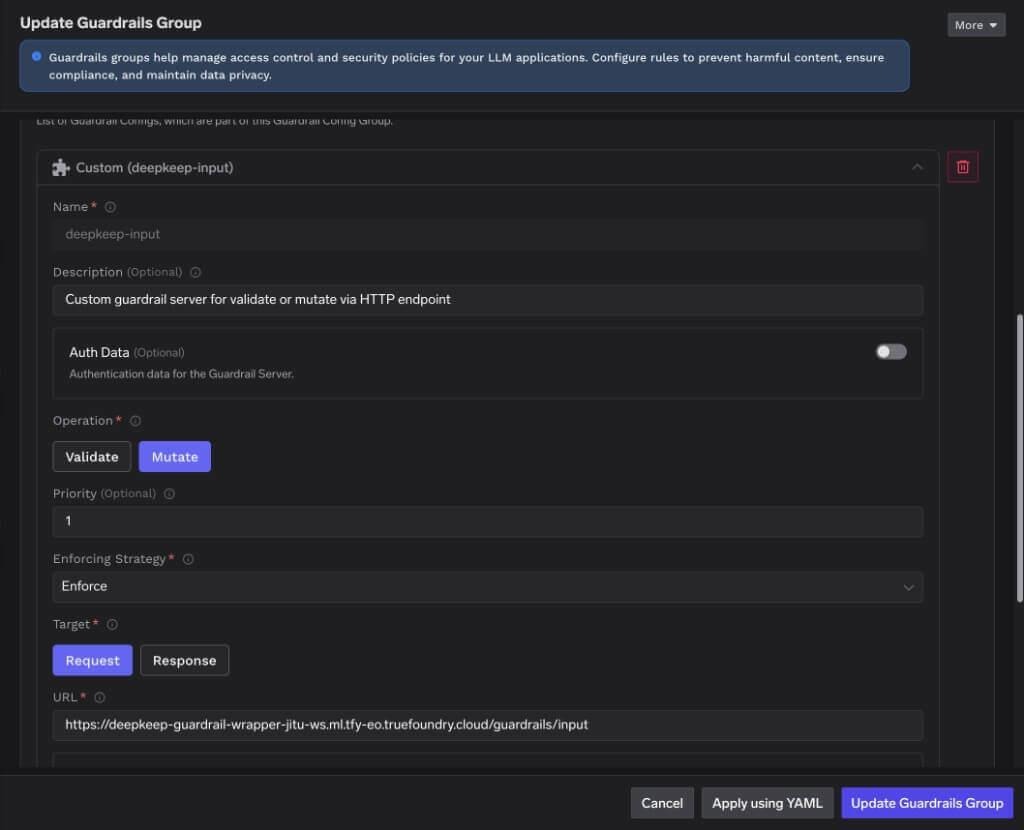
Se você desenvolver seu próprio detector, retorne status 2xx. A especificação para guardrails customizados determina que um código HTTP 2xx indica que o guardrail foi executado com sucesso, retornando o resultado no corpo como verdict: false. Sinalizar um bloqueio com o código 400 é uma falha comum — o gateway pode interpretar o retorno como um erro de infraestrutura e permitir a passagem da requisição.
Trata-se de duas partes complementares. Campanhas descobrem falhas: são episódicas, possuem custo elevado e representam o único meio de identificar novas classes de falha sem detectores pré-existentes. A aplicação em tempo de execução sustenta a defesa: é contínua, possui baixo custo por requisição e não oferece proteção contra ataques dos quais não possui descrição prévia. Um programa baseado apenas no primeiro elemento gera apenas relatórios; um focado apenas no segundo gera uma falsa sensação de segurança.
A TrueFoundry se posiciona exatamente na segunda metade, e preferimos dizer isso abertamente a deixar subentendido. O gateway oferece um único local para aplicar os resultados em todos os modelos, equipes e chamadas de ferramentas MCP. Onde ele para é na geração dos ataques. Se um fornecedor disser que seu firewall torna o red teaming desnecessário, pergunte em quais classes de ataque seus detectores foram treinados e quando — depois execute a campanha de qualquer maneira e aplique o que for encontrado.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



Teste adversarial de um sistema de IA — modelo, prompts, contexto recuperado e ferramentas em conjunto — para encontrar entradas que o façam agir contra a sua intenção. As classes são jailbreaks, injeção de prompt direta e indireta, exfiltração de dados, abuso de ferramentas e ataques “esponja” de esgotamento de recursos. Ele difere do teste de penetração porque a superfície de ataque é a linguagem natural, os resultados são probabilísticos e uma atualização do modelo pode reabrir uma classe que você havia fechado.
Não. Um firewall de LLM é aplicação em tempo de execução: guardrails inline que inspecionam, reescrevem ou bloqueiam cada requisição. Red teaming é descoberta offline: campanhas que geram ataques e relatam o que funcionou. As campanhas dizem o que aplicar; a aplicação faz com que a descoberta pare de custar caro para você.
Não no sentido de campanhas. Ele oferece a metade de aplicação em tempo de execução: guardrails em quatro hooks, dez guardrails nativos integrados, cerca de vinte integrações de parceiros, vinculação de políticas por modelo, servidor MCP, ferramenta, usuário, equipe ou conta virtual, e métricas por guardrail. Ele não documenta geração de ataques, um corpus adversarial, varreduras agendadas nem relatórios de red team. Vários parceiros são fornecedores de segurança com capacidade própria para campanhas.
Sim. O TrueFoundry é executado na sua VPC, on-prem, em ambiente air-gapped ou híbrido, de modo que os prompts e as respostas nunca saem do seu domínio, mesmo quando você roteia entre muitos provedores.
Sim. Ele inclui um MCP Gateway, um Agent Gateway e um MCP & Agents Registry com controle de acesso em nível de ferramenta. Agentes criados com LangGraph, CrewAI, AutoGen ou um framework próprio podem ser governados de forma centralizada.
Sim. O gateway é compatível com OpenTelemetry e se integra com Grafana, Datadog, Prometheus ou a sua stack preferida. Ele rastreia cada requisição, do prompt à execução da ferramenta e do modelo, para que você obtenha logs unificados sem precisar remover o que você já usa.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















