



November 6, 2026
|
5 min read


Obtenha acesso instantâneo a um ambiente TrueFoundry ao vivo. Implante modelos, direcione o tráfego de LLM e explore a plataforma completa — seu sandbox estará pronto em segundos, sem necessidade de cartão de crédito.



Blazingly fast way to build, track and deploy your models!
Uma API de pagamentos é fácil de observar porque é previsível. A mesma entrada produz o mesmo caminho de código, portanto três números — taxa de requisição, taxa de erro, duração — dizem quase tudo. Quando algo vai mal, você lê um stack trace, e um stack trace é um fato sobre o programa, não um palpite sobre a intenção.
Um agent quebra todas as premissas dessa frase. O modelo escolhe o caminho em tempo de execução, então a mesma entrada não produz o mesmo caminho de código. Frequentemente, não há erro algum: o agent é concluído, retorna texto e cada chamada HTTP realizada retornou 200. E o que deu errado geralmente não é um crash, mas sim uma decisão — ele escolheu a ferramenta errada, leu novamente um arquivo que já possuía, continuou tentando uma busca que nunca poderia funcionar.
Portanto, a pergunta muda: não se estava no ar, mas por que ele fez isso. E "por que" é uma propriedade de toda a sequência, não de uma única requisição — motivo pelo qual um dashboard pode parecer saudável enquanto seu agent falha. Uma latência P99 de 900 ms em todas as chamadas de modelo não diz nada sobre uma execução que realizou 140 chamadas.
Os dados possuem quatro níveis aninhados, dos quais apenas os dois inferiores se parecem com uma requisição convencional.
Os dois níveis intermediários concentram o maior valor, e são exatamente os dois que um tracer focado em requisição não modela. Ele enxerga uma dispersão de chamadas de saída sem um pai significativo e não consegue dizer que as chamadas 11 a 27 fizeram parte de um único turn tentando a mesma coisa sete vezes.
Uma propriedade torna isso genuinamente diferente do rastreamento distribuído tradicional: qualquer nível pode entrar em loop. Não há equivalente em um gráfico de serviço normal — A chama B que chama C, e se A chamar a si mesmo, você tem um bug. Em um agent, uma etapa que decide chamar a si mesma novamente é o caso normal, e a única maneira de diferenciar um loop produtivo de um travado é lendo a sequência.
Cada nível precisa de seus próprios sinais. Coletar tudo em todos os lugares produz dados sem insights, portanto este é o mínimo necessário para agregar valor.
A última célula é o sinal de maior rendimento na observabilidade de agents, e quase ninguém o registra: a mesma ferramenta chamada duas vezes com os mesmos argumentos dentro de um único turn é um loop. É algo trivial uma vez que os argumentos estão no span. É impossível de identificar por meio de métricas agregadas.
Três padrões cobrem quase todos os incidentes em produção.
1. O loop de retentativa silencioso. Um agent pesquisa uma base de conhecimento, não obtém nada útil, reformula, pesquisa novamente — vinte vezes. Cada pesquisa retorna 200 em 300 ms, então os dashboards de taxa de requisição e taxa de erro mostram apenas um pequeno pico de tráfego e nada mais. No nível da sessão, é impossível não notar: contagem de turns igual a um, contagem de chamadas de ferramenta igual a vinte, duração de dois minutos. O diagnóstico não está em nenhum span isolado; está na repetição.
2. A ferramenta que retorna sucesso com dados inúteis. Uma ferramenta de busca de documentos atinge uma barreira de permissão e retorna um 200 cortês cujo corpo é uma página de login HTML. O modelo lê isso e informa que a política não existe. Zero erros em qualquer lugar. A única maneira de pegar isso é capturando o resultado bruto — razão pela qual a captura de resultados, e não apenas de códigos de status, é essencial.
3. A execução de 40x. O custo mediano da sessão é de US$ 0,04; uma sessão custou US$ 1,60 e nada falhou. Uma única etapa leu novamente um arquivo grande no contexto, esse arquivo foi mantido em todos os turns subsequentes e os tokens de entrada foram se acumulando pelo resto da execução. Você encontra isso ordenando as sessões por custo e lendo a contagem de tokens por turn dos casos discrepantes (outliers) até ver a alteração brusca. Nunca em uma média.
O padrão em todos os três casos: a anomalia é uma relação entre etapas. Uma ferramenta que armazena etapas de forma independente descartou a informação de que você precisa.
Isso é passível de captura sem instrumentar o código do seu agent porque a execução e a observação ocorrem no mesmo lugar. Cada chamada de modelo e de ferramenta passa por um gateway, de modo que a trajetória é registrada como um efeito colateral do atendimento — nada precisa ser reconstruído a partir de logs dispersos e não há como desativar.
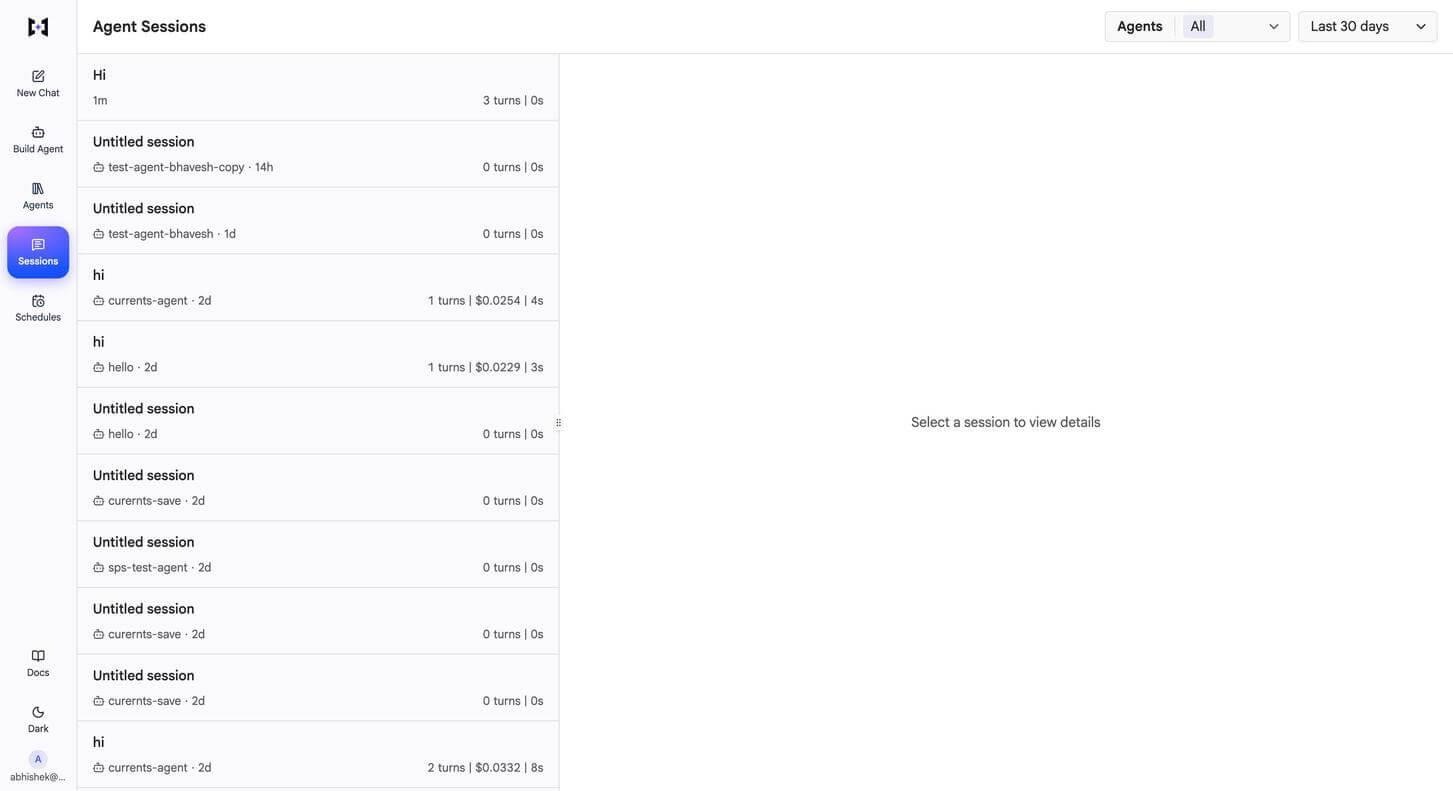
Para agents no agent harness do TrueFoundry, a tela Sessions lista cada conversa em todos os agents — mensagem inicial, agent, contagem de turns, custo, duração. O suficiente para identificar execuções caras ou muito longas sem abrir nada, exatamente o que o modo de falha 3 exige.
Abrir uma sessão fornece todas as três coisas que a hierarquia exige. As métricas agregadas cobrem turns, duração, custo, tokens, contexto, chamadas de ferramentas, sub-agents e erros. Uma linha do tempo por tipo de evento divide a execução em segmentos de sistema, usuário, modelo e chamadas de ferramenta por turn — um turn dominado pela cor de chamada de ferramenta é limitado por ferramentas, um dominado pela cor do modelo é limitado pelo modelo, visível de relance sem necessidade de cálculos. Abaixo fica a transcrição, com tokens, duração e custo por turn, e um painel expansível de agent steps listando as chamadas de ferramenta em ordem com os resultados.
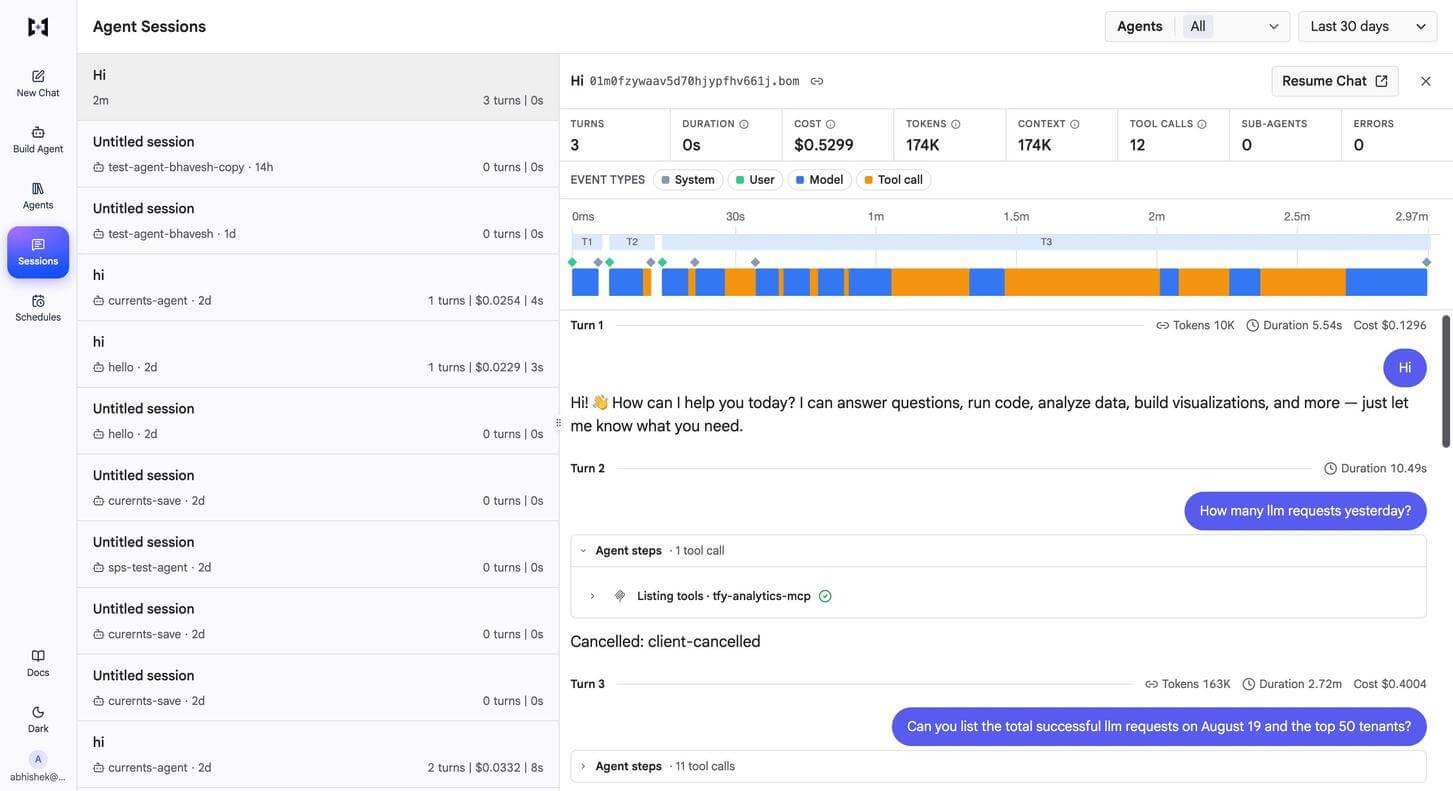
Essa lista ordenada de etapas é onde um turn cancelado, um servidor MCP com falha ou um resultado de ferramenta vazio se tornam visíveis. Uma sessão pode ser retomada como um chat ao vivo a partir da mesma visualização — como você confirma uma correção.
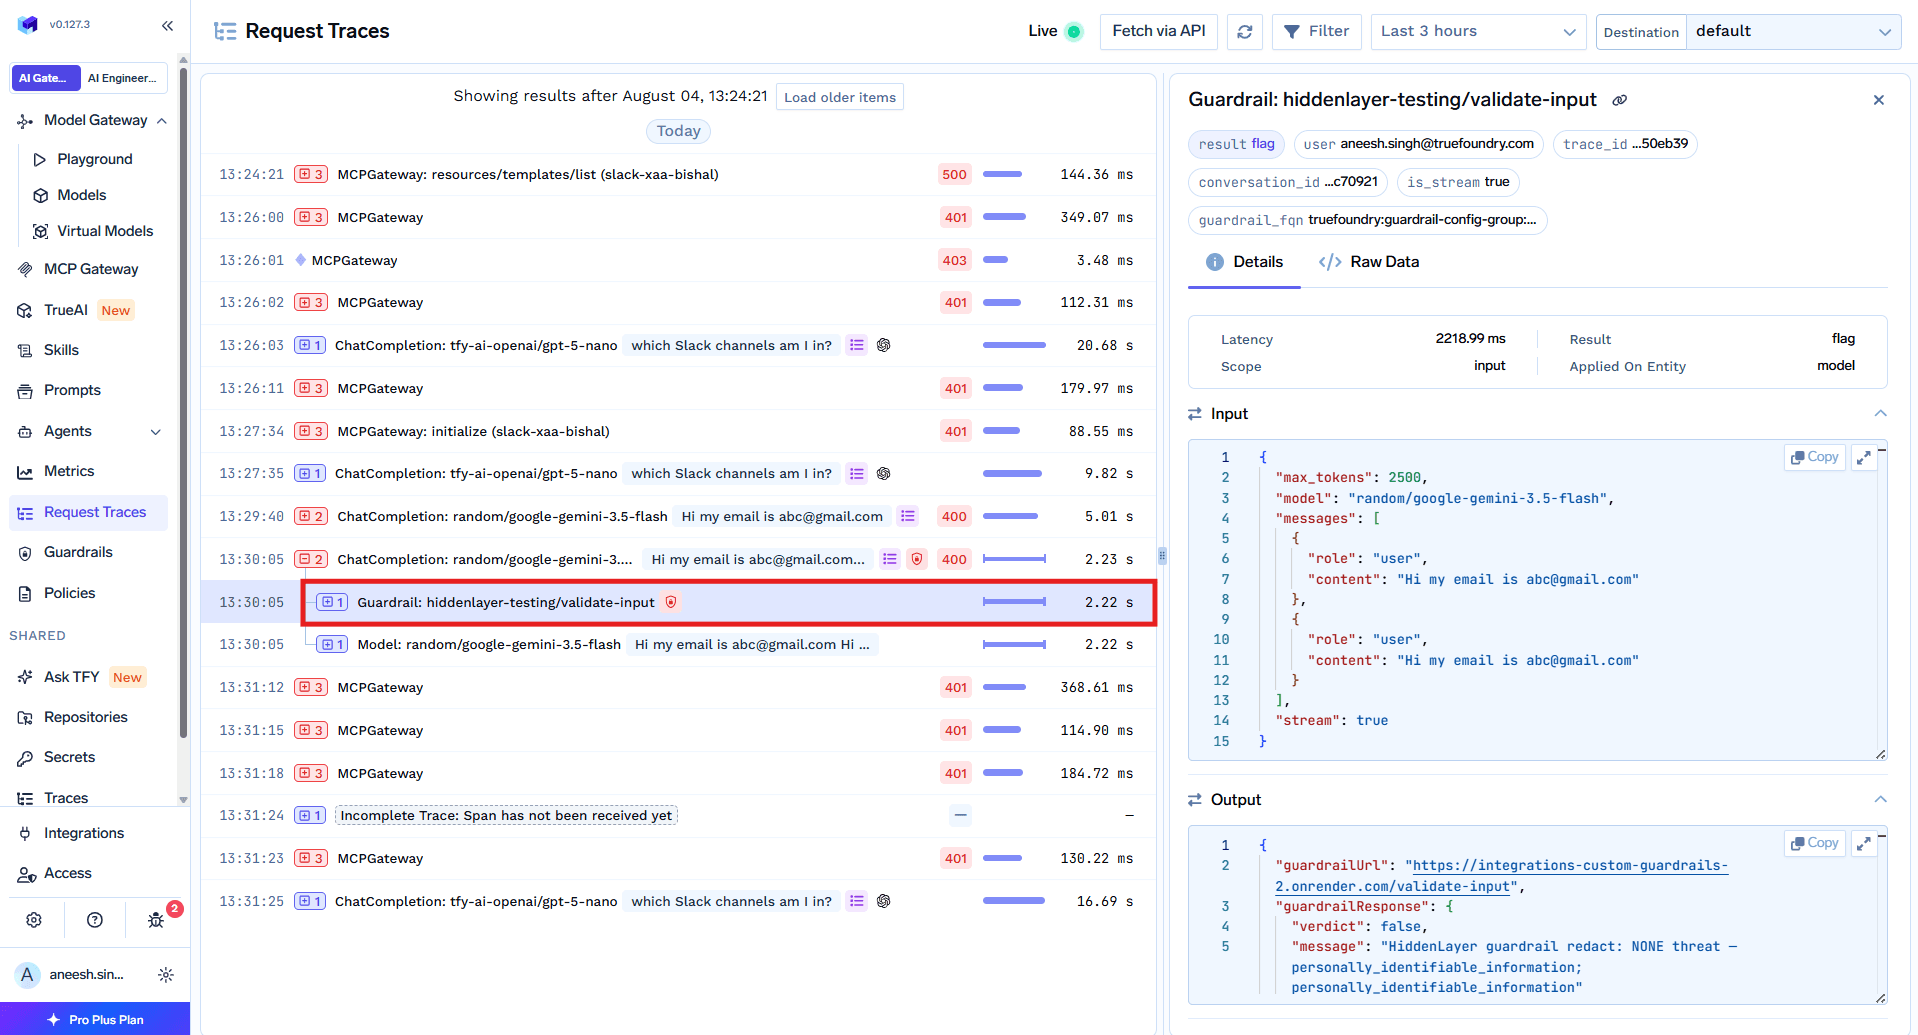
Um nível abaixo, um trace é uma hierarquia real de spans, não um log plano. Uma única conclusão de chat (chat completion) com um guardrail de PII associado produz cinco spans: uma raiz ChatCompletion sem pai, um span Guardrail abaixo dela, a chamada de saída do guardrail abaixo dessa, um span Model e a chamada de saída do modelo abaixo dela.
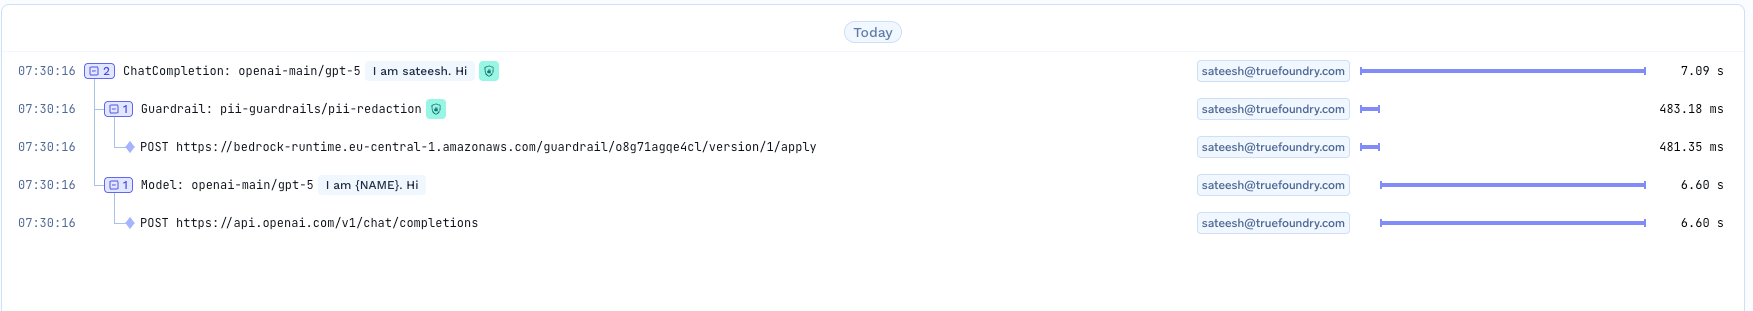
Os atributos de span tornam o custo e a latência atribuíveis em vez de estimados. O span raiz carrega tfy.model.metric.cost_in_usd, input_tokens, output_tokens, latency_in_ms, time_to_first_token_in_ms e inter_token_latency_in_ms, junto com tfy.input, tfy.output e tfy.triggered_guardrail_fqns, e cada span registra o sujeito que o criou. Os spans são consultáveis: client.traces.query_spans(...) com um filtro trace_ids e uma janela de tempo retorna toda a hierarquia, paginada — como você passa de "esta sessão foi cara" para "este span foi caro".
A execução do guardrail aparece como seu próprio span com resultado, latência e descobertas (findings), e requisições bloqueadas também são rastreadas — uma chamada negada é uma evidência, não uma lacuna.
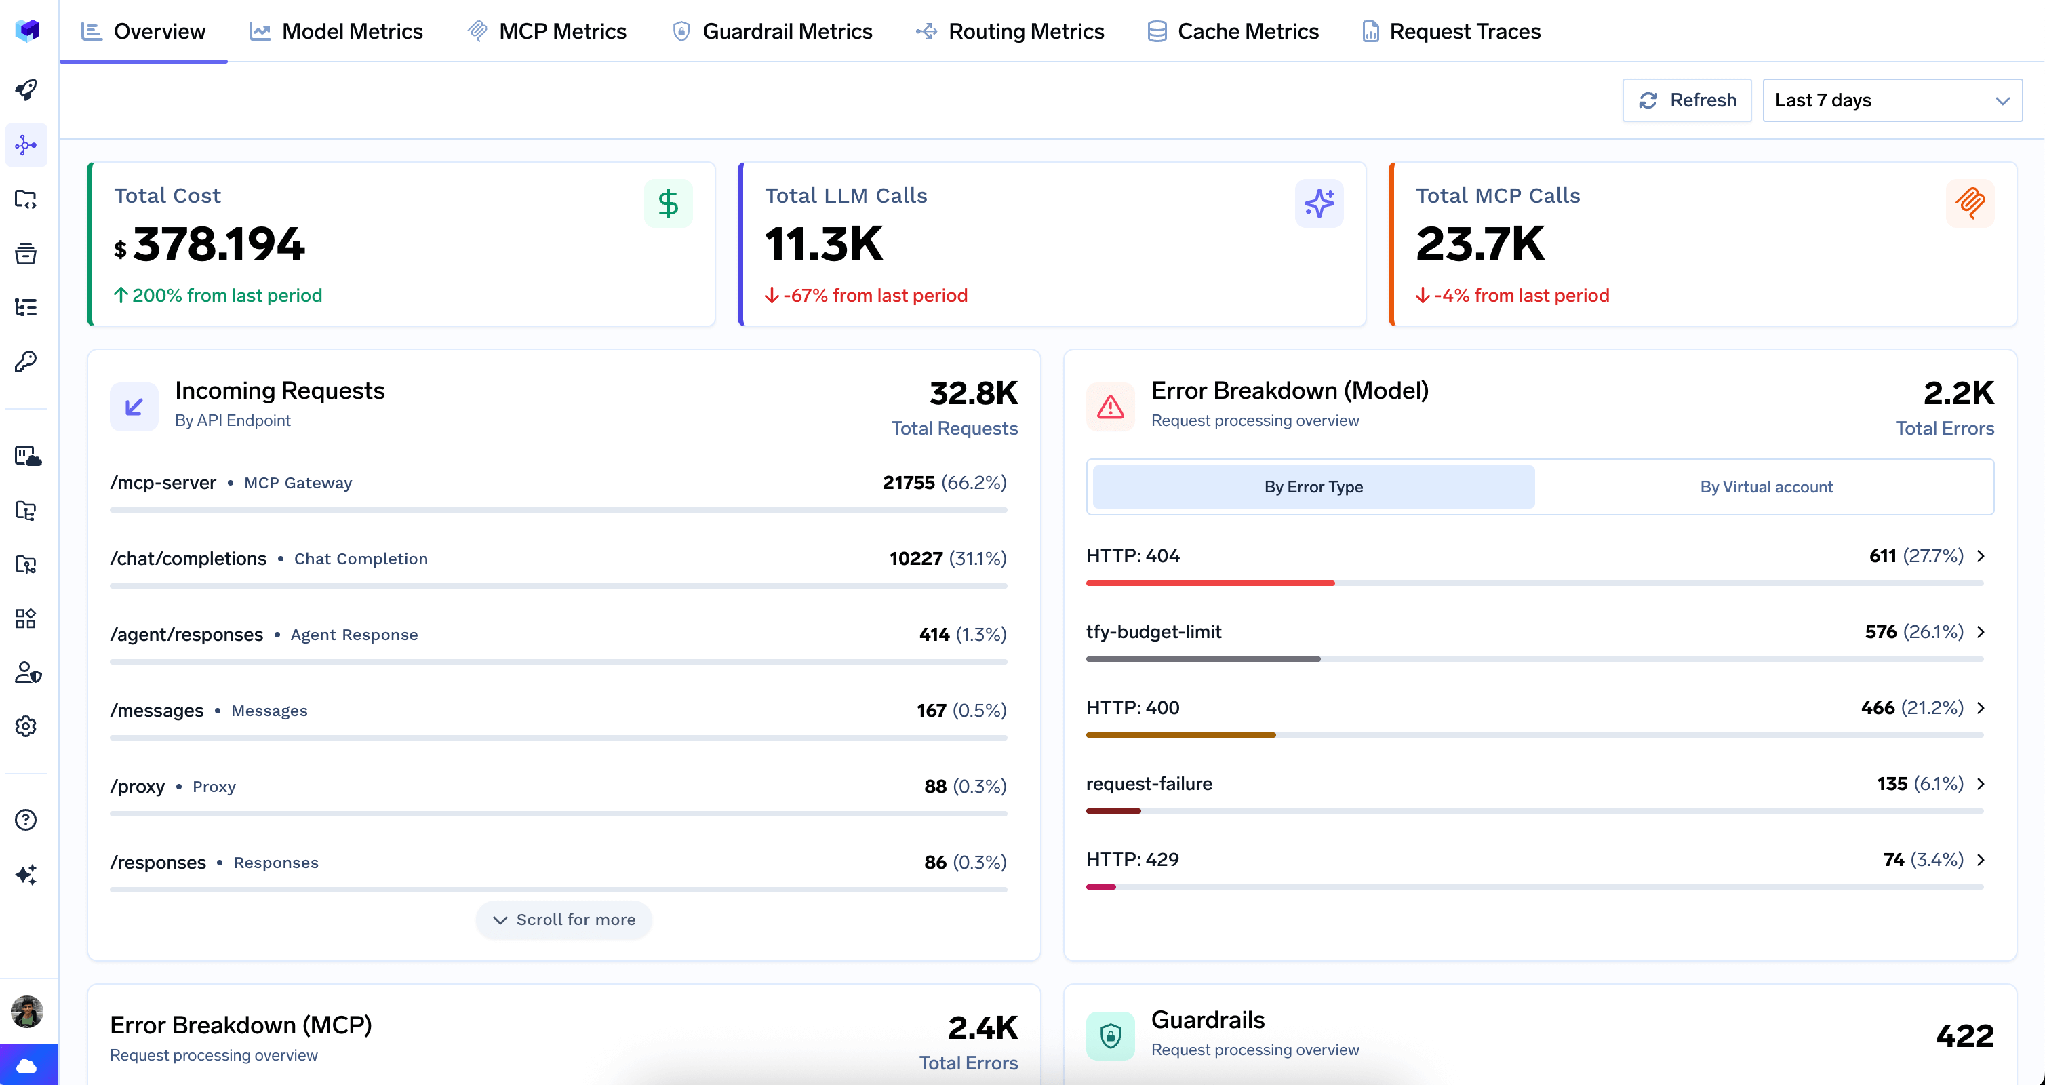
Os agregados vivem no Dashboard de Métricas. As Métricas do Modelo carregam tokens de entrada e saída, contagem de requisições e custo total, além de throughput, taxa de falha e detalhamento de falhas por tipo de erro. A latência vem em P50, P75, P90 e P99 em quatro medições — latência ponta a ponta, tempo até o primeiro token, latência entre tokens, tempo por token de saída — o que importa porque um primeiro token lento e um fluxo de tokens lento possuem causas diferentes.
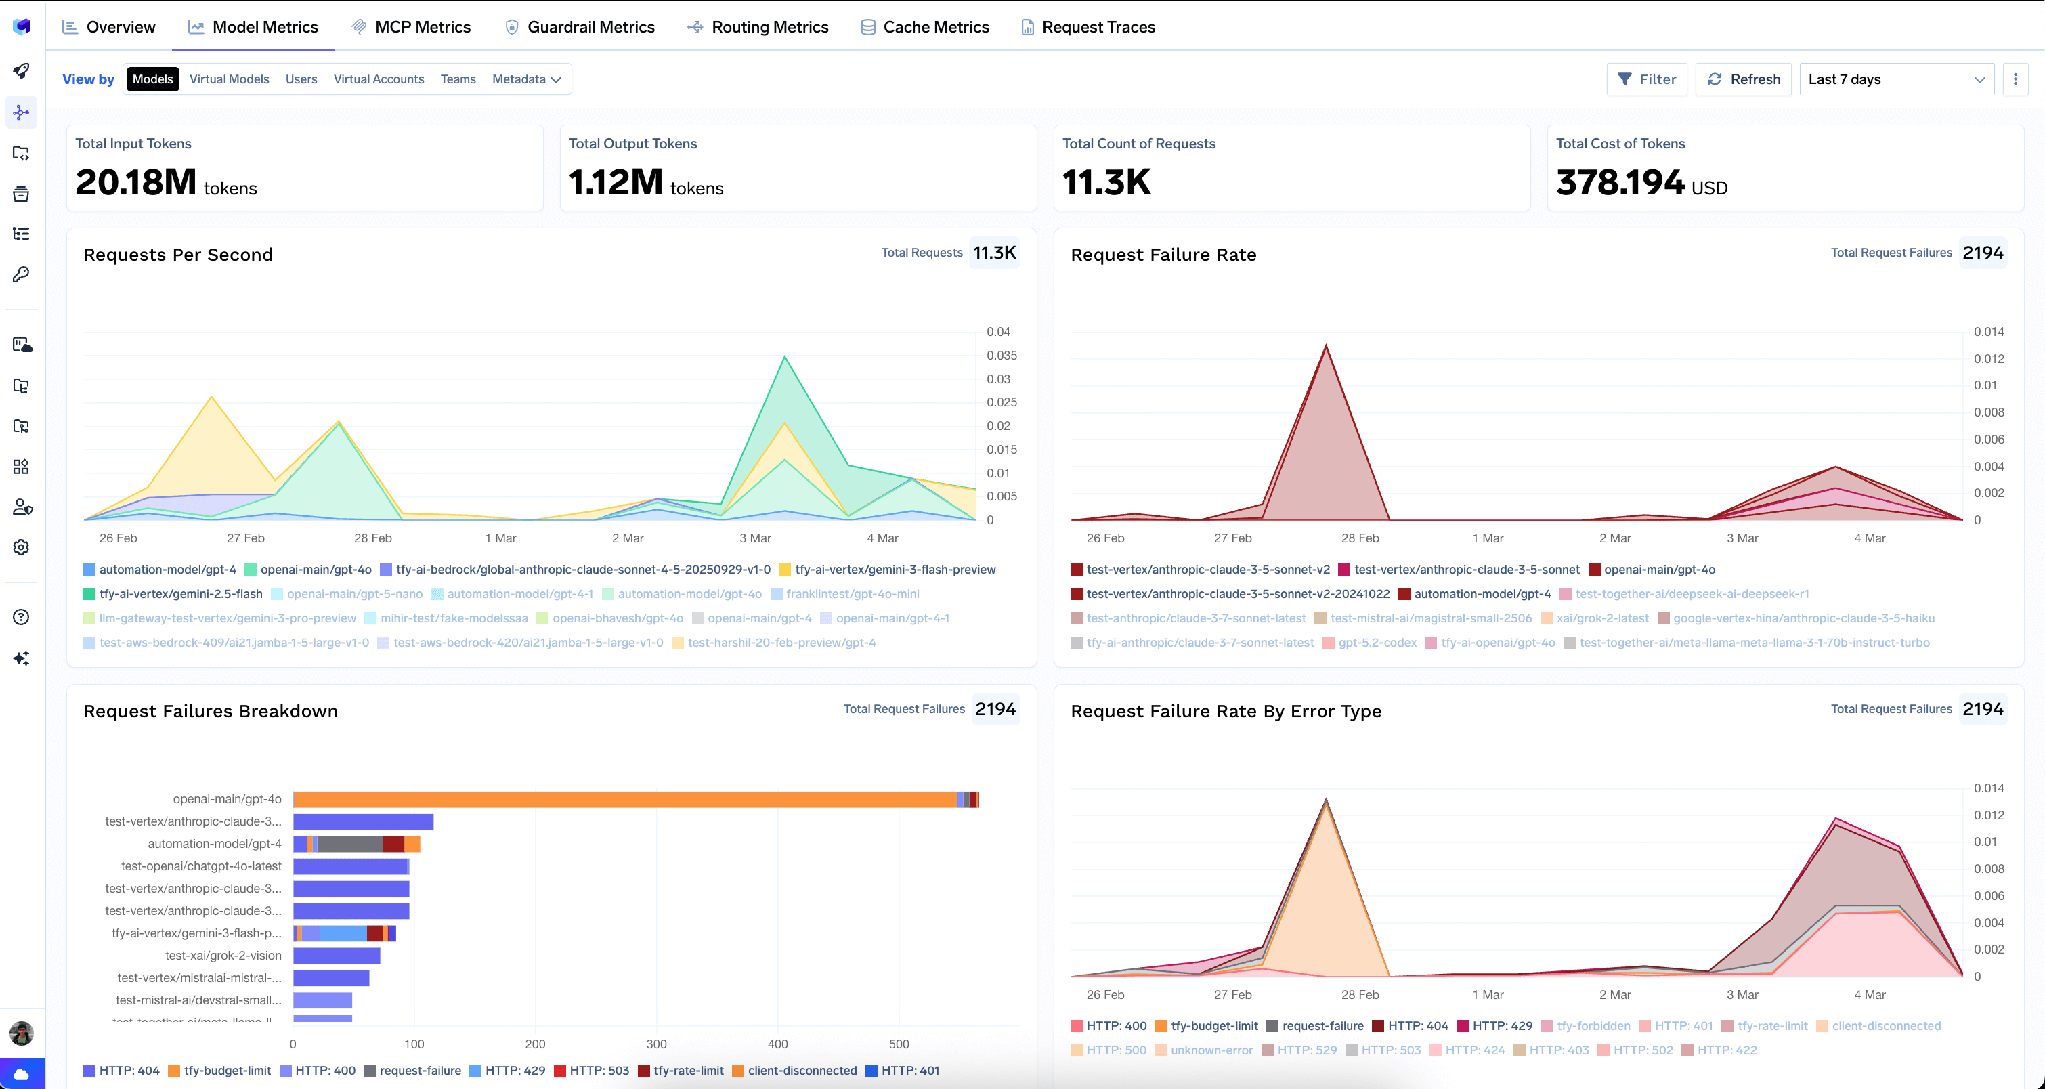
Cada gráfico permite alternar por um seletor View by — modelos, modelos virtuais, usuários, contas virtuais, equipes ou chaves de metadados personalizadas enviadas como cabeçalhos de requisição. Planeje os metadados desde cedo: envie um nome de agent ou ID de execução e você obterá visualizações de custo e latência por agent sem construir nada adicional.
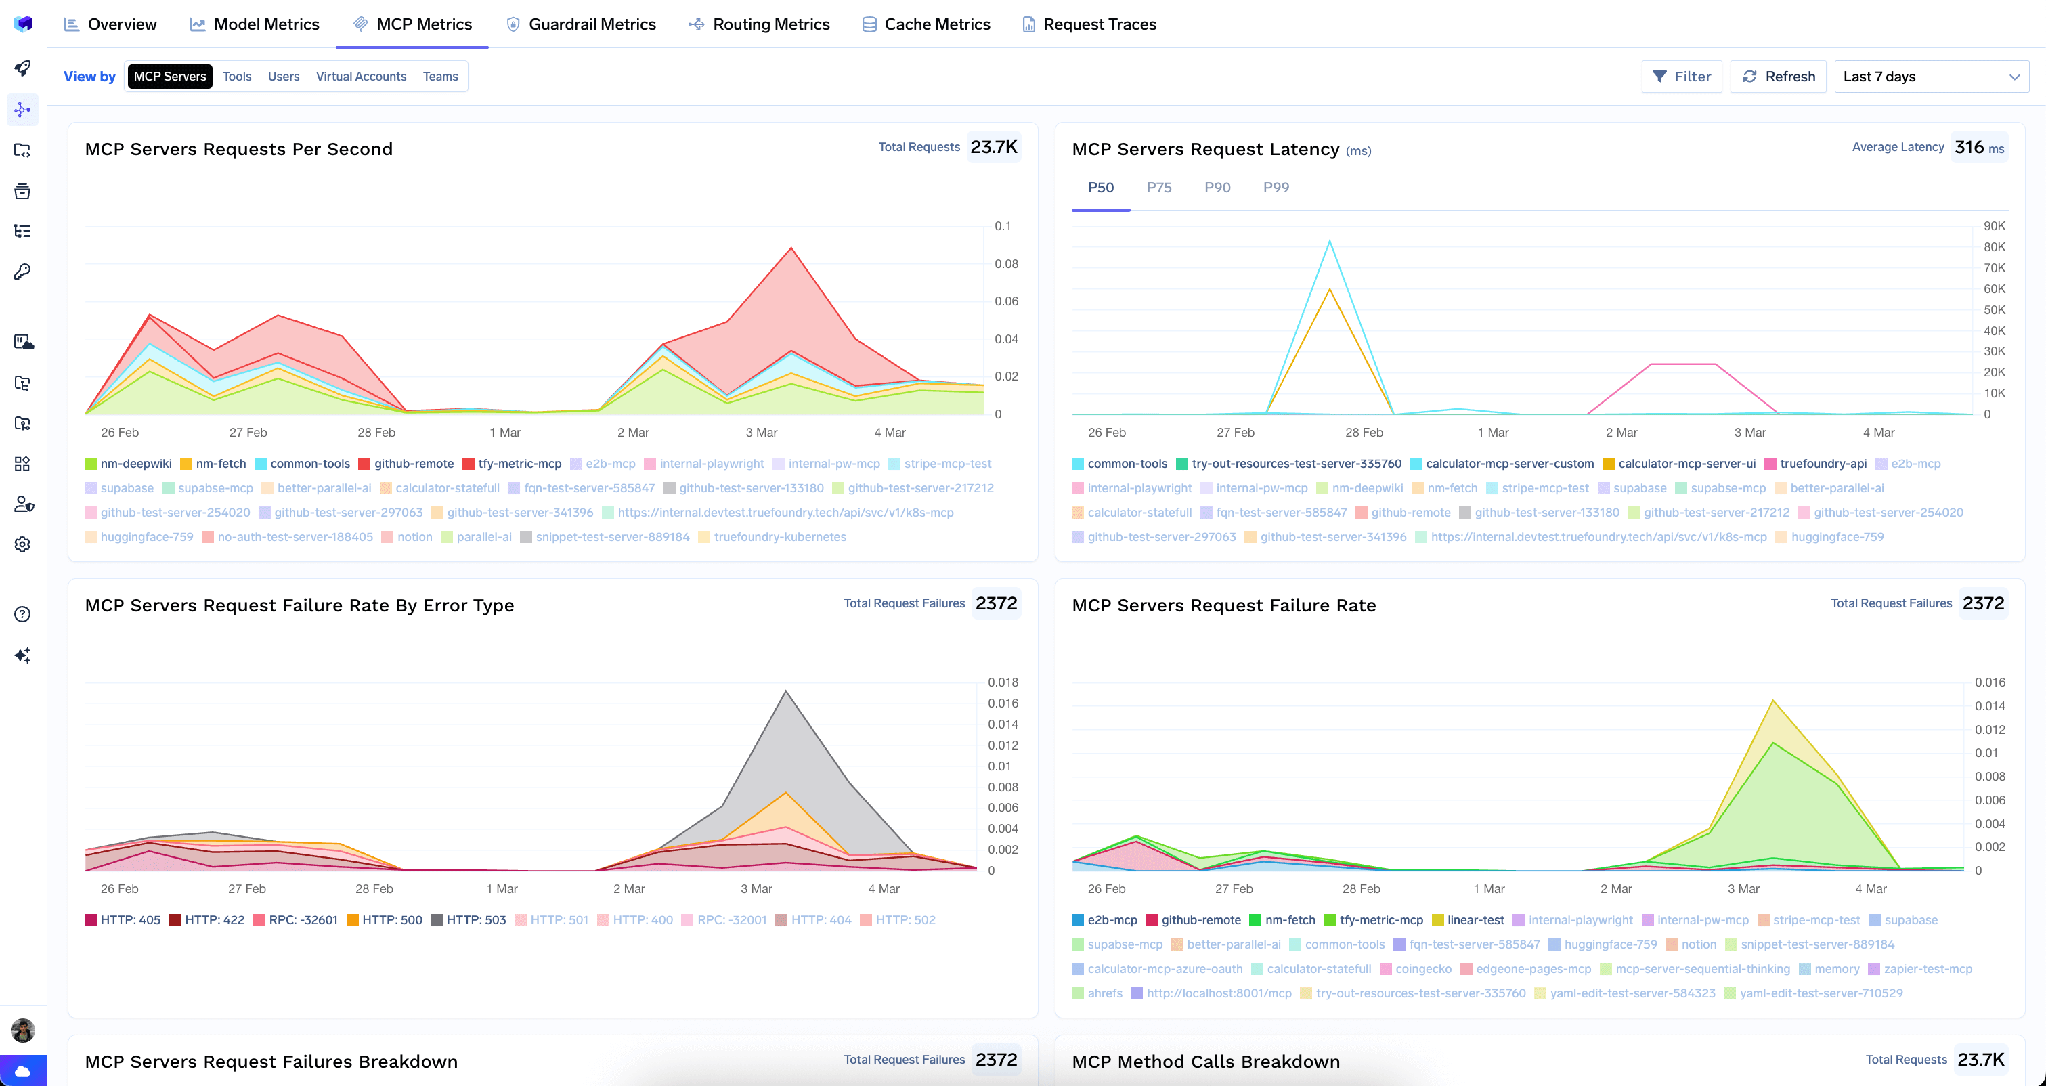
As chamadas de ferramenta recebem o mesmo tratamento por meio das métricas MCP — a metade que a maioria das configurações focadas em LLM ignora. A visualização de servidores fornece throughput por servidor, percentis de latência, taxa de falhas e detalhamento de erros, além de um detalhamento de chamadas de métodos em tools/list, tools/call, resources/list e o restante. Um agent gastando requisições em chamadas repetidas de tools/list tem um problema de descoberta, não um problema de tarefa.
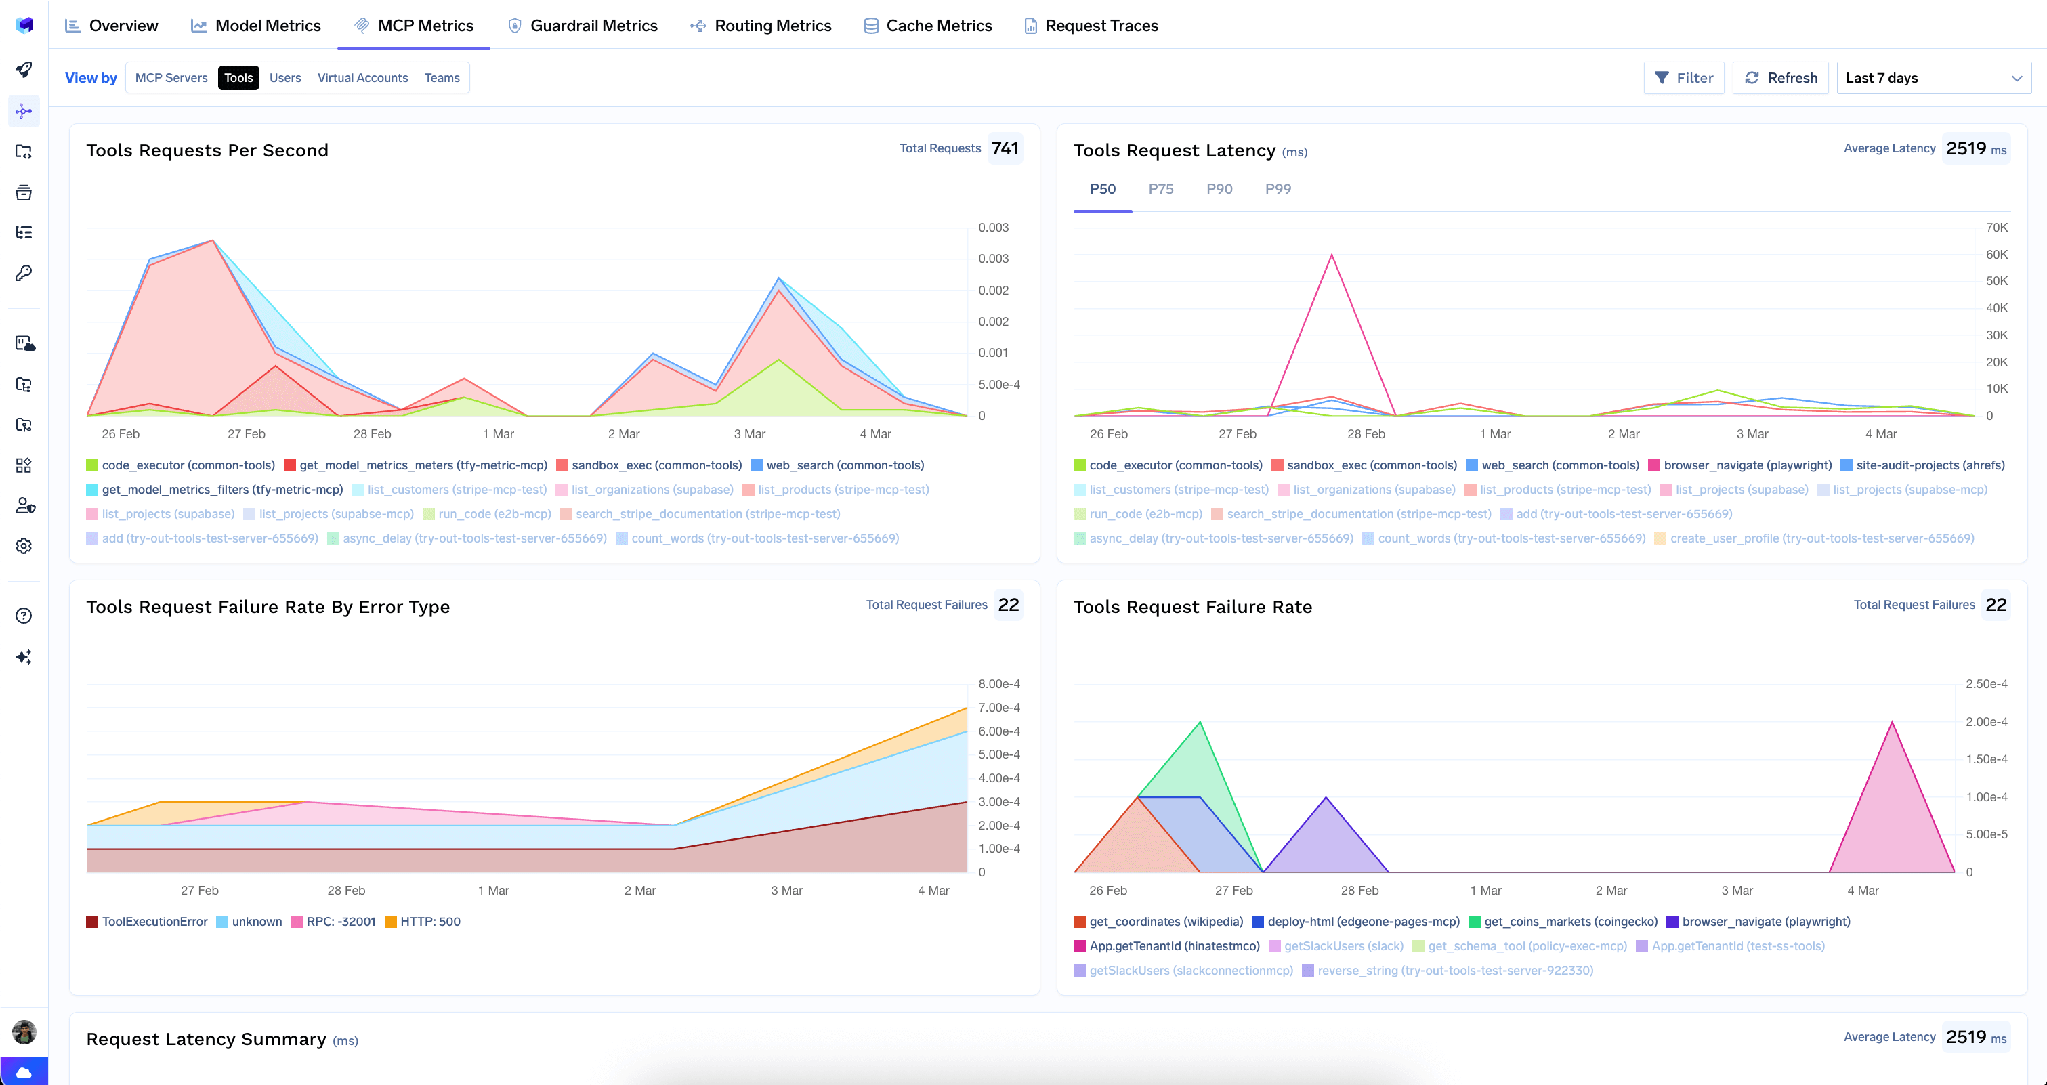
A visualização Tools detalha ferramentas individuais em todos os servidores: requisições por segundo, percentis de latência, taxa de falha por tipo de erro, um resumo lado a lado da latência e ferramentas classificadas pela contagem de requisições. Esse ranking é a maneira mais rápida de identificar uma ferramenta que o agent está utilizando mais do que o esperado.
Os filtros persistem entre as abas, portanto, ao restringir a um usuário na aba de modelo, o filtro é mantido quando você alterna para MCP — como você identifica se as sessões lentas são um problema do modelo ou da ferramenta sem precisar reconstruir a consulta.
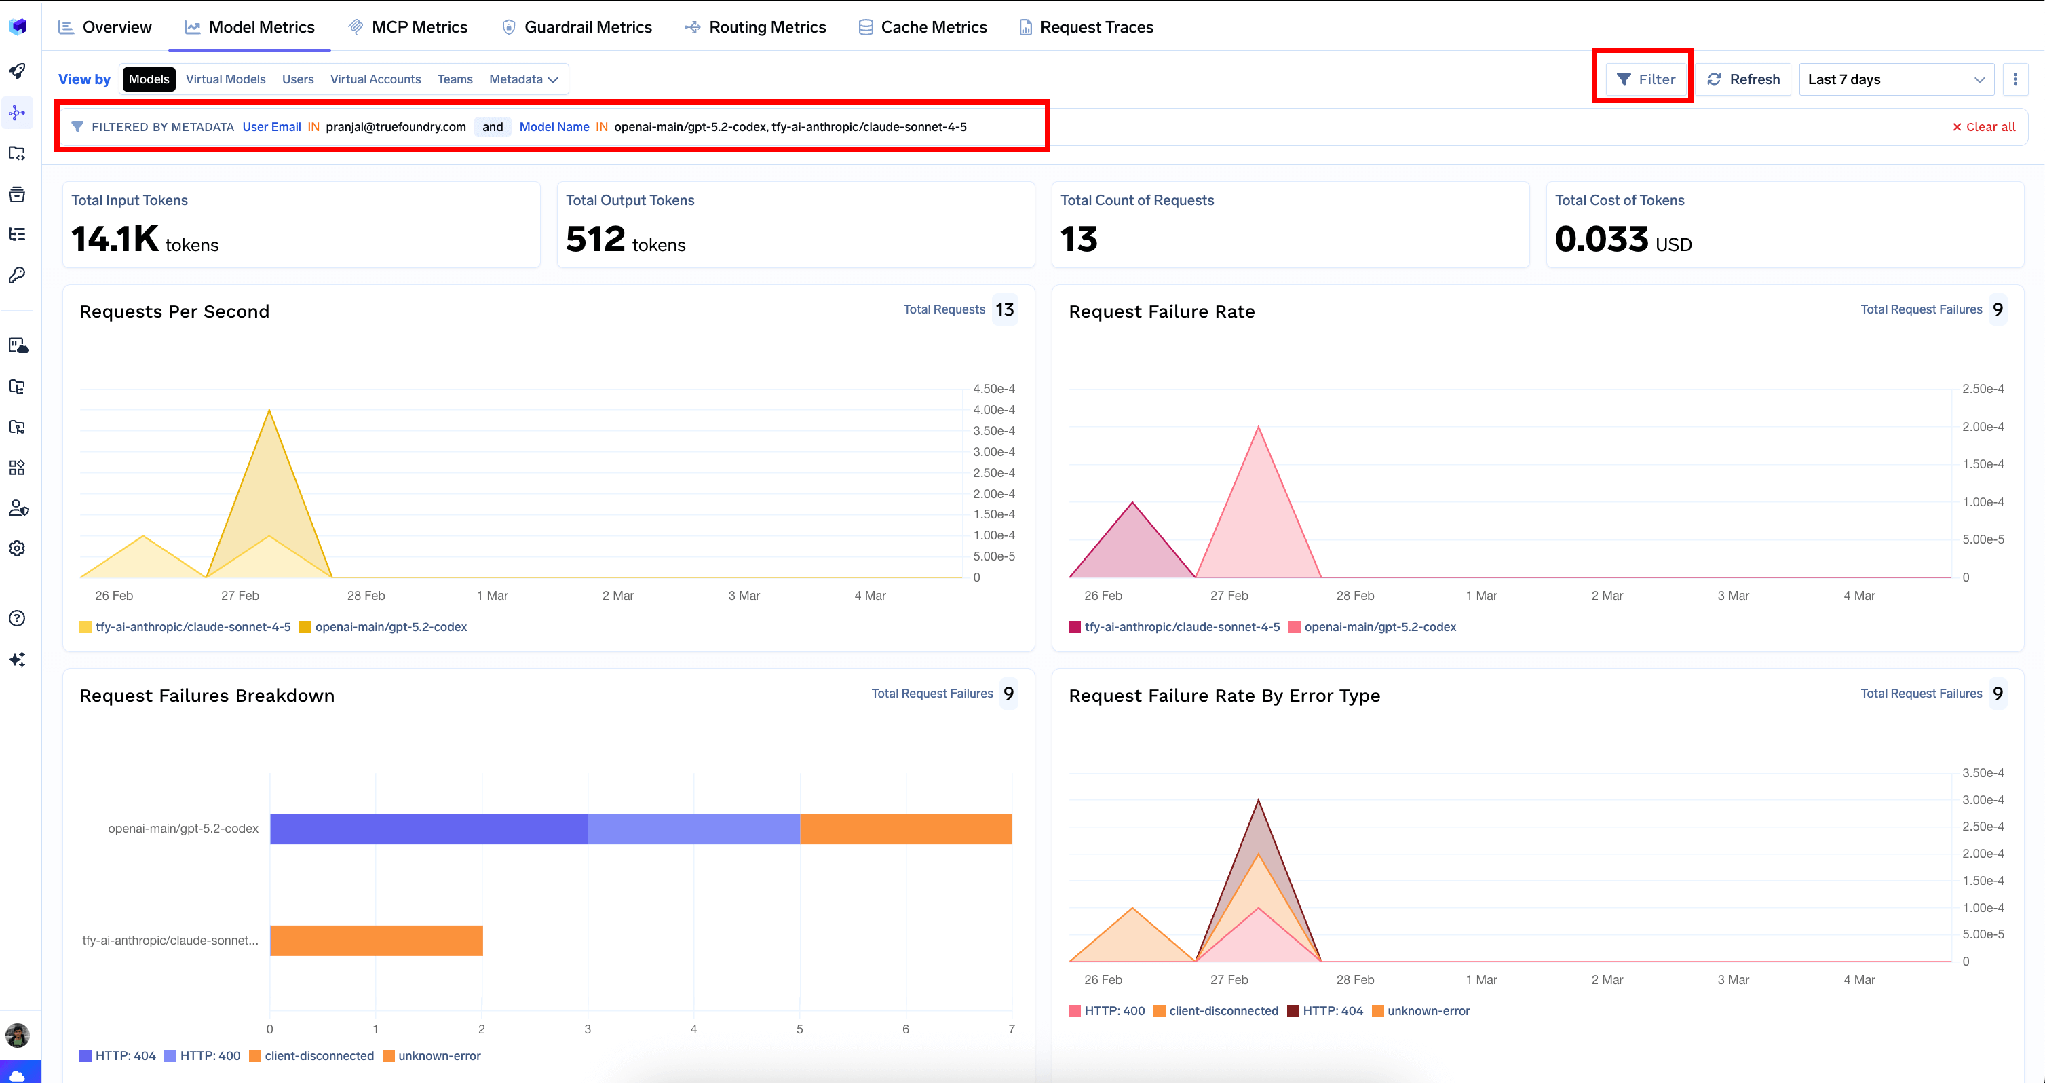
Agents registrados recebem um dashboard cobrindo contagem de requisições, percentis de latência, taxas de erro e uso ao longo do tempo — idêntico se o agent roda no Bedrock, LangGraph ou em um serviço customizado.

Os mesmos dados são consultáveis: a API de métricas expõe uma fonte de dados agentMetrics que retorna resultados de distribuição ou séries temporais agrupados por agentName, agentFramework ou agentServerType, com agregações percentuais em latencyMs. Em sistemas multi-agent, a opção Request Traces registra qual agent fez cada chamada e para qual usuário ele atuou — a atribuição que torna a chamada de ferramenta de um sub-agent rastreável de volta a uma pessoa.
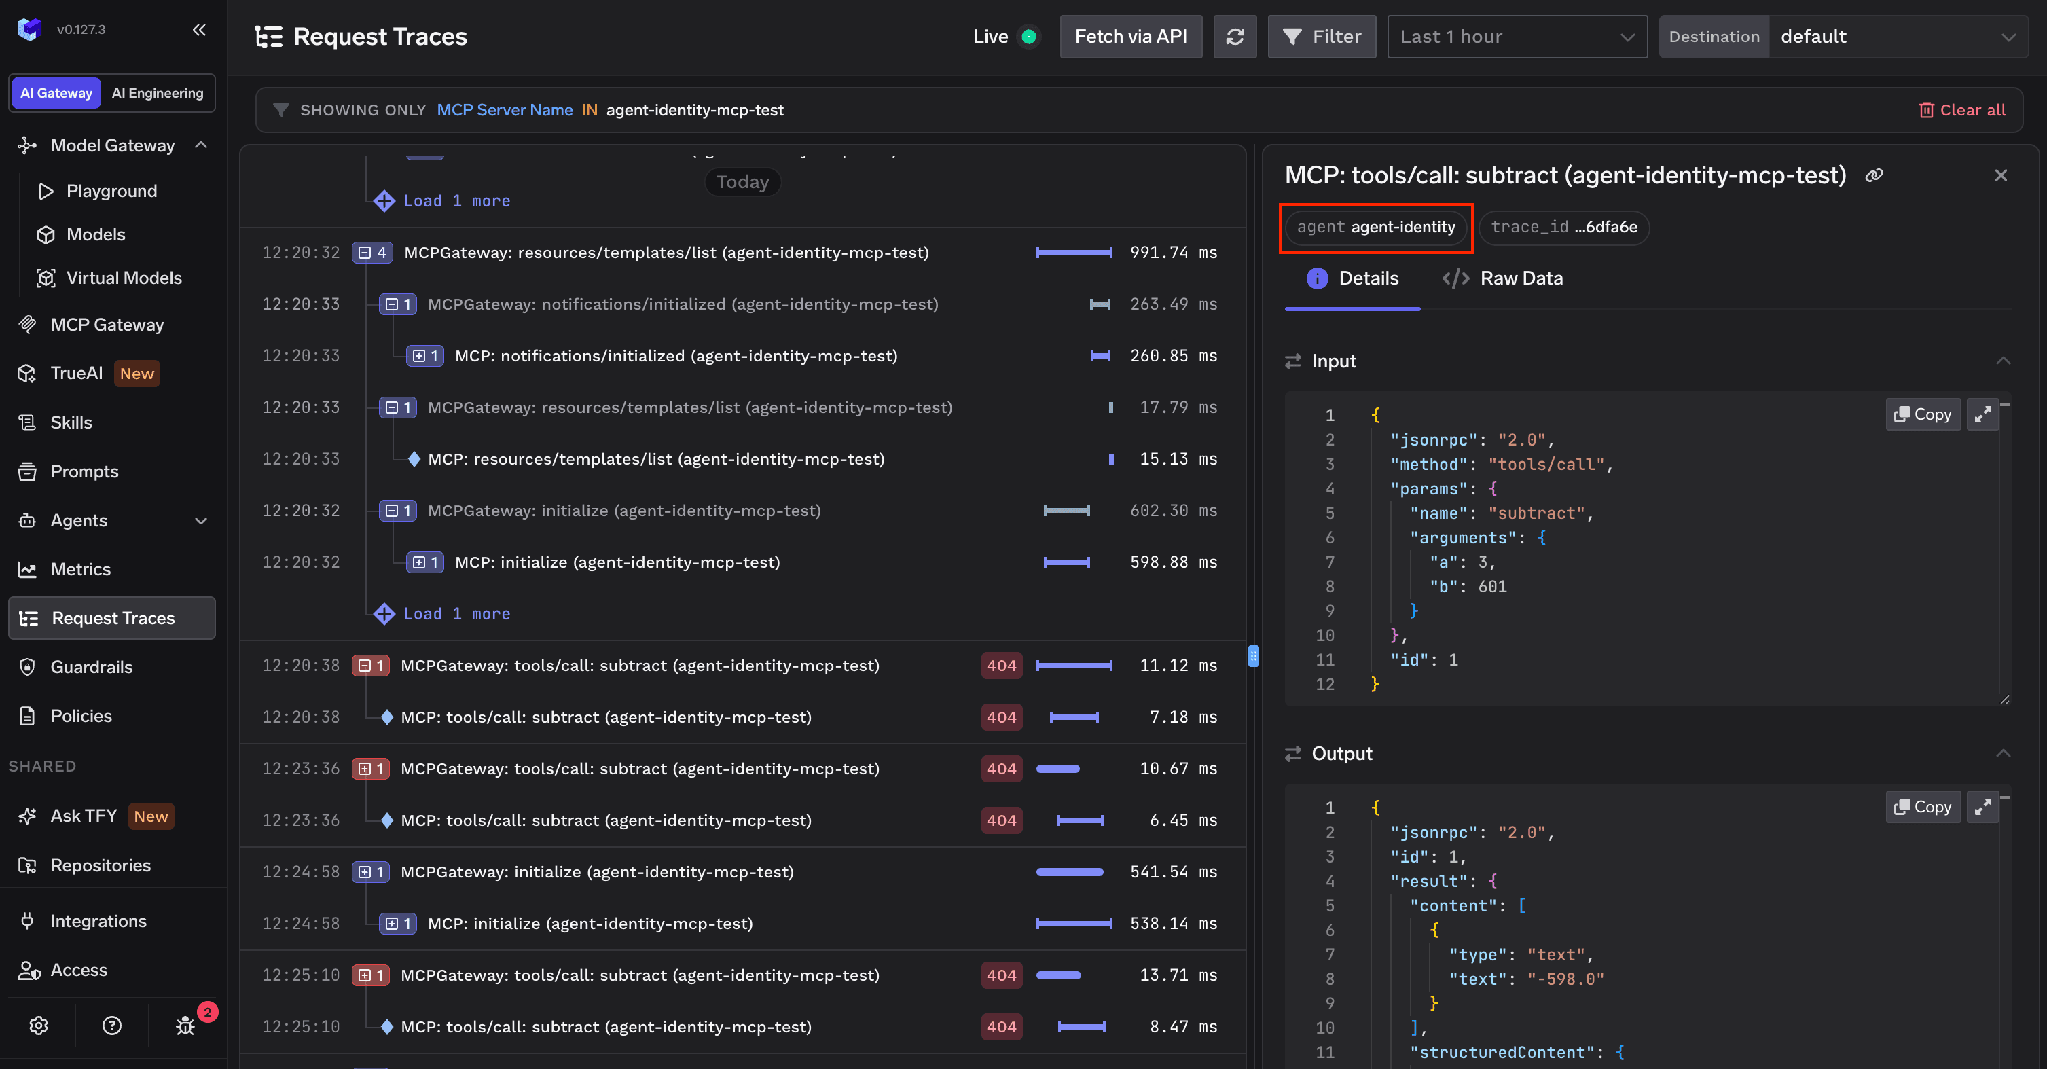
Uma limitação honesta: uma visualização completa da cadeia de atores conectando usuário → agent → sub-agent → ferramenta em um único trace renderizado estará disponível em breve, assim como a detecção de drift, alertas de anomalia e suspensão de agent com um clique. Hoje você obtém atribuição por hop em cada trace em vez da cadeia desenhada como uma imagem única.
Latência e custo são mensuráveis; a qualidade da resposta não é, razão pela qual o feedback pertence ao trace, e não a uma tabela separada. Cada resposta do gateway retorna um cabeçalho x-tfy-feedback-target-id. Envie isso para /api/svc/v1/gateway-feedback com uma classificação de 1 a 5 e um comentário opcional, e isso aparecerá ao lado do span e nos dados brutos sob tfyGatewayFeedbacks, atualizável ou editável pelo ID retornado. O ID de destino atualmente se refere ao span raiz, portanto o feedback vai para a requisição, e não para uma sub-etapa.
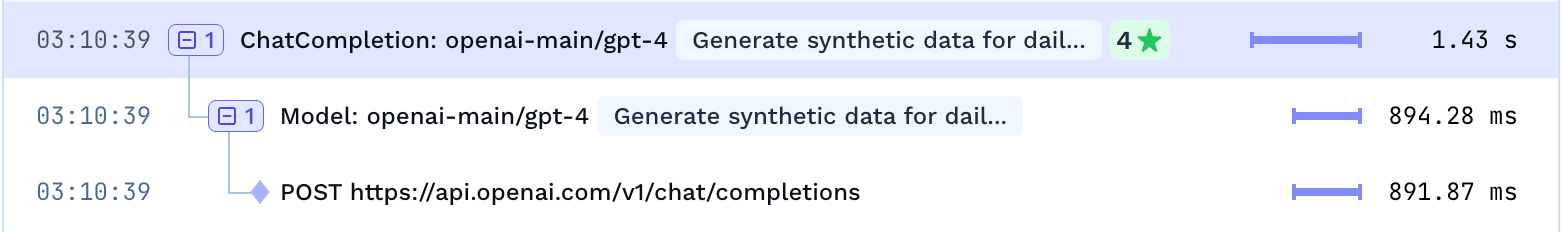
Conecte isso a um controle de thumbs-up em seu produto e as sessões discrepantes receberão um rótulo de qualidade, transformando "esta execução custou 40x" em "esta execução custou 40x e o usuário deu nota 2".
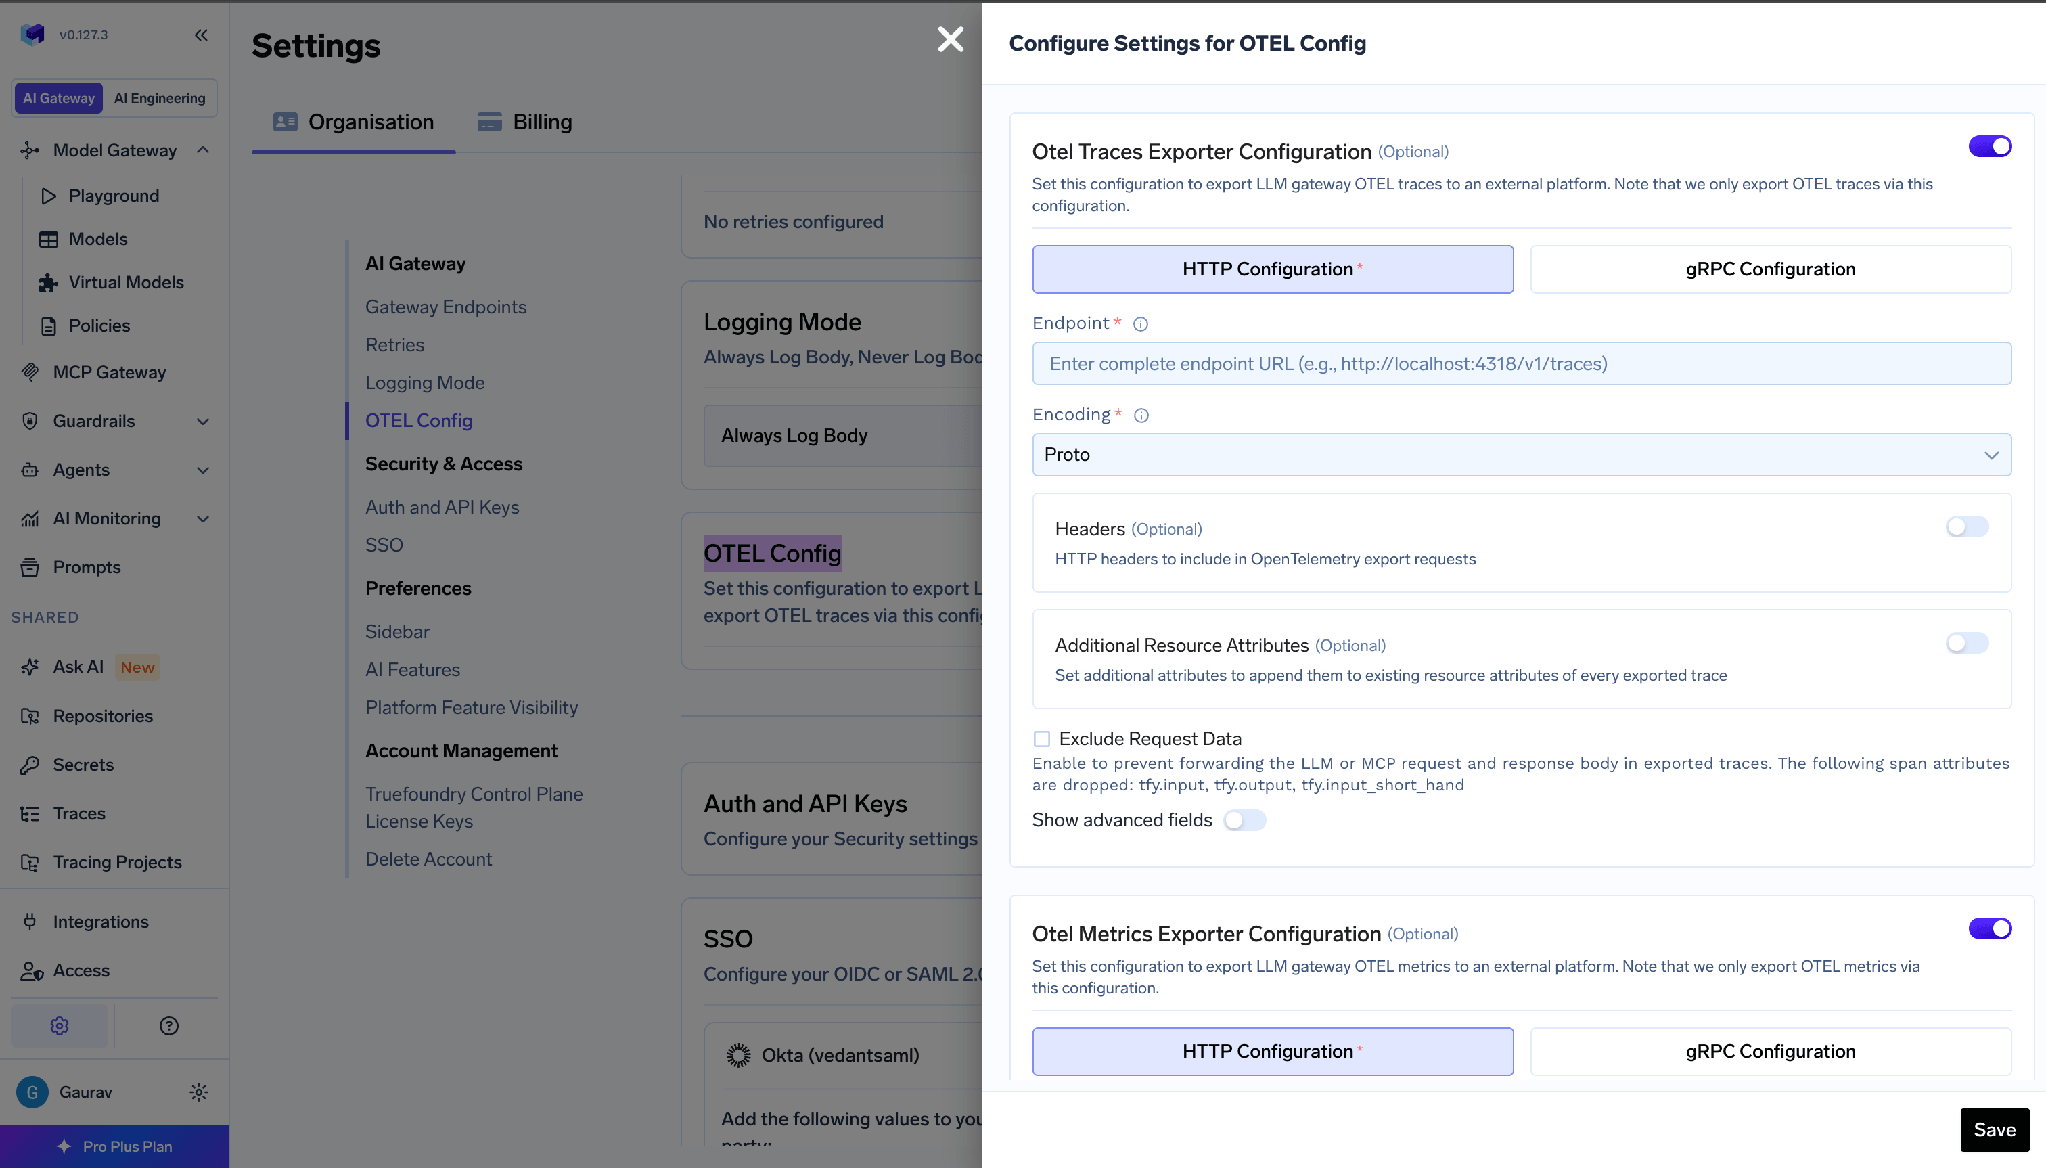
Nada disso exige abandonar a stack que você possui. O gateway é compatível com OpenTelemetry, e os traces e métricas são exportados de forma independente — ambos configurados em AI Gateway → Controls → Settings → OTEL Config, via HTTP ou gRPC, com codificação proto ou json e cabeçalhos de autenticação arbitrários. Backends que esperam métricas codificadas em delta, como Datadog e CloudWatch, exigem a opção Export Delta Metrics ativa mais uma variável de ambiente de temporalidade na implantação do gateway. O Prometheus pode coletar dados de /metrics em gateways auto-hospedados (self-hosted).
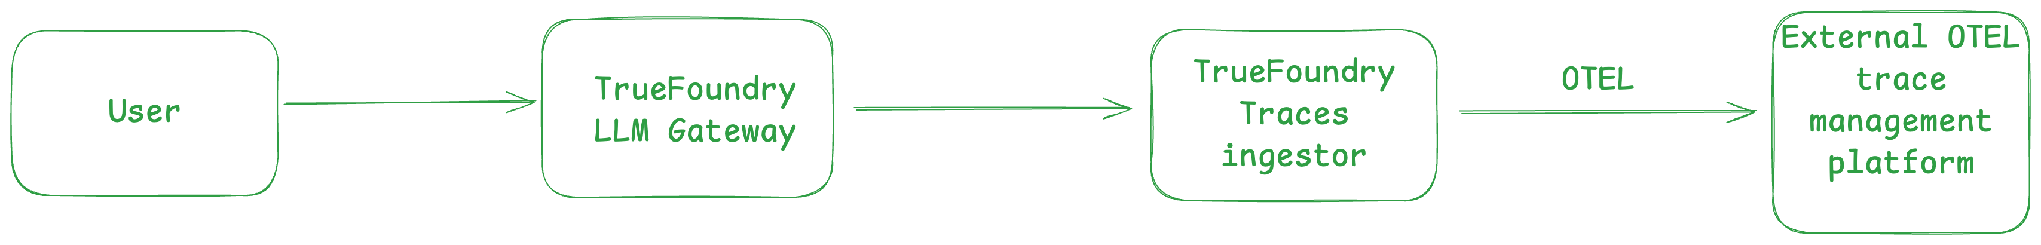
Fluxo de traces OpenTelemetry: traces armazenados pelo TrueFoundry e exportados para um backend externo
A exportação é aditiva, não uma transferência definitiva: o TrueFoundry continua armazenando traces de qualquer maneira, então as visualizações de sessão e span no produto permanecem disponíveis enquanto o Grafana ou o Datadog recebem os mesmos dados.
Copilot de suporte, uma semana em produção. O time financeiro pergunta por que a fatura triplicou.
Comece no nível da sessão. Ordene por custo. A mediana é de alguns centavos; quatro sessões passam de um dólar, todas com contagem de turns de um único dígito — então não se trata de conversas longas, são turns individuais fazendo coisas demais.
Abra uma e leia a linha do tempo. O Turn 3 está quase inteiramente com a cor de chamada de ferramenta. Chamadas de ferramenta: 31. Erros: 0. Nada falhou, razão pela qual nenhum alerta foi disparado.
Expanda os agent steps para o turn 3. A lista ordenada mostra uma ferramenta de busca de documentos chamada repetidamente, e os tokens por turn sobem acentuadamente a partir do turn 3 sem voltar a cair — um documento grande entrou no contexto e permaneceu lá.
Confirme no nível da ferramenta. Em métricas MCP, na visualização Tools, essa ferramenta lidera a classificação de contagem de requisições por uma margem ampla e tem o pior p90.
Corrija e verifique. Se a correção for uma ferramenta mais restrita, paginação ou uma mudança no prompt informando ao agent que ele já possui o arquivo, a verificação é a mesma: filtre as sessões para aquele agent no dia seguinte e verifique se a distribuição de custos se achatou. Se você conectou o feedback, verifique se os casos discrepantes também foram as execuções com notas baixas — geralmente são.
Cinco etapas, nenhuma instrumentação customizada, cada uma sendo uma pergunta sobre a trajetória.
As métricas de agent incluem todas as requisições do gateway por padrão. As linhas que não passaram por um agent retornam null para agentName, agentFramework e agentServerType, e aparecem como agrupamentos nulos na saída do groupBy. IS_NULL não é suportado nesses três campos, portanto defina o escopo com agentName IN [...] ou um operador STRING_*.
A exportação de traces e métricas é configurada separadamente. O exportador de traces envia apenas traces, o exportador de métricas apenas métricas. Habilitar um e presumir que o outro acompanhou é uma maneira comum de terminar com metade do cenário.
Planeje os metadados antes de precisar deles. Chaves de metadados personalizadas enviadas como cabeçalhos de requisição tornam-se uma dimensão View by em todo o dashboard. Adicionar um nome de agent, ambiente ou ID de execução com antecedência não custa nada; fazer isso mais tarde significa que os dados do trimestre passado não poderão ser fatiados dessa forma.
A tentação no monitoramento de agents é acoplar um agent aos dashboards existentes, observar o p99 e a taxa de erros e considerar que ele está observado. Isso funciona perfeitamente até o primeiro incidente, quando você descobre que a execução que estourou seu orçamento retornou 200 em cada hop e não aparece em nenhum gráfico.
A solução não são mais métricas, mas uma unidade de observação diferente. Registre a trajetória — sessão, turn, chamada de modelo, chamada de ferramenta, com argumentos e resultados nos spans — e as três falhas que realmente acontecem tornam-se simples de resolver: um loop é uma chamada repetida com argumentos idênticos, um resultado de ferramenta ruim é visível porque você o manteve, e uma execução de 40x é o caso discrepante que você ordena para o topo.
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



Registrar a trajetória de execução completa de um agente — sessões, turnos, chamadas a modelos e chamadas a ferramentas, com argumentos, resultados, tokens, custo e latência — para que você consiga responder por que ele se comportou daquela forma. Ela difere do monitoramento de aplicações na unidade de observação: uma requisição tem início e fim, enquanto uma trajetória é uma sequência aninhada em que qualquer nível pode entrar em loop.
A observabilidade de LLM é um subconjunto que cobre a chamada ao modelo: prompt, resposta, tokens, latência e custo. A observabilidade de agentes acrescenta tudo o que está ao redor — quais ferramentas foram executadas, em que ordem, com quais argumentos e resultados, e quantas voltas um turno deu antes de parar. A maioria das falhas reais está nessa estrutura, e não em uma única resposta.
Não, se o tráfego de modelos e de ferramentas já passa por um gateway, pois ele registra cada salto como efeito colateral de atendê-lo. A instrumentação por SDK no nível do framework acrescenta etapas internas de raciocínio que o gateway nunca vê, então as duas são complementares, e não alternativas.
Sim — em VPC, on-prem, air-gapped, híbrido ou em várias nuvens, sem que nenhum dado saia do seu domínio.
Sim. Ele inclui um MCP Gateway, um Agent Gateway e um MCP & Agents Registry com controle de acesso em nível de ferramenta. Agentes criados com LangGraph, CrewAI, AutoGen ou um framework próprio podem ser governados de forma centralizada.
Sim. O gateway é compatível com OpenTelemetry e se integra com Grafana, Datadog, Prometheus ou a sua stack preferida. Ele rastreia cada requisição, do prompt à execução da ferramenta e do modelo, para que você obtenha logs unificados sem precisar remover o que você já usa.



As últimas notícias, artigos e recursos enviados para sua caixa de entrada



















