



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Er was eens – ongeveer zes maanden geleden in startup-jaren – Jason, een briljante ML-engineer bij een snelgroeiend fintech-bedrijf. Jason was de lokale "AI-fluisteraar". Wanneer het productteam wilde dat hun nieuwe LLM-aangedreven chatbot empathischer klonk, maar minder gevoelig was voor hallucinaties over rentetarieven, belden ze Jason.
Jasons gereedschapskist was omvangrijk: geavanceerde vector databases, sterk geoptimaliseerde Kubernetes-clusters en geavanceerde CI/CD-pipelines. Maar het hart van de operatie, de werkelijke prompts die deze functies van miljoenen dollars aanstuurden, leefde in een wankel ecosysteem.
Sommige prompts waren hardcoded in Python f-strings, diep verborgen in voorwaardelijke logica als aloude artefacten. Andere stonden in een gedeeld Google Doc van 40 pagina's met de titel "FINAL_PROMPTS_v3_REAL_FINAL(2).docx", bijgehouden door drie verschillende productmanagers. De nieuwste experimentele prompts werden om 23:30 uur door de CEO via Slack naar Jason gestuurd.
Toen een klant klaagde dat de chatbot hem verwarrend genoeg een hypotheek in het Klingon had aangeboden, debugde Jason geen code. Jason ging op archeologische opgraving door de Slack-historie en git-commits om te achterhalen welke versie van de "empathie-prompt" in productie draaide en wie deze als laatste had gewijzigd.
Jason was geen engineering meer aan het doen. Jason deed digitaal schoonmaakwerk. Het team had een Ferrari-motor gebouwd, maar bestuurde deze met losse stukjes touw.
De pijn achter het bovenstaande verhaal is acuut en universeel. Het overbrengen van generatieve AI van een hackathon-prototype naar een betrouwbaar productiesysteem legt een cruciaal ontbrekend onderdeel in de traditionele MLOps-stack bloot.
In de beginperiode leek het logisch om prompts als code te behandelen. Je beheert ze in Git en deployt ze met de applicatie. Maar naarmate teams schalen, stort dit model in. Prompts zijn geen traditionele code; ze zijn configuratie, bedrijfslogica en gebruikersinterface gecombineerd in één natuurlijketaalpakket.
Wanneer prompts nauw gekoppeld zijn aan codebases, ontstaan er verschillende kritieke problemen:
Om de kloof van prototype naar productie te overbruggen, moeten we stoppen met het behandelen van prompts als "magische strings" die verspreid liggen over onze infrastructuur. We moeten ze behandelen als eersteklas burgers.
Voordat een gestructureerde aanpak wordt geïmplementeerd, ziet de workflow er vaak uit als een ingewikkeld web van miscommunicatie en handmatig werk.
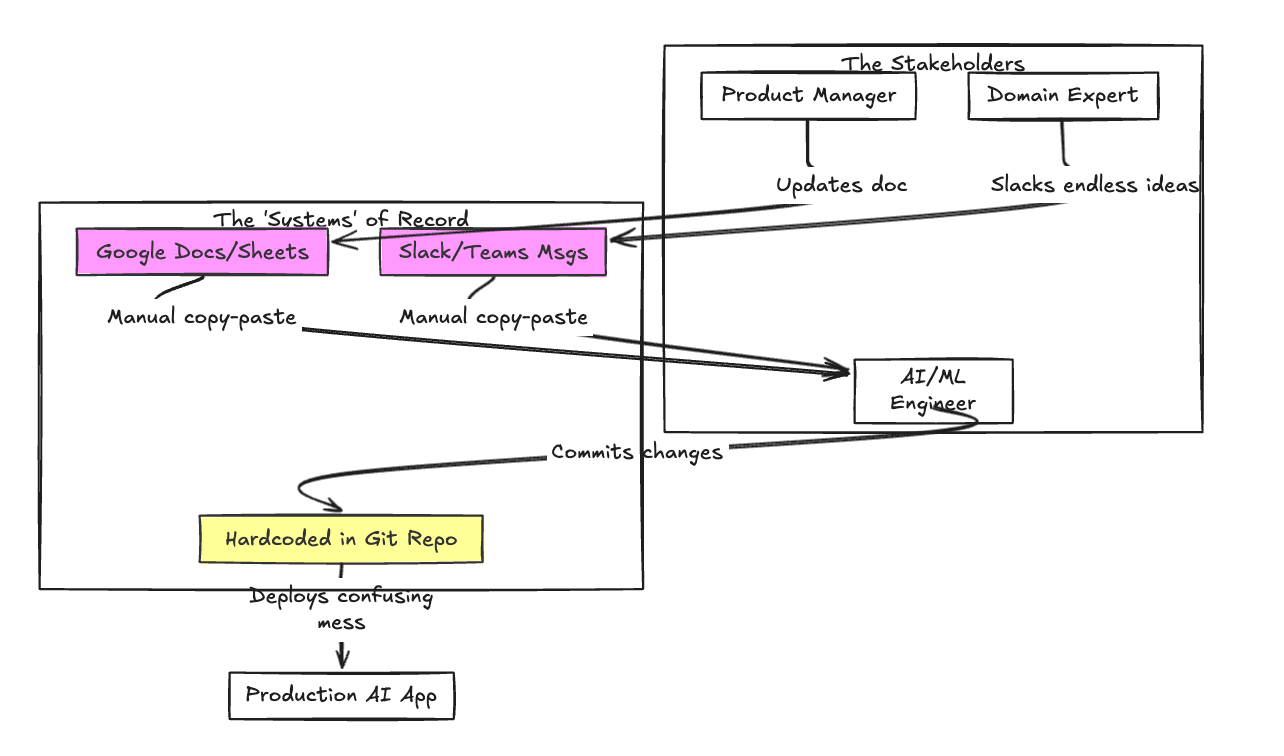
Dit is waar een dedicated Prompt Management System essentieel wordt. Het vormt de brug tussen de experimentele kunst van prompt engineering en de strikte discipline van productie-software-engineering.
TrueFoundry fungeert als dit centrale besturingssysteem. Het is ontworpen om prompt management los te koppelen van applicatielogica, waardoor teams kunnen samenwerken, versiebeheer kunnen toepassen, kunnen evalueren en prompts kunnen deployen met dezelfde strikt heid die ze toepassen op traditionele code, maar met interfaces die zijn ontworpen voor de specifieke behoeften van LLM-workflows.
TrueFoundry transformeert prompt management van een ad-hoc taak naar een gestructureerde, auditeerbare infrastructuurlaag.
TrueFoundry biedt een gecentraliseerde prompt registry. Geen zoektochten meer door Google Docs of codebases. Elke prompt, voor elke use case, bevindt zich op één veilige, toegankelijke locatie.
Dit is de meest aanzienlijke verandering voor de ontwikkelsnelheid. In TrueFoundry bevat je applicatiecode niet de prompttekst. In plaats daarvan bevat het een lichte SDK-call die de actieve versie van de gewenste prompt ophaalt.
Dit betekent dat een Product Manager een prompt kan itereren, deze kan testen in TrueFoundry's playground en deze naar productie kan "promoten" zonder dat een engineer ooit de applicatiecode hoeft aan te raken of een nieuwe deployment hoeft te starten.
Met TrueFoundry verandert de chaos in een gestroomlijnde levenscyclus. Belanghebbenden werken samen in de hub, versies worden strikt bijgehouden en applicaties gebruiken prompts betrouwbaar via API, waarbij rate limiting in AI gateway zorgt voor stabiel productiegedrag bij zwaar gebruik.
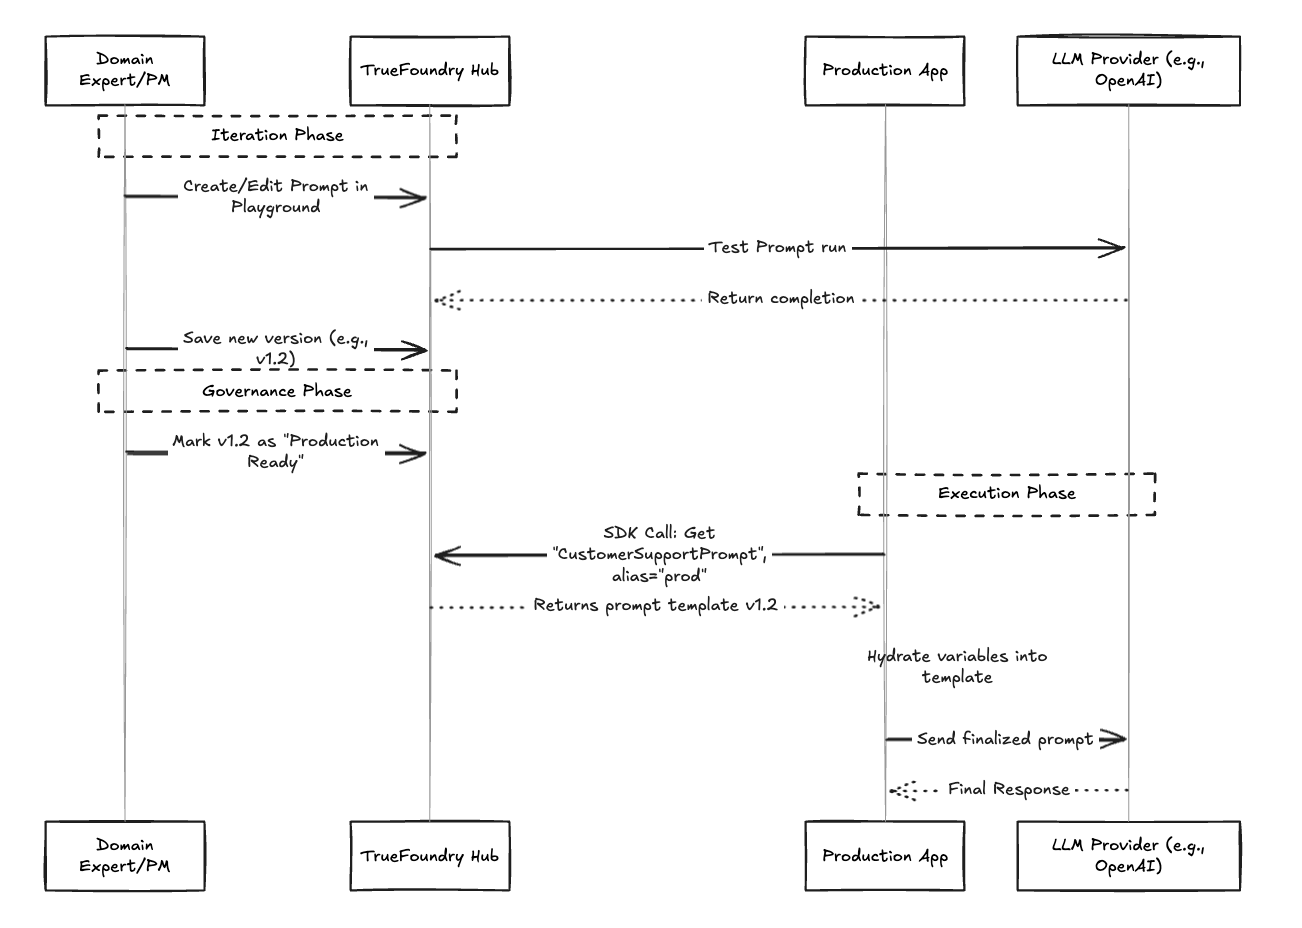
Het beheren van de prompttekst is slechts de helft van het werk. Hoe weet je of versie 2.0 daadwerkelijk beter is dan versie 1.5? TrueFoundry integreert evaluatie samen met beheer. Voordat je een prompt promoveert naar productie, kun je deze uitvoeren tegen golden datasets om er zeker van te zijn dat nauwkeurigheid, toon en veiligheid niet zijn achteruitgegaan.
Voor meer informatie kun je terecht op https://www.truefoundry.com/docs/ai-gateway/prompt-management
Om terug te keren naar ons verhaal: Jason heeft TrueFoundry geïmplementeerd. De Google Docs zijn gearchiveerd. De hardcoded strings zijn vervangen door SDK-calls.
Wanneer de CEO nu de toon van de chatbot wil veranderen, logt deze in op TrueFoundry, stelt een nieuwe versie op, test deze tegen een paar voorbeelden en tagt Jason voor beoordeling. Jason kan het exacte verschil zien, er een evaluatieset tegenover zetten en het binnen enkele minuten goedkeuren voor deployment—alles zonder één regel Python te schrijven.
De overstap naar productie-AI vereist het inzicht dat prompts een nieuwe klasse van software-artefacten zijn. Ze hebben hun eigen dedicated infrastructuur nodig. TrueFoundry biedt de tooling om van de kunst van prompt engineering een beheersbare, schaalbare engineering-discipline te maken, zodat je generatieve AI-applicaties even robuust zijn als de rest van je stack.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















