



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
De text-to-speech- en speech-to-text-modellen van Smallest AI integreren met TrueFoundry AI Gateway via native passthrough. Verzoeken stromen naar de REST-eindpunten van Smallest AI voor batch-synthese en -transcriptie en naar de bijbehorende server-sent event-streams en WebSocket-eindpunten voor gechunkte audio-output en live transcriptie. De gateway vervangt de Bearer-token van Smallest AI vanuit zijn credential store, past toegangscontrole toe en verzendt OpenTelemetry-spans voordat het verzoek wordt geproxy'd of de WebSocket wordt geüpgraded.
Dit bericht behandelt het Smallest AI API-oppervlak binnen de TTS- en STT-families. Het behandelt ook hoe het gateway-vlak het native passthrough-pad afhandelt voor spraakeindpunten die niet compatibel zijn met OpenAI.
Smallest AI levert twee modelfamilies. Lightning is de text-to-speech-familie. Pulse is de speech-to-text-familie. Beide draaien als REST-eindpunten voor batchgebruik en als WebSocket-eindpunten voor streaminggebruik.
Lightning v3.1 is een 44 kHz TTS-model met een gepubliceerde time to first audio van minder dan 100 ms. Het ondersteunt 15 talen met een sterke dekking van Indische talen, waaronder Hindi, Tamil, Telugu, Malayalam, Kannada, Marathi en Gujarati, naast Engels, Spaans, Frans, Duits, Italiaans, Portugees, Zweeds en Nederlands. Het model maakt gebruik van een niet-autoregressieve architectuur die volledige spraaksegmenten parallel genereert in plaats van token voor token. Dit zorgt voor het latency-profiel en zorgt ervoor dat het model kan draaien in minder dan 1 GB VRAM, wat on-premises uitrol praktisch maakt voor gereguleerde omgevingen.
Het model wordt aangeboden via drie eindpuntvormen.
Pulse is de STT-tegenhanger. Het draait in twee vormen. POST /waves/v1/pulse/get_text verwerkt vooraf opgenomen audio in batch. WSS /waves/v1/pulse/get_text verwerkt live streaming transcriptie. Het streaming-eindpunt accepteert audioframes op 8000, 16000, 22050, 24000, 44100 of 48000 Hz met linear16 als standaardcodering. Het ondersteunt 36 talen met code-switching ingeschakeld via language=multi.
De interessante onderdelen van het Pulse-streamingprotocol voor een integratie achter een gateway zijn de inline content-controls. redact_pii=true verwijdert persoonlijk identificeerbare informatie (PII) uit definitieve transcripties voordat ze Smallest AI verlaten. redact_pci=true verwijdert betaalkaartinformatie, waaronder kaartnummers, CVV-codes, postcodes en rekeningnummers. diarize=true maakt sprekerdiarisatie mogelijk. keywords accepteert een door komma's gescheiden lijst met frasen met optionele intensiveringswaarden om de herkenning van domeinspecifieke terminologie zoals productnamen of geneesmiddelennamen te versterken. itn_normalize=true maakt Inverse Text Normalization mogelijk, wat gesproken getallen, datums en valuta's omzet in hun geschreven vorm in definitieve transcripties. De redactieparameters zijn van belang omdat ze privacyhandhaving naar de modellaag verplaatsen, in plaats van een downstream guardrail te vereisen om de transcriptie achteraf op te schonen.
Concurrency-model. Smallest AI biedt een ongebruikelijke concurrency-structuur die het waard is om te begrijpen voordat u ermee gaat bouwen. Eén concurrency-eenheid komt overeen met één actief TTS-verzoek dat op een bepaald moment kan worden verwerkt. Er kunnen maximaal drie WebSocket-verbindingen worden opgezet per concurrency-eenheid voor TTS. Een tenant met drie concurrency-eenheden kan dus negen WebSocket-verbindingen openhouden, maar slechts drie daarvan kunnen tegelijkertijd een actieve generatie in uitvoering hebben. Aanvullende verzoeken die via een verbinding worden verzonden terwijl de concurrency-limiet is bereikt, worden afgewezen met een foutmelding in plaats van in een wachtrij te worden geplaatst. Dit verschilt van het typische token-per-minute- of request-per-minute-model en heeft gevolgen voor de configuratie van de rate limiter van de gateway. Voor STT is één concurrency-eenheid één WebSocket-verbinding.


De TrueFoundry AI Gateway is gebouwd op het Hono-framework en draait als een vloot van stateless pods. Een enkele pod op 1 vCPU en 1 GB RAM verwerkt meer dan 250 RPS met ongeveer 3 ms toegevoegde latency. Het control plane beheert de configuratie in PostgreSQL en ClickHouse en verspreidt updates naar de gateway-pods via NATS. Gateway-pods cachen die configuratie in het geheugen, zodat het verzoekpad geen externe aanroepen maakt voor authenticatie, autorisatie of routingbeslissingen.
Voor providers die compatibel zijn met OpenAI vertaalt de gateway binnen een adapter tussen het inkomende OpenAI-formaat en het native formaat van de provider. Smallest AI past niet in die vertaling omdat de OpenAI Audio API geen equivalent heeft voor de parameters voice_id, pronunciation_dicts en session_id van Smallest AI, en geen equivalent heeft voor het WebSocket-streamingprotocol dat de gechunkte audio-output van Lightning levert. De gateway biedt Smallest AI daarom aan via native passthrough.
Wanneer een Smallest AI-verzoek een gateway-pod bereikt, voert de pre-forwarding pipeline dezelfde controles uit als voor chat completions. De JWT die bij het verzoek wordt aangeboden, wordt gevalideerd tegen gecachte IdP public keys zonder externe auth-aanroep. Autorisatie wordt gecontroleerd tegen de in-memory map van gebruikers naar modellen. De model-identifier (lightning-v3.1 of pulse) wordt herleid naar het geconfigureerde Smallest AI-account. De inkomende Authorization-header wordt verwijderd en vervangen door de Bearer-token die is opgehaald uit de credential store. De doorgestuurde URL wordt https://api.smallest.ai/... met behoud van het overeenkomstige pad en de methode. De body wordt ongewijzigd doorgestreamd. Voor de WebSocket-eindpunten voert de gateway een HTTP Upgrade-handshake uit tegen de Smallest AI WebSocket-URL. Nadat de upgrade is geslaagd, houdt de gateway twee WebSocket-verbindingen vast (één met de client en één met Smallest AI) en proxiet hij frames in beide richtingen zonder payloads te interpreteren. De X-External-Session-Id en X-External-Request-Id echo-headers worden intact doorgegeven aan de aanroeper.
Nadat het verzoek is voltooid, publiceert de gateway een span naar NATS met daarin de duur, status, de herleide modelnaam en de kostenmetadata. De OTEL-exporter leest uit het asynchrone pad en stuurt de span via gRPC of HTTP door naar de geconfigureerde backend. De aggregator-service telt de kostengegevens op per gebruiker, per team en per model.

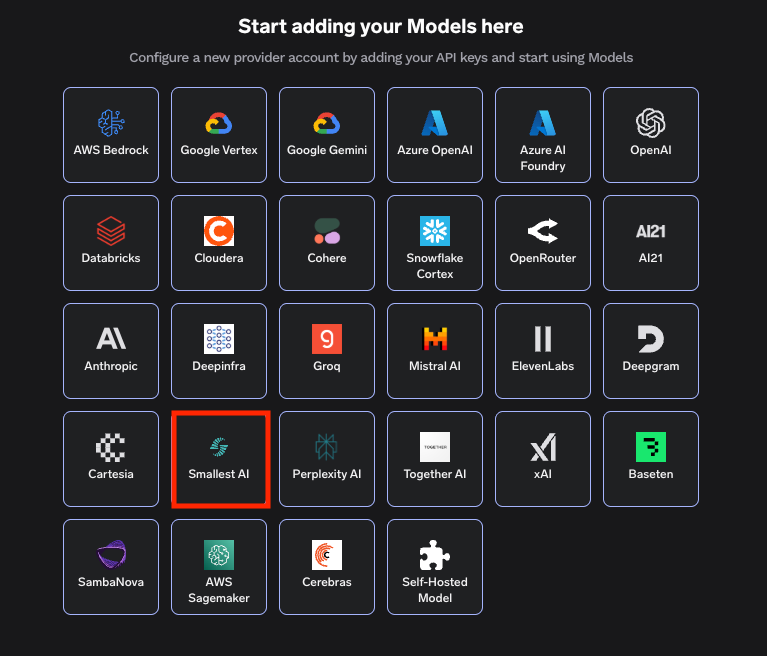
Het toevoegen van Smallest AI aan TrueFoundry AI Gateway vereist drie stappen in het dashboard. Navigeer naar AI Gateway, vervolgens naar Models en selecteer Smallest AI. Voeg een account toe door een unieke accountnaam en de Smallest AI Bearer-token in te voeren. De token wordt versleuteld opgeslagen in het control plane en wordt nooit rechtstreeks blootgesteld aan de gateway-pods. Voeg optioneel collaborators toe om te bepalen welke gebruikers en teams via dit account kunnen routen. Registreer vervolgens een of meer modellen door op Add Model te klikken en de Display name, Model ID en Model type op te geven. De Model ID moet exact overeenkomen met de Smallest AI model-identifier (lightning-v3.1, lightning-v2 of pulse).
Inferentie maakt gebruik van de Smallest AI Python SDK of een willekeurige HTTP-client met de gateway-URL als basis-URL. Een Python-client ziet er als volgt uit.
Dezelfde structuur werkt voor het SSE-eindpunt door het pad te wijzigen en de respons als een stream te lezen. Het WebSocket-eindpunt werkt via elke standaard WebSocket-client door naar de gateway-URL te wijzen met het wss-schema. De door TrueFoundry uitgegeven JWT vervangt de Smallest AI Bearer-token in de Authorization-header. De Smallest AI-client ziet dezelfde response payload en headers als wanneer deze rechtstreeks met Smallest AI zou communiceren, omdat de gateway de URL-paden en de responsvormen behoudt, inclusief de X-External-Session-Id en X-External-Request-Id correlatie-headers.
De end-to-end datastroom is eenvoudig. Een client opent een HTTP-verzoek of een WebSocket naar de gateway-URL met behulp van de Smallest AI Python SDK of een generieke HTTP- en WebSocket-client. De gateway-pod authenticeert de JWT tegen gecachte IdP public keys en herleidt de model-identifier naar het geconfigureerde Smallest AI-account. Het verwijdert de inkomende auth-header en vervangt deze door de Bearer-token uit de credential store. Het stuurt het verzoek door naar https://api.smallest.ai of upgradet de WebSocket naar de bijbehorende wss:// URL. Voor WebSocket-sessies overbrugt het frames in beide richtingen totdat een van de kanten de verbinding sluit. Na voltooiing publiceert de gateway een span naar NATS, die de OTEL-exporter en de kostenaggregator voedt.
Wat niet nodig is, is aanzienlijk. Er is geen Smallest AI SDK-fork. Er is geen vertaallaag tussen de OpenAI Audio-vorm en de voice_id- en pronunciation_dicts-parameters van Smallest AI die informatie zou verliezen op de grens. Er is geen schaduw-tracingpipeline voor spraakverkeer gescheiden van de chatverkeerpipeline. Er is geen Bearer-token per service verspreid over applicatiecode of Kubernetes secrets. Er is geen afzonderlijke WebSocket-terminator die naast de gateway moet worden uitgerold om toegangscontrole toe te passen op de streaming-eindpunten. De Pulse PII- en PCI-redactieparameters reizen onaangeraakt door de gateway, waardoor de privacyhandhaving in de modellaag blijft waar de redactiepipeline van Smallest AI draait, in plaats van deze te fragmenteren over een downstream guardrail.
Het architectonische principe is de scheiding tussen protocolsemantiek en governance-semantiek. Lightning's gechunkte audiostreaming en Pulse's streaming transcriptie met inline redactie dragen spraakdomeinbetekenis die niet kan worden gegeneraliseerd naar andere providers. De governancelaag (authenticatie, autorisatie, credential-injectie, observeerbaarheid, kostenaggreatie en rate limiting op de teamgrens) is provider-agnostisch en draait voor elke HTTP- of WebSocket-origin zonder payloads te inspecteren. Native passthrough behoudt het eerste terwijl het tweede wordt toegepast. Het resultaat is dat het volledige functionaliteitsoppervlak van Smallest AI (de ondersteuning van 15 talen van Lightning, de Indische stemmen, de PCI-redactie van Pulse en het expliciete concurrency-model) beschikbaar is voor clients, terwijl de operationele garanties die de rest van de AI Gateway biedt voor chatverkeer van toepassing zijn op spraakverkeer op dezelfde gateway-pods met hetzelfde control plane en dezelfde trace- en kosten-backends.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















