



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Een tool kan de juiste gegevens retourneren in de verkeerde vorm voor het redeneervermogen van het model. Het verwerken van grote antwoorden scheidt het bezit van de payload van directe aandacht voor elke byte.
Een MCP-tool kan met succes antwoorden en toch de run verstoren. Een repository-API kan honderden pull requests met lange beschrijvingen retourneren. Een metrics-tool kan elke tijdreeks uitzenden. Een CRM-zoekopdracht kan geneste geschiedenissen aan elk account koppelen. De payload is in principe relevant, maar het model heeft mogelijk slechts drie velden nodig.
Als het volledige resultaat de context binnenkomt, gebeuren er meerdere dingen tegelijk: de invoer groeit, latere redeneringen erven de omvang, belangrijke feiten concurreren met irrelevante velden, en vervolganroepen kunnen de run richting de limiet van het model duwen. De tool om minder vragen is de voorkeur wanneer de API projectie, paginering of filtering ondersteunt. De runtime heeft nog steeds een fallback nodig, omdat veel tools geen adequate besturingselementen bieden.
De gedocumenteerde antwoordverwerking van TrueForge schrijft een te groot resultaat naar een sandbox-bestand en plaatst een korte preview plus bestandspad in de context. De agent behoudt toegang zonder te worden gedwongen zich op de gehele payload te richten.
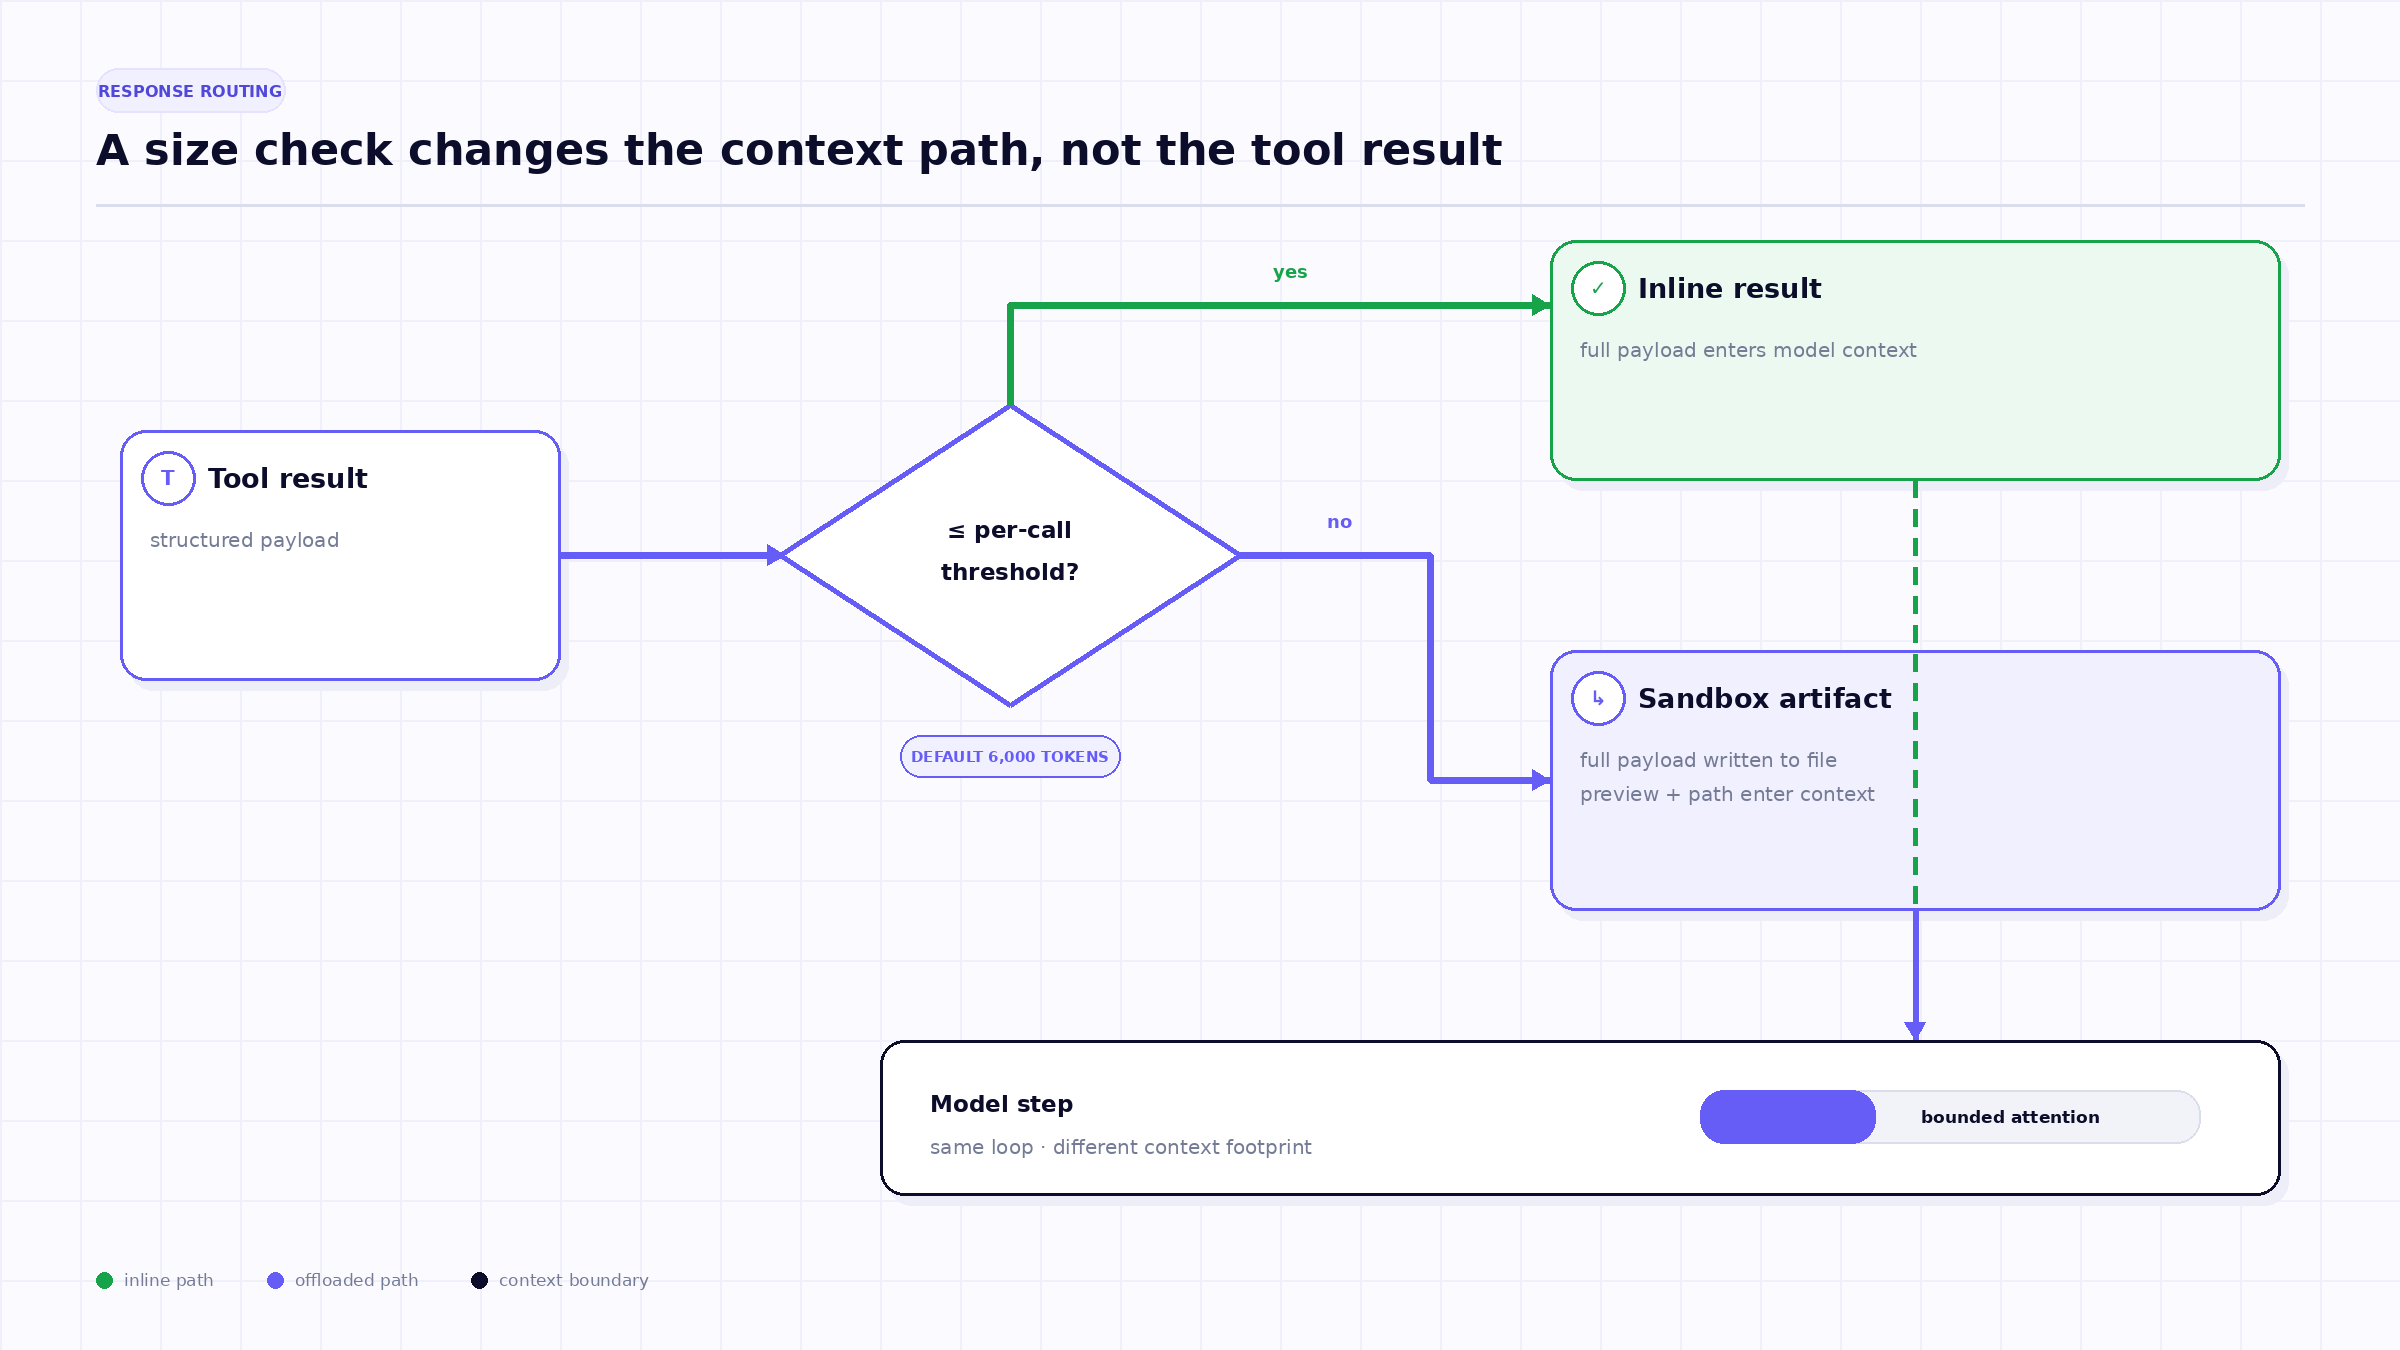
De eerste regel geldt voor één toolresultaat. Als het geschatte antwoord de geconfigureerde drempelwaarde per aanroep overschrijdt, schrijft TrueForge het volledige resultaat naar de sandbox. De context ontvangt een melding, bestandspad en een begrensde preview. De huidige standaarddrempel is 6.000 tokens; de huidige standaardpreview bevat de eerste en laatste 100 tekens.
De preview is navigatie, geen samenvatting. Grenstekens kunnen het objecttype, sleutels op het hoogste niveau, het totale aantal of de uiteindelijke metadata onthullen, maar ze kunnen de exacte records weglaten die de taak nodig heeft. Een verstandige volgende stap is om de structuur te inspecteren, naar een doel te zoeken of een kleine parser uit te voeren — niet om de volledige inhoud af te leiden uit de preview.
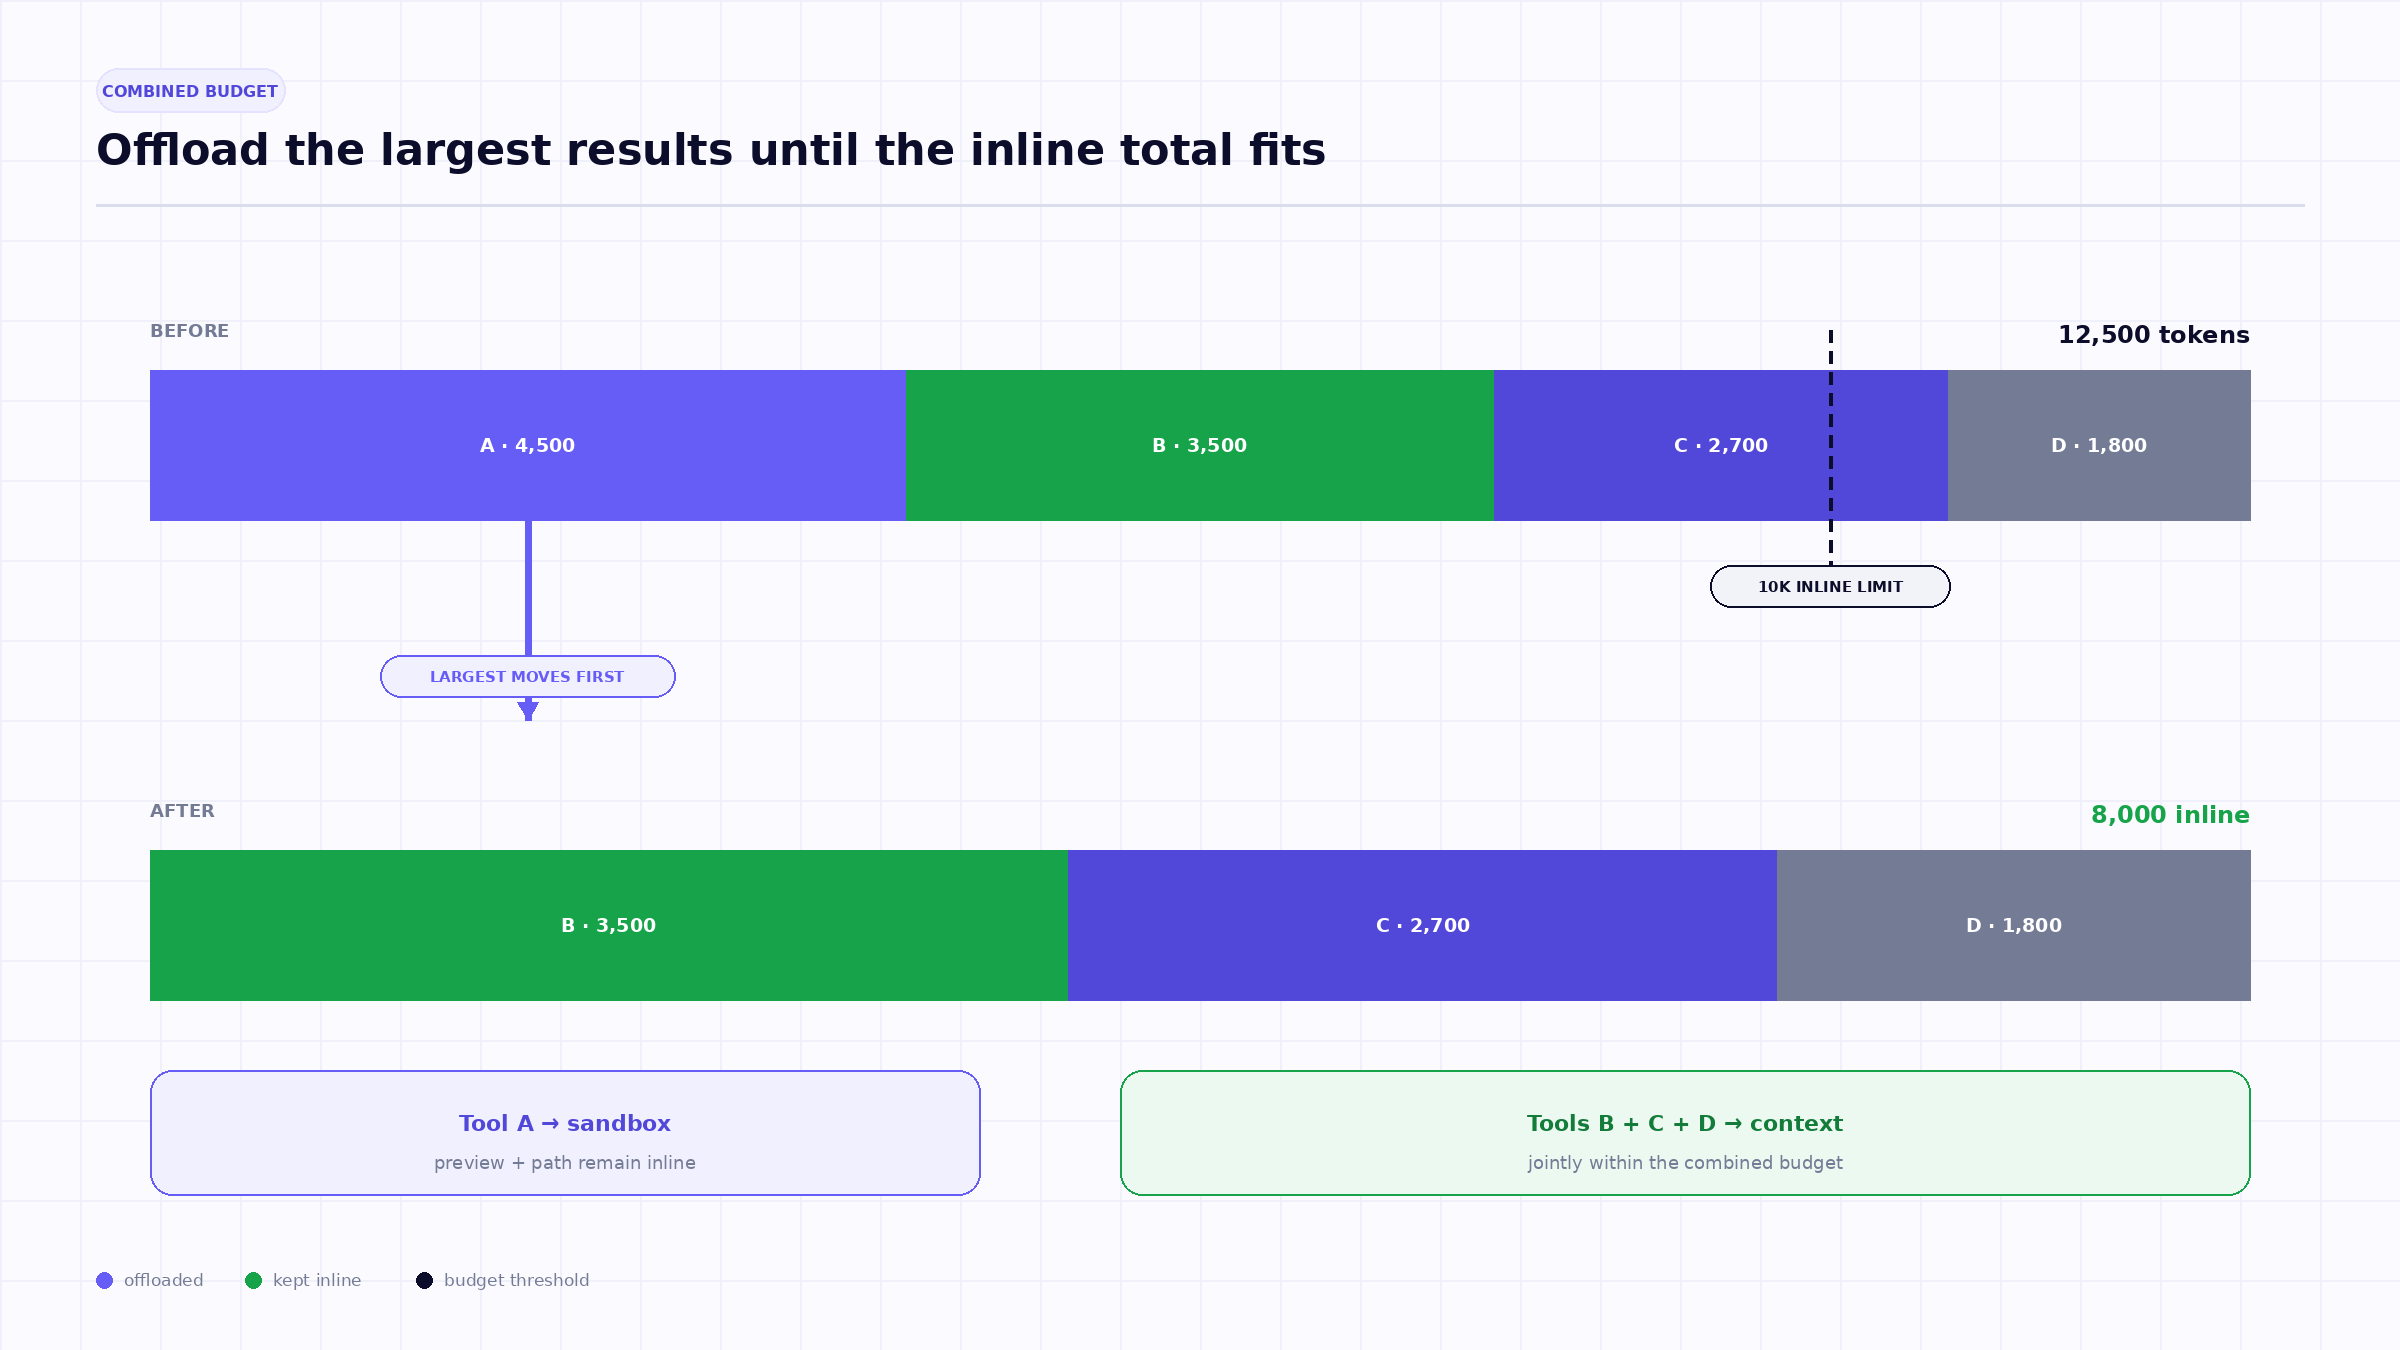
Limieten per aanroep zijn onvoldoende wanneer een agent tools gelijktijdig uitvoert. Vier resultaten van 4.000 tokens slagen elk voor een controle van 6.000 tokens, maar samen voegen ze 16.000 tokens toe aan één stap van het model.
TrueForge documenteert daarom een tweede drempelwaarde voor de gecombineerde tool-call-inhoud die samen wordt geretourneerd. De huidige standaardwaarde is 10.000 tokens. Wanneer de som die limiet overschrijdt, laadt de harness de antwoorden één voor één uit (offloading), beginnend met de grootste, totdat de resterende inline inhoud onder de drempelwaarde daalt.
Dit beleid waarbij de grootste eerst wordt verwerkt, behoudt meer kleine resultaten inline, terwijl de grootste bijdragers snel worden verwijderd. Het is een context-heuristiek, geen beoordeling van relevantie. Het grootste antwoord zou het belangrijkste bewijs kunnen bevatten; het bestandspad zorgt ervoor dat het opvraagbaar blijft.
De volledige payload heeft een duurzaam uitvoeringsoppervlak nodig dat de agent kan inspecteren. De functie van TrueForge is standaard ingeschakeld, maar vereist dat de sandbox van de agent is ingeschakeld, omdat het uitgeladen resultaat als een sandbox-bestand wordt opgeslagen.
De sandbox is niet de plek waar de gehele agent-loop draait. TrueForge-documentatie beschrijft het als een geïsoleerde omgeving die wordt gebruikt voor code, bestanden en shell-werk, ingericht wanneer dat nodig is. Het model ontvangt een pad en kan sandbox-operaties gebruiken om het bestand te inspecteren of te transformeren.
Dit ontwerp heeft een nuttige scheiding: de harness beheert de run en credentials, terwijl de sandbox de verwerking van de payload afhandelt. Het roept ook een vraag op over de levenscyclus. Als de taak, de gebruiker of het bewaarbeleid gevoelig is, moeten teams weten hoe lang het bestand blijft bestaan, wie het kan downloaden, welke telemetrie ernaar verwijst en hoe verwijdering doorwerkt.
Zodra een antwoord is uitgeladen, moet de agent het doelgericht vernauwen:
De documentatie van TrueForge koppelt dit patroon expliciet aan Code Mode. Een script kan het uitgeladen bestand lezen, een resultaat berekenen en alleen afgedrukte regels retourneren aan de modelcontext.
Offloading is aantrekkelijk omdat het de originele payload behoudt. Het is niet automatisch doorzoekbaar, gestandaardiseerd of geverifieerd. Voor herhaaldelijk enterprise-gebruik kan een speciaal gebouwde datapijplijn beter zijn dan aan elke run te vragen om dezelfde ruwe export te analyseren.
Drempelwaarden zijn afhankelijk van tokenschatting. Het exacte aantal factureerbare tokens kan variëren per tokenizer van de provider, berichtopmaak en serialisatie. De functie heeft een voldoende betrouwbaar signaal voor de omvang nodig om de context te beschermen, geen perfecte aansluiting op de factuur.
Operationele monitoring moet onderscheid maken tussen de omvang van de originele tool-payload, de omvang van de inline preview, de tokens die daadwerkelijk naar het model zijn verzonden en het gerapporteerde gebruik van de modelprovider. Deze metingen beantwoorden verschillende vragen.
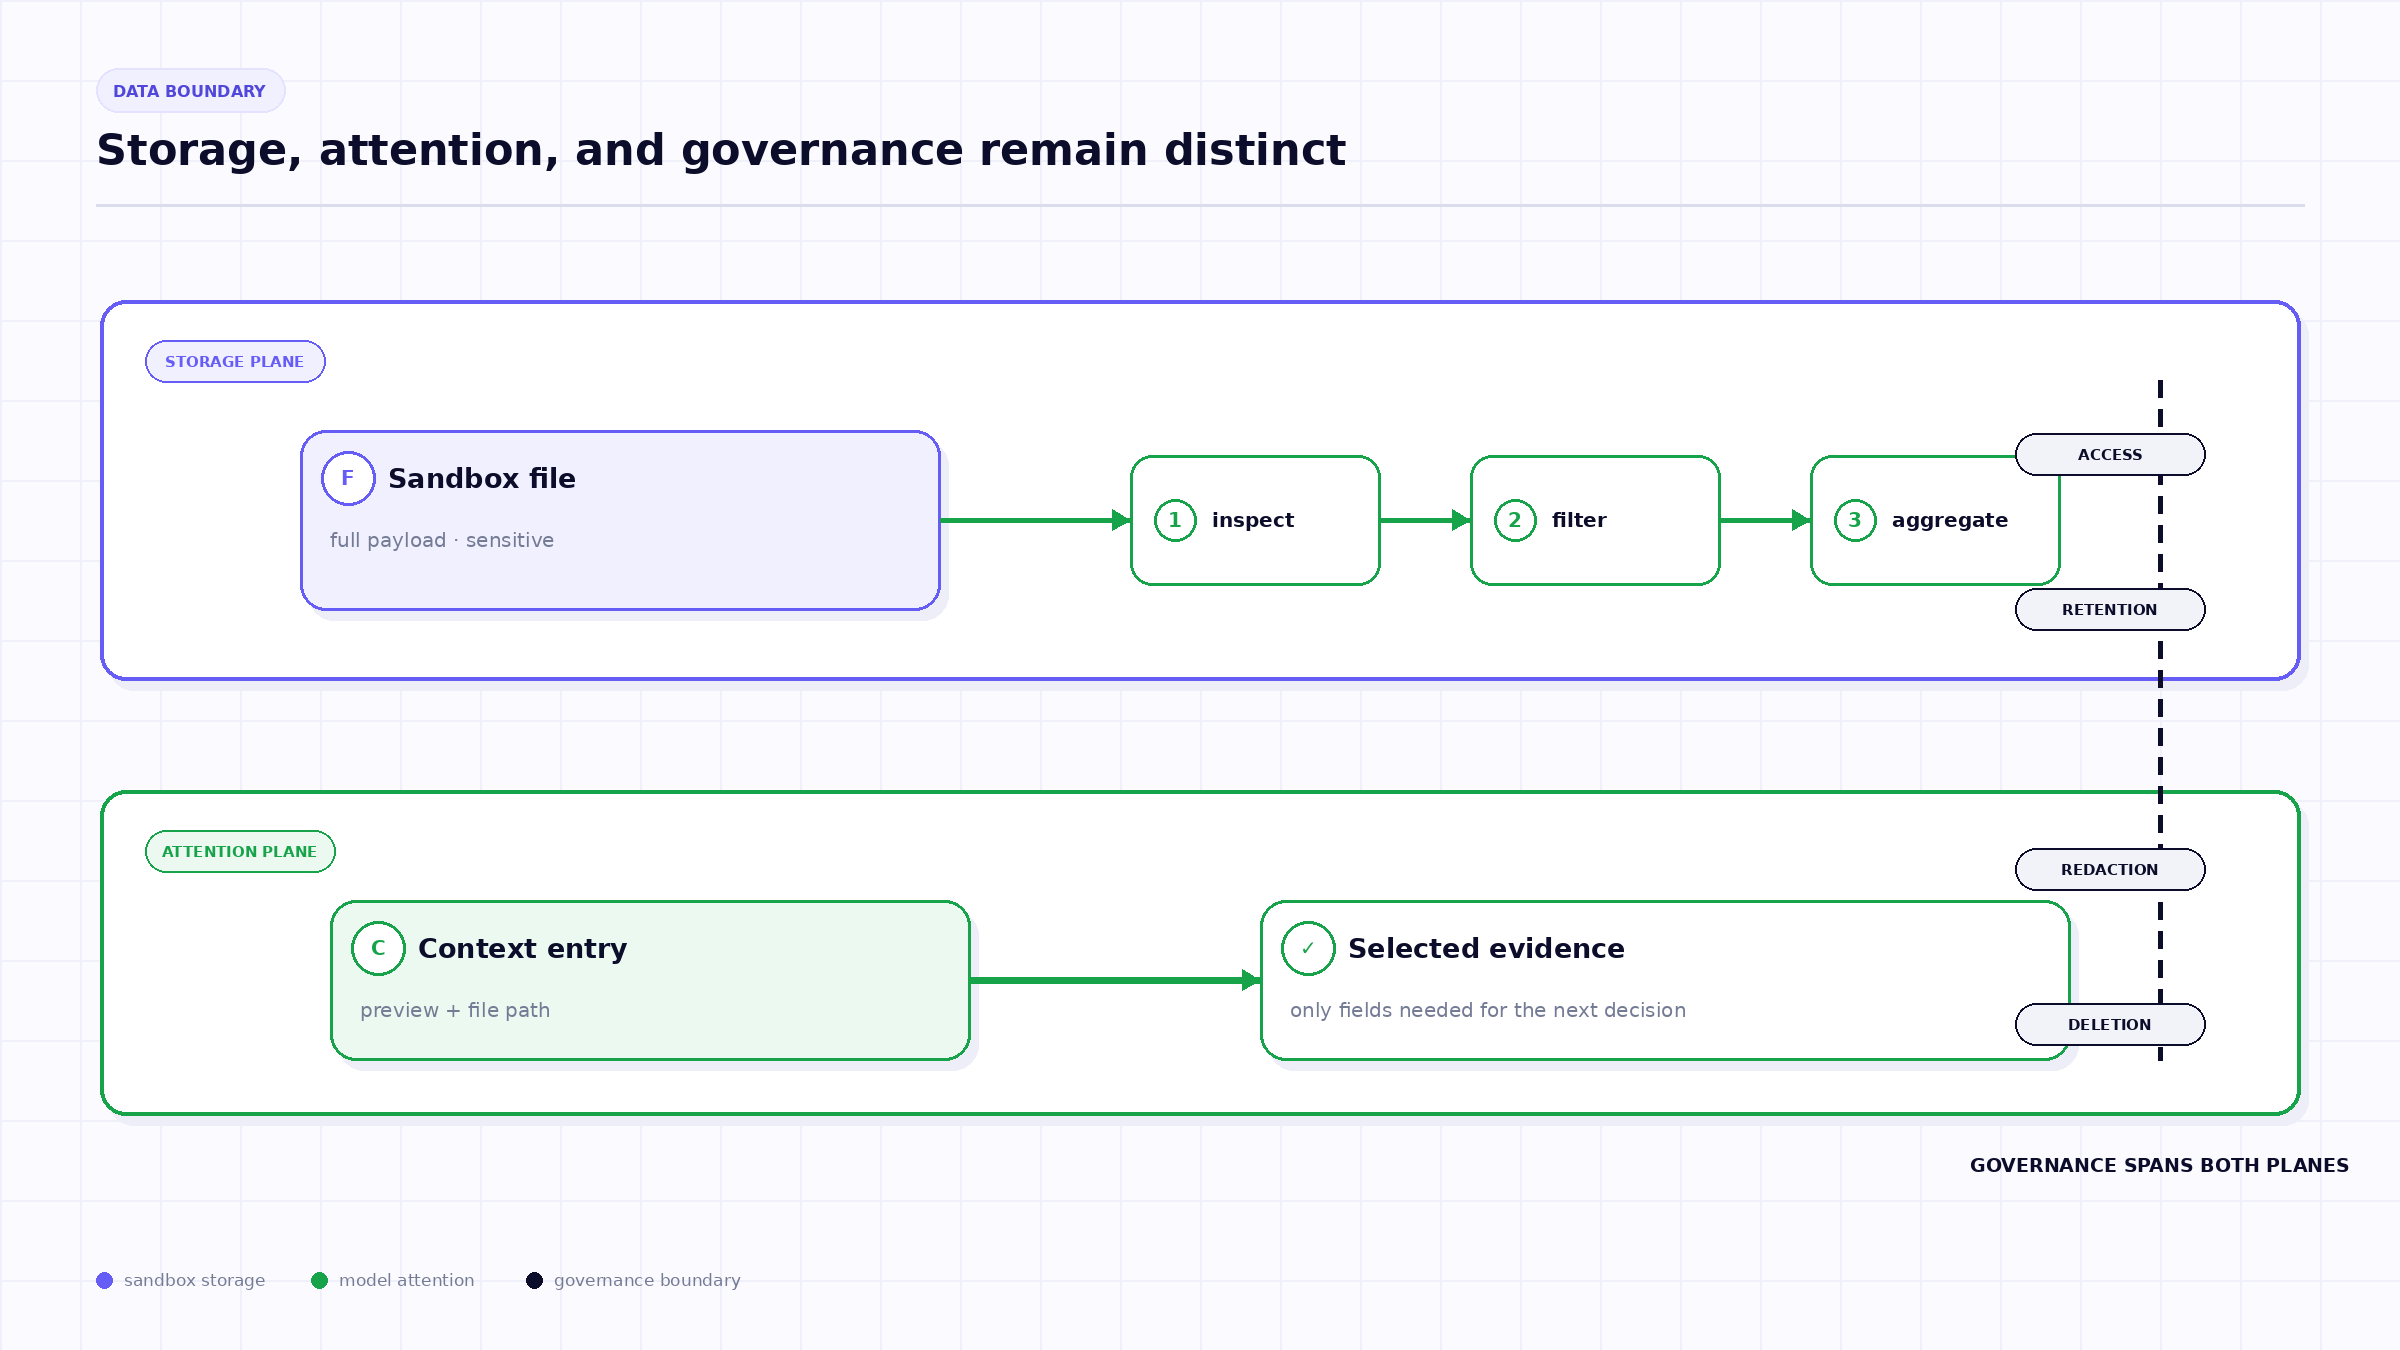
Offloading kan de hoeveelheid gevoelige tool-output die aan een modelstap wordt blootgesteld verminderen. Het wist de gegevens niet. Het bestand bestaat nu in een sandbox en er kan naar worden verwezen door gebeurtenissen, logs of downloadbare artefacten.
Pas dezelfde classificatie toe op het sandbox-bestand als op het oorspronkelijke tool-antwoord. Beperk wie er toegang toe heeft, voorkom dat onnodige geheimen terug in de context worden afgedrukt, definieer retentie en verwijdering, en zorg ervoor dat geëxporteerde telemetrie niet onverwachts de volledige payload vastlegt.
Geen enkele afzonderlijke laag stelt datagovernance op zichzelf vast. De waarde is dat het payloadvolume kan worden beheerd zonder de beheerde tool- en modelgrenzen te omzeilen.
Begin met de gedocumenteerde standaardinstellingen en test vervolgens representatieve payload-verdelingen. Een te hoge drempelwaarde zorgt voor contextpieken. Een te lage drempelwaarde leidt tot onnodige bestands-I/O en extra inspectiestappen. De juiste instelling hangt af van de contextlengte van het model, de typische vorm van het resultaat, de sandbox-latentie en de waarde van het rechtstreeks zichtbaar houden van kleine resultaten.
Het beleid voor drempelwaarden kan ook variëren per agent-rol. Een specifieke incident-responder kan er baat bij hebben om bescheiden diagnostische resultaten inline te houden voor directe synthese, terwijl een portfolio-analyse-agent die routinematig duizenden records verwerkt mogelijk agressief offloadt. Houd de configuratie uitlegbaar en observeerbaar in plaats van uitsluitend te tunen voor het kleinste aantal tokens.
De huidige TrueForge-documentatie zegt van wel, mits de sandbox van de agent is ingeschakeld.
De documentatie vermeldt 6.000 tokens per antwoord, 10.000 gecombineerd over parallelle antwoorden, en een preview van de eerste en laatste 100 tekens.
Als hun gecombineerde inhoud de totale drempelwaarde overschrijdt, laadt TrueForge de grootste antwoorden eerst uit totdat het inline totaal onder de limiet ligt.
Nee. Het resultaat wordt opgeslagen in een sandbox-bestand dat de agent kan inspecteren, doorzoeken of parseren.
Niet uit zichzelf. Het verandert het verwerkingspad. Het bestand vereist nog steeds een beleid voor toegang, retentie, redactie en verwijdering.
Redactionele verklaring: Het gedrag van het product is beschreven op basis van openbare TrueForge- en TrueFoundry-documentatie die beschikbaar was op 10 september 2026. Voorbeelden dienen ter illustratie en moeten worden aangepast aan de vereisten van elke toepassing op het gebied van autorisatie, privacy, betrouwbaarheid en compliance.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















