


August 26, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
In de huidige datagedreven wereld is het doorzoeken van enorme hoeveelheden data om vergelijkbare items te vinden een fundamentele bewerking die in diverse toepassingen wordt gebruikt, van databases tot zoekmachines en aanbevelingssystemen. Dit proces, bekend als similarity search (gelijksoortigheidszoeken), omvat het identificeren van items die op elkaar lijken op basis van bepaalde criteria.
Hoewel traditionele databasezoekopdrachten op basis van vaste numerieke criteria (zoals het vinden van werknemers binnen een specifieke salarisklasse) eenvoudig zijn, pakt similarity search complexere zoekopdrachten aan. Een gebruiker kan bijvoorbeeld zoeken naar "schoenen", "zwarte schoenen" of een specifiek model zoals "Nike AF-1 LV8". Deze zoekopdrachten kunnen vaag en gevarieerd zijn, wat vereist dat het systeem concepten zoals verschillende typen schoenen begrijpt en ertussen verschilt.
Similarity search is van cruciaal belang in vele vakgebieden, waaronder:
De belangrijkste uitdaging bij similarity search is het omgaan met grootschalige data en tegelijkertijd het nauwkeurig begrijpen van de diepere conceptuele betekenissen van de doorzochte items. Traditionele databases, die vertrouwen op symbolische objectrepresentaties, schieten in dergelijke scenario's tekort. In plaats daarvan hebben we geavanceerdere technieken nodig die semantische representaties van data kunnen verwerken en zoekopdrachten efficiënt kunnen uitvoeren, zelfs op grote schaal.
Door gebruik te maken van similarity search kunnen we complexe, abstracte zoekopdrachten omzetten in actiegerichte inzichten, wat het een krachtige tool maakt in diverse domeinen. In de volgende secties zullen we dieper ingaan op hoe similarity search werkt, met de focus op de rol van vectorrepresentaties, afstandsmetrieken en verschillende zoekalgoritmen.

In machine learning representeren we objecten en concepten uit de echte wereld als vectoren, wat sets van continue getallen zijn die bekendstaan als embeddings. Deze aanpak stelt ons in staat om de diepere semantische betekenissen van items vast te leggen. Wanneer objecten zoals afbeeldingen of tekst worden omgezet in vector embeddings, kan hun gelijksoortigheid worden beoordeeld door de afstand tussen deze vectoren in een hoogdimensionale ruimte te meten.
In een vectorruimte zullen vergelijkbare afbeeldingen bijvoorbeeld vectoren hebben die dicht bij elkaar liggen, terwijl niet-vergelijkbare afbeeldingen verder van elkaar verwijderd zijn. Dit maakt het mogelijk om wiskundige bewerkingen uit te voeren om vergelijkbare items efficiënt te vinden en te vergelijken.

Er worden verschillende modellen gebruikt om deze vector embeddings te genereren:
Deze modellen zijn getraind op grote datasets en taken, waardoor ze embeddings kunnen produceren die de semantische inhoud van de items effectief representeren.
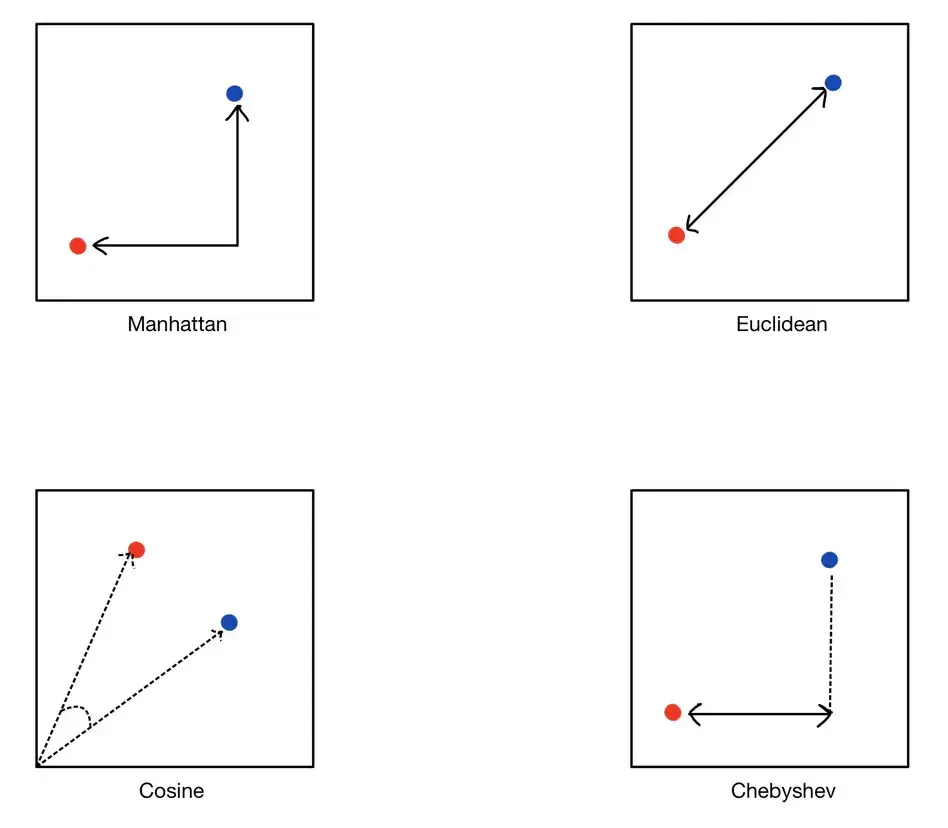
Om te bepalen hoe vergelijkbaar twee vector embeddings zijn, gebruiken we afstandsmetrieken. Deze metrieken berekenen de "afstand" tussen vectoren in de vectorruimte, waarbij kleinere afstanden wijzen op een grotere gelijksoortigheid.
Euclidische afstand meet de rechte-lijn-afstand tussen twee punten in een hoogdimensionale ruimte. Het is de meest intuïtieve manier om afstand te meten, vergelijkbaar met de geometrische afstand die u met een liniaal zou meten. Het is nuttig wanneer de data dicht is en het concept van fysieke afstand relevant is.
Formule:

Ook bekend als L1-afstand; Manhattan distance telt de absolute verschillen van hun coördinaten bij elkaar op. Deze metriek is geschikt voor rasterachtige datastructuren en kan worden gevulgariseerd als de totale "stadsblok"-afstand die men tussen punten in een raster zou afleggen.
Formule:

Cosine similarity meet de cosinus van de hoek tussen twee vectoren, waarbij de nadruk ligt op hun richting in plaats van hun grootte. Dit is met name nuttig voor tekstdata, waar de grootte van de vector (woordfrequentie) kan variëren, maar de richting (woordgebruikspatroon) belangrijker is.

Chebyshev distance meet de maximale afstand tussen de coördinaten van een paar vectoren. Het wordt vaak gebruikt in schaakachtige rasterscenario's waar u in elke richting kunt bewegen, inclusief diagonaal.

Het kiezen van de juiste afstandsmetriek hangt af van de specifieke kenmerken en vereisten van de toepassing. Hier zijn enkele richtlijnen voor het selecteren van de juiste metriek:
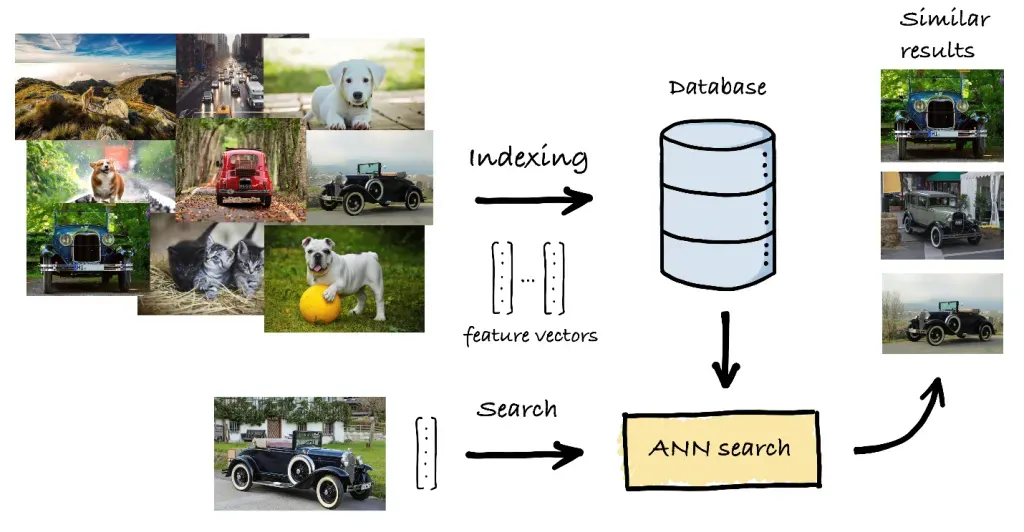
K-Nearest Neighbors (k-NN) is een populair algoritme dat wordt gebruikt om de dichtstbijzijnde vectoren bij een gegeven queryvector te vinden. Hier is hoe het werkt en de voor- en nadelen ervan:

Om de inefficiëntie van k-NN bij grote datasets aan te pakken, bieden Approximate Nearest Neighbor (ANN)-methoden een sneller, hoewel minder nauwkeurig, alternatief. ANN-algoritmen zijn erop gericht een "goede gok" van de dichtstbijzijnde buren te vinden, waarbij een deel van de nauwkeurigheid wordt ingeleverd voor snelheid.
Bij het in de praktijk implementeren van similarity search kunnen verschillende bibliotheken en frameworks helpen:
Similarity search heeft een breed scala aan toepassingen in verschillende gebieden, waarbij gebruik wordt gemaakt van de mogelijkheid om snel en nauwkeurig vergelijkbare items te vinden en te vergelijken. Hier zijn enkele belangrijke toepassingen:
Aanbevelingssystemen gebruiken similarity search om producten, content of diensten voor te stellen op basis van gebruikersvoorkeuren en -gedrag.
Similarity search is van cruciaal belang voor het ophalen van visueel vergelijkbare afbeeldingen of video's uit grote databases.
In NLP helpt similarity search bij verschillende tekstgebaseerde toepassingen door semantisch vergelijkbare documenten of zinnen te vinden.
Het detecteren van frauduleuze activiteiten door patronen en anomalieën te vinden die afwijken van normaal gedrag.
Similarity search helpt bij medische diagnoses en genetisch onderzoek door patiëntgegevens en genetische sequenties te vergelijken.
Een van de primaire uitdagingen bij similarity search is de aard van zoekopdrachten van gebruikers. Zoekopdrachten kunnen variëren van zeer generieke termen zoals "schoenen" tot zeer specifieke items zoals "Nike AF-1 LV8". Het systeem moet deze nuances kunnen onderscheiden en begrijpen hoe verschillende items zich tot elkaar verhouden. Dit vereist een diep begrip van de semantische betekenis achter de zoekopdrachten, wat verder gaat dan eenvoudige trefwoord-matching.
Een andere belangrijke uitdaging is schaalbaarheid. In praktijktoepassingen hebben we vaak te maken met massieve datasets die miljarden items kunnen bevatten. Om efficiënt door zulke grote hoeveelheden data te zoeken, zijn geavanceerde technieken en krachtige rekenbronnen nodig. Traditionele databasesystemen, die ontworpen zijn voor exacte overeenkomsten en symbolische representaties, hebben moeite om in deze scenario's goed te presteren.
Similarity search, ook wel vector search genoemd, speelt een cruciale rol in verschillende moderne toepassingen. Door gebruik te maken van vector embeddings en geavanceerde afstandsmetrieken stelt similarity search ons in staat om items te vinden en te vergelijken op basis van hun semantische betekenis. Hier zijn de belangrijkste inzichten:
Om de kracht van similarity search echt te benutten, is het essentieel om de onderliggende principes te begrijpen en de juiste tools en technieken te kiezen voor uw specifieke behoeften. Of u nu een aanbevelingsengine, een op content gebaseerd retrievalsysteem of een fraudedetectiemechanisme bouwt, similarity search kan de nauwkeurigheid en efficiëntie van uw oplossingen aanzienlijk verbeteren.
Similarity search is een techniek om items te vinden die op elkaar lijken in grote datasets. Het vertrouwt op vector embeddings die de conceptuele betekenis van data vastleggen, vaak met behulp van vectorrepresentaties en afstandsmetrieken. Dit proces is van cruciaal belang voor toepassingen zoals productaanbevelingen en tekstmatching, waardoor systemen relevante informatie efficiënt en nauwkeurig kunnen identificeren.
Om een similarity search uit te voeren, worden objecten zoals tekst of afbeeldingen eerst omgezet in vector embeddings met behulp van gespecialiseerde modellen. Vervolgens meten afstandsmetrieken — zoals Euclidische afstand of Cosine Distance — de "afstand" tussen deze vectoren in een hoogdimensionale ruimte. Kleinere afstanden duiden op een hogere gelijksoortigheid. Als alternatief scoren gelijksoortigheidsmetrieken zoals Cosine Similarity de nabijheid rechtstreeks, waarbij een hogere score (dichter bij 1) betekent dat ze meer vergelijkbaar zijn.
Een uitstekend voorbeeld van similarity search is een e-commerceplatform dat producten aanbeveelt die vergelijkbaar zijn met wat een gebruiker heeft bekeken of gekocht. Dit helpt kopers moeiteloos relevante items te ontdekken. Beeldzoeken, het vinden van visueel vergelijkbare afbeeldingen uit grote databases, is een andere belangrijke toepassing die gebruikmaakt van similarity search-technologie.
In door LLM aangedreven systemen — met name RAG (Retrieval-Augmented Generation)-pipelines — werkt similarity search samen met het model door tekst om te zetten in vector embeddings die de semantische betekenis vastleggen. Een retrieval-laag doorzoekt deze vectoren om de inhoud te vinden die het meest lijkt op een query en geeft de resultaten vervolgens door aan het LLM door de afstand tussen deze vectoren te meten. Het is van cruciaal belang voor het ophalen van relevante informatie en het genereren van contextbewuste antwoorden, wat het begrip en het nut van het model voor gebruikers aanzienlijk verbetert.
Similarity search is van cruciaal belang in vele toepassingen. Het verbetert productaanbevelingen in e-commerce, vergemakkelijkt het zoeken naar afbeeldingen en video's, en verbetert natural language processing voor tekstmatching. In de gezondheidszorg helpt het bij het identificeren van vergelijkbare medische casussen, waardoor complexe data wordt omgezet in actiegerichte inzichten in verschillende sectoren.
Semantic search (semantisch zoeken) vertrouwt op similarity search om items te vinden op basis van hun betekenis, niet alleen op basis van trefwoorden. Het gebruikt vector embeddings om data semantisch te representeren. Waar similarity search de techniek is om deze vectoren te vergelijken, is semantic search de toepassing die hier gebruik van maakt voor een dieper contextueel begrip.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox




















