



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Exact-match caching is dertig jaar lang de juiste standaard geweest. Voor LLMs is het de verkeerde standaard, omdat tekst de verschijningsvorm van een intentie is, niet de intentie zelf. De taak van een semantic cache is het cachen van hetgeen eronder ligt.
Traditionele API-caching is een hashtabel. De request wordt gehasht, de response wordt gekoppeld aan de hash, en de volgende byte-identieke request retourneert de gecachete waarde. Dit model is correct voor deterministische API's, omdat de hash alles omvat wat van belang is voor een request. Er zit geen informatie in de call die zich niet in de bytes bevindt.
LLM-workloads doorbreken deze aanname aan de oppervlakte. Drie gebruikers in een klantenservice-flow vragen hetzelfde op drie verschillende manieren:
gebruikersverkeer · venster van 60 seconden
-- Gebruiker A: "Hoe kan ik mijn wachtwoord opnieuw instellen?"
-- Gebruiker B: "Ik ben mijn wachtwoord vergeten — wat moet ik doen?"
-- Gebruiker C: "Waar vind ik de pagina voor wachtwoord herstel?"
Voor een SHA-256-cache zijn dit drie verschillende keys, drie misses en drie volledige calls naar de provider. Voor het model is de intentie identiek en zou de response identiek moeten zijn. Een cache die ruwe tekst hasht is geen verkeerde cache; het is een cache voor de verkeerde betekenislaag. Tekst is een drager van intentie met informatieverlies — dezelfde intentie kent vele vormen — en exact-match caching gebruikt de vorm als key in plaats van de inhoud.
Het verschil is groot genoeg om rekening mee te houden. Een cache die alleen hits genereert op byte-gelijke requests vangt slechts een fractie op van de calls die een cache op basis van intentie zou vangen. Het dichten van dat gat is waar semantic caching voor bedoeld is.
Een semantic cache van enterprise-kwaliteit kan niet simpelweg embedden en opzoeken. Het moet policy-grenzen afdwingen (verschillende system prompts mogen niet botsen), tenant-isolatie respecteren en voorkomen dat "mijn linkerarm doet pijn" wordt verward met "mijn rechterarm doet pijn". De TrueFoundry gateway voert een pipeline uit van vier fasen die al deze vier vereisten samenbrengt in één kritiek pad.
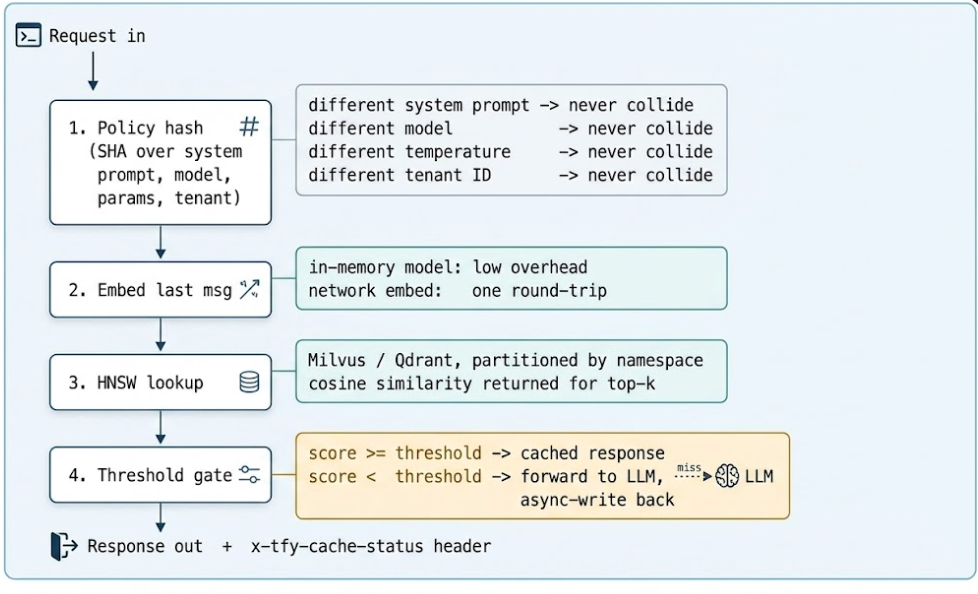
Een subtiel detail: alleen het laatste bericht wordt semantisch vergeleken. Al het andere — modelnaam, temperature, eerdere berichten, system prompt, tenant ID — wordt exact gehasht. Als een van deze niet overeenkomt, behandelt de cache de requests als verschillend, zelfs als de meest recente regel van de gebruiker woord voor woord identiek is. Dat is de juiste standaard. Een vooraf geladen conversatiecontext verandert de betekenis meer dan de meeste engineers verwachten, en u wilt dat de cache de voorkeur geeft aan het niet samenvoegen van deze requests.
Embedding vectors bevinden zich in een hoogdimensionale ruimte — 384 dimensies voor MiniLM, 768 voor BGE-base, 1536 voor text-embedding-3-small. In die geometrie wordt de Euclidean distance gedomineerd door vectorgrootte, wat voornamelijk ruis is; wat de semantische betekenis draagt, is de richting. Cosine similarity normaliseert de grootte door de cosinus van de hoek tussen twee vectors te berekenen — het is onafhankelijk van schaal, dus twee vectors die in dezelfde richting wijzen scoren 1.0, ongeacht hun lengte.
Elke moderne semantic cache gebruikt cosine. De enige keer dat u zou kiezen voor Euclidean is wanneer uw embedding model al unit-genormaliseerde vectors produceert, in welk geval de twee metrieken op een constante na gelijk zijn en cosine nog steeds eenvoudiger te begrijpen is. Er is geen praktische workload waarin Euclidean het juiste antwoord is.
Naïeve nearest-neighbor search is O(N) — elke query wordt vergeleken met elke gecachete vector. Bij een miljoen entries is de benodigde rekenkracht voor vergelijkingen niet haalbaar. HNSW (Hierarchical Navigable Small World) bouwt een gelaagde grafiek waarin elke node verbindt met een klein aantal nabijgelegen buren, met dunnere verbindingen op hogere lagen. Een query begint op de bovenste laag, beweegt naar de dichtstbijzijnde match, daalt een laag af en herhaalt dit proces. De zoekopdracht bezoekt O(log N) nodes — dit is benaderend, maar levert typisch 95–99% recall op vergeleken met een exacte zoekopdracht, tegen een fractie van de kosten. Milvus en Qdrant worden beide geleverd met HNSW; TrueFoundry gebruikt de variant waarvoor de deployment is geconfigureerd.
Semantic caching ruilt rekenkracht in voor lagere latency en providerkosten, waardoor het embedding model de meest bepalende keuze in het systeem is. Er zijn twee serieuze opties.
Managed models — zoals OpenAI's text-embedding-3-small, Cohere en Voyage — bieden direct een sterk domeinoverschrijdend semantisch begrip. De prijs hiervoor is een netwerk-round-trip bij elke request, wat direct ten koste gaat van de latency-winst van de cache. Op TrueFoundry SaaS is text-embedding-3-small (1536 dimensies) de standaard en niet door de gebruiker te configureren; dit is een bewuste keuze voor de managed tier — een bewezen baseline die goedkoop genoeg is om bij elke call af te schrijven.
In-memory alternatieven zoals BGE-micro (384 dim) of all-MiniLM-L6-v2 (384 dim) draaien binnen het gateway-proces, elimineren de netwerkafhankelijkheid volledig en halen de embedding-round-trip uit het request-pad. Op de on-premise tier is het embedding model configureerbaar via het dashboard (Controls → Settings → Semantic Cache); de keuze geldt voor de gehele gateway. Voor interne workloads — zoals coding assistants, technische documentatie en klantenservice-flows — is het fine-tunen van een klein lokaal model op domeinspecifieke terminologie vaak de investering met de hoogste ROI op de gehele stack. “k8s” en “Kubernetes” moeten tot vrijwel dezelfde vector leiden. Een algemeen model ziet ze als gerelateerd; een gefine-tuned model ziet ze als synoniemen. De hit rate verandert dienovereenkomstig.
Er is een praktische observatie over dimensies. Hoger-dimensionale embeddings (1536) bevatten meer semantische informatie, maar zijn duurder om te indexeren en te doorzoeken; HNSW met 1536 dim gebruikt ongeveer 4× het geheugen en kost 2× de zoektijd van 384 dim. Voor de meeste cache-workloads is de marginale recall-winst van 1536 ten opzichte van een gefine-tuned 384-dim model zo klein dat de operationele besparingen doorslaggevend zijn. Begin op 384 en schaal alleen op als de gemeten precisie en recall bij echt verkeer dit rechtvaardigen.
Tabel 1 — Het embedding model is de knop die bepaalt of semantic caching winst op de latency oplevert of niet. In productie is het in-memory pad de optie die zichzelf terugverdiend.
De similarity threshold is de schuifknop tussen besparingen en risico. Verlaag deze, en de hit rate gaat omhoog en de kosten omlaag — maar daarmee stijgt ook de kans op een valse hit, wat kan leiden tot verouderde of verkeerde antwoorden. De instelling bevindt zich in de request via x-tfy-cache-config:
HTTP · request header
Het aanbevolen startpunt van TrueFoundry is 0.9, met een bereik dat afhangt van de tolerantie voor onjuiste cache-hits.
Tabel 2 — Threshold-bereik. Er is geen universele “correcte” waarde; de juiste threshold sluit aan bij de kosten van een valse hit binnen uw domein.
Een gedachte-experiment rond medische triage maakt het gevaar duidelijk. “Mijn linkerarm doet pijn” en “Mijn rechterarm doet pijn” kunnen een score van 0.91 behalen in een algemene embedding-ruimte. Bij een threshold van 0.90 retourneert de cache hetzelfde advies voor twee fysiek tegengestelde aandoeningen. Voor een algemene FAQ-bot kan 0.88 volkomen veilig zijn. Voor triage is het een kwalijke fout. De threshold is geen globale hyper-parameter; het is een codering per workload van de impact van een verkeerd antwoord.
Het kiezen van een threshold is het kiezen van een punt op een precision/recall-curve die specifiek is voor uw verkeer. Hieronder ziet u hoe die curve er doorgaans uitziet voor een klantenservice-workload — die van u zal naar links of rechts verschoven zijn, maar de vorm blijft gelijk:
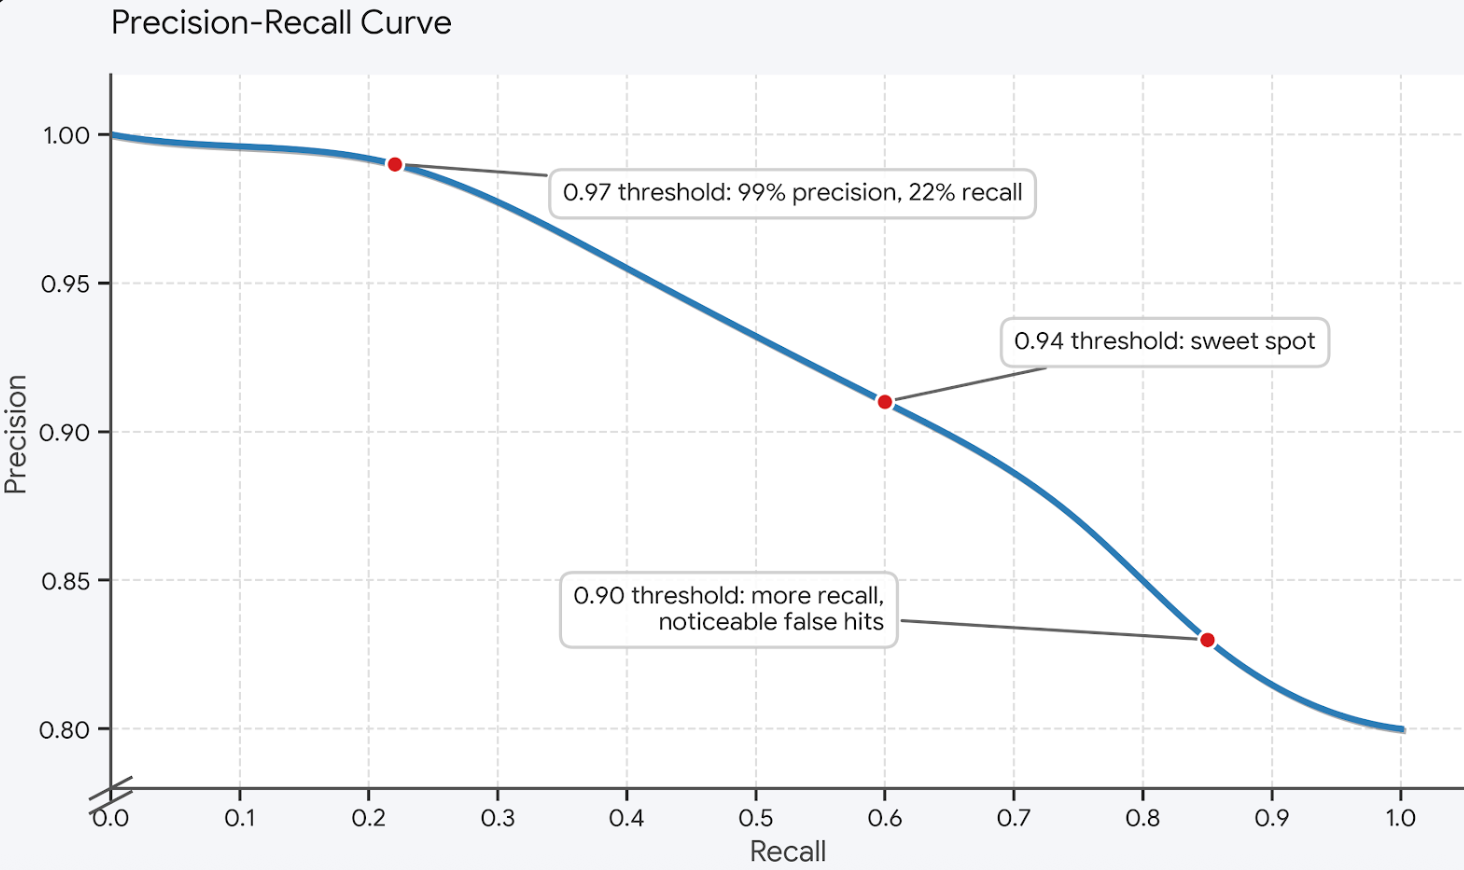
De juiste methode voor het bepalen van een punt is shadow mode. Gedurende een instelbare periode — meestal een week — berekent de cache de overeenkomsten en logt wat er bij elke threshold gematcht zou zijn, zonder daadwerkelijk gecachete antwoorden te retourneren. Engineers bekijken de logbestanden, zetten hun versie van de bovenstaande curve af tegen echt verkeer en kiezen een threshold die valse hits terugbrengt tot een niveau dat acceptabel is. De threshold is geen globale constante; het is een instelknop per workload, en de data voor het afstellen moet afkomstig zijn van productieverkeer, niet van synthetische queries.
Bij elke response retourneert de gateway drie headers die deze cyclus inzichtelijk maken: x-tfy-cache-status (hit / miss / error), x-tfy-cache-similarity-score (de cosine-score bij hits) en x-tfy-cached-trace-id (de trace-ID van de oorspronkelijke request die de entry heeft gegenereerd). De derde header is essentieel — hiermee kunt u elk gecacheted antwoord herleiden naar de conversatie die het heeft geproduceerd, wat de enige manier is om foute matches te analyseren.
Semantic similarity wordt risicovol wanneer de onderliggende feiten veranderd zijn. “Wat is de huidige rentevoet?” gisteren en vandaag zijn semantisch identiek, maar feitelijk verschillend. De cache zal de waarde van vorige maand retourneren met een similarity-score van 1.0.
Workloads vereisen specifieke TTL's. Statische documentatie-assistants kunnen een ruime TTL van meerdere dagen gebruiken omdat de informatie vaststaat en alleen veranderd bij nieuwe releases. RAG-toepassingen gebruiken invalidatie op basis van een document-hash: wanneer het bron-document wijzigt, worden alle afgeleide cache-entries automatisch gewist. Tijdsgevoelige feiten (zoals tarieven, prijzen en schema's) krijgen korte, strikte TTL's en worden niet over dag-grenzen heen bewaard. Voor deze gevallen is semantic caching vaak niet het juiste middel en kunt u beter terugvallen op exact-match caching of helemaal geen caching gebruiken.
We moeten realistisch zijn over de beperkingen van semantic caching. Alles wat moet veranderen naarmate de wereld verandert, is ongeschikt voor caching op welke threshold dan ook. De juiste vuistregel: als een mens zou opmerken dat het antwoord verouderd is, is de cache dat ook.
Er is een specifiek operationeel risico om rekening mee te houden: de cache stampede. Als een veelgevraagde query verloopt en er komen duizend identieke requests binnen in dezelfde seconde, zal een eenvoudige cache al deze duizend requests doorlaten naar de LLM, waarna ze alle duizend het resultaat proberen terug te schrijven. De TrueFoundry gateway gebruikt single-flight logica — de eerste request die mist krijgt een vergrendeling per key; opeenvolgende identieke requests tijdens de LLM-call wachten op die ene response en hergebruiken deze. Het terugschrijven gebeurt asynchroon (de response wordt direct aan de client geretourneerd, de vector wordt op de achtergrond naar Milvus/Qdrant geschreven), waardoor cache-writes de latency op het request-pad nooit beïnvloeden.
In elke B2B SaaS-environment is het een groot probleem als tenant A een gecachete response ontvangt die is gegenereerd voor tenant B. Dit is een beveiligingslek. De cache-architectuur moet dit per definitie voorkomen, en niet pas via filtering achteraf.
TrueFoundry isoleert cache-entries op twee niveaus, waarbij de gebruiker niet hoeft na te denken over het eerste niveau.
Niveau 1 is voldoende voor de meeste teams. Niveau 2 gebruikt u wanneer één virtual account vertakt naar meerdere eindgebruikers — bijvoorbeeld een SaaS-toepassing die LLM-requests afhandelt namens haar eigen klanten — en een cache per klant vereist is vanwege afspraken over datalocatie. In beide gevallen is er geen globale vectorpool waaruit gegevens kunnen lekken. Dit is de implementatie die voldoet aan de eisen van SOC 2- en HIPAA-auditors.
Anthropic en OpenAI bieden beide caching aan de prompt-zijde: de provider hasht een prefix van de system prompt en hergebruikt de interne status bij cache-hits, wat leidt tot lagere kosten voor gecachete input-tokens. Dit is een andere laag dan waar we het over gehad hebben, en beide vormen vullen elkaar aan.
Prompt-caching bij de provider verkort de time-to-first-token en verlaagt de kosten van gecachete input-tokens, maar het model genereert nog steeds een nieuwe completion. Semantic caching op de gateway omzeilt de model-call volledig. De meeste teams die baat hebben bij de ene optie, hebben dat ook bij de andere. De cache aan de gateway-zijde heeft de meeste impact — dit levert een aanzienlijke latency-verbetering op bij hits, voorkomt verwerkingskosten volledig en biedt een laag die de organisatie kan analyseren, controleren en afstellen zonder afhankelijkheid van de provider. De cache van de provider is een black box; de cache op de gateway beheert u zelf.
Er is een bekend principe binnen gedistribueerde systemen: caches waarborgen de juistheid alleen op de betekenislaag waarvoor ze ontworpen zijn. Een page-cache werkt omdat pagina's de eenheid van juistheid zijn. Een query-cache werkt omdat identieke queries identieke resultaten opleveren. Een LLM-cache die tekst hasht, cached op de verkeerde betekenislaag, en dat leidt tot misses waar hits hadden moeten optreden.
Semantic caching verplaatst de cache-key van tekst naar intentie. Het vereist meer infrastructuur (een embedding model, een vectorindex, een threshold) omdat een intentie een abstracter object is dan een string. Het is echter de juiste abstractie voor deze workload. Zodra de cachelaag aansluit op de betekenislaag, voelen de besparingen niet meer als een kleine optimalisatie, maar als de juiste architectuur.
Nee. Semantic caching omvat exact-match volledig — exact-match is simpelweg een cosine similarity van 1.0. Op TrueFoundry levert het instellen van het cache-type op semantic ook exact-match hits op. Het gescheiden uitvoeren van beide lagen leidt tot dubbele infrastructuur en maakt invalidatie ingewikkelder; de gateway behandelt ze als één enkele laag.
Alleen als u een gehost netwerk-embedding-model gebruikt voor een workload waarbij de meeste calls de cache missen. Het hele doel van het draaien van een klein in-memory model op de gateway-nodes is om de kosten van de embedding ver onder de drempel te houden waar het de winst op hits zou opheffen. Op de SaaS-tier is het standaard embedding model text-embedding-3-small, wat ongeveer één netwerk-round-trip toevoegt; dat zijn de kosten voor het niet zelf hoeven beheren van embedding-infrastructuur.
Draai de cache minstens een week in shadow mode. Stel geen threshold in zonder te analyseren wat deze zou hebben geretourneerd op uw echte verkeer. Het verschil in score op een synthetische test vergeleken met productiedata kan voor vervelende verrassingen zorgen — dit is te voorkomen met één logbestand en één Jupyter notebook.
De cache-beslissing wordt vooraf genomen, voordat de call naar het model begint. Bij een hit wordt de response direct geretourneerd zonder vertraging door streaming. Bij een miss wordt de gestreamde response asynchroon opgevangen en opgeslagen in de cache nadat de call is voltooid — er is geen afweging tussen streaming en caching nodig.
De gateway valt terug op het doorsturen van elke request naar de LLM-provider. Cache misses kosten dan wat ze gekost zouden hebben zonder de cache; er breekt niets af. Het enige operationele signaal is de header x-tfy-cache-status: error bij responses, waarvoor een alert op het dashboard moet worden ingesteld. De betrouwbaarheid van het request-pad gaat boven de beschikbaarheid van de cachelaag.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















