



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
"In 20 minuten door de API-quota heen" is geen fictief SRE-verhaal; het is een alledaagse dinsdagmiddag met een slecht begrensde loop. Token buckets, circuit breakers en een elegante fallback chain — allemaal afgedwongen op de gateway voordat de loop een provider bereikt.
429 is geen crash. Het is de gateway die een holgedraaide agent vertelt stappen terug te doen. De agent gehoorzaamt, de breaker grijpt in, het budget overleeft de dag.
LLM-agents falen volgens een specifiek patroon. Het meest voorkomende productie-incident is niet een model dat het verkeerde antwoord geeft; het is een agent die besluit het opnieuw te proberen, en opnieuw, en opnieuw, en opnieuw. Elke poging is een volledige provider call. Elke call voegt toe aan de context. Context groeit kwadratisch. Tokens worden verbruikt in een tempo dat de mens voor het toetsenbord nooit zou genereren — omdat er geen mens voor het toetsenbord zit.
De rekensom is meedogenloos. Een initiële context van 4.000 tokens, die bij elke stap verdubbelt omdat de uitvoer van de vorige stap wordt toegevoegd, bereikt 128.000 tokens bij stap 5 en de kosten per stap zijn met 32× gestegen. Bij stap 15 heeft de context het window van het model overschreden en betaalt elke call het maximale contexttarief. Bij stap 30 heeft de loop meer uitgegeven dan het maandsalaris van een bekwame engineer. De agent heeft het nooit gemerkt; het is de taak van de agent om door te gaan.
De eerste keer dat de meeste teams dit zien, zien ze het op de rekening van de volgende dag. De tweede keer stellen ze rate limiting in. De juiste plaats voor die rate limiting is niet de applicatie — het is de gateway, waar een enkele laag elke workload beschermt, ongeacht welk framework de loop heeft gestart. Een team dat de limiet binnen elke agent plaatst, moet deze opnieuw schrijven voor elke agent, mist deze in sommige, en ontdekt de failure modes afzonderlijk. Een team dat het op de gateway plaatst, schrijft het één keer en erft de bescherming over elke workload die ooit een model aanroept.
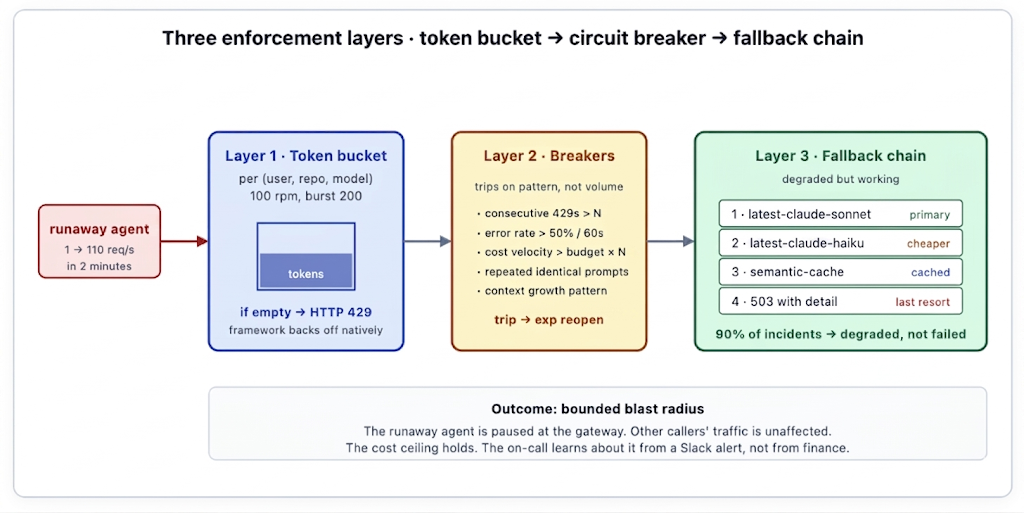
De bucket is de eerste linie. Elke tuple (gebruiker, repo, model) krijgt zijn eigen bucket — bijvoorbeeld 100 requests per minuut met een burst van 200. Bijvullen gebeurt continu op de geconfigureerde snelheid. Wanneer een request arriveert en de bucket leeg is, retourneert de gateway onmiddellijk HTTP 429, voordat het request de provider bereikt. De 429 bevat een Retry-After header die aangeeft hoelang de caller moet wachten.
De keuze van granulariteit is van belang. Eén enkele bucket per gebruiker is te grof — één kwaadwillend script blokkeert al het legitieme werk van de gebruiker, inclusief het werk dat nodig is om het script te debuggen. Een bucket per request is te fijn — er valt niets af te knijpen. De tuple (gebruiker, repo, model) is meestal de juiste vorm: het isoleert de holgedraaide repository van de andere workloads van de gebruiker, stelt het platformteam in staat verschillende plafonds in te stellen voor verschillende modeltiers (ruimer bij goedkope modellen, strenger bij frontier-modellen), en levert nuttige dimensionele opsplitsingen op in het rate-limit dashboard. Sommige teams voegen een vierde dimensie toe — pipeline- of workflow-ID — voor multi-tenant AI-producten waar de bucket moet behoren tot de klant namens wie het request wordt gedaan, niet het team dat de dienst uitvoert.
De meeste agent-frameworks lezen 429 als een standaard backoff-signaal. De agent pauzeert, wacht op de voorgestelde duur en probeert het opnieuw — exact het gedrag dat de gateway wil. Frameworks die 429 niet elegant afhandelen zijn op een andere manier defect, maar de gateway heeft zijn werk al gedaan. Het contract is HTTP-standaard: 429 met Retry-After is wat elke HTTP-clientbibliotheek al vijftien jaar weet af te handelen. Teams die ontdekken dat hun agent-framework 429 niet correct kan verwerken, moeten het framework repareren, niet de gateway.
Burst is de parameter die wordt afgesteld. Stel de burst te laag in en legitieme piekerige workloads (CI-triggers, batch-evaluaties, piekuren van gebruikersgerichte chatbots) krijgen onterecht 429's; stel deze te hoog in en de rate limit beperkt een holgedraaide loop niet daadwerkelijk. Het juiste startpunt is empirisch — kijk naar de natuurlijke burstvorm van legitiem verkeer in de voorgaande maand, stel de bucketgrootte in op ongeveer de waargenomen P99-burst, en pas vanaf daar aan op basis van klachten over false-positives.
Token buckets behandelen volume. Circuit breakers behandelen patronen. Sommige holgedraaide loops blijven onder het plafond van de bucket, maar vertonen andere kenmerken van pathologisch gedrag — een agent die gehoorzaamt aan de bucket van 100 rpm, maar 100 identieke calls per minuut maakt in een krappe loop, is nog steeds een holgedraaide loop, alleen een langzamere. De gateway monitort het recente verkeer van elke identiteit en slaat uit wanneer een van de volgende situaties zich voordoet:
Elke breaker heeft zijn eigen uit- en heropeningslogica. Het gecombineerde effect is dat pathologisch gedrag snel wordt gestopt zonder dat er false-positives uitslaan bij legitiem piekerig verkeer. De breaker is geconfigureerd op platformniveau en geldt voor elke identiteit; de drempelwaarden worden in de loop van de tijd afgesteld op basis van het percentage false-positives dat het team bereid is te tolereren.
Kostensnelheid is de breaker die de meeste teams niet goed genoeg implementeren, omdat de gateway hiervoor de kosten van elk request in real-time moet kennen — invoertokens, uitvoertokens, gecachte tokens, modelspecifieke prijzen — en deze moet invoeren in de breakerlogica voordat het volgende request wordt toegelaten. De gateway van TrueFoundry berekent de kosten per request bij het verlaten van het netwerk op basis van de actuele prijzen van de provider en geeft de lopende kostensnelheid door aan de breaker als een first-class invoer. Een workload die de geplande kostensnelheid overschrijdt met een configureerbare vermenigvuldigingsfactor slaat uit; de breaker is geparametriseerd relatief ten opzichte van het budget van de workload in plaats van een absoluut dollarbedrag, wat de drempelwaarde duurzaam maakt bij prijswijzigingen van providers. Teams die kostensnelheid achteraf inbouwen op een gateway die niet standaard de kosten per request kent, eindigen met verouderde prijstabellen en breaker-drempelwaarden die elk kwartaal handmatig moeten worden geherkalibreerd; de geïntegreerde versie heeft die onderhouds-overhead niet.
Wanneer het primaire pad niet beschikbaar is — de token bucket is afgeknepen, de circuit breaker is open, de provider zelf heeft een storing — is het hard mislukken van elk request de verkeerde uitkomst. Een configureerbare fallback chain levert in plaats daarvan gedegradeerde uitvoer. De chain is een declaratieve configuratie per route:
De chain is een configuratieknop, geen hardgecodeerd gedrag. Verschillende routes hebben verschillende chains. Een coding-pipeline kan een chain van 2 stappen hebben (Sonnet → Haiku → 503) omdat een gedegradeerd Haiku-resultaat soms erger is dan een duidelijke fout. Een gebruikersgerichte chatbot kan een chain van 4 stappen hebben die de semantische cache bevat als een elegante fallback, omdat elke reactie beter is dan geen reactie voor de gebruiker. Een workflow met een hoog afbreukrisico (juridische concepten, financiële analyses) heeft mogelijk helemaal geen fallback chain — het enige acceptabele gedrag bij een primaire fout is het tonen van de fout, zodat een mens kan beslissen.
Het punt is dat het platform beslist wat "gedegradeerd" betekent voor elke workload, in plaats van dat elke workload dat voor zichzelf beslist. In de praktijk verandert dit 90% van de incidenten met "capaciteit uitgeput" in incidenten die "gedegradeerd maar werkend" zijn — zichtbaar voor het platformteam, onzichtbaar voor de eindgebruiker. De semantische cache is het onderbenutte onderdeel van de chain in de configuraties van de meeste teams; een workload met een redelijke cache-hitratio (bijvoorbeeld 30%) overleeft de meeste kortstondige storingen door gecachte reacties te serveren voor voldoende vergelijkbare query's.
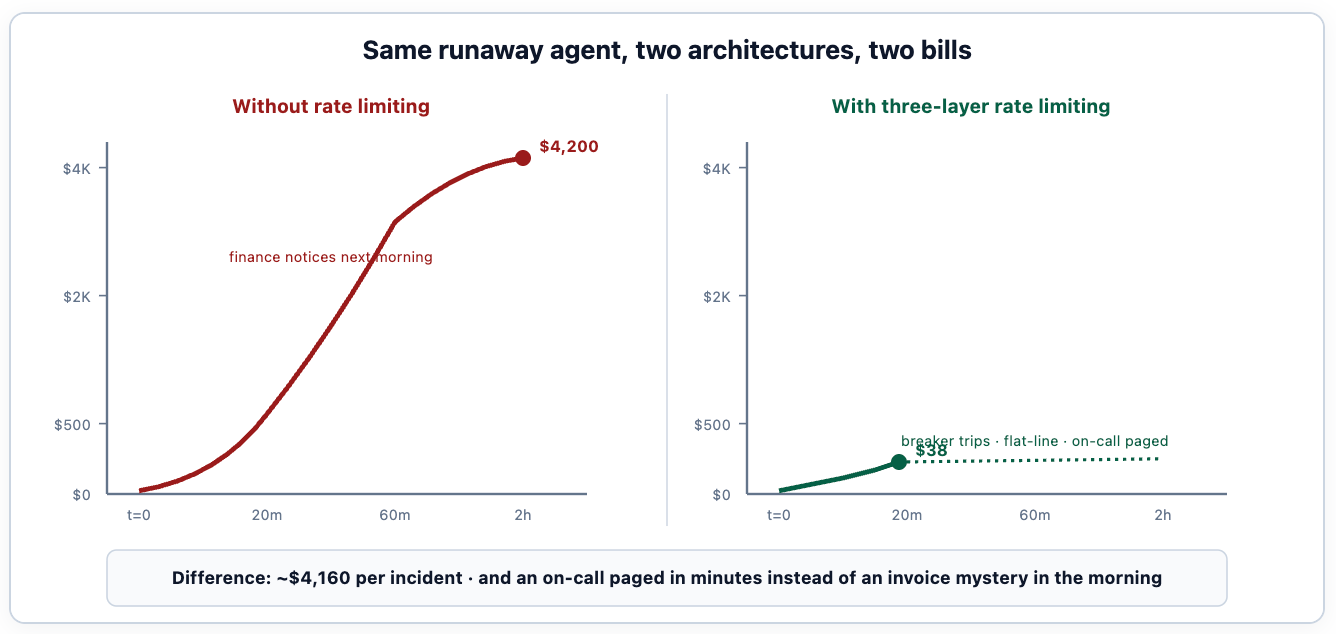
Het economische argument is het argument waarmee het rate-limiting-project gefinancierd wordt. Een enkel incident met een holgedraaide loop zonder handhaving kost doorgaans $ 2.000 tot $ 8.000 tegen de tijd dat iemand het opmerkt; hetzelfde incident met de drie lagen actief kost $ 20 tot $ 100 en leidt tot een hanteerbare post-mortem in plaats van een excuses-mail naar de financiële afdeling. Het eerste incident betaalt de engineering-inspanning om de rate-limitinglaag te bouwen vijf tot tien keer terug.
Het contract vanuit het perspectief van de caller is HTTP-standaard. De vier uitkomsten dekken elke status af die de rate-limitinglaag kan produceren, en elke status komt overeen met een goed begrepen oplossing. Agent-code hoeft niet te weten dat de rate-limitingarchitectuur bestaat; het moet weten hoe het moet omgaan met 429, 503 en de header voor modelidentificatie. Drie regels foutafhandelingscode zijn voldoende voor de meeste agent-frameworks.
Paging-signalen worden alleen verzonden wanneer de breaker daadwerkelijk uitslaat, niet bij elke 429. Een 429 is normaal; een uitgeslagen breaker is afwijkend. De on-call engineer ontvangt een enkele, actiegerichte Slack-melding:
Trace ID, identiteit, patroon, kosten, oplossing. Alles wat de engineer nodig heeft om te beslissen of hij de breaker verlengt, het quota verhoogt of het team belt dat eigenaar is van de foutieve pipeline. De melding is ontworpen om binnen 30 seconden te worden beoordeeld: 90% van de tijd is de melding een legitieme holgedraaide loop en verlengt de engineer de breaker, plaatst een bericht in het kanaal van het betreffende team en gaat terug naar waar hij mee bezig was. 10% van de tijd is het een false-positive (een legitieme burst die de drempelwaarden niet hadden voorzien) en verhoogt de engineer het quota en voegt het geval toe aan de herziening van de drempelwaarden.
De indeling van de melding is het operationele element dat meer wordt afgesteld dan de drempelwaarden van de breaker zelf. De eerste versie van de melding is meestal te uitgebreid (iedereen wil alles weten) en wordt genegeerd; de zevende versie is degene die precies de vijf feiten bevat die de engineer daadwerkelijk nodig heeft. De discipline bestaat erin de melding als een product te behandelen, met de on-call engineer als gebruiker.
De standaard meldingsindeling van TrueFoundry wordt geleverd met die vijf feiten (trace ID, identiteit, patroon, kostensnelheid, deep link naar het dashboard van de workload) gecalibreerd op basis van de operationele lessen van het uitvoeren van deze rate-limitlaag voor de bestaande klanten van het platform. Teams kunnen de indeling per route aanpassen; de meeste doen dat niet, omdat de standaard al is waar ze bij de zevende iteratie op uit zouden zijn gekomen. Het structurele ontwerp is de bijdrage — het benoemen van de juiste vijf feiten op de juiste granulariteit — niet het YAML-schema waarin ze staan.
De drie lagen vormen samen een configuratie per route die het platformteam beheert. Hieronder ziet u hoe een werkende configuratie eruitziet voor een CI/CD agentic workload — de kanonieke casus waar rate limiting het belangrijkst is omdat het menselijke tempomechanisme ontbreekt:
De configuratie is het artefact. Het wordt beoordeeld in pull requests, heeft versiebeheer samen met de gateway-deployment en wordt gewijzigd wanneer de tolerantie van het team verandert (een nieuw type workload met andere burst-patronen, een strenger kostenplafond, een nieuwe modeloptie in de fallback chain). Het platformteam is eigenaar van het schema; individuele workloadteams kunnen specifieke velden voor hun routes overschrijven binnen de grenzen die het platformteam stelt.
Elk primitief in het bovenstaande manifest — de token buckets per identiteit, de vier genoemde circuit breakers, de declaratieve fallback chain, de meldingen in actiegerichte indeling — is een TrueFoundry gateway-primitief in plaats van aangepaste middleware. Het platformteam kiest de granulariteit, stelt de drempelwaarden in, configureert de chain; er is geen rate-limiting middleware om te bouwen, testen en onderhouden. Teams die dezelfde drie lagen hebben geïmplementeerd bovenop een gateway zonder deze primitieven, eindigen met het schrijven van dezelfde paar honderd regels Lua- of Python-middleware, dezelfde Redis-gestuurde bucket-store, dezelfde meldingsformatter — en ontdekken de meeste randgevallen (race conditions bij het bijvullen van buckets, overdracht van de breaker-status over replica's, volgorde van de fallback chain bij gedeeltelijke storingen) pas de derde of vierde keer dat de holgedraaide loop in productie optreedt.
Vier patronen verschijnen regelmatig bij de eerste opzet van rate limiting door teams, en elk patroon leidt tot een andere failure mode die het waard is om te kennen.
Fout 1: een te grove bucket key. Eén enkele bucket per gebruiker betekent dat één holgedraaide agent het debug-werk van de gebruiker blokkeert — inclusief het werk dat nodig is om de holgedraaide agent te vinden en te repareren. De tuple (gebruiker, repo, model) is meestal de juiste granulariteit; teams die hoger aggregereer dan dit, eindigen met operationeel pijnlijke incidenten.
Fout 2: geen fallback chain. Een workload die hard mislukt op elke 429 leidt tot een slechtere gebruikerservaring dan nodig is. Zelfs als het team geen fallback-model wil (kwaliteitszorgen zijn terecht), is het tonen van een gecachte reactie of een melding "tijdelijk niet beschikbaar" beter dan een 5xx die de gebruiker leest als "de AI is kapot."
Fout 3: pagen bij elke 429. 429's zijn normaal — ze laten zien dat het systeem werkt zoals ontworpen. Paging-signalen mogen alleen afgaan wanneer de breaker uitslaat, niet wanneer de bucket afknijpt. Teams die pagen bij een 429 negeren uiteindelijk de meldingen (omdat het meeste ruis is) of werken met hun buckets zo hoog ingesteld dat de limiet niets meer beperkt.
Fout 4: drempelwaarden voor kostensnelheid ingesteld als statische dollarbedragen. Een statische drempelwaarde ("$ 10/minuut is te veel") wordt snel achterhaald naarmate het verkeer en de prijzen van het team veranderen. De drempelwaarde moet relatief zijn ten opzichte van het geplande budget van de workload — "10× de geplande snelheid" is duurzaam bij kostenveranderingen; "$ 10/minuut" is kwetsbaar.
Rate limiting is een van de weinige platformwijzigingen waarbij het deployment-risico asymmetrisch is: niet handhaven is de status quo (met incidenteel dure incidenten), te agressief handhaven breekt legitieme workloads. De uitrolvolgorde moet primair gericht zijn op observatie, en in tweede instantie op handhaving.
Week 1 — Buckets alleen voor audit, breakers alleen voor audit. Deploy de rate-limitinglaag met elke drempelwaarde ingesteld op "loggen maar niet handhaven." Elk request gaat er nog steeds doorheen; de gateway legt vast wat gecanceld zou zijn of wat een breaker zou hebben doen uitslaan. Het dashboard aan het einde van de week beantwoordt de vragen waarvan het team niet wist dat ze ze moesten stellen: welke workloads piekerig zijn, welke al loop-patronen vertonen, hoeveel requests/minuut de drukste legitieme gebruiker daadwerkelijk genereert.
Week 2 — Schakel alleen de token bucket in op één workload-klasse. Kies de klasse met het hoogste risico — meestal agentic CI/CD-pipelines, waar een menselijk tempomechanisme ontbreekt. Schakel de token bucket in met drempelwaarden ingesteld op de P99 van het waargenomen legitieme verkeer plus een marge. Let de hele week op 429's. Bij false-positives (legitieme workloads die de limiet bereiken) wordt de drempelwaarde verhoogd; bij afwezigheid van false-positives wordt de volgende workload-klasse ingeschakeld.
Week 3 — Voeg de breaker voor kostensnelheid toe. De breaker voor kostensnelheid is degene die de langzame holgedraaide loops opvangt die de token bucket mist. Configureer deze standaard op 10× de geplande snelheid; pas deze per workload aan na een week aan auditgegevens. Paging-signalen zijn geconfigureerd, maar worden tijdens week 3 alleen naar het platformteam gestuurd, niet naar product on-calls — de drempelwaarde wordt nog steeds afgesteld.
Week 4 — Andere breakers, fallback chain. Voeg de detector voor loop-patronen toe. Configureer fallback chains per route, in nauw overleg met de eigenaars van de workloads — zij weten hoe "gedegradeerd" eruit moet zien voor hun use-case. De semantische cache vult zich tijdens de eerste werkweek; cache-hitratios stijgen geleidelijk en stabiliseren rond 20-40% voor de meeste workloads.
Week 5+ — Steady-state. De paging-signalen gaan naar de product on-call. Het rate-limit dashboard is onderdeel van de reguliere evaluatie van het team. Nieuwe workloads starten standaard in de audit-only status en worden expliciet overgezet naar handhaving. De drempelwaarden worden elk kwartaal opnieuw afgesteld als het verkeerspatroon verschuift; de breaker-regels worden uitgebreid naarmate nieuwe pathologische patronen worden ontdekt. Het systeem draait als infrastructuur, niet als een project.
De rate-limitinglaag is eigendom van het platformteam. De workloadspecifieke drempelwaarden zijn mede-eigendom van de workloadteams. Het goed krijgen van de grens is van belang omdat elk team andere beslissingsrechten en andere tijdshorizonten heeft.
Het platformteam is eigenaar van de architectuur. Welke breakers er bestaan, wat de meldingsindeling is, wat het auditlogboek vastlegt, hoe de configuratie wordt beoordeeld. Deze zijn stabiel over workloads heen; ze veranderen zelden. De taak van het platformteam is om primitieven te leveren, ze te documenteren en de standaarden af te stellen.
Het workloadteam is eigenaar van de parameters. De bucketgrootte voor hun workload, de volgorde van de fallback chain, de drempelwaarde voor kostensnelheid. Deze zijn workloadspecifiek en veranderen naarmate de vereisten van de workload evolueren. Het platformteam beoordeelt wijzigingen (een workload die om een enorme bucket vraagt, krijgt een gesprek, geen automatische goedkeuring), maar het workloadteam heeft het operationele eigenaarschap.
De on-call-dienst wordt gewisseld tussen platform en product. Paging-signalen van de rate-limitinglaag gaan naar een gedeelde rotatie. Platformengineers behandelen meldingen waarbij het probleem in de platforminfrastructuur zit (de breakerlogica zelf klopt niet); productengineers behandelen meldingen waarbij het probleem in hun workload zit (de holgedraaide loop zit in hun code). De overdracht is de inhoud van de melding; als de melding zegt "uw workflow heeft 200 keer in 5 minuten een loop uitgevoerd, hier is de trace," dan is de productengineer de juiste responder.
Het patroon dat mislukt, is dat platform alles van A tot Z bezit. Platformengineers weten niet wat "gedegradeerd maar acceptabel" betekent voor de chatbot van de klantenservice; productengineers hebben geen zicht op platformbrede signalen. De splitsing is wat het operationele model duurzaam maakt.
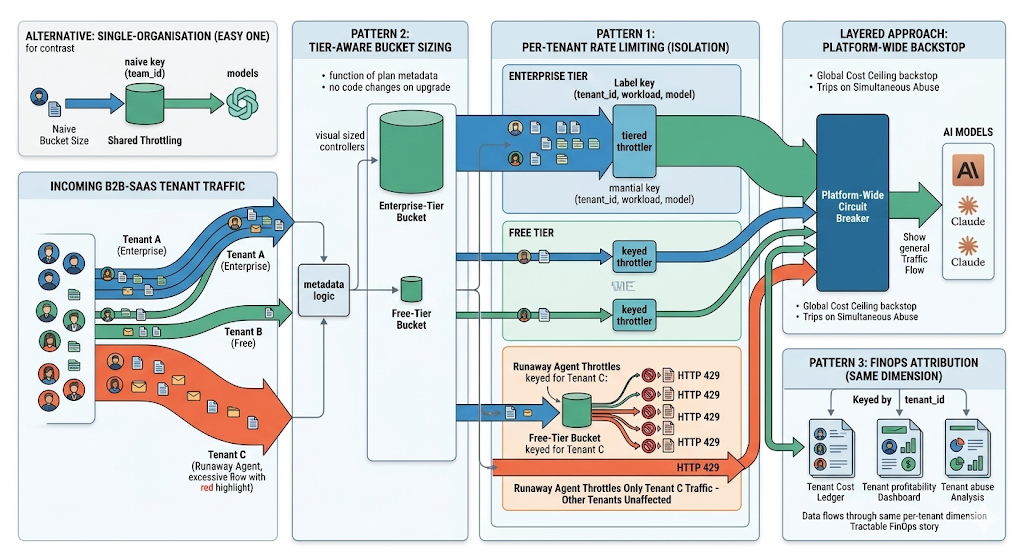
Het geval van een enkele organisatie waarin elke caller bij één team hoort, is het eenvoudige geval. Veel AI-implementaties in productie zijn multi-tenant: een B2B-SaaS-product biedt AI-functies aan aan zijn eigen klanten, die elk verkeer van willekeurige vorm kunnen genereren. De rate-limitinglaag moet huurders (tenants) van elkaar isoleren en tariefplannen per tenant afdwingen zonder de architectuur te veranderen.
Het patroon dat werkt, voegt tenant toe als een extra dimensie aan de bucket key. De bucket wordt gedefinieerd door (tenant, workload, model) — een holgedraaide agent van één tenant knijpt alleen het verkeer van die tenant af; andere tenants ondervinden geen hinder. Het algehele kostenplafond van het platform bevindt zich boven de plafonds per tenant; een enkele tenant die zijn tariefplan overschrijdt, raakt eerst zijn eigen bucket, en de platformbrede breaker biedt een opvangnet voor het geval meerdere tenants zich gelijktijdig misdragen.
Tier-aware bucket sizing is het tweede patroon. De customer in de free-tier krijgt een kleiner bucket dan de customer in de enterprise-tier; de bucket sizes worden afgeleid van het plan van de tenant. Wanneer een tenant van plan upgradet, wordt de bucket size bijgewerkt zonder code-wijzigingen — de tier is metadata op de tenant-identiteit, de bucket size is een functie van de tier. Teams die bucket sizes hardcoden in applicatiecode eindigen met het herschrijven ervan elke keer dat de pricing verandert; teams die ze afleiden uit tenant-metadata erven automatisch het juiste gedrag.
Het derde patroon: per-tenant cost attribution stroomt door dezelfde dimensie. Als de bucket gekoppeld is aan de tenant, is het cost ledger gekoppeld aan de tenant, het audit log is gekoppeld aan de tenant, het rate-limit dashboard is gekoppeld aan de tenant. Het FinOps-verhaal van het platform (welke tenants het duurst zijn, welke winstgevend zijn, welke het systeem misbruiken) wordt hanteerbaar op basis van dezelfde data die de rate-limiting-laag al produceerde.
Begin bij de natuurlijke traffic shape — kijk naar de P99 burst voor de workload over de afgelopen maand en dimensioneer de bucket ongeveer daarop. Pas aan op basis van de false-positive rate (legitieme workloads die klagen over 429s) en de breaker trip rate (runaways die aan de bucket ontsnappen). De bucket is een parameter per workload; one size does not fit all.
Nee — ze vullen elkaar aan. De limits van de provider zijn absoluut; de limits van de gateway zijn per identiteit en fijnermazig. De limit van de provider zegt misschien "100.000 requests/minuut org-wide"; de limit van de gateway zegt "100 requests/minuut voor deze CI pipeline." Beide zijn van toepassing; de limit van de gateway zal voor individuele workloads meestal als eerste getriggerd worden.
Configureer een hogere bucket voor die workload. Een workload waarvan bekend is dat deze 1.000 rpm nodig heeft, krijgt een bucket die dienovereenkomstig gedimensioneerd is; de drempelwaarde is per workload, niet platform-wide. De discipline zit in het beoordelen van de hogere bucket met het platformteam voordat deze wordt toegekend, in plaats van het standaard toekennen van onbeperkte capaciteit.
Ja. Een streaming response die twee minuten duurt, verbruikt één bucket token op het moment van het request, maar genereert aanzienlijke kosten gedurende de looptijd van de stream. De cost-velocity breaker handelt dit geval af; de token-bucket-laag wordt aangevuld met een streaming-cost monitor die de stream kan annuleren als de cost velocity halverwege de stream de drempelwaarde overschrijdt.
Ja — de cost-velocity breaker bevat "spike detection": een enkel request waarvan de kosten N× de gemiddelde kosten van de workload overschrijden (typisch 50× of 100×) laat de breaker trippen, zelfs als er geen rate-patroon zichtbaar is. Dit vangt het geval op waarin een agent een request met context overflow indient dat $50 kost in plaats van de gebruikelijke $0,05.
Uitrollen gebeurt eerst in audit-only mode — de breaker berekent of deze zou zijn getript, maar blokkeert niet daadwerkelijk. Na een week heeft het team een reële distributie: welke workloads zouden zijn getript, hoe vaak en onder welke voorwaarden. Tune de drempelwaarden op basis van de audit-only data en schakel vervolgens enforcement in. De audit-only week is een goedkope verzekering tegen false positives.
Nee — de fallback chain neemt het over. Als de fallback chain uitgeput is, krijgt de applicatie een schone HTTP 503 met een gestructureerde error body die het kan tonen aan de gebruiker. Crashes gebeuren niet bij de gateway; ze gebeuren in slecht afgehandelde applicatiecode die niet weet wat te doen met een 503. De oplossing is error handling aan de applicatiezijde, geen wijzigingen aan de gateway.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















