



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Elke grote LLM-provider implementeert prompt caching op een andere manier. Zo vertaalt de TrueFoundry AI Gateway cache-directives tussen providers, handelt hij fallbacks af wanneer een doel geen caching ondersteunt en biedt hij geünificeerde hit-metrics — inclusief benchmarks voor tokenbesparingen.

Prompt caching is de meest effectieve kostenoptimalisatie voor elke LLM-workload die gebouwd is op een lange, stabiele prefix — een system prompt van 10K tokens, een tool registry of een retrieval bundle. De korting bedraagt ongeveer 90% op gecashte input-tokens, groot genoeg om de rendabiliteit per eenheid van een agent-product ingrijpend te veranderen.
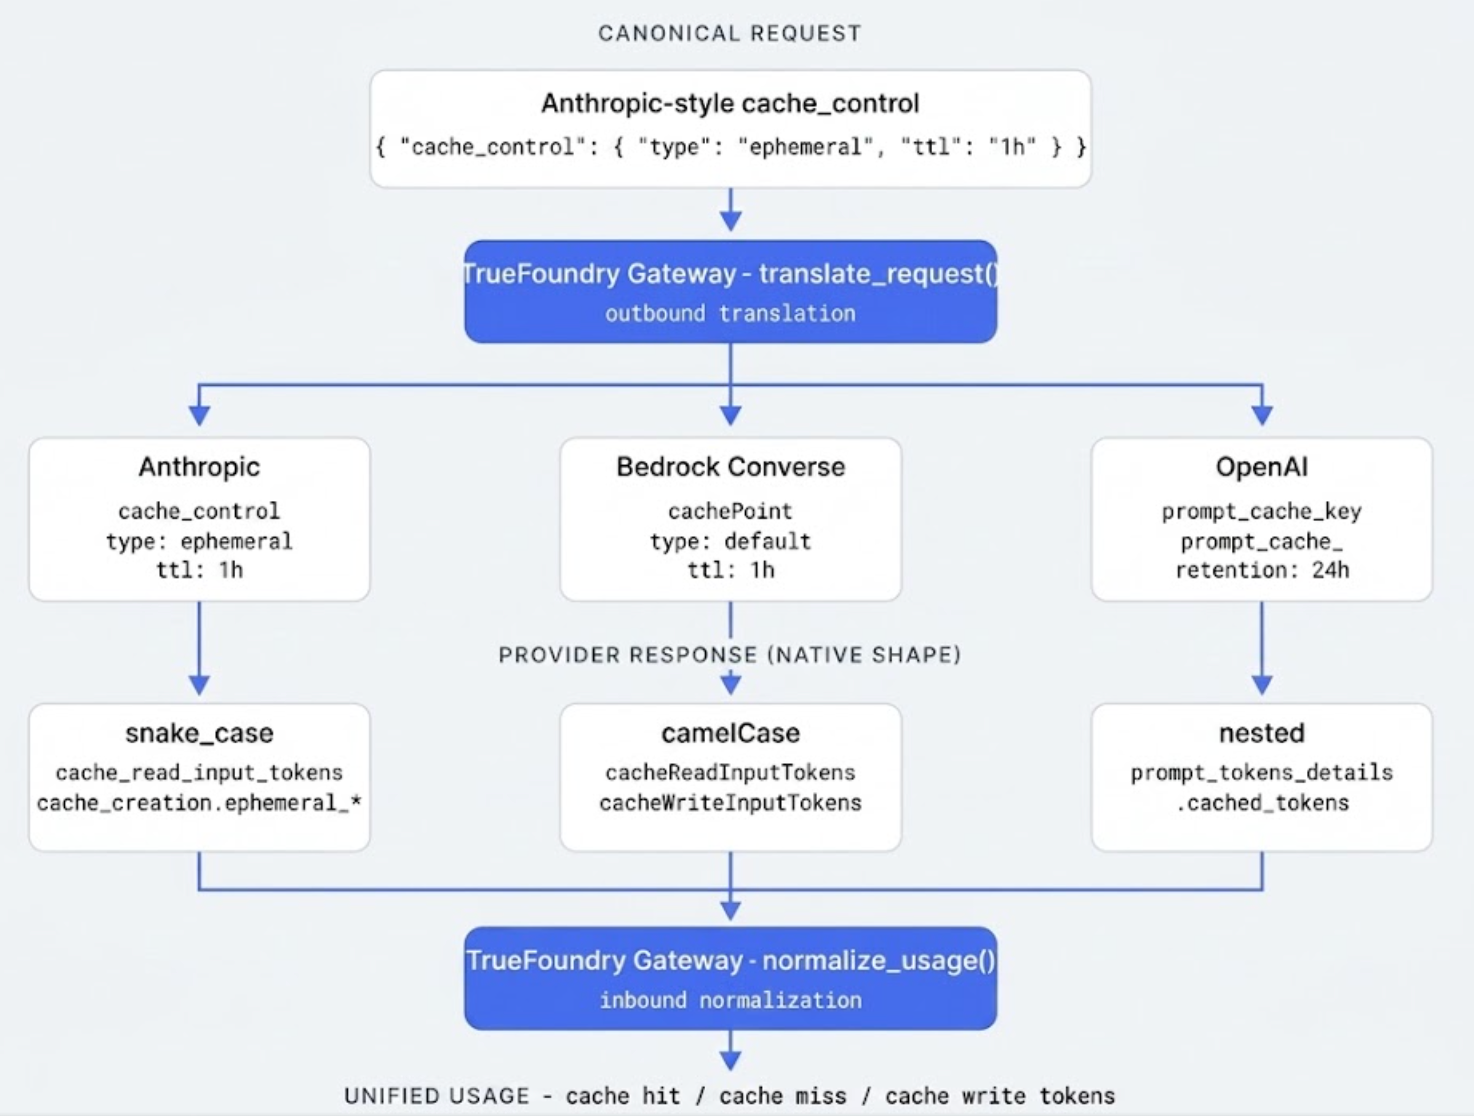
Het addertje onder het gras is dat de API's van de drie grote LLM-providers — Anthropic native, OpenAI en AWS Bedrock Converse — caching elk op een fundamenteel andere manier modelleren: in directive-vorm, response-vorm, TTL-opties en zelfs wanneer caching überhaupt wordt aangeroepen.
De prompt caching van Anthropic is de meest expressieve van de drie. Je geeft expliciet aan welk deel van de request gecasht moet worden door het attribuut cache_control te gebruiken op een system- of message-blok:
anthropic request · json
Drie regels bepalen wanneer dit daadwerkelijk wordt gecasht. De prefix moet een modelspecifiek minimum overschrijden: 1.024 tokens voor de Sonnet-klasse en 2.048 tokens voor de Opus-klasse. Onder die drempel wordt de directive stilzwijgend genegeerd. De standaard TTL is 5 minuten, welke bij elke hit wordt vernieuwd. En de prefix moet byte-identiek zijn — een losse timestamp vóór het gecashte blok maakt de hit onmogelijk (we komen hierop terug in §08).
Prijsstelling heeft twee niet-voor-de-hand-liggende componenten. Cache reads worden gefactureerd tegen 10% van het basis input-tarief — de 90% korting waar je voor kwam. Cache writes dragen een toeslag van 25% bovenop de basis input-prijs. De cache moet zichzelf terugverdienen over voldoende opeenvolgende hits om de write-toeslag terug te verdienen; voor een prefix van 10K tokens op Sonnet 4.6 ligt het break-evenpunt op twee vervolghits.
De response toont caching in drie usage-velden: cache_read_input_tokens (geserveerd uit cache), cache_creation_input_tokens (geschreven in deze beurt) en input_tokens (al het andere). Omdat caching met verlengde TTL je nu laat kiezen voor een retentie van 1 uur tegen een write-toeslag van 2×, toont Anthropic ook een specificatie per TTL onder cache_creation.ephemeral_5m_input_tokens en cache_creation.ephemeral_1h_input_tokens. Die opsplitsing is belangrijker dan hij lijkt — we komen daar in §04 op terug.
De prompt caching van OpenAI hanteert de tegenovergestelde filosofie. Er is geen directive. De cache wordt automatisch ingeschakeld zodra de prompt-prefix meer dan 1.024 tokens bedraagt, en de infrastructuur van OpenAI casht de KV-activaties aan de serverzijde. Opeenvolgende requests met dezelfde prefix krijgen automatisch de gecashte status.
De interface voor ontwikkelaars bestaat uit twee optionele parameters die invloed hebben op — maar niet de aanleiding zijn voor — caching. prompt_cache_key is een string die wordt gecombineerd met de prefix-hash om de backend-routing te beïnvloeden: dezelfde sleutel betekent dezelfde backend en een hogere hit-rate. prompt_cache_retention accepteert "in_memory" (standaard, 5–10 minuten) of "24h" voor verlengde retentie. Beide staan gedocumenteerd in de prompt caching-gids van OpenAI.
Het verschil met Anthropic is scherp: je kunt niet kiezen welke prefix wordt gecasht. De cachinglaag van OpenAI kiest de langste herhaalde prefix die hij op een gegeven backend waarneemt. Als je system prompt wordt gevolgd door een regelmatig veranderende tool registry, kan de cache enkel op de system prompt landen of op een andere grens, zonder dat je inzicht hebt in welke. De response toont slechts één cache-veld — cached_tokens genest onder usage.prompt_tokens_details — en geen teller aan de write-zijde, omdat OpenAI niets in rekening brengt voor cache-writes.
De praktische implicatie: OpenAI-caching is uitermate geschikt voor workloads waarbij de stabiele prefix uit één blok bestaat. De expliciete breekpunten van Anthropic geven je fijnmazige controle over multi-region prefixen; OpenAI biedt dat niet.
Bedrock's prompt caching bevindt zich in de Converse API en maakt gebruik van een cachePoint marker-blok dat na de inhoud geplaatst wordt die het casht:
bedrock converse · json
Drie zaken maken dit ingewikkelder dan het lijkt. Ten eerste is de plaatsing van de marker het tegenovergestelde van Anthropic — de directive komt na de inhoud die het casht, niet erin. Implementaties die het patroon van Anthropic rechtstreeks overnemen, schakelen caching stilzwijgend uit. Ten tweede betreft dit specifiek de Converse API; het native InvokeModel-eindpunt van Bedrock accepteert het formaat in Anthropic-stijl letterlijk voor Claude-modellen, maar Converse is het pad dat de meeste nieuwere integraties gebruiken.
Ten derde is de TTL-ondersteuning onlangs gewijzigd. Vóór 26 januari 2026 ondersteunde Bedrock Converse alleen een TTL van 5 minuten. Op die datum lanceerde AWS ondersteuning voor een TTL van 1 uur voor de Claude 4.5+-familie en Amazon Nova; het nieuwe veld ttl: "1h" op de cachePoint activeert dit. Oudere modellen weigeren dit veld — er is geen automatische downgrade.
De response gebruikt camelCase: cacheReadInputTokens, cacheWriteInputTokens en inputTokens. In tegenstelling tot Anthropic toont Bedrock Converse geen opsplitsing per TTL bij writes. De gateway die de request heeft vertaald weet welke TTL is aangevraagd; de response alleen vertelt je dat niet.
Het vertaalprobleem dat de gateway moet oplossen is: een client stuurt één canonieke request met cache_control in Anthropic-stijl, en de gateway routeert naar de provider die door het beleid wordt geselecteerd. Er zijn drie strategieën mogelijk — de directive strippen wanneer het doel deze niet begrijpt, vertalen naar de native cache-primitive van het doel, of een foutmelding geven en weigeren te routeren.
De gateway van TrueFoundry kiest voor vertalen waar mogelijk, anders strippen en loggen. Anthropic en Bedrock Converse krijgen een volledige vertaling — cache_control met een TTL wordt een cachePoint met het equivalente ttl-veld. OpenAI krijgt een vertaalde intentie: de directive zelf wordt verwijderd, maar prompt_cache_retention wordt ingesteld op "24h" voor een canonieke TTL van 1 uur, en prompt_cache_key wordt doorgestuurd vanuit de canonieke cache_key. Wanneer een downgrade wordt afgedwongen — bijvoorbeeld een TTL van 1 uur die wordt gerouteerd naar een model dat geen verlengde TTL ondersteunt — zendt de gateway een warning span-attribuut uit (gen_ai.tfy.cache_ttl_downgrade=5m) zodat de regressie observeerbaar is.
Een subtielere valkuil aan de response-zijde is de kosten-berekeningsfout bij gemengde TTL's.
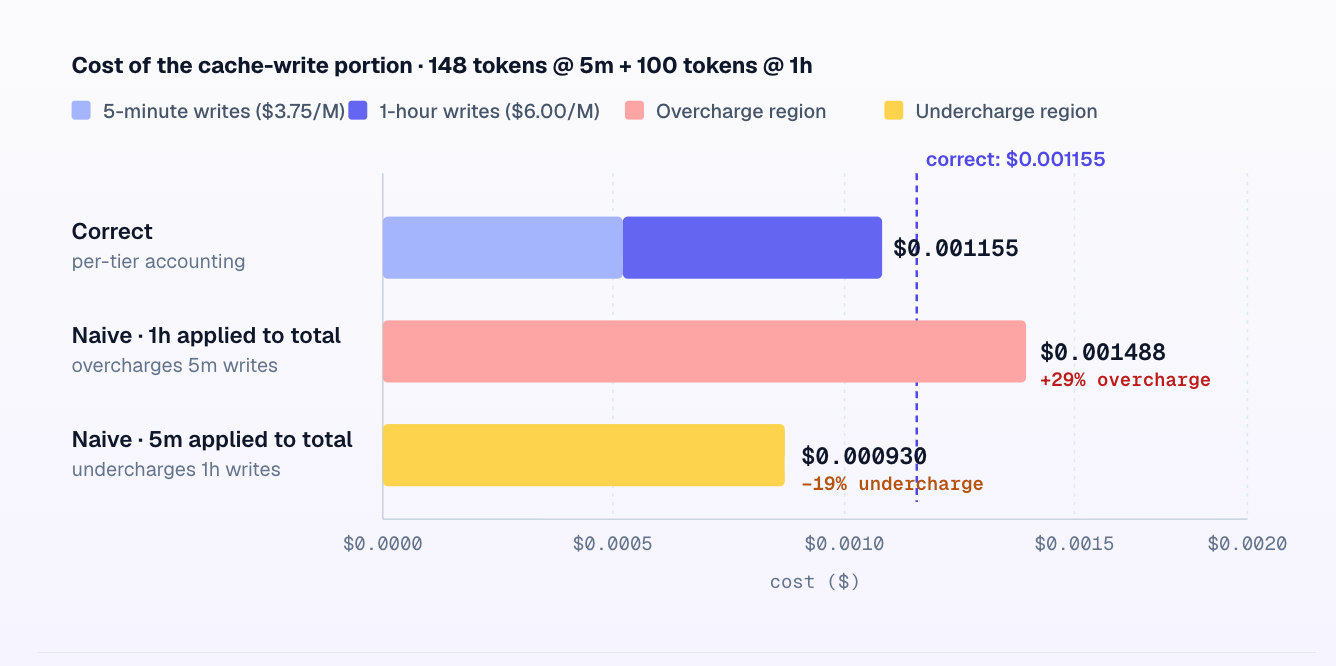
Het geünificeerde usage-object dat de gateway downstream beschikbaar stelt, heeft daarom vijf tokenvelden in plaats van vier: cache_hit_tokens, cache_miss_tokens, cache_write_5m_tokens, cache_write_1h_tokens en .
Het interessante foutscenario voor elke multi-provider gateway is wat er gebeurt als het primaire doel rate-limited is of offline is en de request terugvalt op een secundair doel. Wat caching betreft: caches verhuizen niet mee met het verkeer tussen providers. Een request waarvan de system prompt van 10K tokens de afgelopen vijftien minuten actief is geweest in de cache van Anthropic, zal bij een fallback naar Azure OpenAI op een volledig lege prefix-cache stuiten. De fallback slaagt — maar betaalt wel de volle prijs voor de input-tokens van de prefix, en de trace meldt terecht een cache-miss.
Voor een prefix van 10K tokens op Sonnet 4.6 is dat het verschil tussen $ 0,003 (gecashte read) en $ 0,030 (volledige input) per request — een kostenstijging van 10× tijdens het failover-venster. Zelfs nadat het secundaire doel is opgewarmd, is dat opwarmen niet gratis: elke verse request op een koud doel betaalt de write-toeslag.
De oplossing bestaat uit twee delen. Houd het secundaire doel warm — stuur continu 1% van het verkeer naar de fallback-provider, niet alleen tijdens incidenten. Monitor de cache-hit rate van de fallback afzonderlijk. Een nuttige melding is niet "fallback-percentage overschrijdt 5%"; het is "fallback-percentage overschrijdt 5% EN cache-hit rate van de fallback is onder de 50%." Het eerste is een routing-event; het tweede is een routing-event met een meetbare kostenstraf eraan gekoppeld.
De opbrengst van de normalisatielaag is dat elke trace span dezelfde cache-attributen bevat, ongeacht welke provider de request heeft verwerkt:
otel span attributes · gateway-emitted
Elke dashboard-query, kostentoewijzingstaak of router-tuning-analyse kan deze velden uitlezen zonder vertakkingen per provider te hoeven maken. De hieruit berekende cache-hit rate is vergelijkbaar tussen Anthropic-, OpenAI- en Bedrock-verkeer, wat betekent dat één dashboardpaneel de vraag kan beantwoorden "welke provider geeft ons de beste cache-efficiëntie voor deze workload" zonder dat er drie verschillende SQL-templates nodig zijn.
Twee kanttekeningen. De cache-specifieke attributen volgen het gen_ai.* namespace-patroon van OTel, maar maken (nog) geen deel uit van de officiële semantische conventiespecificatie. En hit_rate is een operationeel nuttige samenvatting, geen exacte efficiëntiemetrik; gebruik voor exacte kostenafstemming rechtstreeks de onderliggende tokenvelden.
De workload die de meeste agent-toepassingen daadwerkelijk uitvoeren: een stabiele system prompt van 10.000 tokens, een user query van 200 tokens die per request verschilt, een model-response van 500 tokens en 1.000 requests gedurende een sessie. Uitgaande van een realistische cache-hit rate van 95% — 950 hits, 50 misses door verlopen TTL's tijdens rustpauzes. Alle bedragen in $ USD op basis van de catalogusprijzen van mei 2026.
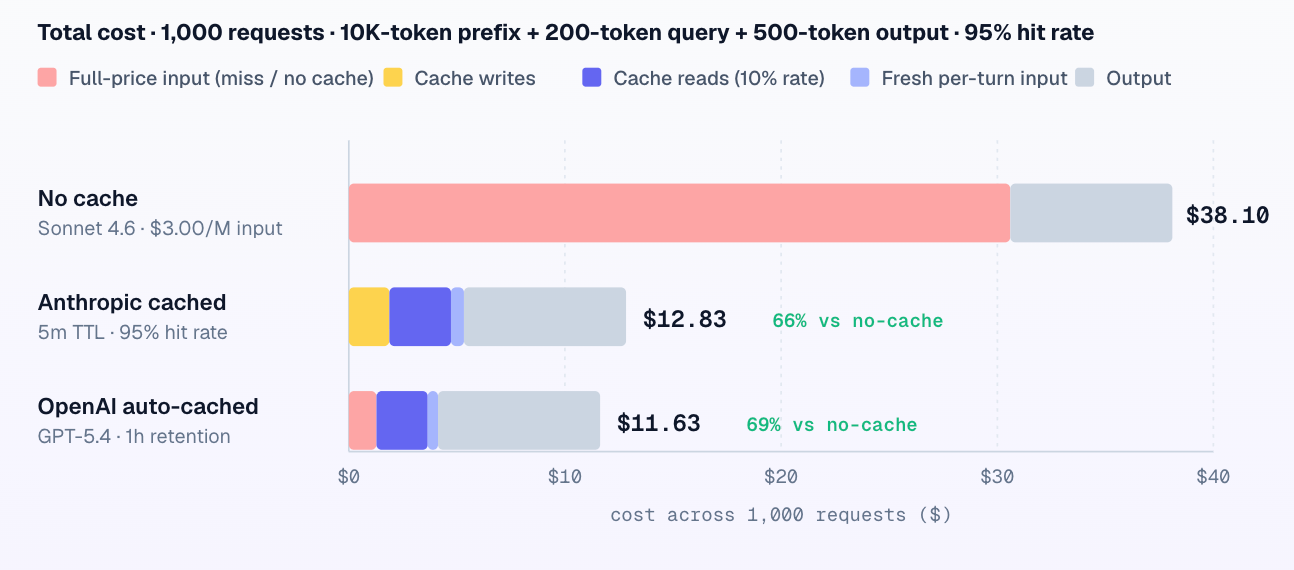
Twee zaken vallen op. Beide providers leveren grote, vrijwel vergelijkbare besparingen op — het verschil tussen de twee is klein vergeleken met het verschil ten opzichte van géén caching. En zodra caching is ingeschakeld, worden output-tokens de dominante kostenpost (~58% van het totaal bij Anthropic, ~65% bij OpenAI). Dat verandert welke optimalisaties daarna belangrijk zijn: zodra caching aan staat, behaal je de volgende besparing op het beperken van de output-lengte, niet op een verdere input-optimalisatie.
De cache-key is gebaseerd op een exacte match op byte-niveau, nog voordat een van de slimme oplossingen hierboven in werking treedt. Een aantal veelvoorkomende patronen vernietigt stilzwijgend je hit-rate, en ze hebben allemaal dezelfde vorm: er wordt iets veranderlijks samengevoegd vóór of in de zogenaamd stabiele prefix.
De gateway kan de meeste hiervan passief detecteren door de cache-hit rate per virtueel account te bewaken. Een system prompt van 10K tokens die structureel onder een hit-rate van 40% blijft, is bijna altijd het gevolg van veranderlijke inhoud, en de trace-tijdlijn laat meestal zien welk segment verandert. Het TrueFoundry-dashboard geeft dit weer als een melding "low cache hit rate" inclusief prefix-diff context, waardoor het probleem meestal binnen vijf minuten is opgelost met een kleine prompt-aanpassing.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















