



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Oracle Cloud Infrastructure (OCI) kiest voor een andere benadering van AI-compute dan de hyperscalers die uitgaan van VM's. De onderscheidende laag is bare-metal: de GPU-shapes van OCI — zoals BM.GPU.H100.8 — draaien zonder enige hypervisor-overhead en maken verbinding via NVIDIA ConnectX SmartNICs over een op maat gemaakt RDMA over Converged Ethernet (RoCE v2) clusternetwerk.
Dat prestatieplafond brengt operationele overwegingen met zich mee bij het beheren van cloudinfrastructuur op bare-metal. Bare-metal betekent dat u nu verantwoordelijk bent voor de laag die VM's gewoonlijk abstraheren: GPU-drivers en de OFED-stack, scheduling binnen de topologiebeperkingen van het clusternetwerk, federatieve identiteit via OCI IAM, en het kiezen uit verschillende opslagpaden voor modelgewichten. Niets hiervan is exotisch, maar het is aanzienlijk Kubernetes-werk dat niet voorkomt bij beheerde VM-proposities.
De rol van TrueFoundry op deze stack is de Kubernetes-native operationele laag. Het Compute Plane is uw eigen Oracle Cloud Infrastructure Kubernetes Engine (OKE)-cluster dat draait op OCI bare-metal. Het platform verpakt een reeks open-source- en CNCF-geaffilieerde onderdelen (ArgoCD, Argo Workflows, NVIDIA GPU Operator, Prometheus, KEDA, Istio en andere) in een beheerde uitrol, voegt een geïntegreerde UI en GitOps-workflow toe, en biedt observability over services, jobs en GPU-benutting. Het vervangt geen OCI-primitieven — het bevindt zich er bovenop.
Dit artikel doorloopt de architectuur die u overhoudt wanneer u TrueFoundry op OCI bare-metal uitvoert: de scheiding tussen control/compute plane, hoe RDMA-training past in Kubernetes, hoe workloadidentiteit werkt, en de praktische patronen voor het op schaal laden van modelgewichten.
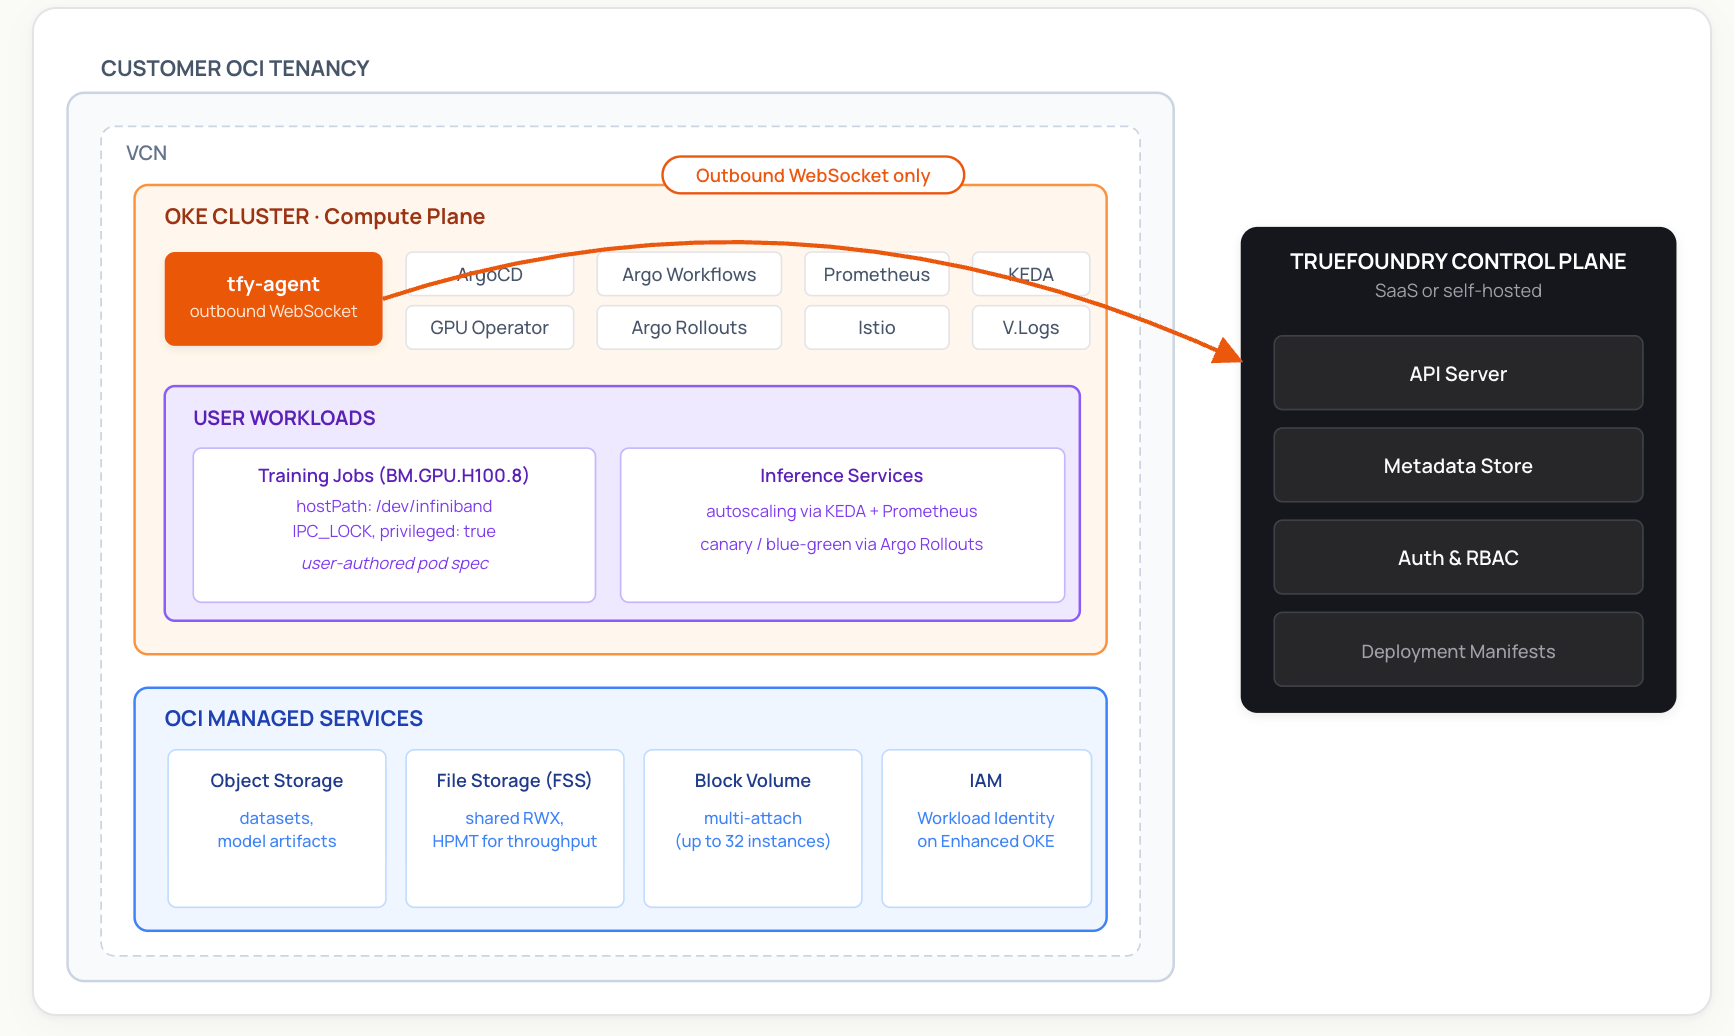
TrueFoundry gebruikt een gesplitste plane-architectuur. Het Control Plane (beheerd door TrueFoundry of self-hosted) bevat metadata, RBAC, de API-server en de deployment manifest store. Het Compute Plane bestaat uit een of meer Kubernetes-clusters in uw eigen cloudomgeving — in dit geval een OKE-cluster op OCI bare-metal. Workloads, modelgewichten en klantgegevens blijven in uw tenancy.
De verbinding tussen beide is de tfy-agent, die op het Compute Plane-cluster draait en een outbound-only WebSocket opent naar het Control Plane. De agent haalt deploymentmanifesten op en stuurt Kubernetes-resource-updates terug. Omdat de verbinding uitgaand is, hoeft u geen inkomende poorten op uw VCN te openen of de cluster-API-server bloot te stellen aan het openbare internet.
Wanneer TrueFoundry een Compute Plane instelt, installeert en beheert de agent een reeks open-source addons via ArgoCD:
U kunt ook uw eigen bestaande instanties van al deze onderdelen meenemen — TrueFoundry documenteert de configuratie die nodig is om samen te werken met een bestaande installatie van ArgoCD, Prometheus of Istio.
Het clusternetwerk van OCI is de onderscheidende netwerklaag die grootschalige gedistribueerde training haalbaar maakt. Oracle heeft interne metingen gepubliceerd die een latentie van één cijfer in microseconden laten zien in deze fabric — zo laag als 2 microseconden voor single-rack clusters, en typisch 2,5 tot 9 microseconden over multi-rack superclusters — met behulp van RoCE v2 over NVIDIA ConnectX SmartNICs. Daadwerkelijke cijfers in productie hangen af van de clustertopologie, berichtgrootte en congestie; Oracle's First Principles-artikelen behandelen het onderliggende ontwerp.
Om RDMA effectief te gebruiken, moeten twee zaken waar zijn:
oci.oraclecloud.com/rdma.local_block_id, network_block_id en hpc_island_id — en de oci-hpc-oke quickstart van Oracle laat zien hoe u deze gebruikt met Kueue's topologie-bewuste scheduling voor de beste NCCL-prestaties. Voor nauw gekoppelde training heeft het de voorkeur om pods binnen hetzelfde Local Block te plaatsen./dev/infiniband/ (de padnaamgeving weerspiegelt de onderliggende IB verbs-API, hoewel het transport RoCE v2 over Ethernet is).Het standaard pod-patroon uit de quickstart van Oracle ziet er als volgt uit:
Deze verhoogde privileges — privileged: true, IPC_LOCK, host-netwerken — zijn specifiek voor HPC/RDMA-workloads. Isoleer deze pods in productie in toegewezen GPU-namespaces met admission policies (bijv. Pod Security Admission ingesteld op privileged in de namespace, restricted elders; of een OPA/Kyverno-policy op basis van een label), zodat niet-gerelateerde workloads niet dezelfde context kunnen overnemen.
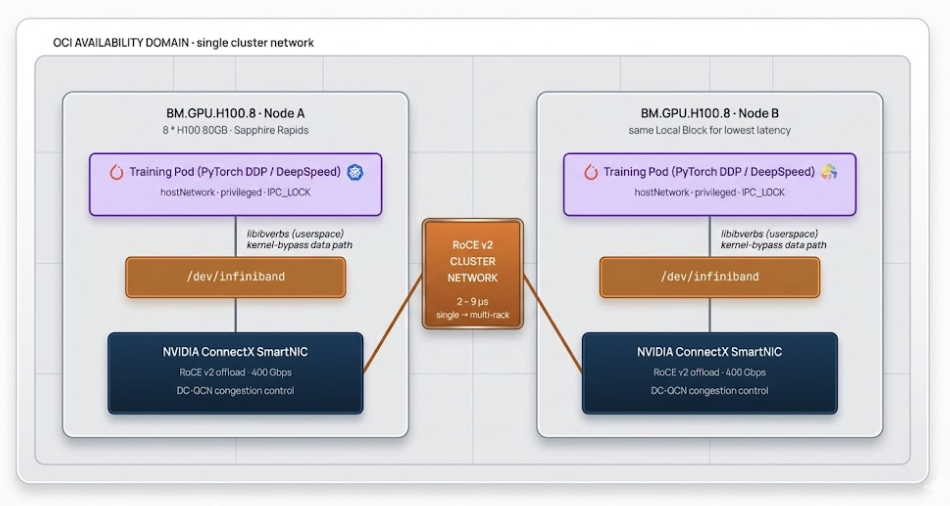
De rol van TrueFoundry hier is om het uitvoeren van deze trainingspods onderdeel te maken van een normale deployment-workflow — u ontwikkelt de workload, het platform pusht deze via Argo Workflows, Prometheus verzamelt GPU-metrieken van de DCGM Exporter die bij de GPU Operator wordt geleverd, en ArgoCD beheert de versie van de manifesten. Signalen op workload-niveau, zoals NCCL-tellers, worden alleen verzameld wanneer de applicatie deze beschikbaar stelt. De RDMA-specifieke onderdelen (hostPath-mounts, IPC_LOCK, topologie-affiniteit) worden geconfigureerd in uw job-specificatie volgens het bovenstaande standaardpatroon; het platform vervangt die velden niet, maar implementeert wat u opgeeft.
Specifiek voor gedistribueerde training over meerdere nodes installeert u doorgaans een operator op het cluster via de bijbehorende helm-chart — MPI Operator voor op MPIJob gebaseerde runs (PyTorch DDP, DeepSpeed, NCCL), Kubeflow Training Operator voor PyTorchJob/TFJob, of KubeRay voor op Ray gebaseerde training. TrueFoundry levert deze standaard niet mee. Eenmaal geïnstalleerd, implementeert het platform MPIJob/PyTorchJob/RayJob-resources net als elke andere Kubernetes-workload, met hetzelfde GitOps- en observability-verhaal. Gedistribueerde training met RDMA op OCI is momenteel geen primaire functionaliteit van TrueFoundry — het is een implementatiepatroon gebaseerd op de gepubliceerde referentiemanifesten van Oracle, waarbij het platform de omringende operationele stack afhandelt in plaats van de RDMA-specifieke orchestratie.
Voor ondersteunde clustertypes adviseert OCI nu OKE Workload Identity boven het distribueren van langdurige API-sleutels naar pods. Het mechanisme werkt vergelijkbaar met AWS IRSA of GKE Workload Identity: een Kubernetes ServiceAccount wordt gekoppeld aan een OCI IAM-policy, en de OCI SDK ruilt het geprojecteerde ServiceAccount-token van de pod om voor een kortstondig OCI-toegangstoken op het moment van de aanroep. Er is geen statische authenticatiegegeven in de pod aanwezig.
Twee belangrijke beperkingen uit de documentatie van Oracle:
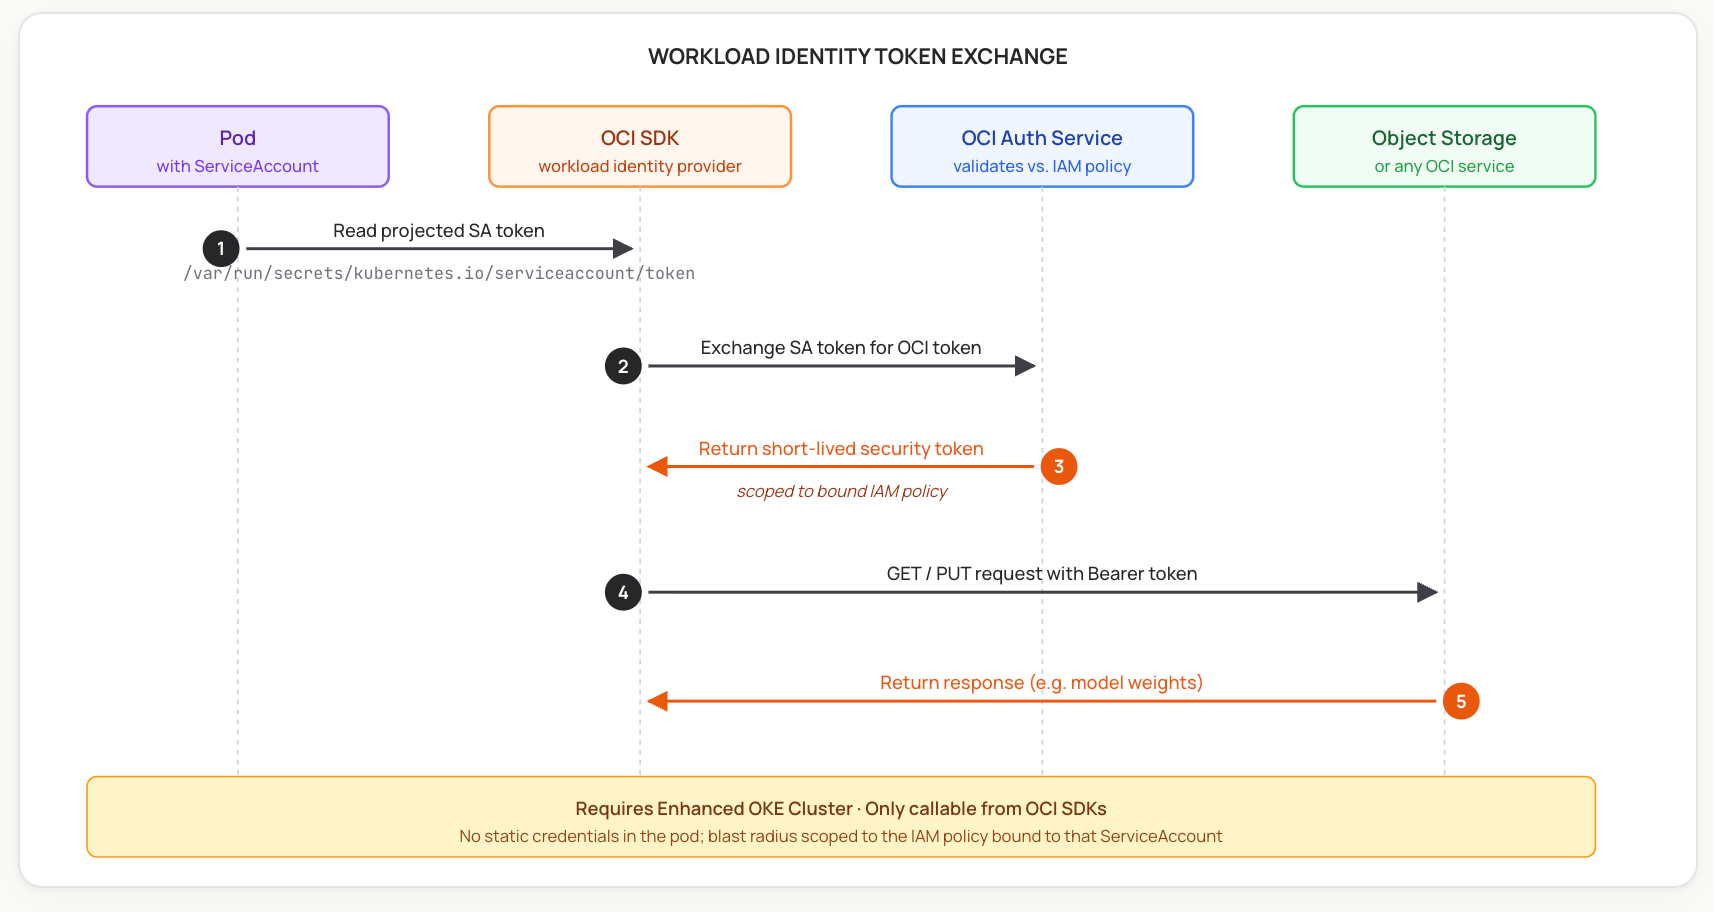
Aan de Kubernetes-zijde worden workloads gebonden aan ServiceAccounts met een namespace-bereik, en het platform kan de aanmaak ervan automatiseren als onderdeel van de deployment-flow. De OCI-zijde — de IAM-policy met de request.principal.type='workload'-regel en de cluster/namespace/serviceaccount-selectors — wordt geconfigureerd volgens de standaard Workload Identity-instelling van Oracle. Zodra beide zijden zijn ingericht, verkrijgen deployments die OCI-toegang nodig hebben transparant kortstondige tokens via de SDK.
OCI bare-metal biedt u verschillende opslagkeuzes om modelgewichten in het VRAM te laden. Elk heeft zijn eigen afwegingen, en de volume-abstracties van TrueFoundry (PVC's, volume mounts, init containers) werken met al deze opties — het juiste patroon hangt af van uw workload:
Het juiste patroon is afhankelijk van de workload. Voor de meeste trainingsruns is lokale NVMe (voor vluchtige warme data) plus FSS (voor gedeelde checkpoints en gewichten) de productie-inrichting. Block Volume multi-attach is een optie voor specifieke gevallen waarin een enkel onveranderlijk artefact er als een lokale schijf uit moet zien voor meerdere lezers.
Het uitvoeren van bare-metal GPU-workloads op ruwe OCI-primitieven is haalbaar — Oracle biedt een op Terraform gebaseerde HPC-stack en de oci-hpc-oke quickstart — maar het betekent wel dat u verantwoordelijk bent voor een aanzienlijke operationele Kubernetes-laag. De onderstaande tabel beschrijft wat TrueFoundry hieraan toevoegt.
Het patroon is consistent: OCI biedt de bare-metal compute- en netwerkprimitieven; TrueFoundry biedt de operationele Kubernetes-laag die er bovenop ligt.
TrueFoundry op OCI is een Kubernetes-native platform dat draait op de bare-metal-stack van Oracle. Het Compute Plane is uw OKE-cluster, de workloads maken gebruik van OCI's RoCE v2-clusternetwerk en Workload Identity via standaard Kubernetes-patronen, en het platform verpakt de open-source en CNCF-geaffilieerde operationele laag — GitOps, observability, autoscaling, GPU operator — in een beheerde uitrol. Het resultaat is minder platform-engineering-overhead om bare-metal GPU-workloads te beheren, waarbij de OCI-specifieke configuratie transparant blijft in plaats van verborgen.
Een praktisch evaluatiepad is een referentie-implementatie op een klein OKE-cluster — doorgaans een of twee BM.GPU-shapes plus een CPU-pool voor de platform-addons — om de architectuur te valideren voordat u opschaalt naar een volledig Supercluster.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















