



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Anthropic introduceerde het Model Context Protocol in november 2024, en binnen een jaar had vrijwel elke API-toolingleverancier en verschillende onafhankelijke generators een manier uitgebracht om mechanisch een OpenAPI-specificatie te converteren naar een werkende MCP-server. De basiskoppeling is grotendeels strak: het pad wordt de toolnaam, parameters worden het invoerschema, de succesrespons wordt het uitvoerschema. De interessante onderdelen zijn waar de koppeling verliesgevend is — paginering, multipart-uploads, webhooks, streaming-responsen — en de operationele stukken die bepalen of de gegenereerde server daadwerkelijk bruikbaar is: auth-injectie, schemavalidatie, beschrijvingskwaliteit. Deze post doorloopt het volledige algoritme en de specifieke patronen die niet één-op-één vertalen.
Dinsdag bij Northwind. Priya, integrations lead van het logistics platform team, krijgt een ticket: "Maak shipment-tracking-svc aanroepbaar door de routing optimizer agent." De service heeft 47 REST-endpoints, een onderhouden OpenAPI 3.1-spec, OAuth2-auth, op cursors gebaseerde paginering, twee webhook-endpoints en een streaming-endpoint voor live vrachtwagentelemetrie. De MCP-gereedschapskist van de agent bevat momenteel 12 tools verdeeld over drie andere services, elk in ongeveer een week handmatig gecodeerd. Zevenenveertig endpoints in dat tempo zou het grootste deel van een kwartaal aan engineeringtijd kosten.
De OpenAPI-spec beschrijft de service al in machineleesbare vorm — paden, parameters, schema's, responsvormen, zelfs de OAuth2-scopes per operatie. Niets van de handmatige code die ze heeft geschreven voegt informatie toe die de spec niet al bevat. Het werk was voornamelijk het vertalen van de ene schemataal naar de andere, met een kleine set goed gedefinieerde randgevallen. Dat werk hoort thuis in een bouwstap, niet in een kwartaal engineering.
Deze post behandelt het conversie-algoritme — wat strak koppelt, wat niet, en de operationele onderdelen (auth, validatie, beschrijvingskwaliteit) die de gegenereerde server daadwerkelijk bruikbaar maken.
De conversie doorloopt het OpenAPI-document en geeft één MCP-tool uit per (pad, methode)-paar. Voor elk paar berekent het vier dingen: de toolnaam, de beschrijving, het invoerschema en (waar de doel-MCP-revisie dit ondersteunt) het uitvoerschema.
Toolnaam. Gebruik bij voorkeur de operationId als de spec-auteur er een heeft opgegeven — operationIds zijn idiomatische identificaties, meestal al gekozen om de leesbaarheid. Indien afwezig, synthetiseer uit methode en pad: zet de methode in kleine letters, voeg het pad toe met niet-alfanumerieke tekens vervangen door underscores, en voeg dubbele underscores samen. GET /users/{user_id}/repos wordt get_users_user_id_repos. De gesynthetiseerde vorm is syntactisch geldig maar erg lang; operationIds winnen waar ze bestaan.
Toolbeschrijving. Gebruik bij voorkeur de samenvatting (summary), dan de beschrijving (description), en daarna een gegenereerde stub van methode + pad. Sectie 6 behandelt waarom dit schijnbaar kleine veld belangrijker is dan menig mens verwacht.
Invoerschema. Een samenvoeging van padparameters, queryparameters en de request-body-schema tot één enkel JSON Schema-object, met de juiste vereiste/optionele markeringen. Details in sectie 2.
Uitvoerschema. Het schema dat is gekoppeld aan de eerste 2xx-respons voor application/json. Andere content-types en niet-2xx-responsen worden niet gerepresenteerd. Details in sectie 3.
YAML — OpenAPI path item (fragment uit shipment-tracking-svc)
JSON — gegenereerde MCP-tool
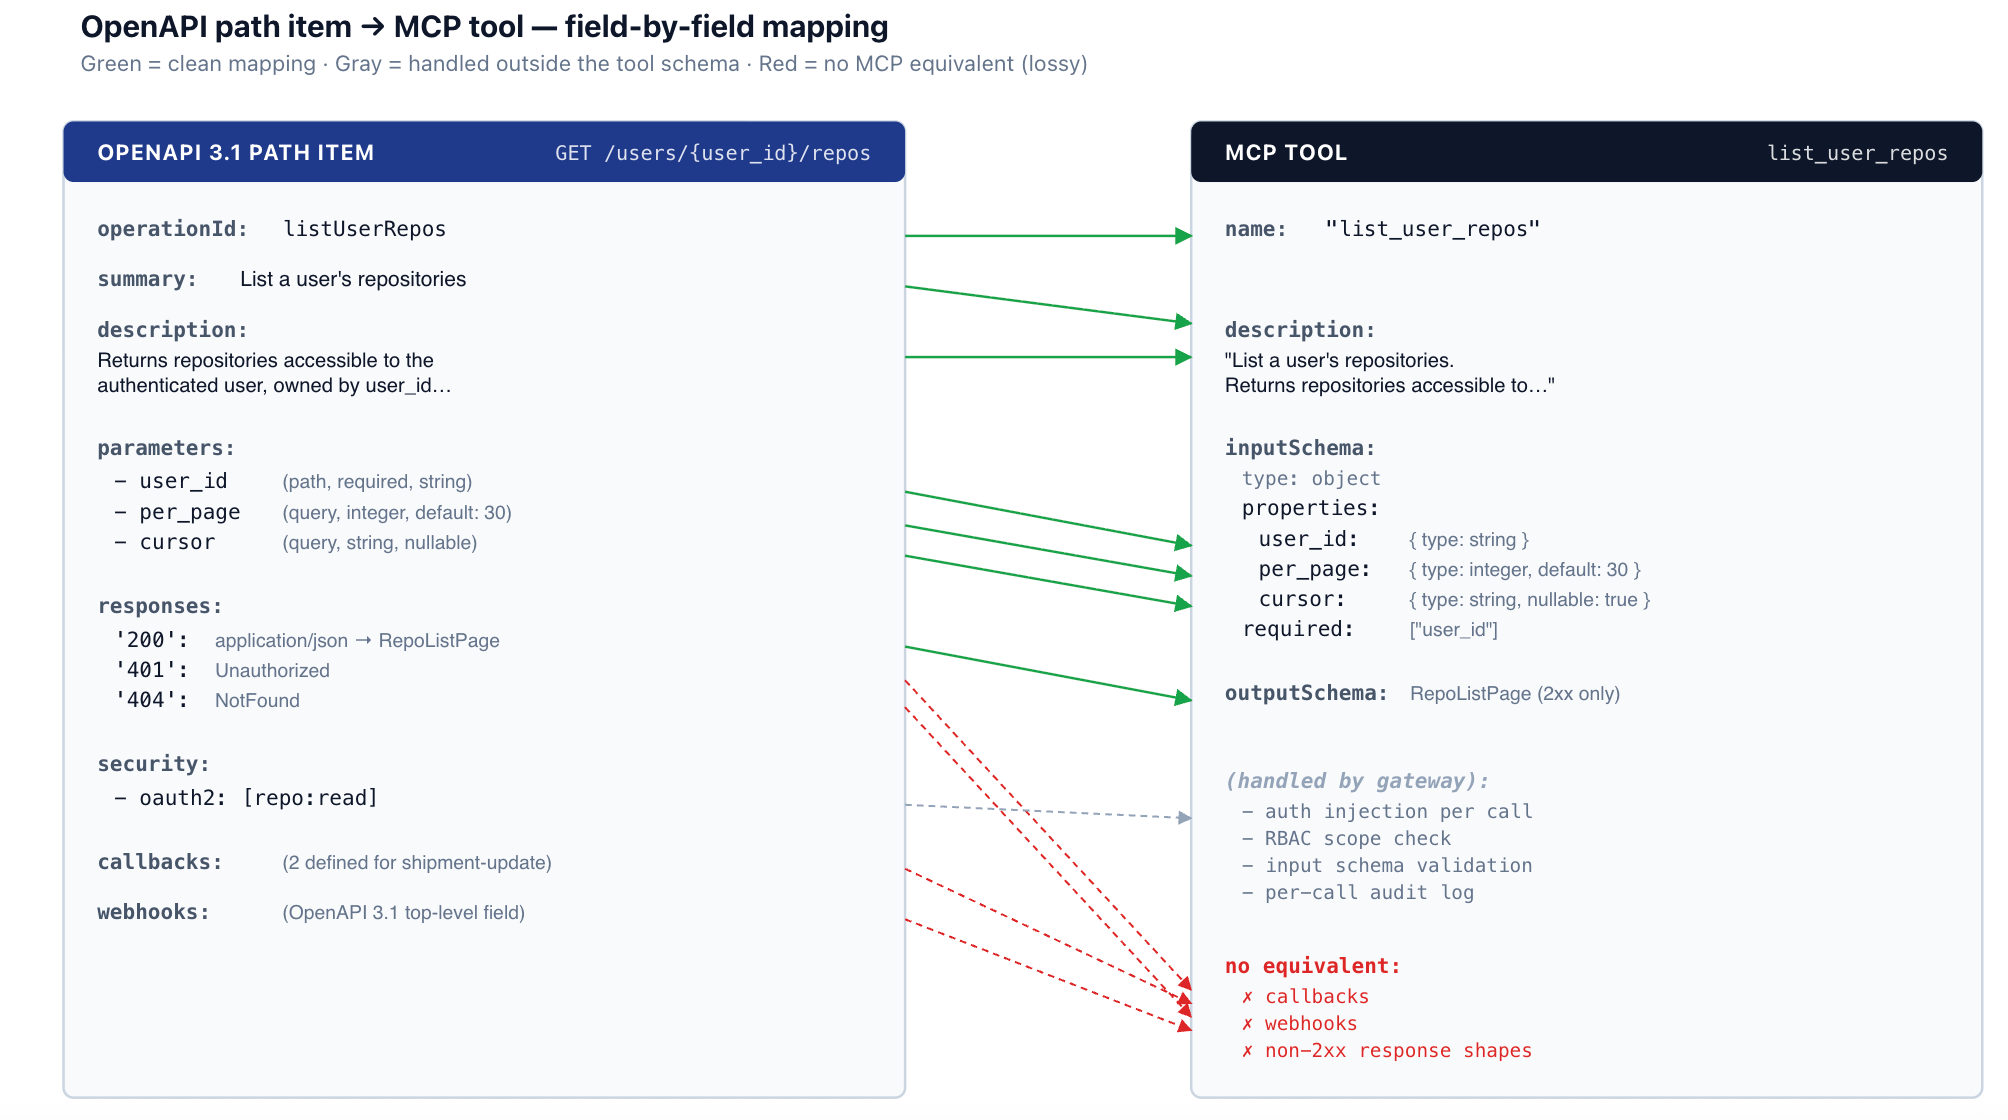
Padparameters zijn altijd verplicht en worden verplichte velden in het invoerschema. Queryparameters zijn optioneel, tenzij expliciet als verplicht gemarkeerd, en eventuele standaardwaarden worden overgenomen. Headers worden meestal weggelaten uit de invoer voor de agent — de agent hoort de Content-Type niet te kiezen — met expliciete uitzonderingen voor headers die semantische informatie overdragen (X-Org-Id, X-Idempotency-Key).
application/json request-bodies worden gekoppeld aan een genest object in het invoerschema. De gehele request-body wordt één gestructureerd argument, typisch vernoemd naar de $ref van de body-schema (dus een request-body die verwijst naar #/components/schemas/CreateRepoRequest wordt een "create_repo_request"-eigenschap). Dit is het strakste geval in de conversie, omdat OpenAPI request-bodies al JSON Schema zijn en het invoerschema JSON Schema is — de conversie is grotendeels een kopieeractie.
multipart/form-data en application/x-www-form-urlencoded zijn het gedeeltelijk ondersteunde geval. MCP-tools accepteren JSON-argumenten; de gegenereerde server moet JSON opnieuw serialiseren naar het juiste body-formaat alvorens door te sturen. Binaire bestandsuploads — de meest voorkomende reden voor multipart — hebben geen strak equivalent: MCP kan base64-gecodeerde strings doorgeven, maar de meeste API's accepteren dat niet op multipart-endpoints. Het eerlijke antwoord voor binaire uploads is dat ze vaak een handmatig gecodeerde tool vereisen in plaats van de gegenereerde.
Alleen de succesrespons wordt blootgesteld als het uitvoerschema van de tool (en alleen waar de doel-MCP-revisie outputSchema überhaupt ondersteunt — het veld is toegevoegd in de spec-revisie van 2025-06-18, dus oudere runtimes negeren het). De conversie kiest de eerste 2xx-respons (200, 201, 202) voor application/json-inhoud. Andere content-types worden niet blootgesteld; niet-2xx-responsen worden aan de agent geretourneerd als toolfouten, niet als alternatieve uitvoervormen.
Dit heeft een subtiel gevolg: de agent ziet de responsvorm van het succespad, nooit de gestructureerde foutresponsvorm. Dat is vrijwel altijd de juiste aanpak — agenten plannen niet nuttig op basis van foutresponsschema's — maar het betekent dat foutafhandeling generiek moet zijn (HTTP-statuscode plus bericht) in plaats van getypeerd. Voor API's met rijke gestructureerde fouten (validatiedetails, gedeeltelijke succesresponsen) gaat hierbij informatie verloren.
Het is ook de plek waar paginering als eerste vastloopt: het uitvoerschema voor een gepagineerd lijst-endpoint is de responsvorm van een enkele pagina, niet het conceptuele resultaat van de volledige lijst. De agent die de tool aanroept krijgt één pagina, niet de lijst — wat leidt tot de volgende sectie.
REST-API's pagineren. MCP-tools retourneren vanwege het protocolontwerp afzonderlijke resultaten. Het afstemmen hiervan is de moeilijkste beslissing bij de conversie. Drie reële opties, elk met verschillende afwegingen:
De meeste generators (inclusief die van TrueFoundry) kiezen standaard voor optie (a). De discipline die het laat werken is de beschrijvingskwaliteit uit sectie 6: de toolbeschrijving moet de pagineringsovereenkomst expliciet uiteenzetten, waarbij de cursor-parameter wordt genoemd en de instructie "roep opnieuw aan met next_cursor voor meer" vermeld staat. Zonder dat nemen agenten steevast de eerste pagina en beschouwen ze de taak als voltooid.
Optie (b) is af en toe de juiste keuze — kleine begrensde datasets waarbij de agent de hele lijst daadwerkelijk nodig heeft (een configuratietabel van 50 rijen, een vaste lijst met regio's) — maar is meestal verkeerd voor al het andere. Optie (c) verschijnt in domeinen waar de semantiek van de volgende pagina niet-triviaal is (verval van cursor, snapshot-isolatie), waar de expliciete scheiding de grotere tool-oppervlakte waard is.
De gegenereerde MCP-server voert HTTP-requests uit naar de onderliggende API; die requests hebben inloggegevens nodig. De architectonische regel: de gegenereerde server bezit geen inloggegevens. Ze bevinden zich in de gateway, en de gateway injecteert ze op het moment van aanroepen.
De keten, op volgorde:
Auth-injectieketen voor een toolaanroep naar shipment-tracking-svc
Dit is het gateway-patroon uit eerdere artikelen in deze serie toegepast op een specifiek type MCP-server. De ontkoppeling is wat de gegenereerde server stateless en vervangbaar maakt — het is een zuivere transformatie, waarbij inloggegevens, RBAC, audit-logging en rate-limiting zich een laag hoger bevinden.
Automatisch gegenereerde beschrijvingen zijn syntactisch geldig en semantisch waardeloos. "Get users user id repos" is wat een synthesizer produceert voor GET /users/{user_id}/repos wanneer de OpenAPI-spec geen summary of description bevat. In de praktijk maken agenten vaak slechtere toolselecties bij dergelijke beschrijvingen — ze kiezen de verkeerde tool, vullen verkeerde argumenten in, of slaan de tool over terwijl het de juiste was. Het effect is het meest zichtbaar bij toolvoorraden waar meerdere endpoints vergelijkbare vormen hebben en het model op de beschrijving moet vertrouwen om het verschil te bepalen.
De conversiepijplijn kan dit in drie stappen verbeteren:
Ten eerste, geef de voorkeur aan de summary- en description-velden van OpenAPI. Goede spec-auteurs schrijven deze goed; ze gebruiken kost niets.
Ten tweede, als de summary ontbreekt of niet helpt, pas dan een LLM-verbeteringsstap toe: voer het pad, de methode, parameters, het responsschema en eventuele docstrings in bij een goedkoop model en vraag om een agent-vriendelijke beschrijving. "Retrieve all repositories accessible to the authenticated user, owned by a specified user ID, paginated 30 per page by default; returns repository metadata including name, owner, primary language, and last-update timestamp." Tegen Claude Haiku 4.5-prijzen (ongeveer $1 per miljoen invoertokens, $5 per miljoen uitvoer) bedraagt de verbetering ongeveer $0.0005 per tool en hoeft deze alleen te draaien wanneer de spec verandert.
Ten derde, voeg voorbeelden toe in de beschrijving voor niet-evidente argumenten. Formaat-strings, ID-conventies en enum-waarden hebben vaak een voorbeeld nodig om ondubbelzinnig te zijn. "user_id is the numeric user ID (e.g., '12345'), not the username."
De prijs van een verkeerde aanpak betaal je elke keer dat de agent draait. De prijs van het goed doen betaal je eenmalig op het moment van genereren en wordt daarna afgeschreven over elke toolaanroep.
Automatische generatie maakt de kwaliteit van de spec bepalend voor de kwaliteit van de conversie. Veelvoorkomende praktijkproblemen, ongeveer in de volgorde waarin ze opspelen:
Geen van deze zaken zijn conversiebugs — het zijn spec-bugs die getrouw door de conversie worden overgenomen. De pragmatische reactie is om OpenAPI-naar-MCP-generatie te zien als een aanjager van spec-kwaliteit: de eerste hergeneratie van een slecht onderhouden spec levert een slechte MCP-server op, wat meestal snel zichtbaar is, wat vaak voldoende motivatie vormt om de spec te herstellen. De conversie maakt spec-kwaliteit waarneembaar op een manier die intern gebruik van het OpenAPI-document alleen vaak niet doet.
Een naïeve één-endpoint-per-tool-conversie van een grote API levert een toollijst op die op zichzelf een probleem wordt. Een API met 500 endpoints levert een MCP-server met 500 tools op; het laden van die toolvoorraad in de context van de agent verbruikt tienduizenden tokens voordat de agent iets nuttigs heeft gedaan, en de nauwkeurigheid van de toolselectie door het model neemt naar verluidt af naarmate het aantal beschikbare tools groeit. De shipment-tracking-svc die Priya converteert heeft 47 endpoints, wat beheersbaar is; een grote publieke REST-oppervlakte (Stripe, GitHub, AWS) in haar geheel genereren is dat niet.
Vier praktische strategieën, die meestal worden gecombineerd:
Filteren op operatorniveau bij registratie. Met de meeste generators (inclusief die van TrueFoundry, en de openapi-mcp-generator CLI gebruikt hiervoor OpenAPI x-mcp-extensies) kan de operator kiezen welke endpoints worden blootgesteld. De standaardoptie "alles in de spec" is boven een paar dozijn endpoints zelden de juiste.
Groepeer op basis van tags. OpenAPI-tags koppelen aan logische groeperingen; de gateway kan één MCP-server per tagset blootstellen ("shipment-tracking-reads" voor de alleen-lezen-operaties, "shipment-tracking-admin" voor de destructieve). Dit sluit natuurlijk aan bij RBAC per tool — de lezende agent ziet alleen de reads-server.
Virtuele MCP-servers (het patroon van TrueFoundry, vergelijkbare concepten elders). Een logische server die een samengestelde subset van tools aggregeert over meerdere fysieke MCP-servers. De agent ziet een kleine, taakspecifieke toolvoorraad ("billing-agent-tools" die 12 tools blootstelt afkomstig van Stripe, de interne facturatieservice en het CRM) in plaats van de verzameling van elke backend.
Dynamische discovery. De agent laadt niet vooraf de volledige toollijst. In plaats daarvan stelt de gateway een meta-tool beschikbaar die de agent kan aanroepen om tools te zoeken of te filteren op beschrijving, waarbij alleen de relevante subset voor de taak wordt geretourneerd. Dit is complexer om te implementeren en om te beredeneren — de agent moet nu slim omgaan met discovery — maar het schaalt verder dan welke statische filterstrategie dan ook.
De juiste combinatie hangt af van de use-case. Een gericht agent-platform per team gebruikt doorgaans operator-filtering + virtuele MCP-servers en vermijdt dynamische discovery. Een agent voor algemeen gebruik waarvan wordt verwacht dat hij werkt over de gehele tool-oppervlakte van het platform, heeft uiteindelijk dynamische discovery nodig omdat geen enkele statische selectie klein genoeg is.
Een niet-uitputtende lijst van wat OpenAPI beschrijft waar MCP, vanaf medio 2026, geen strak equivalent voor heeft:
Het eerlijke patroon over al deze punten: wanneer een OpenAPI-functie geen MCP-equivalent heeft, moet de conversie het endpoint weglaten en niet stilzwijgend een kapotte tool genereren. De meeste productie-generators (inclusief die van TrueFoundry) vlaggen deze op het moment van conversie en vereisen expliciete actie van de operator om de betrokken operaties over te slaan of handmatig te coderen.
Elke toolaanroep naar de gegenereerde MCP-server passeert de gateway. De gateway valideert de aanroepargumenten tegen het invoerschema voordat ze worden doorgestuurd naar de server, waardoor drie klassen van fouten vroegtijdig worden opgevangen: type-mismatches (string waar integer vereist is), ontbrekende verplichte velden (agent liet een verplichte padparameter weg) en enum-schendingen (agent gaf een waarde door die niet in de enum-set zit).
De validatiefout wordt aan de agent geretourneerd in een gestructureerde vorm waar deze over kan redeneren, niet als een ruwe 400 van de onderliggende API:
JSON — validatiefout geretourneerd aan de agent bij een verkeerde toolaanroep
Waarom bij de gateway en niet in de gegenereerde server? Twee redenen. Ten eerste, consistentie — elke MCP-server, gegenereerd of handmatig gecodeerd, krijgt hetzelfde validatiegedrag. Ten tweede kan de gateway validatiebeleid toepassen (strikt vs. mild, aangepaste foutformattering) zonder gegenereerde code te wijzigen. De gegenereerde server blijft het meest eenvoudige ding: een gevalideerd request komt binnen, een HTTP-aanroep gaat eruit, een respons komt terug.
Moeten we een generator gebruiken? Waarom coderen we de MCP-server niet handmatig?
Voor API's met minder dan ongeveer tien endpoints, of waar de gegenereerde tools aanzienlijke nabehandeling nodig hebben (aangepaste argumentnamen, samengevoegde endpoints, complexe zakelijke logica), kan handmatig coderen redelijk zijn. Daarboven is de gegenereerde server meestal goedkoper te onderhouden — wanneer de API een endpoint toevoegt, pakt hergeneratie dit automatisch op. Handmatig gecodeerde servers gaan afwijken.
Hoe doen we aan versiebeheer voor de gegenereerde server?
De gegenereerde server is een build-artefact, geen broncode die je bewerkt. Genereer opnieuw bij elke OpenAPI-specwijziging, idealiter in CI. Toolnamen blijven stabiel zolang operationIds dat blijven, wat de discipline is die spec-auteurs sowieso moeten aanhouden. Langlopende agenten die de vorige toollijst hebben gecachet, zien updates bij hun volgende MCP-discovery-aanroep.
Hoe zit het met API's die geen OpenAPI-spec hebben?
Het moeilijke geval. Drie reële opties, geen van allen ideaal. (a) Genereer de spec op basis van geobserveerd verkeer of uit SDK-broncode — verschillende tools doen dit met wisselende nauwkeurigheid. (b) Sla conversie over en codeer de MCP-server rechtstreeks handmatig. (c) Schrijf de OpenAPI-spec handmatig. Optie (c) is meer werk dan (b) voor een kleine API en minder voor een grote, met het bijkomende voordeel dat er een OpenAPI-spec ontstaat die de rest van de organisatie kan gebruiken.
Hoe verhoudt dit zich tot het toewijzen van kosten per trace in de AI-gateway?
Elke toolaanroep via de MCP-gateway verzendt een OTel-span die de team- en app-metadata uit eerdere artikelen in deze serie draagt. Tool-latency, succespercentage en eventuele kosten die zijn gekoppeld aan de onderliggende API worden toegewezen aan de aanroepende agent en het team.
Wat is de juiste granulariteit voor de auth-scope van de generator?
Per tool. De beveiligingsvereisten per operatie van de OpenAPI-specificatie worden vertaald naar een lijst met OAuth2-scopes (of andere authenticatieschema's), en de gateway dwingt deze af op het niveau van tools, niet per server. Een agent met read-scope op de repos-endpoints maar zonder write-scope kan list_user_repos aanroepen, maar niet delete_repo.
Waar past TrueFoundry in dit plaatje?
TrueFoundry's MCP Gateway wordt geleverd met een OpenAPI-naar-MCP-generator die draait in het control plane van de gateway. Conversie vindt plaats op het moment van registratie; de gegenereerde server draait als een beheerde proxy waar de gateway naartoe routeert. De authenticatie-injectieketen, schemavalidatie, RBAC en audit logging die in dit bericht worden beschreven, zijn gateway-primitieven die de gegenereerde server erft door achter de gateway te staan — dezelfde primitieven die gelden voor elke andere MCP-server die erbij is geregistreerd. De generator is een van de verschillende productieopties (Speakeasy, Stainless, FastMCP en een handvol open-source equivalenten doen soortgelijke conversies); de keuze komt meestal neer op waar de resulterende server wordt gehost, hoe deze integreert met de bestaande authenticatie en observability van het team, en wat het team al gebruikt.
Zevenenveertig endpoints tegen één ingenieursweek per stuk is het grootste deel van een kwartaal aan engineering. Zevenenveertig endpoints via een generator is een build-stap. Het werk dat overblijft — het cureren van beschrijvingen, het bepalen van de pagineringsstrategie per endpoint, het handmatig coderen van het halve dozijn operaties dat niet vertaalt — is reëel maar begrensd. De mechanica is niet waar de engineering naartoe zou moeten gaan.
Northwind, Priya en shipment-tracking-svc zijn ter illustratie; de conversie-architectuur, mappingsregels en randgevallen weerspiegelen hoe productie OpenAPI-naar-MCP-generatoren (die van TrueFoundry, Speakeasy, Stainless, FastMCP en verschillende open-source equivalenten) daadwerkelijk werken vanaf mei 2026. De OpenAPI- en MCP-specificaties blijven zich ontwikkelen; mappings voor nieuwere functies (OpenAPI webhooks, MCP elicitations, MCP tool-annotaties zoals readOnlyHint) kunnen in toekomstige revisies veranderen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















