



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het begon met een idee: laat een AI-agent een onderzoekstaak met meerdere stappen afhandelen. Verbind hem via MCP met een paar tools, geef hem toegang tot de juiste databronnen en laat hem draaien.
Wat er in werkelijkheid gebeurde, was een stuk leerzamer. De agent had meer toegang dan de taak vereiste. Hij riep tools aan in sequenties die niemand had voorzien, en er waren geen logs om uit te leggen wat hij had aangeraakt of waarom.
Datzelfde token dat de demo liet werken, had de gedeelde schijf van het bedrijf kunnen wissen als het model ging hallucineren of een kwaadaardige prompt tegenkwam in het document dat het moest lezen.
Dit is de fundamentele uitdaging van MCP security. Nu het Model Context Protocol de standaard wordt voor het verbinden van LLMs met externe tools en databases, vereist het beveiligen van deze verbindingen strikte beveiligingsmaatregelen.
Deze gids legt uit waarom traditionele API security faalt voor AI-agents, hoe de daadwerkelijke attack vectors eruitzien en wat Zero Trust in deze context betekent. Het belicht ook hoe sommige platforms een toeslag vragen voor beveiligingsfuncties die standaard zouden moeten zijn.
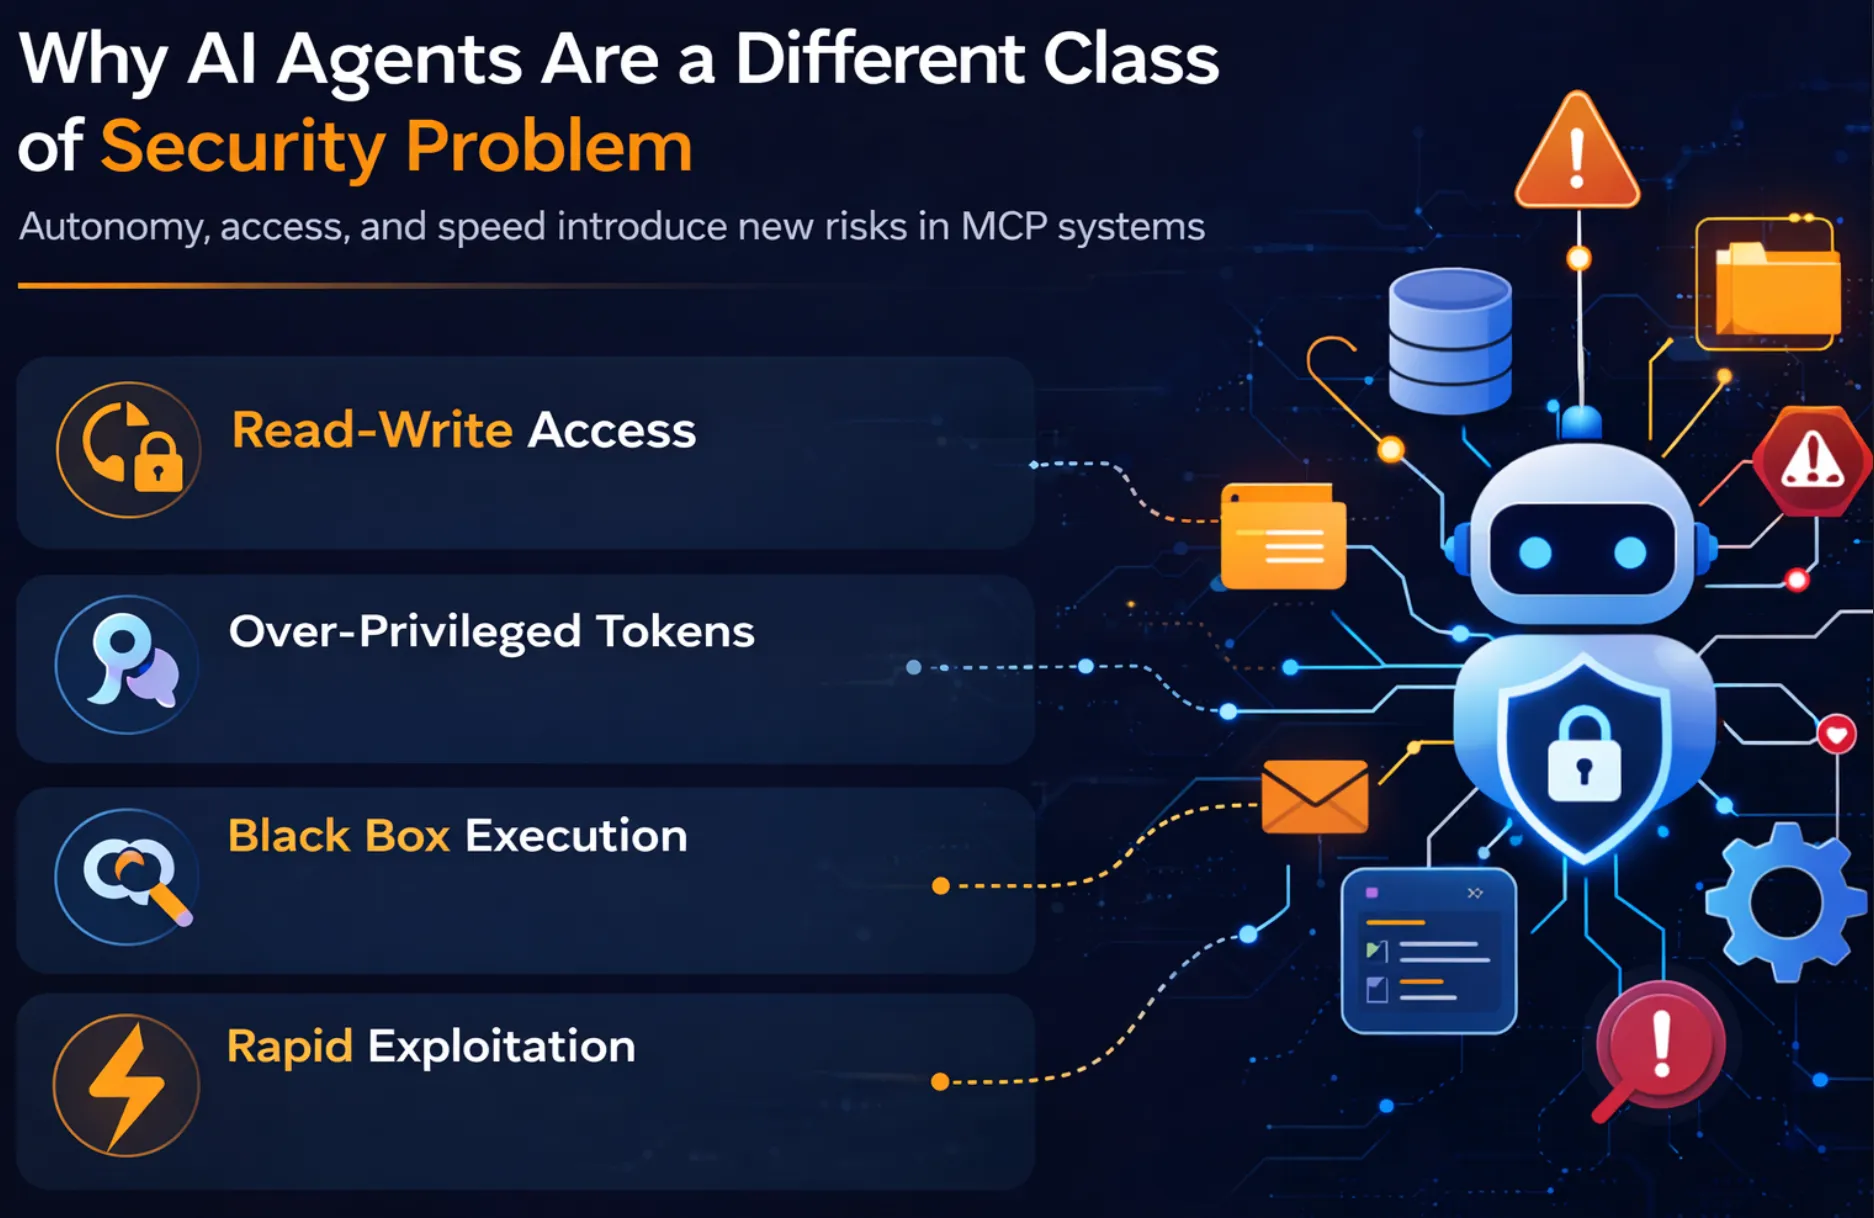
In tegenstelling tot traditionele software die deterministische workflows uitvoert, nemen AI-agents dynamische beslissingen over welke MCP-tools ze gebruiken en hoe ze die gebruiken. Deze autonomie verandert hoe risico's zich verspreiden door MCP-omgevingen en introduceert nieuwe vormen van blootstelling die invloed hebben op uw beveiligingsstatus.
De AI-agents brengen een nieuw type risico met zich mee dat fundamenteel verschilt van traditionele softwaresystemen. Hun unieke combinatie van autonomie, toegang en snelheid creëert unieke beveiligingsrisico's, vooral in op MCP gebaseerde systemen.
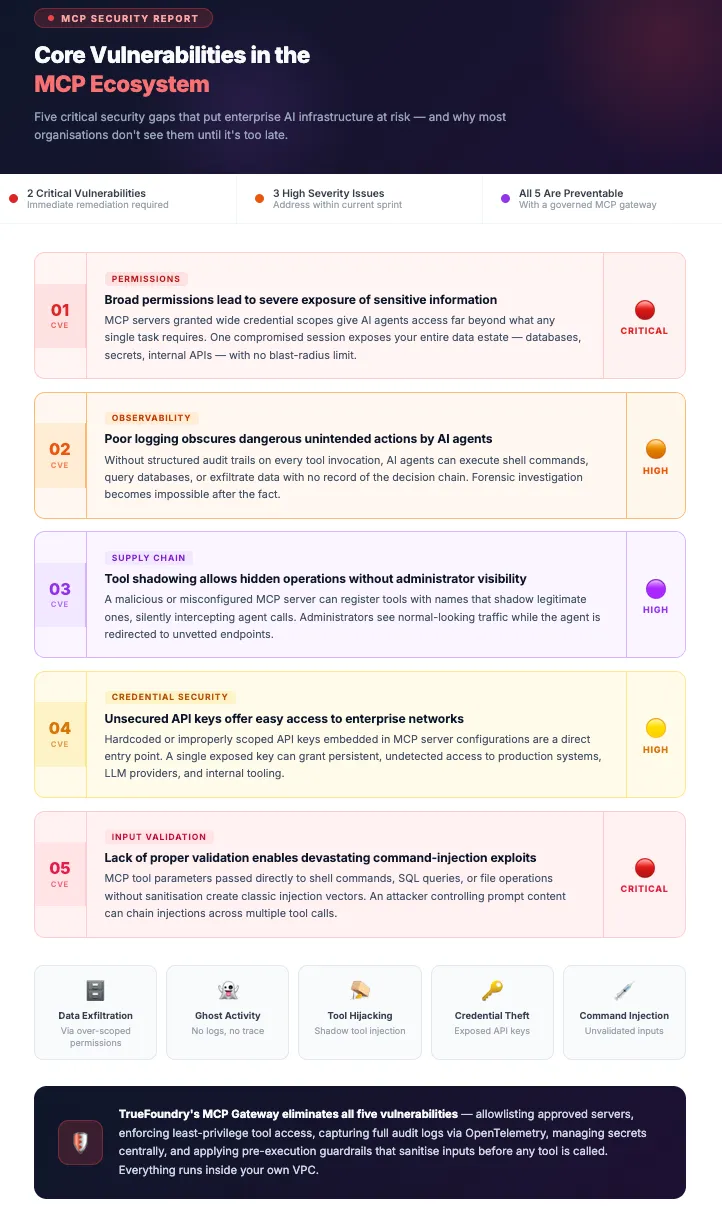
Het Model Context Protocol maakt krachtige tool-orkestratie mogelijk, maar het creëert ook nieuwe aanvalsvlakken via prompts, tool-metadata en agent-uitvoeringsstromen. In tegenstelling tot traditionele API's interpreteren agents instructies en metadata dynamisch, wat subtiele manipulatie veel gevaarlijker maakt.
De onderstaande secties beschrijven de belangrijkste attack vectors die worden geïntroduceerd door systemen met MCP-ondersteuning.
Prompt injection is niet nieuw, maar MCP tilt het naar een grotere schaal. Omdat de agent verbinding maakt met live tools, kunnen kwaadaardige prompts, zelfs binnen externe inhoud, echte acties activeren. De aanvaller voegt kwaadaardige instructies toe aan een document, webpagina of API-respons die de agent verwerkt.
De agent verwerkt de instructies als legitiem en handelt ernaar, onbewust van het feit dat ze van een kwaadaardige bron afkomstig zijn. Deze indirect prompt injection is een ernstige bedreiging voor MCP-implementaties.
Terwijl teams zich richten op het beveiligen van het datagebruik door de agent, richten weinigen zich op het beveiligen van de tool zelf. Tool poisoning vindt plaats op het niveau waar de agent het meeste vertrouwen heeft. De aanvaller manipuleert de tool-beschrijvingen, parameterschema's of tool-manifesten, waardoor de agent kwaadaardige functie-aanroepen doet die vermomd zijn als legitieme aanroepen.
De agent vertrouwt de tool-metadata, en dat is waar de misbruik plaatsvindt, wat aanzienlijke beveiligingsrisico's oplevert voor de onderneming.
Het risico is niet alleen de kwaadaardige tool-aanroep, maar het aan elkaar koppelen (chaining) ervan. Agents koppelen meerdere tools aan elkaar om een gegeven taak uit te voeren, waarbij exfiltratie van gegevens optreedt bij open permissies.
Een agent met directe toegang tot interne klantgegevens en externe zoekfunctionaliteit op het web kan worden misbruikt om interne gegevens samen te vatten en deze via zoekopdrachten naar buiten te sturen.
Er is geen specifieke "verstuur data naar buiten"-opdracht nodig; de agent wordt misbruikt via legitieme tool-combinaties, waardoor gevoelige systemen gevaar lopen.
De vertrouwensgrens is uitgebreid met georkestreerde multi-agent-systemen. Elke interactie tussen agents is een potentieel punt voor injection-aanvallen, aangezien de context van de ene agent naar de andere wordt doorgegeven.
In systemen waar agents informatie doorgeven, geeft een gecompromitteerde upstream MCP-client valse context door aan de gedeelde status.
De downstream agent behandelt de gecompromitteerde context als vertrouwd en zet de verspreiding voort zonder interactie met de oorspronkelijke gebruiker, wat de bedrijfsvoering verstoort.
Hoewel credential hygiene een bekend probleem is, introduceren MCP-systemen nieuwe drukpunten. De snelheid van prototyping bij agents gaat sneller dan beveiligingspraktijken, en statische tokens in config-bestanden worden daarvan de dupe.
MCP-systemen bevatten regelmatig hardcoded cloud-credentials in config-bestanden die zich verspreiden naar versiebeheersystemen en -omgevingen.
Statische tokens zonder rotatie en zonder afgebakende scope behoren tot de meest gedocumenteerde kwetsbaarheden in de MCP-architectuur.
Conventionele API-beveiligingsmodellen vertrouwen sterk op perimeterverdediging en getrouwde interne actoren. Agents met MCP-ondersteuning werken anders: ze roepen tools dynamisch aan en koppelen acties over verschillende systemen heen. Deze verschuiving vereist een Zero Trust security model waarbij identiteit, toegang en uitvoering continu worden geverifieerd.
Naarmate de adoptie van MCP groeit, is er een nieuwe categorie tooling ontstaan rond het beveiligen van de toegang van agents tot tools en data. Veel leveranciers verpakken fundamentele beveiligingsmogelijkheden echter als premiumfuncties, wat operationele en financiële drempels opwerpt voor teams die AI-systemen in productie nemen.
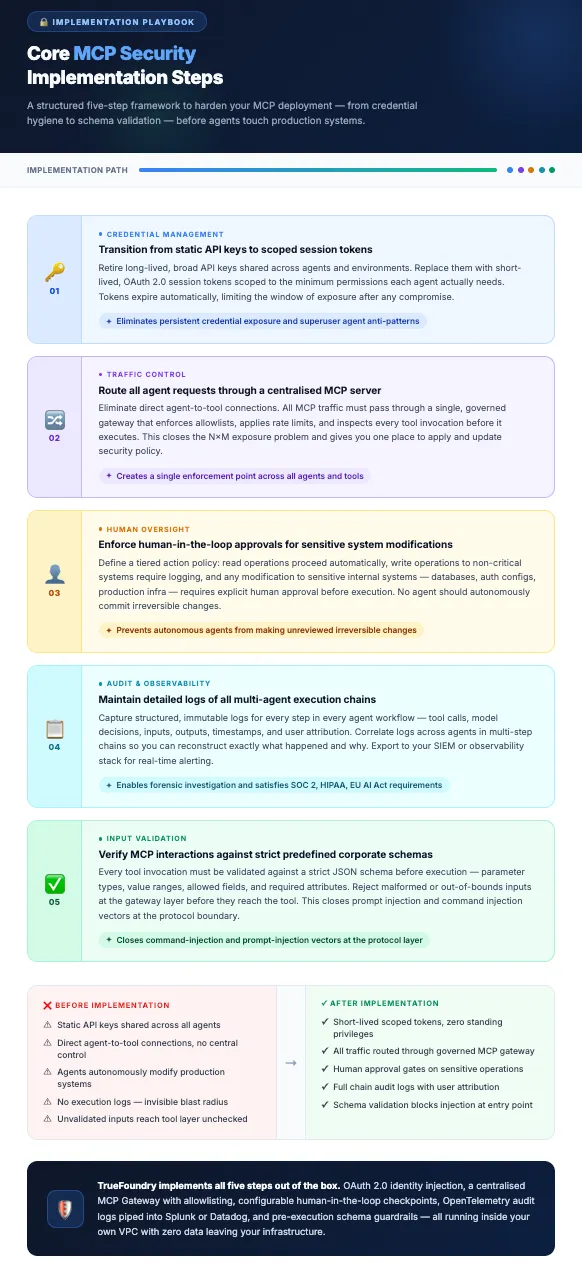
TrueFoundry is een enterprise AI-platform dat is ontworpen om beveiligingsteams te helpen bij het veilig bouwen, implementeren en beheren van AI-systemen in productie. Naarmate organisaties agents op basis van MCP omarmen, biedt TrueFoundry de infrastructuur die nodig is om governance, identiteit en toegangscontrole af te dwingen bij alle interacties.
Het platform integreert Zero Trust MCP security direct in de uitvoeringslaag, zodat teams agents kunnen uitrollen zonder afzonderlijke security gateways of enterprise add-ons toe te voegen.
De snelheid van de MCP-adoptie is zo hoog dat de meeste teams onder druk werken, en onder druk neemt men afsnijroutes. Een demo werkt, de agent is functioneel, en governance is een functie die later wordt toegevoegd — wat zelden kosteloos gebeurt.
Het probleem is structureel. Wanneer een agent autonoom aanroepen kan doen tussen interne systemen en externe API's, kan geen enkele vorm van governance op prompt-niveau een gateway compenseren die nooit voor deze realiteit is ontworpen. U beveiligt niet zomaar een verzoek; u beveiligt een besluitvormingsproces dat tientallen acties kan uitvoeren voordat er überhaupt een resultaat aan een mens wordt gepresenteerd.
De teams die spijt krijgen van hun MCP-adoptie zijn niet de teams die te snel gingen. Het zijn de teams die geloven dat hun bestaande beveiligingsstack zich zonder ingrijpende wijzigingen zal aanpassen. API Gateways begrijpen traditioneel geen tool-schema's. Auth-modellen waren traditioneel niet ontworpen voor on-behalf-of-scenario's met autonome agents. En betaalmuren voor enterprise-klanten waar basisrolgebaseerde toegangscontrole een premiumfunctie is, zijn geen beveiligingsmodel; het is een verdienmodel.
Zero Trust voor MCP is geen vinkje; het is een overtuiging. Elke afzonderlijke tool-aanroep wordt geverifieerd, elke afzonderlijke agent-actie wordt vastgelegd en elke afzonderlijke permissie is gebaseerd op de gebruiker die de workflow is gestart. Het verschil tussen teams die dit meteen goed doen en teams die dat pas doen na een datalek, is simpelweg of governance vanaf dag één een kernonderdeel van de gateway was. TrueFoundry maakt dit de standaard, niet een optionele functie.
MCP security omvat mechanismen die regelen hoe AI-agents toegang krijgen tot tools via het Model Context Protocol. Omdat MCP dynamische toegang tot tools mogelijk maakt, moet beveiliging verder gaan dan basis API-bescherming. Het omvat identiteitspropagatie, schemavalidatie en audit trails. TrueFoundry biedt dit via een centrale gateway die identiteit, beveiligingscontroles en uitvoeringslogs beheert.
MCP security brengt risico's met zich mee omdat agents dynamisch met API's communiceren. Beveiligingsrisico's omvatten prompt injection-aanvallen, manipulatie van tool-schema's en over-geprivilegieerde service tokens. Multi-agent pipelines kunnen gecompromitteerde context verspreiden over gevoelige systemen. Om deze bedreigingen te beperken, moeten tool-aanroepen worden geverifieerd en op identiteit gebaseerde rechten worden afgedwongen. TrueFoundry biedt een veilige gateway om deze interacties te beheren.
MCP is een neutraal protocol dat standaardiseert hoe AI-modellen met tools communiceren. Of het veilig is, hangt af van de toegepaste beveiligingsmaatregelen. Agents kunnen verhoogde rechten krijgen en toegang verkrijgen tot private databases. Door echter een robuuste beveiligingsinfrastructuur te bieden, zoals de gateway van TrueFoundry, kan het protocol veilig worden geïmplementeerd om te voorkomen dat bedrijfsmiddelen worden blootgesteld.
Zero Trust gaat ervan uit dat geen enkele entiteit vertrouwd is. Voor een AI-agent die MCP gebruikt, betekent dit dat alle tool-aanroepen moeten worden geauthenticeerd en geverifieerd vóór uitvoering om een kwaadaardige server te stoppen. Agents moeten uitvoeren met dezelfde rechten als de initiërende gebruiker. TrueFoundry dwingt Zero Trust af door identiteitspropagatie te vereisen en alle tool-aanroepen te monitoren.
Een confused deputy-aanval vindt plaats wanneer een AI-agent met hoge privileges wordt misleid om acties uit te voeren namens een kwaadwillende, wat kan leiden tot datalekken. Omdat de AI-agent over geldige privileges beschikt, merkt het systeem de aanval mogelijk niet op. Het voorkomen hiervan vereist het beperken van agent-privileges en het valideren van de uitvoer van tool-aanroepen.
Conventionele API gateways verwerken deterministische aanroepen waarbij de eindpunten bekend zijn. Agents op MCP-basis gedragen zich anders: ze ontdekken tools en maken dynamisch parameters aan. Beveiliging moet worden afgedwongen op het niveau van het tool-schema, niet alleen op netwerkniveau, om kwaadaardige code te blokkeren. TrueFoundry breidt traditionele gateways uit om te voldoen aan nieuwe beveiligingsbehoeften rondom MCP.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















