
True ML Talks #1 - Machine Learning Workflow @ Gong

Gebouwd voor snelheid: ~10ms latentie, zelfs onder belasting
De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
- Verwerkt 350+ RPS op slechts 1 vCPU — geen tuning nodig
- Productieklaar met volledige enterprise-ondersteuning
Vandaag lanceert TrueFoundry een Machine Learning Deep Dive Series waarin we spreken met ML- en Data Science-leiders van bedrijven die ML gebruiken, om dieper in te gaan op de use cases en workflows van ML binnen hun organisaties. Als onderdeel van deze serie organiseren we sessies waarin we dieper ingaan op de ML Stack van bedrijven zoals Gong, StichFix, SalesForce, Gusto, Simpl en vele anderen.
📌
In deze serie duiken we in de wereld van Machine Learning om het spectrum van ML-toepassingen en infrastructuur-setups in verschillende sectoren te onthullen.
Onze gesprekken zullen draaien om vier centrale thema's:
1. Machine Learning use cases voor de organisatie
2. Hoe zij hun Machine Learning stack hebben gebouwd, inclusief Training en Experimentation Pipeline, Deployment en Serving, Monitoring, en hoe zij deze onderweg hebben geoptimaliseerd voor Cost/Latency
3. Uitdagingen bij de opbouw van de ML stack, met name sectorspecifieke uitdagingen
4. Een overzicht van baanbrekende innovaties die zijn toegepast tijdens het bouwen en schalen van de ML-infrastructuur.
Om de eerste discussie van de serie af te trappen, spraken we met Noam Lotner van Gong. Gong is een Revenue Intelligence-platform. Het stelt Revenue-teams in staat hun volledige potentieel te benutten door de klantsituatie te onthullen uit de gesprekken van het salesteam. Gong analyseert klantgerichte interacties via telefoon, e-mail, web, enz., om de beste inzichten te leveren voor salesteams, zodat zij deze kunnen gebruiken om meer deals te sluiten.
Noam Lotner is Research Operations Team Lead bij Gong. Hij bouwt het operationele platform voor de AI/ML-researchgroep – het automatiseren van model-releaseprocessen, experimentbeheer en performancetests, het bouwen van labeling- en datasetcreatietools, en het mogelijk maken van veilige toegang tot productie-databronnen.
Bekijk ons gesprek hieronder:
Waarom ML belangrijk is voor Gong: een Sales Intelligence Platform
Gong analyseert klantgerichte interacties via telefoon, e-mail, web, enz. Machine Learning is essentieel om verkoopinteracties te analyseren en inzichten te bieden aan Revenue Teams. ML-algoritmen kunnen taken automatiseren die voorheen handmatig werden uitgevoerd, zoals het analyseren van videocalls, het transcriberen en analyseren van verkoopgesprekken. Dit bespaart tijd en verbetert de efficiëntie van het verkoopproces.
- Video Call Analysis Pipeline → Om gesprekken te analyseren, verwerkt het team de video, classificeert de frames en voert het verwerkingen uit op specifieke typen videosegmenten.
- Audio Transcript Analysis Pipeline → De spraak wordt automatisch getranscribeerd via een andere pipeline met de nodige modellen, die detecteert waar spraak is, bepaalt welke spreker wanneer spreekt en de inhoud van het gesprek analyseert.
- Text NLP-Based Pipeline → Er is een pipeline om informatie te extraheren uit slides en gespreksnotities. Voor e-mails wordt een afzonderlijke pipeline voor NLP-verwerking, messaging en opmerkingen gebruikt.
Hoe deze modellen zijn gesegmenteerd over klanten
Hoewel dit een vraag is die we aan Gong hebben gesteld, zien we dat vrijwel alle SaaS-bedrijven het volgende doen:
- Modellen die gemeenschappelijk zijn voor alle klanten: Er zijn modellen zoals de ASR-modellen die automatische spraakherkenning uitvoeren. Dit helpt bij een gestandaardiseerde dienstverlening en het behouden van consistentie over het gehele platform.
- Modellen die uniek zijn voor elke klant: In het geval van SaaS-startups, en zeker bij een sales intelligence-platform zoals Gong, moet elk model uniek zijn. Dit wordt gedaan om dataprivacy en beveiliging te garanderen en maatwerk of personalisatie te bieden door het model te trainen op de dataset van de klant. Dit brengt twee uitdagingen met zich mee: serving en dataprivacy. Omdat Gong klanten in staat stelt modellen te trainen op hun eigen data, moeten ze ML-interfaces op hun platform aanbieden, waardoor de scheiding van data per klant een uitdaging wordt.
📌
Aantal modellen: Aantal klanten X Modeltypen
📌
"We gebruiken hetzelfde basismodel voor iedereen. We laten klanten ook specifieke modellen trainen voor hun eigen content."
Om de kosten te optimaliseren, gebruikt Gong multi-model serving in de inference-laag, aangezien het draaien van afzonderlijke modellen op afzonderlijke machines een kostbaar systeem zou opleveren.
Hier is een gedetailleerde blog van Gong over het gebruik van ML in B2B-sales
ML System Workflow bij Gong
Bij Gong is het ML-systeem gestructureerd volgens de ML-organisatie.
- Research: Er is een afzonderlijke omgeving voor research. Het team werkt zelfstandig – haalt de data op, voert de training uit, rondt de training af, geeft het model vrij, waarna het model naar de deployment pipeline wordt gestuurd die door engineering wordt beheerd.
- Production Deployment (onderdeel van Engineering): Het getrainde model wordt door het Engineering-team in productie genomen.
In deze blog (en gespreksserie) duiken we dieper in de uitdagingen van de infrastructuur aan de Research-zijde voor Gong
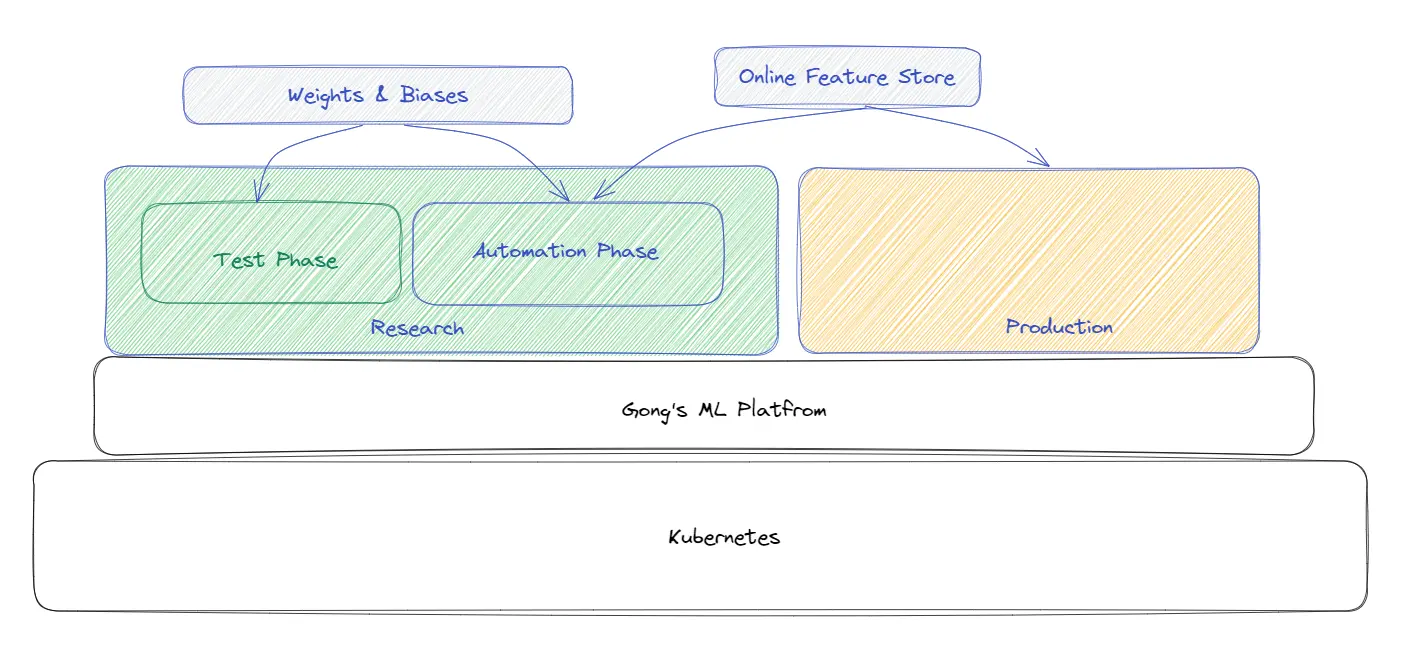
Hoe is de ML Researcher Workflow ingericht bij Gong?

- Basis Testfase: Onderzoekers nemen data en trainen op hun eigen machines of via VM's door data uit productie naar hun eigen machine te halen
- Automatiseringsfase: Zodra het model definitief is, wordt er een automatische pipeline gemaakt voor de dataverwerking om de grote hoeveelheid data bij de onderzoeker te krijgen.
Om onderzoekers eenvoudig machines te laten opstarten, is de gehele Research-infrastructuur ingericht op Kubernetes. De meeste modellen in het researchteam maken geen gebruik van online features.
Cloud: Het grootste deel van de infrastructuur draait op AWS, en er wordt op kleinere schaal samengewerkt met andere cloudproviders.
Infrastructuurbeheer: De pipelines draaien de modellen specifiek voor elke klant. Er wordt een machine opgestart die alle calls van dat specifieke bedrijf verwerkt
Andere uitdagingen die ML tot een complex probleem maken bij Gong
- Kosten: Zoals we hierboven al noemden, zijn kosten een grote uitdaging voor Gong, aangezien er een enorme hoeveelheid data nodig is om het model te trainen en vervolgens opnieuw te trainen. Spraakdatasets zijn zeer groot (een paar honderd uur spraak komt overeen met enkele honderden gigabytes aan data). NLP-datasets zijn kleiner in omvang, maar kunnen uit zeer veel rijen bestaan. Omdat research gescheiden is van productie, heeft het researchteam de flexibiliteit om te bepalen hoeveel data er wordt gebruikt bij modeltraining. Het researchteam werkt aan het optimaliseren van de hoeveelheid data die nodig is voor de training.
- Het ML Platform vereenvoudigen: Een belangrijk aspect van het vereenvoudigen van het proces is het verbergen van de complexiteit van de dataselectie voor training, gecombineerd met het juiste toegangsbeheer achter de tools.
Dit aanpak verschilt per databron. Bij een groot aantal databases (die elk een ander type informatie bevatten en anders toegankelijk zijn) wordt er veel werk verricht om veilige pipelines te bouwen die alleen geautoriseerde personen data laten gebruiken en een logboek bijhouden van wie de data heeft geopend en voor welk doel. Dit omvat ook het toestaan dat onderzoekers resultaten uit verschillende databronnen kunnen combineren. - Databeveiliging & Privacy: Een van de belangrijkste prioriteiten voor Gong is beveiliging en privacy, oftewel zorgen dat er geen datalekken zijn, dat onbevoegden geen toegang krijgen tot data en dat geen enkele klant data van een andere klant ontvangt. Dit is uiterst ingewikkeld vanwege de grote hoeveelheden data.
Hoe Gong dit heeft opgelost: Data wordt opgeslagen op veilige locaties, elk datapunt is geannoteerd en heeft toegangsrechten op basis van de tenant ID van de klant. Toegang wordt beheerd via credential-mechanismen en alles wat geautomatiseerd kan worden, is geautomatiseerd - Zorgen dat data van klant A niet in het model van klant B terechtkomt - Bij het gebruik van een Large Language Model is het mogelijk om iets af te leiden uit de data van de ene klant, waardoor een andere klant toegang zou kunnen krijgen tot privé-informatie. Dit is iets waarmee rekening moet worden gehouden.
- Automatische retraining is niet eenvoudig: Retraining wordt alleen toegepast wanneer er een zeer volwassen methode is voor alle stappen in de pipeline. Dit komt zelden voor. Retraining-inspanningen hangen af van het type model; bij een spraakherkenningsmodel voor een specifieke taal is het bijvoorbeeld vrij eenvoudig om met dezelfde parameters opnieuw te trainen op nieuwe data.
Het verversen van data verandert ook veel van de inhoud, waardoor een onderzoeker vaak opnieuw onderzoek moet doen om te garanderen dat het nieuwe model daadwerkelijk beter presteert dan het vorige.
Aanvullende gedachten van Noam
Kubernetes is de aangewezen weg
Alles wat binnen het Research-team wordt gedaan, wordt nu overgezet naar Kubernetes. Een deel van Noams werk bestaat uit het helpen van zijn team om automatisch toegang te krijgen tot resources vanuit de Kubernetes-cloud. Dit is een doorlopend traject.
📌
"Ik zou iedereen die hiermee begint aanraden om al heel vroeg in het proces na te denken over schaalbaarheid en hoe je team gaat werken"
"Ik denk dat de meeste MLOps-systemen Kubernetes nodig hebben voor resourcebeheer. Ik zie in de toekomst geen enkel MLOps-platform ontstaan dat zonder Kubernetes kan"
Enkele belangrijke aandachtspunten:
- Scale to Zero is cruciaal voor kostenbeheer. Het draaiend houden van ongebruikte machines veroorzaakt een enorme kostenpost.
- Het systeem moet wendbaar zijn om beveiligings- en privacyvraagstukken efficiënt af te handelen. De data moet blijven waar hij staat; je moet je code naar de data toe brengen.
MLOps: Zelf bouwen vs. Kopen
📌
"Mijn visie is dat we dit platform bij Gong zelf moesten bouwen"
- Als je zelf gaat bouwen, start dan op Kubernetes, wat een schaalbaar en flexibel platform is.
- Configureer alle systemen zo dat je voorbereid bent op tenant-scheiding en de toepassing van GDPR. Als iemand data wil laten verwijderen, moet je deze direct kunnen wissen.
- Vroegtijdig nadenken over schaalbaarheid is essentieel. Maak je infrastructuur wendbaar en flexibel, zorg voor schaalbaarheid, en stel jezelf in staat om zo veel machines op te starten als nodig is. Zorg er echter voor dat ze direct worden afgesloten zodra ze niet meer actief zijn.
Beveiliging, Beveiliging, Beveiliging
Niets is belangrijker voor een SaaS-bedrijf dan beveiliging. ML-pipelines moeten prioriteit geven aan beveiliging vanwege dataprivacy bij het verwerken van gevoelige klantgegevens, evenals het voorkomen van onbevoegde toegang.
We hopen dat de 1e blogserie in de TrueML Talks je waardevolle inzichten heeft gegeven over hoe je kunt nadenken over het bouwen van je Machine Learning Research Infrastructure om je ML-teams te versterken. #MLOps #MachineLearning #DataScience #DevOps #ModelOps #AIInfrastructure
Lees onze nieuwe blogs in deze serie
Ga naar onze tweede aflevering van de TrueML talks, waarin we spreken met de Platform Lead bij Stitch. Blijf de TrueML YouTube-serie volgen en vind alle afleveringen van de TrueML-blogserie hier -
TrueFoundry is een ML Deployment PaaS op Kubernetes die ontwikkelaars-workflows versnelt en hen volledige flexibiliteit biedt bij het testen en deployen van modellen, terwijl het infra-team volledige controle en beveiliging behoudt. Via ons platform stellen we Machine Learning-teams in staat om modellen binnen 15 minuten te deployen en monitoren met 100% betrouwbaarheid, schaalbaarheid en de mogelijkheid om binnen seconden te roll-backen – waardoor zij kosten besparen, modellen sneller in productie brengen en echte bedrijfswaarde realiseren.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.







.png)

.webp)


.webp)


.webp)















