



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



Bijgewerkt: November 10, 2026
Gepubliceerd: November 9, 2026
De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Nu large language models (LLM's) de manier waarop applicaties worden gebouwd blijven transformeren, waaronder AI-copiloten en enterprise-chatinterfaces, groeit de behoefte aan een gestructureerde infrastructuur en processen om deze efficiënt te beheren. Deze opkomende discipline staat bekend als LLMOps. Vergelijkbaar met hoe MLOps discipline bracht in traditionele machine learning-workflows, richt LLMOps zich op het oplossen van de unieke operationele uitdagingen die komen kijken bij het op schaal werken met funderingsmodellen.
LLMOps beperkt zich niet tot het serveren van een model via een API. Het omvat de gehele levenscyclus, inclusief prompt engineering, fine-tuning, retrieval-augmented generation (RAG), versiebeheer, prestatiebewaking, kostenoptimalisatie en het afdwingen van veilige toegang. Vanwege de omvang en complexiteit van LLM's is een toegewijde architectuur noodzakelijk om betrouwbare, schaalbare en onderhoudbare implementaties te garanderen.
Dit artikel verkent de grondbeginselen van LLMOps-architectuur. We ontleden de belangrijkste componenten, onderzoeken referentiepatronen die in de praktijk worden gebruikt en belichten de tools die snelle ontwikkeling en governance ondersteunen. Of u nu een klantenservice-assistent, een engine voor het ophalen van kennis of een AI-gestuurd agentplatform bouwt, het begrijpen van LLMOps-architectuur is essentieel voor het creëren van oplossingen die efficiënt, schaalbaar en gereed voor productie zijn.
LLMOps-architectuur verwijst naar het gestructureerde ontwerp en de set componenten die nodig zijn om de levenscyclus van large language models in productiemilieus te beheren. Het is het fundament dat teams in staat stelt om te bewegen van experimenteren met LLM's naar het bouwen van schaalbare, veilige en onderhoudbare applicaties die door deze modellen worden aangedreven.
In tegenstelling tot traditionele MLOps, die zich voornamelijk bezighouden met gestructureerde datasets en model-trainingspipelines, moet LLMOps rekening houden met unieke uitdagingen zoals prompt-orchestratie, retrieval-augmented generation, modelversiebeheer op massale schaal en real-time inferentie-latentie. De architectuur moet ook dynamische workloads, multi-model routing en veilige toegang voor gebruikers en teams ondersteunen.
LLMOps-architectuur combineert infrastructuur, automatisering en observability om een betrouwbare uitrol en governance te garanderen. Het omvat doorgaans:
Deze architectuur is ontworpen om zowel voorgetrainde modellen die als API worden aangeboden als custom fine-tuned modellen die in private omgevingen zijn geïmplementeerd te ondersteunen. Naarmate het gebruik van LLM's groeit over verschillende domeinen heen, wordt een goed gestructureerde architectuur essentieel voor snelle iteratie, kostenefficiëntie en gebruikersvertrouwen.
Het begrijpen van LLMOps-architectuur helpt teams systemen te bouwen die schalen en tegelijkertijd flexibel en compliant blijven en zijn afgestemd op echte bedrijfsresultaten.
LLMOps-architectuur brengt structuur en schaalbaarheid naar de implementatie van large language models. In tegenstelling tot traditionele MLOps adresseert het unieke complexiteiten rond prompt-orchestratie, retrieval-pipelines en modelgedrag tijdens runtime. Een robuuste architectuur verbindt verschillende kernlagen, die elk een kritieke functie vervullen.
Databeheer
LLM's zijn afhankelijk van diverse data van hoge kwaliteit om goed te presteren. Deze component omvat het sourcen, opschonen, formatteren en opslaan van grootschalige tekst- of documentdata. Voor fine-tuned modellen kunnen ook gelabelde datasets nodig zijn. Dataversiebeheer en lineage-tracking zijn cruciaal om de traceerbaarheid over modeliteraties heen te garanderen.
Modelontwikkeling
Deze laag richt zich op het selecteren van het basismodel en het toepassen van aanpassingen via fine-tuning, instruction tuning of prompt engineering. Benchmarking-frameworks worden gebruikt om prestaties te valideren voor verschillende stroomafwaartse taken. Tools zoals LoRA en PEFT helpen de kosten en rekenkracht bij modelupdates te verminderen.
Inferentie en uitrol
Het serveren van LLM's vereist een schaalbare infrastructuur. Dit omvat geoptimaliseerde API's, modelkwantisering, streaming op token-niveau en autoscaling op GPU's. Observability-tools bewaken inferentiekosten, latentie en doorvoer. Productie-opstellingen omvatten vaak A/B-testen, rollback-strategieën en multi-model routing.
Beveiliging en compliance
LLMOps moet voldoen aan beveiligingsbehoeften op ondernemingsniveau. Encryptie, toegangsbeheer, datapseudonymisering en audit-trails zijn essentieel om te voldoen aan compliancestandaarden zoals HIPAA, GDPR of SOC 2.
Governance en verantwoorde AI
Deze laag beheert prompt-versiebeheer, hallucinatie-tracking en biasdetectie. Het loggen van alle interacties en het toepassen van filters voor schadelijke content zorgt voor ethisch en consistent gedrag in productie.
Best practices en toekomstbestendigheid
Effectieve LLMOps omvatten modulaire pipelines, evaluatieloops en prompt-traceerbaarheid. Met het oog op de toekomst evolueren architecturen om real-time retrieval, continue fine-tuning en multi-agent coördinatie te ondersteunen.
Door deze componenten op elkaar af te stemmen, kunnen teams LLM-applicaties leveren die robuust, aanpasbaar en gereed voor de onderneming zijn.
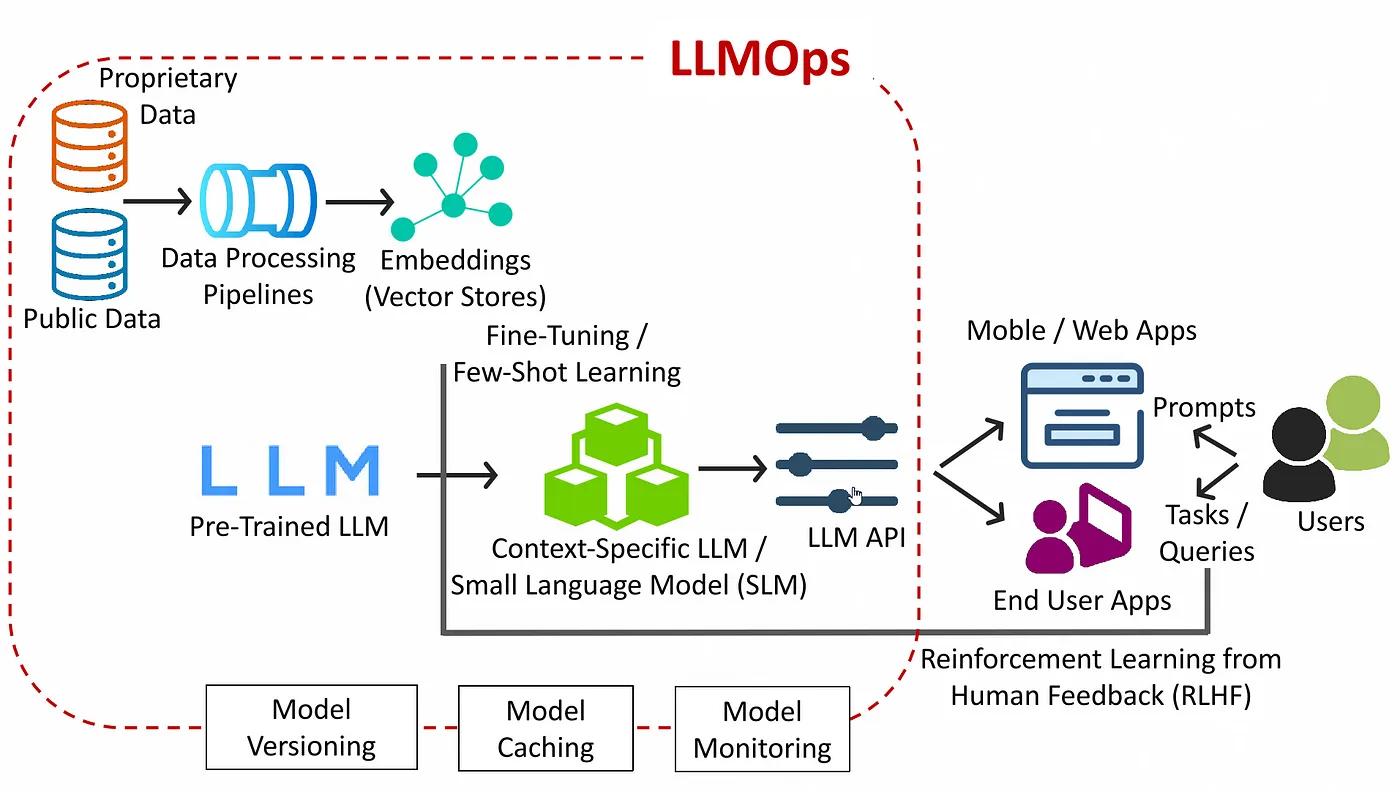
deze visualisatie toont een moderne LLMOps-architectuur, die de volledige pipeline beslaat van de inname van ruwe data tot productie-uitrol, gebruikersinteractie en feedbackgestuurd leren. Het weerspiegelt hoe real-world large language model-systemen worden gebouwd en onderhouden door teams en in verschillende omgevingen.
Datacollectie en -verwerking: De architectuur begint met openbare en bedrijfseigen databronnen. Dit kunnen tekstcorpora, documenten, CRM-data, interne kennisbanken of klantgesprekken zijn. Alle data passeert een dataverwerkingspipeline, waar het wordt opgeschoond, genormaliseerd en verrijkt voor stroomafwaartse taken. Dit omvat het omzetten van tekst in vector-embeddings, die worden opgeslagen in vectordatabases of embedding-stores voor snelle, op similariteit gebaseerde retrieval.
Modelselectie en -aanpassing: Een voorgetrainde LLM (zoals GPT, LLaMA of Falcon) wordt geselecteerd als het funderingsmodel. Met behulp van fine-tuning of few-shot learning creëren teams een contextspecifieke LLM of small language model (SLM) dat is afgestemd op hun domein of use case. Dit zorgt voor een betere afstemming op specifieke taal, toon, taken en datastructuur die relevant zijn voor de applicatie.
LLM Gateway
In het hart van de architectuur bevindt zich de LLM Gateway. Deze biedt een geïntegreerd API-oppervlak voor alle modeleindpunten en verzorgt authenticatie, routing, batching en protocoltranslatie. De gateway dwingt ratelimieten en quota af, past prompt-templates toe en orchestreert fallback- of A/B-routing tussen modelversies. Het verzamelt ook gedetailleerde metrieken over het aantal requests, latenties en foutpercentages voordat calls naar de inferentielaag worden doorgestuurd.
LLM API Serving: Het aangepaste model wordt beschikbaar gesteld via een LLM API, die fungeert als de primaire interface voor applicaties. Deze API's zijn ontworpen voor real-time interactie en verwerken inferentie-optimalisatie via batching, kwantisering en latentiecontrole. De architectuur omvat ook model-caching om redundantie te verminderen en modelmonitoring om betrouwbaarheid en kostenefficiëntie te garanderen.
Gebruikersapplicaties en feedbackloop
Mobiele en webclients sturen prompts naar de gateway, ontvangen gegenereerde antwoorden en presenteren deze aan eindgebruikers. Interactiedata wordt vastgelegd voor RLHF of offline hertraining, waardoor de cirkel rond is voor continue modelverbetering.
Governance en levenscyclusbeheer: De architectuur omvat essentiële operationele functies zoals modelversiebeheer, audit-trails, prompt-tracking en veilige toegangsregels. Deze zorgen ervoor dat LLM-systemen in de loop der tijd reproduceerbaar, interpreteerbaar en compliant blijven.
Dit diagram geeft effectief de volledige levenscyclus weer van LLM-implementatie en -optimalisatie binnen een productieklare LLMOps-pipeline.
De LLMOps-architectuur begint met openbare en bedrijfseigen data die door verwerkingspipelines stroomt om embeddings te genereren, die worden opgeslagen in vectordatabases. Een voorgetrainings-LLM wordt vervolgens gefinetuned of aangepast met behulp van few-shot learning om een contextspecifiek model te maken. Dit model wordt uitgerold achter een geoptimaliseerde LLM API die mobiele en webapplicaties in real-time bedient. Gebruikers interacteren met deze applicaties door prompts in te dienen en intelligente antwoorden te ontvangen. Feedback van gebruikersinteracties wordt gebruikt via reinforcement learning from human feedback (RLHF), terwijl modelversiebeheer, caching en monitoring de systeemprestaties, traceerbaarheid en governance garanderen.
LLMOps-architectuur is geen 'one-size-fits-all'. Afhankelijk van de omvang van de organisatie, het domein en de regelgeving, ontstaan er verschillende patronen om LLM's effectief te operationaliseren. Deze patronen helpen teams een balans te vinden tussen prestaties, kosten, governance en ontwikkelingssnelheid. Hieronder staan enkele veelgebruikte referentiepatronen in echte implementaties.
API-Centrische LLM-uitrol
Dit is het meest voorkomende patroon voor beginnende teams of lichte use cases. Een voorgetrainde of gefinetunede LLM wordt gehost achter een REST API, en stroomafwaartse applicaties doen synchrone requests. Prompt-templates zijn voorzien van versiebeheer en er wordt minimale orchestratie gebruikt. Dit patroon is eenvoudig te implementeren en werkt goed voor contentgeneratie, samenvattingen of basis-chatinterfaces.
Retrieval-Augmented Generation (RAG)-patroon
Gebruikt in kennisintensieve omgevingen, combineert deze architectuur een LLM met een vectordatabase die context-relevante informatie ophaalt. Invoeren worden eerst verrijkt door op embeddings gebaseerde retrieval uit interne of externe kennisbanken en vervolgens aan de LLM doorgegeven. Dit patroon versterkt de feitelijke onderbouwing en domeinspecificiteit. Het is ideaal voor klantenservice, analyse van juridische documenten of enterprise search.
LLM + Workflow-orchestratiepatroon
In complexere systemen worden LLM's ingebed in grotere workflows met behulp van orchestratie-frameworks zoals LangChain, LangGraph of Airflow. Deze architecturen ketenen meerdere stappen aan elkaar—retrieval, prompt-formattering, inferentie, post-processing en actie-triggers. Dit maakt dynamische besluitvorming, multi-agent systemen en autonome taakuitvoering mogelijk. Het wordt gebruikt in agentic AI, AI-copiloten en multi-turn applicaties.
Fine-Tuned Privé LLM-patroon
Voor sterk gereguleerde industrieën of use cases met gevoelige data kunnen organisaties open-source LLM's finetunen en hosten binnen hun eigen infrastructuur of VPC. De architectuur omvat dataanonisering, fine-tuning pipelines, geïsoleerde inferentie-omgevingen en volledige monitoring en toegangsbeheer. Dit patroon komt veel voor in de gezondheidszorg, financiële sector en defensie.
Hybride Cloud-Edge-patroon
Opkomend in edge AI-scenario's, houdt dit patroon de hoofd-LLM in de cloud, maar verplaatst lichte modellen of promptverwerkingslogica naar edge-apparaten. Het vermindert de latentie en het bandbreedtegebruik, terwijl gevoelige data lokaal blijft. Het wordt steeds vaker gebruikt in IoT, automotive en mobiele ervaringen.
Deze patronen weerspiegelen de flexibiliteit en het aanpassingsvermogen van LLMOps en bieden trajecten naar
Het LLMOps-ecosysteem groeit snel en geen enkele tool kan aan elke behoefte voldoen. Hoogwaardige teams bouwen modulaire stacks die aansluiten bij hun infrastructuur en workflows. In het hart van veel enterprise-grade stacks speelt TrueFoundry een centrale rol door ondersteuning te bieden voor uitrol-, observability-, orchestratie- en automatiseringslagen. Hieronder vindt u een overzicht van de kernlagen en de tools die deze aandrijven.
1. Data- & Embeddinglaag
Deze laag verzorgt het opschonen, transformeren, chunking en embedding van data voor retrieval-augmented generation (RAG). Het stelt LLM's in staat om te werken met contextueel bewustzijn.
Deze tools stellen modellen in staat om relevante informatie op te halen tijdens de inferentie, wat de feitelijke onderbouwing en de kwaliteit van de uitvoer verbetert.
2. Model Serving- & Inferentielaag
Dit is de ruggengraat van de LLMOps-stack. Het omvat de componenten die nodig zijn om modellen efficiënt te hosten en te serveren, GPU-gebruik te beheren en API's te schalen.
Deze laag zorgt ervoor dat LLM-antwoorden snel en kostenefficiënt worden geleverd, zelfs onder productieverkeer.
3. Prompt- & Orchestratielaag
Deze laag beheert prompt-templates, agent-flows en dynamische interacties. Het helpt logica te routen en meerstaps-processen binnen LLM-applicaties aan elkaar te koppelen.
Prompt-orchestratie geeft teams controle over hoe LLM's zich gedragen bij complexe zakelijke use cases.
4. Monitoring-, Feedback- en Governancelaag
Betrouwbaarheid, transparantie en ethiek vereisen robuuste monitoring- en governancesystemen. Deze laag legt outputs, gebruikersfeedback en prestatiemetrieken vast.
5. Workflow- & Automatiseringslaag
Deze laatste laag beheert training, evaluatie, uitrol-automatisering en CI/CD. Het maakt traceerbare, herhaalbare workflows mogelijk die iteratieve ontwikkeling ondersteunen.
Wanneer deze tools over alle lagen heen zijn afgestemd, transformeren ze LLMOps van gefragmenteerd experimenteren naar een herhaalbare, schaalbare engineeringdiscipline. In plaats van te vertrouwen op één enkele end-to-end oplossing, stellen moderne teams koppelbare stacks samen die passen bij hun infrastructuur, schaal en compliance-behoeften.
De sleutel is interoperabiliteit: het kiezen van tools die soepel integreren, sleutelfasen automatiseren en transparantie bieden over de gehele levenscyclus van het model. Met de juiste stack op zijn plaats kunnen LLM's evolueren van prototypes tot productieklare systemen die waardevolle bedrijfsresultaten opleveren.
LLMOps wordt snel een fundamentele discipline voor teams die applicaties bouwen die worden aangedreven door large language models. Naarmate LLM's verschuiven van experimenteel gebruik naar productiekritische systemen, hebben organisaties een gestructureerde architectuur, gespecialiseerde tooling en herhaalbare workflows nodig om complexiteit, kosten en prestaties te beheren. Een goed ontworpen LLMOps-architectuur versnelt niet alleen de uitrol, maar garandeert ook ethische afstemming, datagovernance en continue verbetering via feedback.
Door modulaire tools toe te passen op het gebied van databeheer, inferentie, orchestratie en monitoring, krijgen teams flexibiliteit en controle over elk aspect van de LLM-levenscyclus. Of u nu een open-source model serveert of een bedrijfseigen model finetunet, schaalbare LLMOps-praktijken zijn de ruggengraat van duurzame AI-systemen.
De toekomst van LLMOps ligt in het vermogen om gelijke tred te houden met de snelle evolutie van modellen, opkomende risico's en de groeiende vraag vanuit bedrijven. Voor organisaties die klaar zijn om verantwoord te schalen, is investeren in LLMOps-architectuur niet langer optioneel; het is een strategisch voordeel.
Een LLMOps-architectuur is het structurele raamwerk dat is ontworpen om de gehele levenscyclus van large language models in een productie-omgeving te beheren. Het biedt de noodzakelijke infrastructuur voor datainname, prompt-versiebeheer en model-orchestratie, waardoor AI van eenvoudig experimenteren naar een betrouwbare bedrijfsimplementatie beweegt. Deze architectuur zorgt ervoor dat applicaties schaalbaar, veilig en onderhoudbaar blijven naarmate ze evolueren.
Een LLMOps-architectuur bestaat uit verschillende kritieke lagen: vectordatabases voor op RAG gebaseerde context, promptbeheersystemen voor versiebeheer en een gecentraliseerde AI-gateway voor model-serving. Bovendien moet het observability-modules bevatten om latentie en tokengebruik te volgen, samen met fine-tuning pipelines voor gespecialiseerde taken. TrueFoundry verenigt deze componenten in één enkel control plane, wat de complexiteit van het beheren van een gefragmenteerde AI-stack vereenvoudigt.
Het primaire verschil in LLMOps-architectuur is de verschuiving van trainingszware workflows naar orchestratiezware pipelines. Waar traditionele MLOps zich richt op het bouwen van custom modellen en feature engineering, geeft LLMOps prioriteit aan het beheer van voorgetrainde funderingsmodellen via prompt engineering en retrieval-augmented generation (RAG). TrueFoundry biedt een platform dat beide paradigma's ondersteunt, waardoor teams kunnen overstappen op generatieve AI zonder gevestigde operationele standaarden op te offeren.
Standaardtools binnen een LLMOps-architectuur omvatten vectorstores zoals Pinecone of Weaviate, orchestratie-frameworks zoals LangChain en gespecialiseerde monitoringsuites. Het afzonderlijk beheren van deze elementen creëert echter vaak integratiesilo's. TrueFoundry fungeert als een uitgebreide orchestratielaag die de nodige infrastructuur biedt om modelimplementaties, secret-rotatie en kostenefficiënte routing over elke cloudprovider te beheren.
TrueFoundry is een ideaal platform voor LLMOps-architectuur omdat het een ontwikkelaarsgericht control plane biedt dat native draait binnen uw eigen veilige cloudomgeving. Het abstraheert de complexiteit van Kubernetes en infrastructuur-provisioning, terwijl het hoogwaardige gateways en diepe observability biedt. Door data binnen uw VPC te houden en bronoptimalisatie te automatiseren, zorgt het ervoor dat het schalen van enterprise AI zowel veilig als kostenefficiënt blijft.
LLMOps-architectuur bestaat typisch uit verschillende lagen: de datalaag, modellaag, applicatielaag en infrastructuurlaag. De datalaag beheert datasets, de modellaag behandelt training of inferentie, de applicatielaag integreert AI in producten, en de infrastructuurlaag ondersteunt uitrol, schaling, monitoring en systeembeheer.
LLMOps omvat gestructureerd versiebeheer voor prompts, modellen en fine-tuning-iteraties. Versiebeheer zorgt voor reproduceerbaarheid, vergemakkelijkt rollbacks en maakt experimenteren mogelijk zonder productiesystemen te verstoren. Teams kunnen verbeteringen volgen, modelprestaties vergelijken en voldoen aan audit- en regelgevingsvereisten.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















