



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
LiteLLM is de meest gebruikte open-source LLM-proxy. Het lost een echt probleem elegant op: u krijgt een uniforme, OpenAI-compatibele API die kan routen over tientallen providers, en de community-versie kost niets om uit te voeren. De routinglogica is solide. De developer experience is goed. Voor teams die alleen een lichtgewicht proxy nodig hebben en de DevOps-capaciteit hebben om deze te beheren, werkt het prima.
Het gesprek verandert wanneer teams tegen de grenzen van de zelfbeheerde open-sourceversie aanlopen en LiteLLM Enterprise beginnen te evalueren. Publieke referenties en gesprekken met leveranciers noemen vaak een Basic-tier van rond de $250/maand en een Premium-tier rond de $30.000/jaar, maar LiteLLM publiceert geen gestandaardiseerde prijzen en de uiteindelijke kosten worden doorgaans rechtstreeks met de leverancier onderhandeld. Deze cijfers weerspiegelen openbaar gerefereerde schattingen, maar de prijzen van LiteLLM zijn niet volledig gestandaardiseerd en moeten rechtstreeks bij de leverancier worden geverifieerd. LiteLLM Enterprise is een self-hosted product. U richt de infrastructuur in, u beheert de PostgreSQL-database en Redis-cache, u verzorgt upgrades en beveiligingspatches, en u bent verantwoordelijk voor de storingsdienst wanneer de proxy om 2 uur 's nachts uitvalt. Niets daarvan staat op de prijzenpagina.
Dit is geen vergelijking van functielijsten. Het is een eerlijke analyse van de totale eigendomskosten (total cost of ownership) waarin de enterprise-prijzen van LiteLLM, infrastructuurkosten, engineering-onderhoudskosten, het MCP-governancegat en de vergelijking met TrueFoundry aan bod komen voordat u zich aan een leverancier verbindt.
LiteLLM Enterprise is de commerciële laag die bovenop de open-source proxy is gebouwd. Het voegt governance-functies toe die niet beschikbaar zijn in de community-versie: SSO/SAML-integratie, granulaire RBAC voor modeltoegang, Prometheus-metrics, aangepaste callbacks, LLM guardrails voor inhoudsfiltering, JWT-autorisatie en prioriteitsondersteuning.
Twee tiers richten zich op verschillende organisatieprofielen. Controleer de actuele details op litellm.ai/enterprise voordat u aankoopbeslissingen neemt.
Enterprise-kopers die AI gateway-opties vergelijken, beginnen vaak bij de licentiekosten en stoppen daar. Het werkelijke kostenbeeld van LiteLLM Enterprise wordt pas duidelijk na implementatie, wanneer de infrastructuurfactuur binnenkomt en de eerste engineering-storingsdienst op de kalender staat. Er zijn drie kostencategorieën die over een periode van twee tot drie jaar consistent hoger uitvallen dan de licentiekosten.
De onderstaande cijfers zijn gebaseerd op representatieve enterprise-implementaties en interne benchmarks in plaats van gestandaardiseerde leveranciersprijzen, en moeten worden beschouwd als richtinggevende schattingen in plaats van vaste kosten.

LiteLLM Enterprise draait doorgaans op een toegewijde compute-stack: een proxyserver of -cluster, vaak samen met een PostgreSQL-database voor configuratie en audit-logging, en een Redis-instantie voor caching en rate limit-tellers. Op AWS of Azure ligt een enterprise-waardige multi-regionale implementatie met hoge beschikbaarheid voor omvangrijk LLM-verkeer doorgaans in de orde van grootte van enkele honderden tot een paar duizend dollar per maand aan cloudinfrastructuurkosten, los van de licentiekosten.
Teams die 99,9% uptime nodig hebben voor hun LLM gateway — een redelijke vereiste wanneer de gateway zich op het kritieke pad van productie-AI-functies bevindt — hebben multi-regio redundantie en databasereplicatie nodig, wat de maandelijkse infrastructuurkosten naar de bovenkant van het spectrum drijft. Deze kosten stijgen bovendien jaarlijks. Prijswijzigingen van cloudproviders, kosten voor dataoverdracht en logbeheer-overhead voegen jaarlijks 10 tot 15 procent toe aan een realistische 3-jarige infrastructuurprospectie.
Zelfbeheerde infrastructuur vereist voortdurende engineering-aandacht die niet terugkomt in de prijzen van de leverancier, maar absoluut wel in de personeelsplanning. Werkzaamheden omvatten het toepassen van beveiligingspatches, het beheren van versie-upgrades (LiteLLM brengt frequent releases uit en upgrades vereisen af en toe configuratiewijzigingen), het afhandelen van gateway-storingen en het beheren van configuraties naarmate de organisatie nieuwe modellen of teams toevoegt.
Organisaties die migreren van zelfbeheerde LiteLLM naar beheerde platformen onderschatten vaak de voortdurende engineering-overhead die nodig is om het systeem te onderhouden. In de praktijk zetten organisaties doorgaans ongeveer 0,25 tot 0,5 FTE aan engineering-capaciteit in voor LiteLLM-activiteiten, waaronder onderhoud, schalen en betrouwbaarheidswerkzaamheden. Uitgaande van een volledig belaste senior engineer-kostenpost van $250.000 per jaar, vertaalt de 0,25 tot 0,5 FTE-inzet zich in een geschatte $62.500 tot $125.000 per jaar aan engineering-inspanningen die puur aan infrastructuurbeheer worden besteed — vaak meer dan de licentiekosten zelf. En dit groeit niet-lineair: een organisatie die begint met vijf teams op LiteLLM en groeit naar vijftig, zal merken dat de configuratiecomplexiteit en de onderhoudslast sneller toenemen dan het aantal teams.
Volgens de huidige documentatie en functiebeschikbaarheid biedt LiteLLM geen native MCP gateway. Organisaties die agentic AI-systemen uitrollen waarbij agents tools aanroepen via het Model Context Protocol, hebben een afzonderlijke oplossing nodig om toegang tot MCP-servers te beheren. Dat betekent een tweede leveranciersevaluatie, een tweede beveiligingsbeoordeling, een tweede inkoopproces en een afzonderlijk integratieproject om twee governance-systemen een uniforme audit-trail te laten genereren en een consistent identiteitsbeleid te laten afdwingen.
Gartner voorspelt dat tegen 2028 70% van de software-engineeringteams die multimodale toepassingen bouwen, AI gateways zal gebruiken, waaronder voor toegang tot agentic tools. Organisaties die vandaag voor LiteLLM kiezen voor LLM-routing, kiezen een platform dat aanvulling nodig heeft naarmate hun agentic AI-voetafdruk groeit. De integratiekosten voor het verbinden van twee afzonderlijke governance-systemen zijn reëel en worden bij initiële inkoopbeslissingen consistent onderschat. De jaarlijkse kosten van een tweede tool, plus de voortdurende engineering-overhead voor het onderhouden van de integratie, voegen een aanzienlijke extra jaarlijkse kostenpost toe, afhankelijk van de leverancierskeuze, integratiecomplexiteit en compliance-vereisten.
Het volgende maakt gebruik van een representatief enterprise-scenario: een engineering-organisatie van 200 personen die ongeveer 500 miljoen tokens per maand via de gateway routeert, actief is over twee cloudproviders, met 20 teams op het platform en compliance-vereisten die gestructureerde audit-logging verplichten. Pas de cijfers aan voor uw eigen profiel.
LiteLLM Enterprise Premium: Jaar 1 Kostenoverzicht
De vergelijking van de volledig belaste kosten draait vaak het beeld om dat de puur op licenties gebaseerde vergelijking schetst. Organisaties die rekening houden met engineering-onderhoud en MCP-governance ontdekken dat beheerde platformen op enterprise-schaal concurrerend geprijsd zijn — en soms goedkoper — dan zelfbeheerde alternatieven. De vraag is niet of de licentievergoeding van LiteLLM Enterprise redelijk geprijsd is. Dat is zo. De vraag is of de totale kosten van het self-hosted model, inclusief alles wat de klant zelf beheert, passen binnen het budget en de capaciteit van de organisatie.
Licentiekosten en infrastructuurkosten vertellen u wat u betaalt. Functiedekking vertelt u wat u krijgt. Het volgende behandelt de mogelijkheden die enterprise-inkoopteams in 2026 consistent identificeren als evaluatiecriteria voor AI gateway-beslissingen.
Functievergelijking: LiteLLM Enterprise vs TrueFoundry
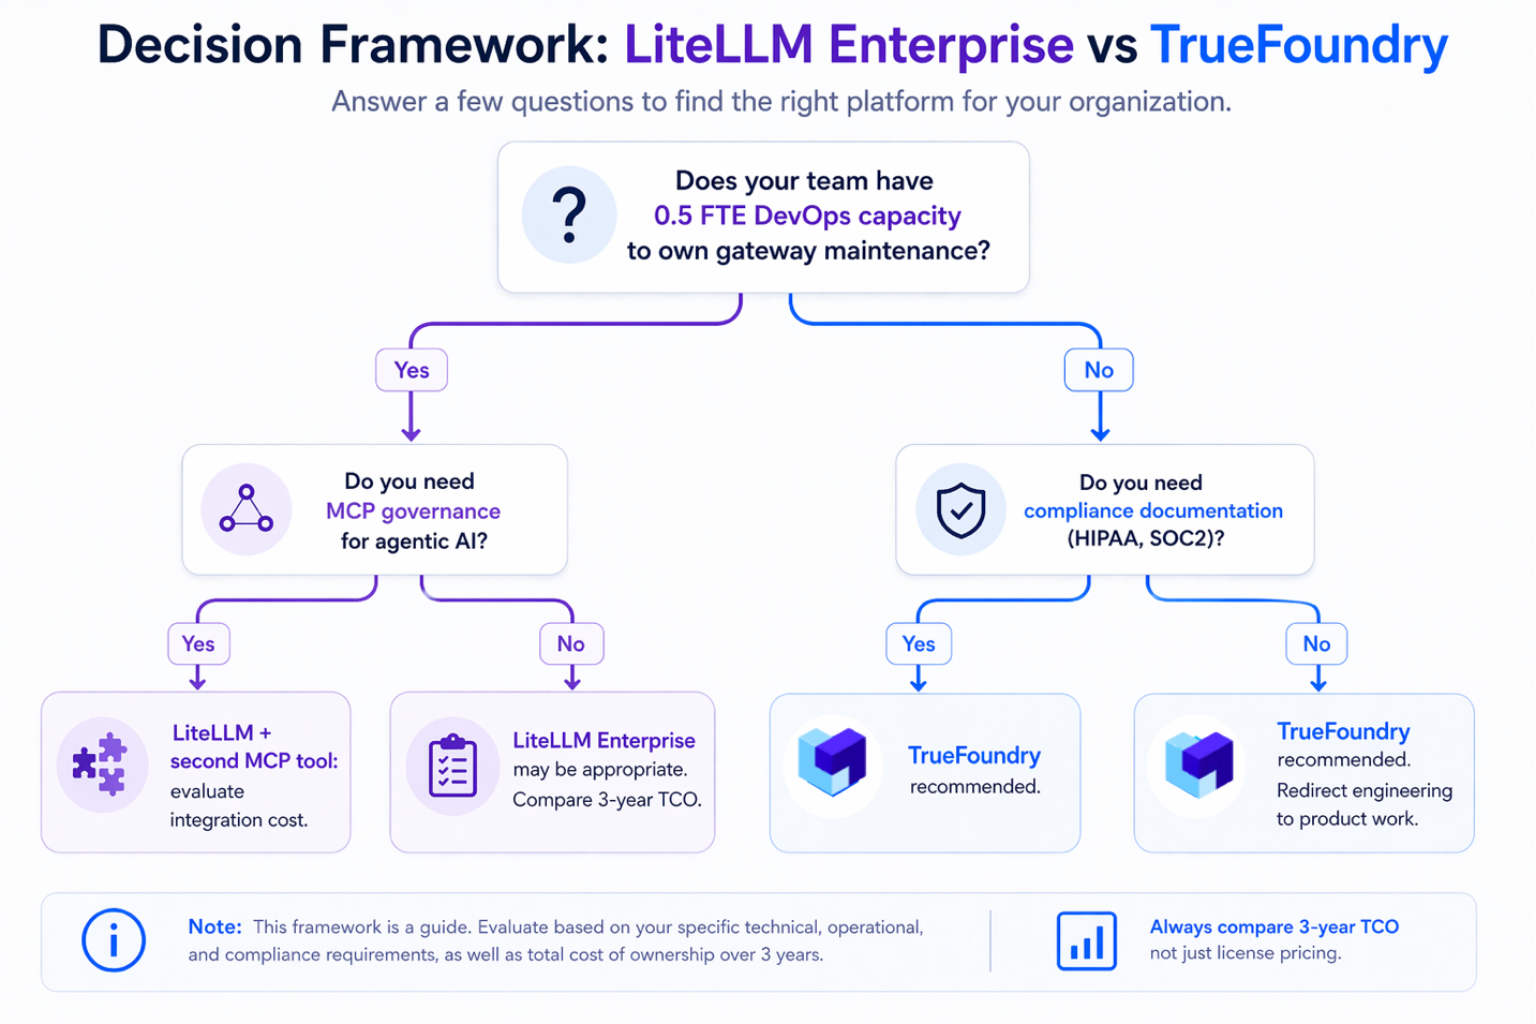
TrueFoundry is geen LiteLLM-vervanger die hetzelfde doet met een ander prijskaartje. Het is een breder platform dat het governance-gat adresseert dat ontstaat wanneer enterprise AI-implementaties volwassen worden en verder gaan dan eenvoudige LLM-proxyrouting naar agentic AI met toolgebruik, multi-cloud-uitrollen en gereguleerde gegevensverwerking.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.



LiteLLM Enterprise Basic, at approximately $250 per month, adds the enterprise management UI, SSO/SAML integration, Prometheus metrics, JWT authentication, LLM guardrails for content filtering, and a dedicated Slack support channel to the open-source feature set. Enterprise Premium, at approximately $30,000 per year, adds priority support with defined SLA response times, dedicated account management, custom feature development, and assistance with compliance certifications for SOC2 and HIPAA.
The practical distinction is support and compliance assistance. Basic gives you the governance features. Premium gives you a vendor partner for enterprise deployment. Verify the current feature breakdown at litellm.ai/enterprise before purchasing, as feature availability changes with releases.
LiteLLM Enterprise is self-hosted in alle niveaus. De licentie dekt de software en support. De klant richt alle infrastructuur zelf in en beheert deze: een proxyserver of -cluster, een PostgreSQL-database voor configuratie en auditlogging, en een Redis-instantie voor caching en rate-limit-tellers. Implementaties met hoge beschikbaarheid vereisen daarbovenop load balancers en databasereplicatie. LiteLLM biedt wel cloud- en self-managed implementatieopties, maar de operationele verantwoordelijkheid ligt bij de klant, ongeacht welk implementatiemodel wordt gekozen.
Enterprises that have migrated from self-managed LiteLLM to managed platforms consistently report 0.25 to 0.5 full-time-equivalent of ongoing engineering capacity consumed by maintenance. Initial deployment takes two to four weeks of senior DevOps time to set up Kubernetes clusters, configure load balancers, establish CI/CD pipelines, and integrate monitoring systems. Ongoing maintenance adds 10 to 20 hours per month for security patches, dependency updates, scaling adjustments, and infrastructure troubleshooting. Incident response for gateway outages falls entirely on the customer's on-call team.
At a fully-loaded senior engineer cost of $250,000 per year, the ongoing maintenance overhead represents $62,500 to $125,000 in annual engineering spend dedicated purely to infrastructure management. This figure grows as the number of teams and use cases on the gateway increases.
Ja. De AI Gateway van TrueFoundry biedt een OpenAI-compatibele API, zodat applicaties gebouwd tegen de uniforme API van LiteLLM naar het gateway-endpoint van TrueFoundry kunnen wijzen zonder applicatiecode te herschrijven. De migratie omvat het bijwerken van endpoint-URL's, het verplaatsen van providercredentials naar de credential vault van TrueFoundry, het configureren van RBAC en teambudgetten in de beheerinterface van TrueFoundry, en het opzetten van SSO-integratie met uw bestaande identity-provider.
Het solutions-team van TrueFoundry biedt migratieondersteuning en kan een gepersonaliseerde TCO-vergelijking opstellen voor teams die de overstap overwegen. De typische migratietijdlijn voor een middelgrote engineeringorganisatie is twee tot vier weken voor de technische migratie, plus een periode van parallel draaien om gedrag te valideren voordat de LiteLLM-implementatie buiten gebruik wordt gesteld.
TrueFoundry's semantic caching matches prompts based on semantic similarity rather than exact string matching, serving cached responses for prompts that are functionally equivalent even when phrased differently. TrueFoundry's documented reduction rate is up to 40% of redundant LLM API calls. LiteLLM's caching implementation uses exact match and does not publish independent benchmarks for semantic similarity reduction rates. Verify current LiteLLM caching capabilities at docs.litellm.ai before comparing.
For organizations with high repetition in query patterns, such as customer support, documentation search, or internal Q&A tools, the semantic caching difference can be material. At $100,000 per month in LLM API spend, a 40% reduction from semantic caching generates $40,000 per month in direct savings, which offsets a significant portion of managed gateway costs.
TrueFoundry's pricing is based on usage and deployment model rather than a fixed published rate for this scale. The fully managed SaaS option eliminates infrastructure costs entirely. The self-hosted gateway plane option runs approximately $600 per month in infrastructure cost for the gateway deployment itself. The full self-hosted control plane plus gateway option runs approximately $800 to $1,000 per month.
For a specific organization with 50 teams and 1 billion tokens per month, TrueFoundry's solutions team will produce a personalized pricing and TCO model that accounts for token volume, team count, compliance requirements, and deployment model. Book a 20-minute call to get the actual numbers for your scenario rather than working from generic estimates.



Het laatste nieuws, artikelen en bronnen in je inbox



















