



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Toen Moonshot AI Kimi K2 als open-source vrijgaf, trok dat de aandacht van de AI-community. Toen ze dit opvolgden met Kimi K2 Thinking, een model dat kon redeneren over honderden tool-calls heen met opmerkelijke coherentie, begonnen professionals er serieus op te letten. Nu heeft Moonshot met Kimi K2.6 de grenzen nog verder verlegd: een state-of-the-art open-source model dat aan de absolute top staat van benchmarks voor coding en long-horizon agentic taken, en wedijvert met de beste closed-source oplossingen ter wereld.
Deze blogpost is een diepgaande duik in wat K2.6 zo opmerkelijk maakt, wat de benchmarkcijfers daadwerkelijk betekenen voor echte workloads, en hoe u het in gebruik kunt nemen zonder een uitroltraject van zes weken.
Kimi K2.6 is het multimodal model van de volgende generatie van Moonshot AI, beschikbaar op Hugging Face en via de Kimi API. Net als zijn voorgangers is het gebouwd op een Mixture-of-Experts (MoE)-architectuur met een context window van 262.144 tokens. K2.6 is echter meer dan een incrementele verbetering — het vertegenwoordigt een betekenisvolle ontwerpverschuiving naar drie zaken die de vorige generatie wisselvallig afhandelde: long-horizon coding, coding-driven design en agent swarm coordination.
Hier is een korte illustratie van wat "long-horizon" in de praktijk betekent. In één benchmarkdemo implementeerde K2.6 autonoom een Qwen3.5-0.8B-model lokaal op een Mac, voerde inference uit in Zig (een niche systeemprogrammeertaal), en verbeterde over meer dan 4.000 tool-calls en 12+ uur aan eengesloten uitvoering de throughput van ~15 naar ~193 tokens per seconde (ongeveer 20% sneller dan LM Studio). Dat is geen chatbot die een vraag beantwoordt; dat is een AI die optreedt als een senior performance engineer gedurende een langdurig traject.
In een afzonderlijke demonstratie herzag K2.6 een 8 jaar oude open-source financiële matching engine tijdens een sessie van 13 uur. Het voerde meer dan 1.000 gerichte code-aanpassingen uit om een throughput-verbetering van 185% op de mediaan en een piek-throughput-winst van 133% te behalen — zonder enige menselijke sturing na de initiële taakspecificatie.
Cijfers zijn belangrijk, maar context is nog belangrijker. Dit is hoe K2.6 presteert op de benchmarks die er het meest toe doen voor agentic productiesystemen:
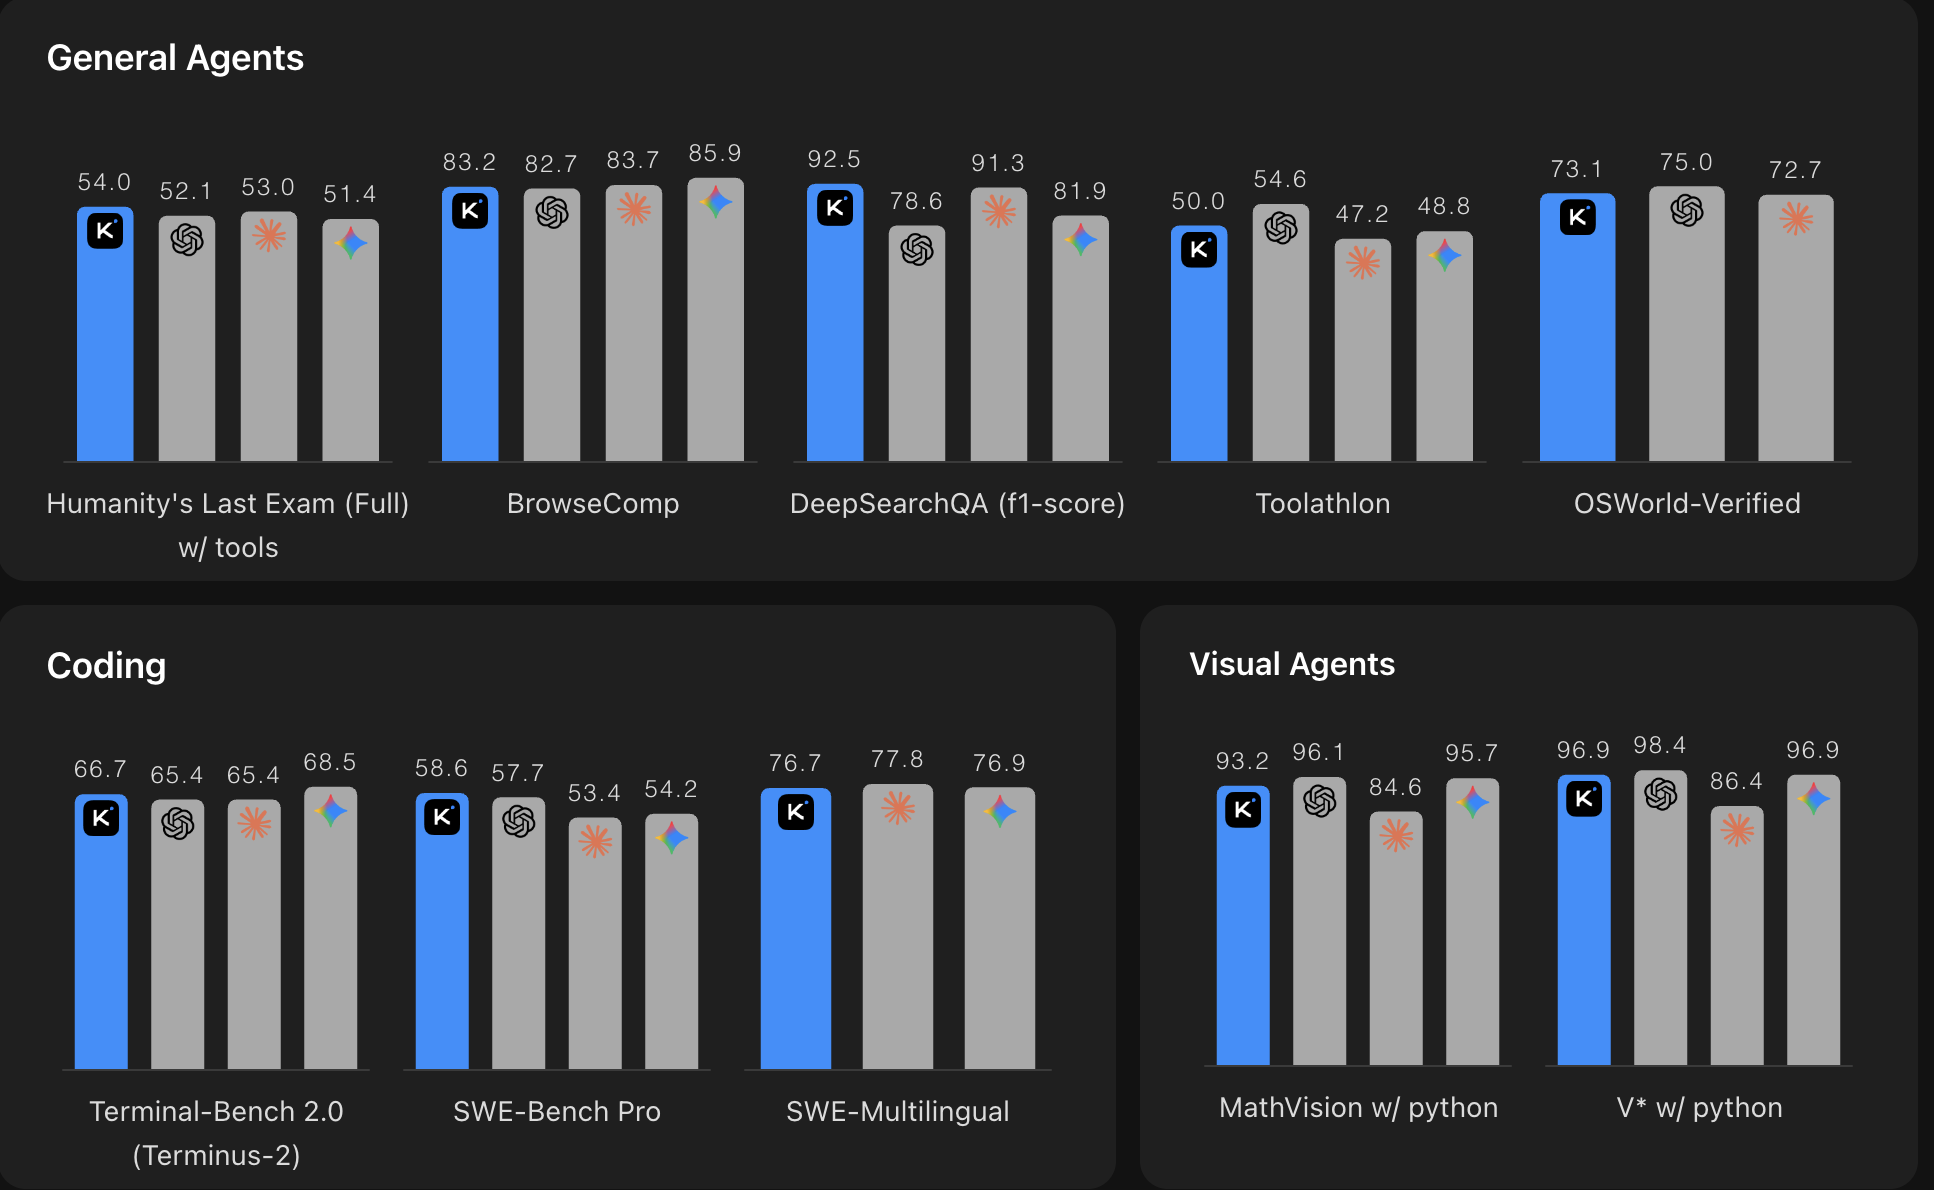
*Bron: Moonshot AI Kimi K2.6 benchmarkvergelijking. Hoger is beter. De grafiek vergelijkt Kimi K2.6 met leidende closed-source modellen op het gebied van algemene agent-, coding- en visual-agent-benchmarks.*
K2.6 is concurrerend met de allerbeste closed-source modellen, waaronder Claude Opus 4.6 en GPT-5.4, op vrijwel elk vlak dat van belang is voor agentic coding en long-horizon taken. En dit doet het als een open-weight model tegen $0,74 / $3,50 per miljoen input/output-tokens, wat een fractie is van de kosten van vergelijkbare propriëtaire alternatieven.
De sprong ten opzichte van Kimi K2.5 is eveneens aanzienlijk: een verbetering van bijna 80% op Toolathlon, ~8 procentpunten op BrowseComp en SWE-Bench Pro. Dit zijn geen marginale winsten.
Enterprise-partners met vroege toegang melden eveneens indrukwekkende resultaten: de CTO van Augmentcode merkte de "chirurgische precisie in grote codebases" van K2.6 op; Vercel zag een verbetering van 50%+ op hun Next.js-benchmark vergeleken met K2.5; en CodeBuddy mat een verbetering van 12% in de nauwkeurigheid van codegeneratie met een succespercentage voor tool-invocatie van 96,6%.
De meeste LLM's zijn prima geschikt voor one-shot codegeneratie. K2.6 is gebouwd voor taken die uren duren: refactorings over meerdere bestanden, cross-language optimalisaties, verbeteringen aan build-pipelines en iteratieve debugging-loops waarbij het model compiler-output moet lezen, zijn hypothese moet aanpassen en het opnieuw moet proberen.
Het model toont een sterke generalisatie over Python, Rust, Go en zelfs zeldzamere talen zoals Zig. Dit is opmerkelijk omdat het suggereert dat het model programmeerconcepten diep genoeg heeft geïnternaliseerd om ze over te dragen, in plaats van alleen patronen uit trainingsdata te memoriseren.
K2.6 kan een enkele prompt in natuurlijke taal omzetten in een volledige, productieklare frontend — niet zomaar een statische mockup, maar een met interactieve elementen, scroll-animaties en authenticatie gekoppeld aan een database. Op Moonshots interne Kimi Design Bench presteert K2.6 beter dan Google AI Studio bij taken met visuele invoer, het bouwen van landingspagina's, full-stack applicatieontwikkeling en algemeen creatief programmeren.
Voor teams die AI-ondersteunde ontwikkelworkflows bouwen, betekent dit in feite een enkel model dat de volledige stack afhandelt: architectuur, logica, UI en deployment-scaffolding.
K2.6 introduceert een grote architectonische uitbreiding van het agent swarm-systeem dat voor het eerst werd getoond in K2.5. De swarm schaalt nu naar 300 sub-agents die gelijktijdig over 4.000 gecoördineerde stappen worden uitgevoerd, vergeleken met 100 agents en 1.500 stappen in K2.5. Dat is niet zomaar een schaalverbetering; het is een kwalitatieve verandering in het type taken dat haalbaar wordt.
Een taak die eerder menselijke orchestratie vereiste (bijvoorbeeld: "onderzoek 100 halfgeleiderbedrijven, bouw vijf kwantitatieve investeringsstrategieën en maak een presentatie in McKinsey-stijl") kan nu als een enkele instructie aan K2.6 worden gegeven en als een compleet eindproduct worden opgeleverd.
Hier stopt het gesprek gewoonlijk: een team leest de benchmarkcijfers, raakt enthousiast en is vervolgens de komende drie weken bezig met het uitzoeken hoe het model daadwerkelijk betrouwbaar geserveerd kan worden.
K2.6 is een groot MoE-model. De context window van 262K betekent dat de geheugenvereisten aanzienlijk zijn. Agentic workloads genereren per definitie zeer wisselende verkeerspatronen: urenlang stilte, en dan plotseling honderden parallelle sub-agents die allemaal tegelijkertijd requests doen. Naïeve deployment-strategieën begeven het onder die belasting.
Dit is het infrastructuurprobleem waarvoor de TrueFoundry AI Gateway is ontworpen.
In plaats van uw eigen GPU-cluster te provisionen, een custom load balancer te bouwen en handmatig inference-parameters af te stellen, laat TrueFoundry u uw applicatie naar een enkel endpoint verwijzen — en regelt de rest. De Gateway routeert requests intelligent over providers, beheert concurrency bij piekbelastingen (zoals een swarm die 300 gelijktijdige sub-agents afvuurt) en biedt u de observability-tools — traces, latency-histogrammen, tokengebruik per team — die u anders zelf zou moeten bouwen.
In onze interne tests met Kimi K2 Thinking verwerkte de Gateway van TrueFoundry 350+ RPS op een enkele vCPU met ~10ms overhead. Voor agentic workloads waarbij een enkele door de gebruiker geïnitieerde taak kan uitwaaieren in tientallen of honderden API-calls, is die speling van groot belang.
Er is ook een praktische organisatorische dimensie. Enterprise-teams die K2.6 gebruiken, hebben typisch meerdere teams — data science, product engineering, platform — die allemaal met hetzelfde model willen experimenteren. De Gateway biedt één single control plane voor rate limiting, kostentoewijzing en access policies, zonder dat elk team zijn eigen API-sleutelbeheer nodig heeft.
De snelste weg om K2.6 te draaien in een beheerde, productieklare omgeving:
1. Via de TrueFoundry AI Gateway (API)
Als u de OpenAI SDK of een OpenAI-compatibele client gebruikt, kunt u overstappen naar K2.6 door simpelweg de model-string aan te passen:
De Gateway regelt de providerselectie, fallback-routing en rate limiting op een transparante manier.
2. Voor Agentic Workloads
De tool-calling interface van K2.6 volgt het standaard OpenAI function calling-schema. Voor long-horizon taken is het aan te raden om:
- `max_tokens` ruim in te stellen (het model kan een groot generatiebudget nuttig gebruiken)
- Streaming in te schakelen om incrementele output van lange tool-chains te ontvangen
- Het tracing-dashboard van TrueFoundry te gebruiken om te visualiseren welke tool-calls tijd kosten en waar de context wordt verbruikt
3. Voor Agent Swarm Orchestration
Als u multi-agent systemen bouwt, biedt de Gateway van TrueFoundry metadata op request-niveau — u kunt de requests van elke sub-agent taggen met een overkoepelend parent-taak-ID en achteraf de volledige execution trace reconstrueren. Dit is van onschatbare waarde voor het debuggen van swarm-gedrag en om te begrijpen waar parallelle uitvoering helpt (of hindert).
Engineering-teams die agentic coding tools bouwen: K2.6 is het eerste open-source model dat serieus concurreert met GPT-5.4 en Claude Opus op SWE-Bench Pro. Als u heeft gewacht op een open-weight model dat productieklare codebase-taken kan afhandelen, dan is dit het moment.
ML-platformteams die modeltoegang beheren: een organisatie die K2.6 evalueert naast andere frontier-modellen profiteert ervan om alles via een enkele gateway te laten verlopen. Met de modelcatalogus-aanpak van TrueFoundry kunt u K2.6 A/B-testen tegen Claude of GPT-5.4 op uw werkelijke workloads, met kosten en latency zij-aan-zij bijgehouden.
Teams met vereisten rond dataresidentie: de open weights van K2.6 betekenen dat het kan worden ingezet op infrastructuur die u zelf beheert. Het deployment-platform van TrueFoundry verzorgt de orchestratie, zodat u enterprise model governance krijgt zonder dat een propriëtaire leverancier zich in uw inference-pad bevindt.
Iedereen die genoeg heeft van de prijzen voor closed-source modellen: bij $0,74 / $3,50 per miljoen tokens en benchmarkprestaties die propriëtaire alternatieven evenaren of overtreffen op de meeste agentic taken, is het argument voor de prijs-kwaliteitverhouding van K2.6 moeilijk te negeren.
Kimi K2.6 is een authentiek frontier-model. Niet zomaar "goed voor een open-source model" — echt concurrerend met de beste modellen ter wereld op de benchmarks die er toe doen voor echt engineering-werk. De betrouwbaarheid bij long-horizon taken, de agent swarm-architectuur en de scherpe prijzen maken het het meest aantrekkelijke open-weight model dat momenteel beschikbaar is voor agentic productiesystemen.
De praktische vraag is niet óf K2.6 het waard is om te gebruiken. Dat is het zeker. De vraag is hoe snel en betrouwbaar u het in productie kunt krijgen. TrueFoundry AI Gateway beantwoordt die vraag — zodat uw team zijn tijd besteedt aan het bouwen mét het model, in plaats van het bouwen van de infrastructuur eromheen.
Probeer het nu: Krijg toegang tot Kimi K2.6 via de [TrueFoundry AI Gateway](https://www.truefoundry.com/ai-gateway), of [boek een demo](https://www.truefoundry.com/book-demo) om te zien hoe het past in de workflow van uw team.
*Alle vermelde benchmarkcijfers zijn afkomstig uit de officiële Kimi K2.6 technische blog en geverifieerde evaluaties van derden op OpenRouter. Infrastructuurprestatiecijfers zijn afkomstig uit interne tests van TrueFoundry.*
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















