



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Elke seconde neemt je AI beslissingen. Agents praten rechtstreeks met je klanten, sturen requests door, voeren tools uit en geven echt geld uit. Het systeem draait, maar meestal heb je geen idee wat er zich daadwerkelijk in afspeelt.
Dat is geen verwijt aan je team. Het is simpelweg de realiteit van AI op schaal draaien. De data is er wel, in je traces, je configs, je logs, maar om erbij te komen moet je precies weten waar je moet kijken, wat je moet filteren en hoe je de punten verbindt over een half dozijn verschillende schermen. Wanneer alles werkt, denk je er niet over na. Wanneer er iets kapotgaat, ben je plotseling aan het context-switchen tussen je monitoring dashboard, je guardrail config, je routing regels en je documentatie, terwijl je probeert te achterhalen wat er misging voordat iemand het escaleert tot een groter probleem.
Dit is waar de meeste teams zich vandaag de dag bevinden. En het is uitputtend.
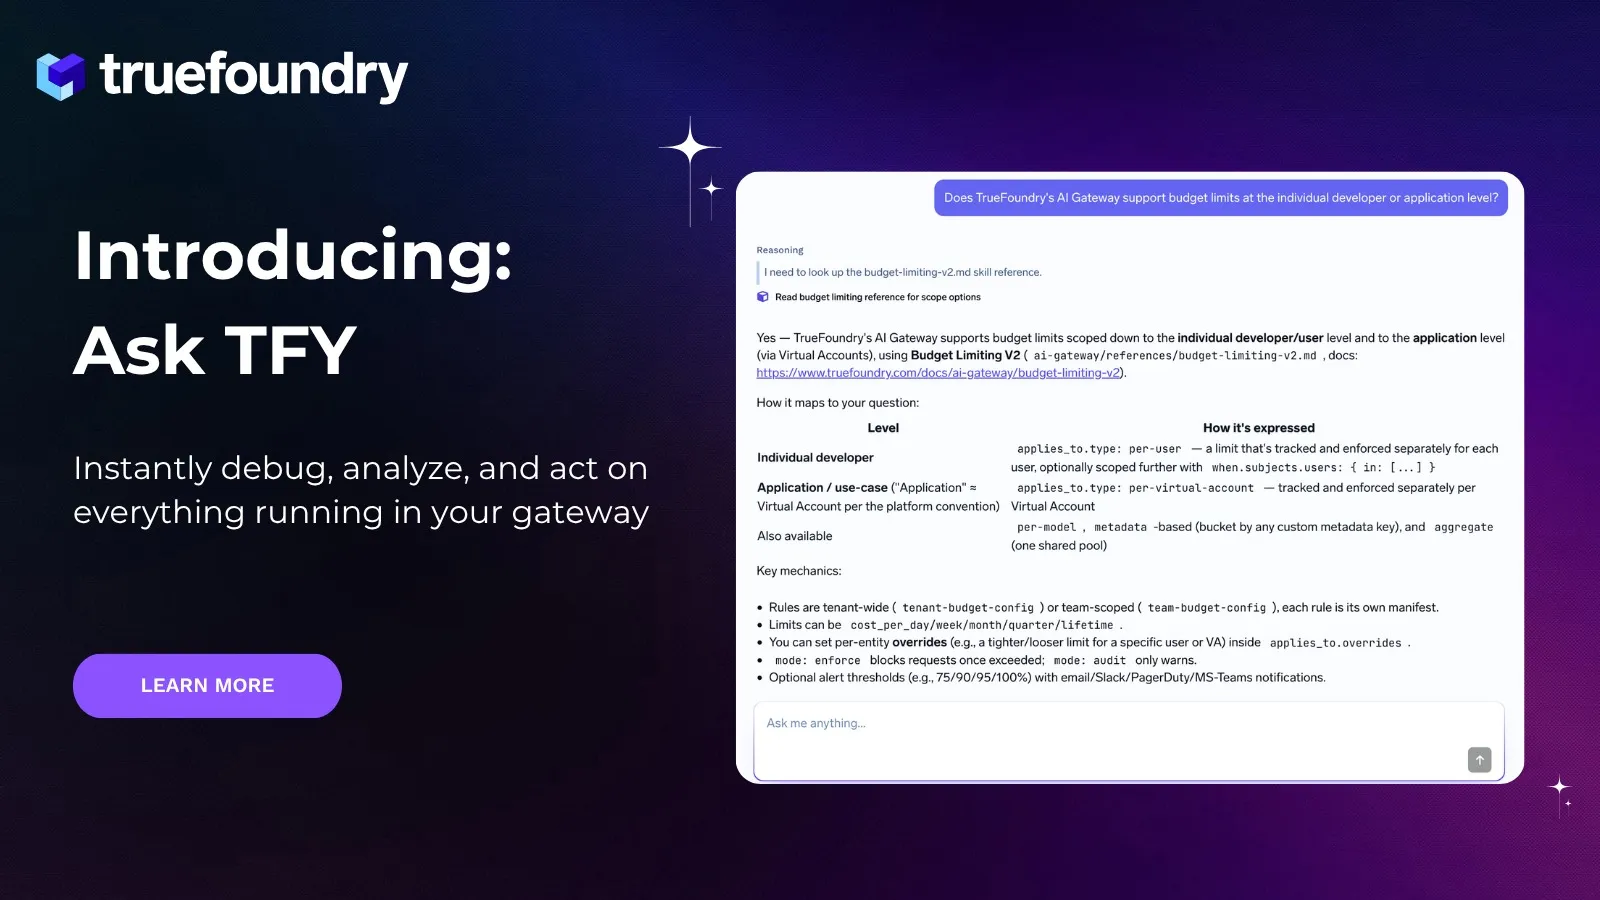
Ask TFY is een nieuwe manier om te interageren met je AI gateway op TrueFoundry. Het is geen zoekbalk en het is geen chatbot die documentatie naar je herhaalt. Het is een agent gebouwd binnen TrueFoundry, met live toegang tot alles wat er in je gateway draait: je models, je traces, je MCP servers, je guardrail configuraties, je budgetregels en je datatoegangsbeleid. Wanneer je iets vraagt, komt het terug met een antwoord dat gegrond is in wat er op dit moment daadwerkelijk in je systeem gebeurt.
Hier is een scenario dat je waarschijnlijk maar al te bekend voorkomt. Je applicatie begint fouten te vertonen. Je weet niet of het een model-probleem is, een routing-probleem, een budgetlimiet die is bereikt, of iets heel anders. Dus begin je te graven, handmatig traces te filteren, te zoeken naar patronen en configs één voor één te controleren.
Met Ask TFY beschrijf je in plaats daarvan het probleem.
"Mijn applicatie vertoont de afgelopen 7 dagen af en toe fouten. Wat is er misgegaan?"

Ask TFY duikt in je trace-historie, classificeert de fouten, identificeert of de problemen aan de client-zijde lagen of veroorzaakt werden door bijvoorbeeld een upstream model provider die uitviel, en brengt het patroon aan het licht. Het vertelt je wat er kapotging en waarom, specifiek en niet generiek. En vervolgens vertelt het je wat je eraan kunt doen.
"Hoe pas ik de configuratie aan om dit veerkrachtiger te maken?"
Het beveelt de juiste oplossing voor jouw setup aan. Misschien is dat het configureren van een virtual model met een fallback. Misschien is het het aanpassen van je routing regels. Omdat het je systeem kent, geeft het je een antwoord dat daadwerkelijk van toepassing is, niet een generieke handleiding voor probleemoplossing.
En vervolgens kun je het de opdracht geven om direct op die aanbeveling te handelen.
"Pas het aanbevolen budget en de fallback-configuratie toe op die agent."
Dat is alles. Je bleef op één plek, stelde drie vragen en het probleem is opgelost. Geen YAML kopiëren van het ene scherm en plakken in het andere. Geen tabbladen wisselen.
Debuggen is één toepassing, maar Ask TFY is net zo nuttig wanneer er zichtbaar niets mis is. De duurste productieproblemen zijn de problemen die stilzwijgend je middelen uitputten of beveiligingsrisico's creëren voordat iemand het doorheeft.
Je kunt bijvoorbeeld vragen hoe goed je prompt caching op provider-niveau daadwerkelijk wordt benut. Het geeft je niet zomaar een getal. Het vertelt je welke specifieke requests de cache missen en precies waar je het cache-blok moet toevoegen om het op te lossen. Dat is het soort inzicht waar een ervaren engineer handmatig een uur over zou doen om te achterhalen, en de meeste teams nemen de moeite niet eens omdat het niet dringend genoeg voelt totdat de rekening binnenkomt.

Of vraag naar de kosten. Geef een tijdsbereik op, geef aan hoe je de uitgaven wilt uitsplitsen — per developer, per applicatie, per model — en het genereert de analyse en stelt een budgetconfiguratie voor die je direct kunt toepassen.
De vragen die er het meest toe doen in AI operations zijn zelden de vragen waar standaard dashboards voor zijn gebouwd. Observability tools tonen je wat er is gebeurd. Ask TFY helpt je begrijpen waarom, te beslissen wat je moet doen en het vervolgens uit te voeren, zonder het gesprek te verlaten.
Er is geen context die opnieuw opgebouwd moet worden tussen tabbladen, geen handmatige kruisverwijzingen, geen vertaalslag van wat je in de monitoring vond naar wat er in de config moet veranderen. Ask TFY overziet dat allemaal tegelijk en werkt daaraan namens jou.

Het weet ook meer dan alleen jouw data. Vraag het iets dat verder gaat dan je gateway, zoals hoe een nieuwe library van derden integreert met jouw setup, wat de API van een specifieke model provider verwacht, of hoe je een configuratie opbouwt die je nog nooit eerder hebt ingesteld, en het put uit de documentatie van TrueFoundry en zoekt op het web om de hiaten op te vullen.
De volgende keer dat je moet begrijpen wat je AI daadwerkelijk doet in productie, of snel actie moet ondernemen, vraag het gewoon aan Ask TFY.
Ask TFY is nu beschikbaar in TrueFoundry AI Gateway. Meld je nu aan om aan de slag te gaan.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















