



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Het implementeren van Generatieve AI op Google Cloud Platform (GCP) vereist de orchestratie van een complexe reeks bouwstenen: Google Kubernetes Engine (GKE), Cloud TPUs en Vertex AI. Hoewel GCP de ruwe rekenkracht levert, vereist het verbinden van deze elementen tot een compliant Internal Developer Platform (IDP) aanzienlijk maatwerk op het gebied van engineering.
TrueFoundry fungeert als de infrastructuuroverlay. Wij verzorgen de orchestratie, terwijl u de controle behoudt over de VPC en dataresidentie. Dit artikel geeft een gedetailleerd overzicht van onze integratiepatronen met GCP, met name wat betreft de split-plane-architectuur, Workload Identity Federation en TPU-beheer.
We gebruiken een split-plane-architectuur om de beheerinterface te scheiden van uw workload-executie-omgeving.
Beveiligingsgrens We vereisen geen inkomende firewallregels. De Agent in uw cluster initieert een veilige, uitsluitend uitgaande WebSocket- of gRPC-stream naar onze Control Plane. Deze peilt naar deployment-manifesten en stuurt telemetrie door. Uw VPC blijft afgeschermd voor extern inkomend verkeer.
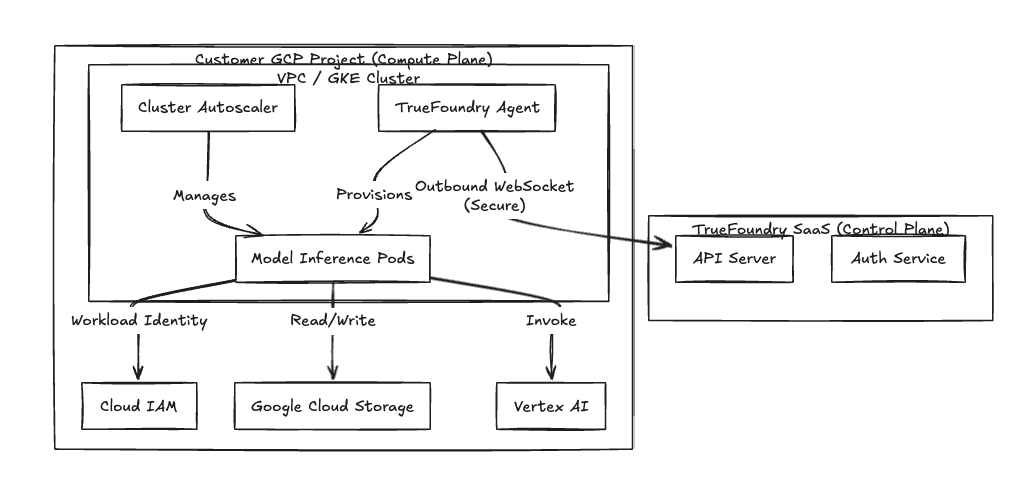
Fig 1: De Split-Plane-architectuur isoleert dataverwerking binnen de VPC van de klant.
Voor maximale prestaties configureren we de compute plane zo dat deze gebruikmaakt van VPC-native clusters met Alias IPs. Alle compute-resources bevinden zich in private subnets.
Ingress (Inference-verzoeken) Applicatieverkeer komt de VPC binnen via Cloud Load Balancing (meestal een Global External ALB). De ALB beëindigt TLS en stuurt verzoeken door naar de Istio Ingress Gateway die binnen het GKE-cluster draait.
Private Google Access Om compliance te waarborgen, wordt verkeer naar Google API's (Cloud Storage, Vertex AI) gerouteerd via Private Google Access. Hierdoor blijft het verkeer tussen inference pods en door GCP beheerde diensten op het Google-netwerkbackbone, zonder het openbare internet te gebruiken.
Egress GKE worker nodes hebben uitgaande toegang nodig om container images op te halen uit Artifact Registry. We routen dit verkeer via Cloud NAT dat is gekoppeld aan de private subnets.
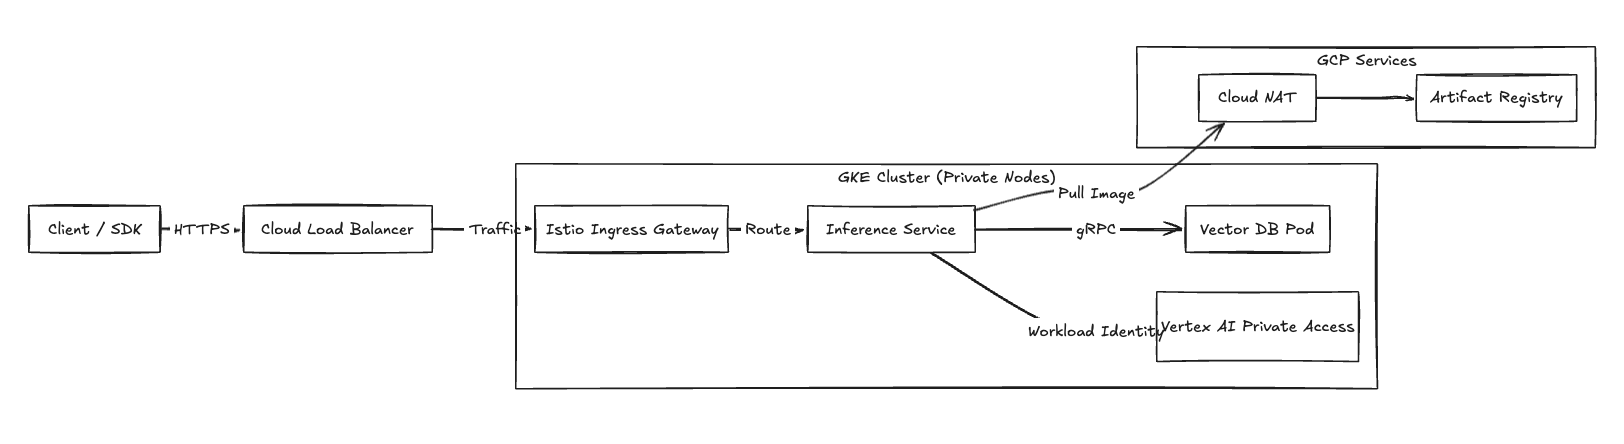
Fig 2: Netwerkverkeersstroom met details over ingress en private connectiviteit.
Wij dwingen het verwijderen van statische Service Account-sleutels (.json-bestanden) af. TrueFoundry implementeert GKE Workload Identity voor alle workload-authenticatie.
De Authenticatievolgorde
Als een pod gecompromitteerd raakt, blijft de mogelijke schade strikt beperkt tot de IAM-rollen die aan die specifieke GSA zijn toegewezen.
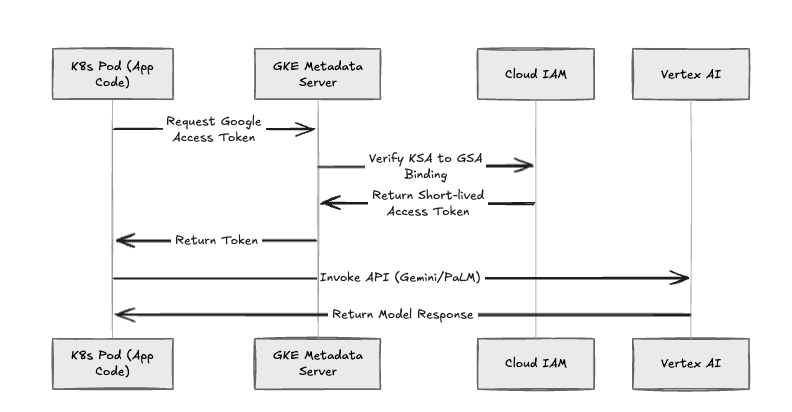
Fig 3: De GKE Workload Identity-authenticatiestroom.
We integreren met GKE Node Pools om NVIDIA GPU's en Cloud TPU's te orchestreren.
TPU-orchestratie Scheduling op TPU's vereist het verwerken van specifieke topologiebeperkingen. TrueFoundry beheert de nodeSelector en tolerations die nodig zijn om pods in te plannen op TPU-slices (bijv. v4-8, v5e). We injecteren automatisch de vereiste drivers en resource-limieten in het deployment-manifest, waardoor de low-level Kubernetes-configuratie wordt geabstraheerd.
Spot VM-beheer Voor batchverwerking of ontwikkel-workloads beheren we Spot VMs om kosten te besparen (typisch 60-90% vergeleken met on-demand).
Het beheren van afzonderlijke sleutels voor modellen zoals Gemini Pro zorgt voor operationele overhead. TrueFoundry biedt een AI Gateway die fungeert als een geünificeerde API-interface.
Deze integratie stelt uw team in staat om de hardware-voordelen van GCP—met name TPU's en netwerken met hoge doorvoer—volledig te benutten, zonder vast te lopen in de operationele wrijving van ruw Kubernetes-beheer. TrueFoundry fungeert als een krachtvermenigvuldiger voor uw infrastructuur: wij abstraheren de complexiteit van GKE-orchestratie, terwijl u de absolute controle behoudt over beveiliging en dataresidentie. Deze balans stelt u in staat om GenAI-workloads onmiddellijk in productie te nemen, waardoor infrastructuur verandert van een beperking in een strategisch snelheidsvoordeel.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















