



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



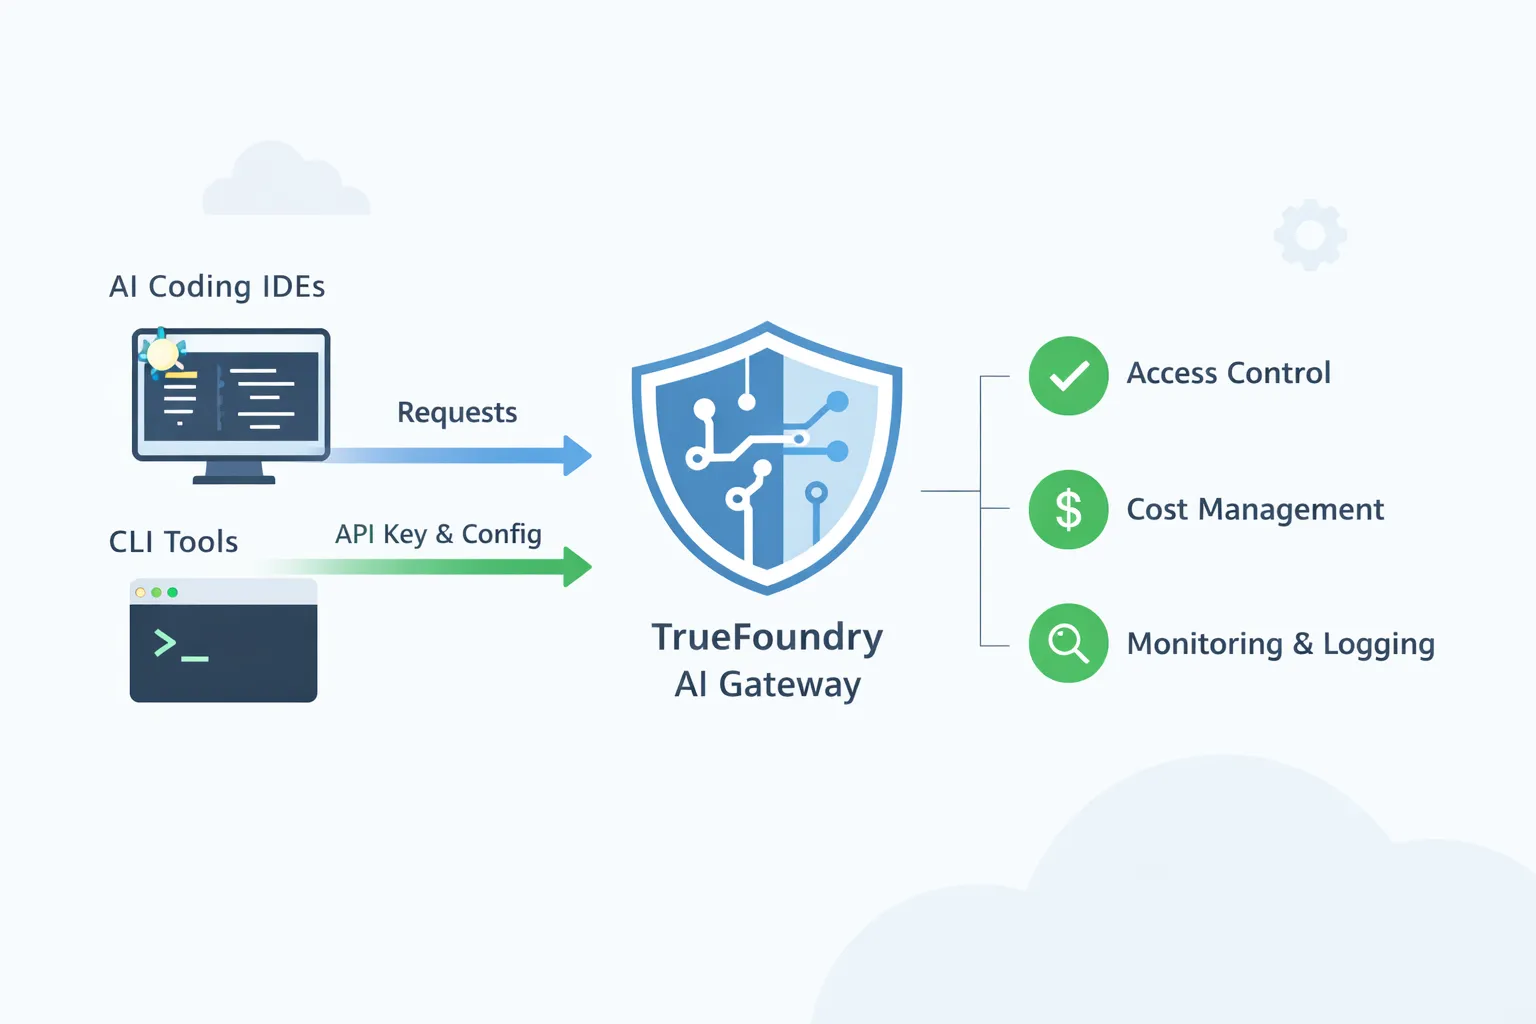
De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
AI-codingtools maken nu deel uit van de dagelijkse ontwikkeling. Ontwikkelaars gebruiken producten zoals Claude Code, Cline, Cursor, Gemini CLI, OpenAI Codex CLI, Qwen Code CLI, Roo Code en Goose om code te genereren, te refactoren, te debuggen en grote codebases uit te leggen, rechtstreeks vanuit de editor of terminal. Het probleem in de meeste ondernemingen is niet de adoptie. Het probleem is governance. Elke tool kan communiceren met een of meer modelvendors. Elke tool slaat sleutels vaak lokaal op. Teams eindigen snel met tientallen ongebeheerde toegangspunten tot externe modellen. Dat brengt reële risico's met zich mee rond welke modellen zijn goedgekeurd, waar code en context naartoe worden gestuurd, hoe uitgaven worden toegewezen en hoe incidenten worden onderzocht. Het maakt de betrouwbaarheid ook moeilijker omdat routing en fallbacks inconsistent zijn over verschillende tools.
Als je dit handmatig probeert op te lossen, eindig je meestal met het bouwen van een interne proxy waar elke IDE en CLI naar verwijst. Die proxy heeft authenticatie, autorisatie, allowlists voor goedgekeurde modellen, providerrouting, auditlogs, rate limiting, budgetbeheer en observability nodig. Het moet ook compatibel zijn met de API's die deze tools verwachten. Veel tools spreken een OpenAI-compatibele API, maar ze hebben ook eigenaardigheden rond modelnaamgeving en speciaal gedrag waarmee je rekening moet houden.
Hier is een klein dummy-voorbeeld dat laat zien waarom dit echt engineeringwerk wordt. Het is niet geschikt voor productie. Het is alleen bedoeld om de vorm van het probleem te tonen.
from fastapi import FastAPI, Request, HTTPException
import time
import httpx
app = FastAPI()
APPROVED_MODELS = {
"gpt-4o": {"provider": "openai", "target": "gpt-4o"},
"claude-3-5-sonnet": {"provider": "anthropic", "target": "claude-3-5-sonnet"},
}
OPENAI_URL = "https://api.openai.com/v1/chat/completions"
ANTHROPIC_URL = "https://api.anthropic.com/v1/messages"
def verify_token(auth_header: str) -> dict:
# In reality this is JWT validation against Okta or your IdP.
if not auth_header or not auth_header.startswith("Bearer "):
raise HTTPException(status_code=401, detail="missing token")
return {"user": "alice", "team": "platform"}
@app.post("/v1/chat/completions")
async def chat_completions(req: Request):
user_ctx = verify_token(req.headers.get("authorization"))
body = await req.json()
model = body.get("model")
if model not in APPROVED_MODELS:
raise HTTPException(status_code=403, detail="model not approved")
route = APPROVED_MODELS[model]
started = time.time()
async with httpx.AsyncClient(timeout=60) as client:
if route["provider"] == "openai":
upstream = await client.post(
OPENAI_URL,
headers={"Authorization": "Bearer " + "UPSTREAM_OPENAI_KEY"},
json={**body, "model": route["target"]},
)
else:
# You would also need request and response transforms here.
upstream = await client.post(
ANTHROPIC_URL,
headers={"x-api-key": "UPSTREAM_ANTHROPIC_KEY"},
json={"model": route["target"], "messages": body.get("messages", [])},
)
latency_ms = int((time.time() - started) * 1000)
# In reality you would emit OpenTelemetry traces and structured logs here.
print("llm_request", {"user": user_ctx["user"], "model": model, "latency_ms": latency_ms})
return upstream.json()
Zelfs in deze vereenvoudigde versie zie je ontbrekende onderdelen. Je hebt nog steeds robuuste transformaties over vendors heen nodig, ondersteuning voor streaming, retries, fallbacks, veilige pass-through-headers, scoping voor tenants en teams, en duurzame auditlogs. Je hebt ook een configuratiesysteem nodig dat schaalt over teams heen.
TrueFoundry AI Gateway is ontworpen om dat gedeelde controlepunt te zijn. IDE's en CLI's blijven de workflows gebruiken die ontwikkelaars al prettig vinden, maar het verkeer wordt geleid via één gecentraliseerde, beheerde gateway. De gateway wordt de plek waar platformteams toegang tot goedgekeurde modellen afdwingen, beleid toepassen en volledig inzicht krijgen in het gebruik.
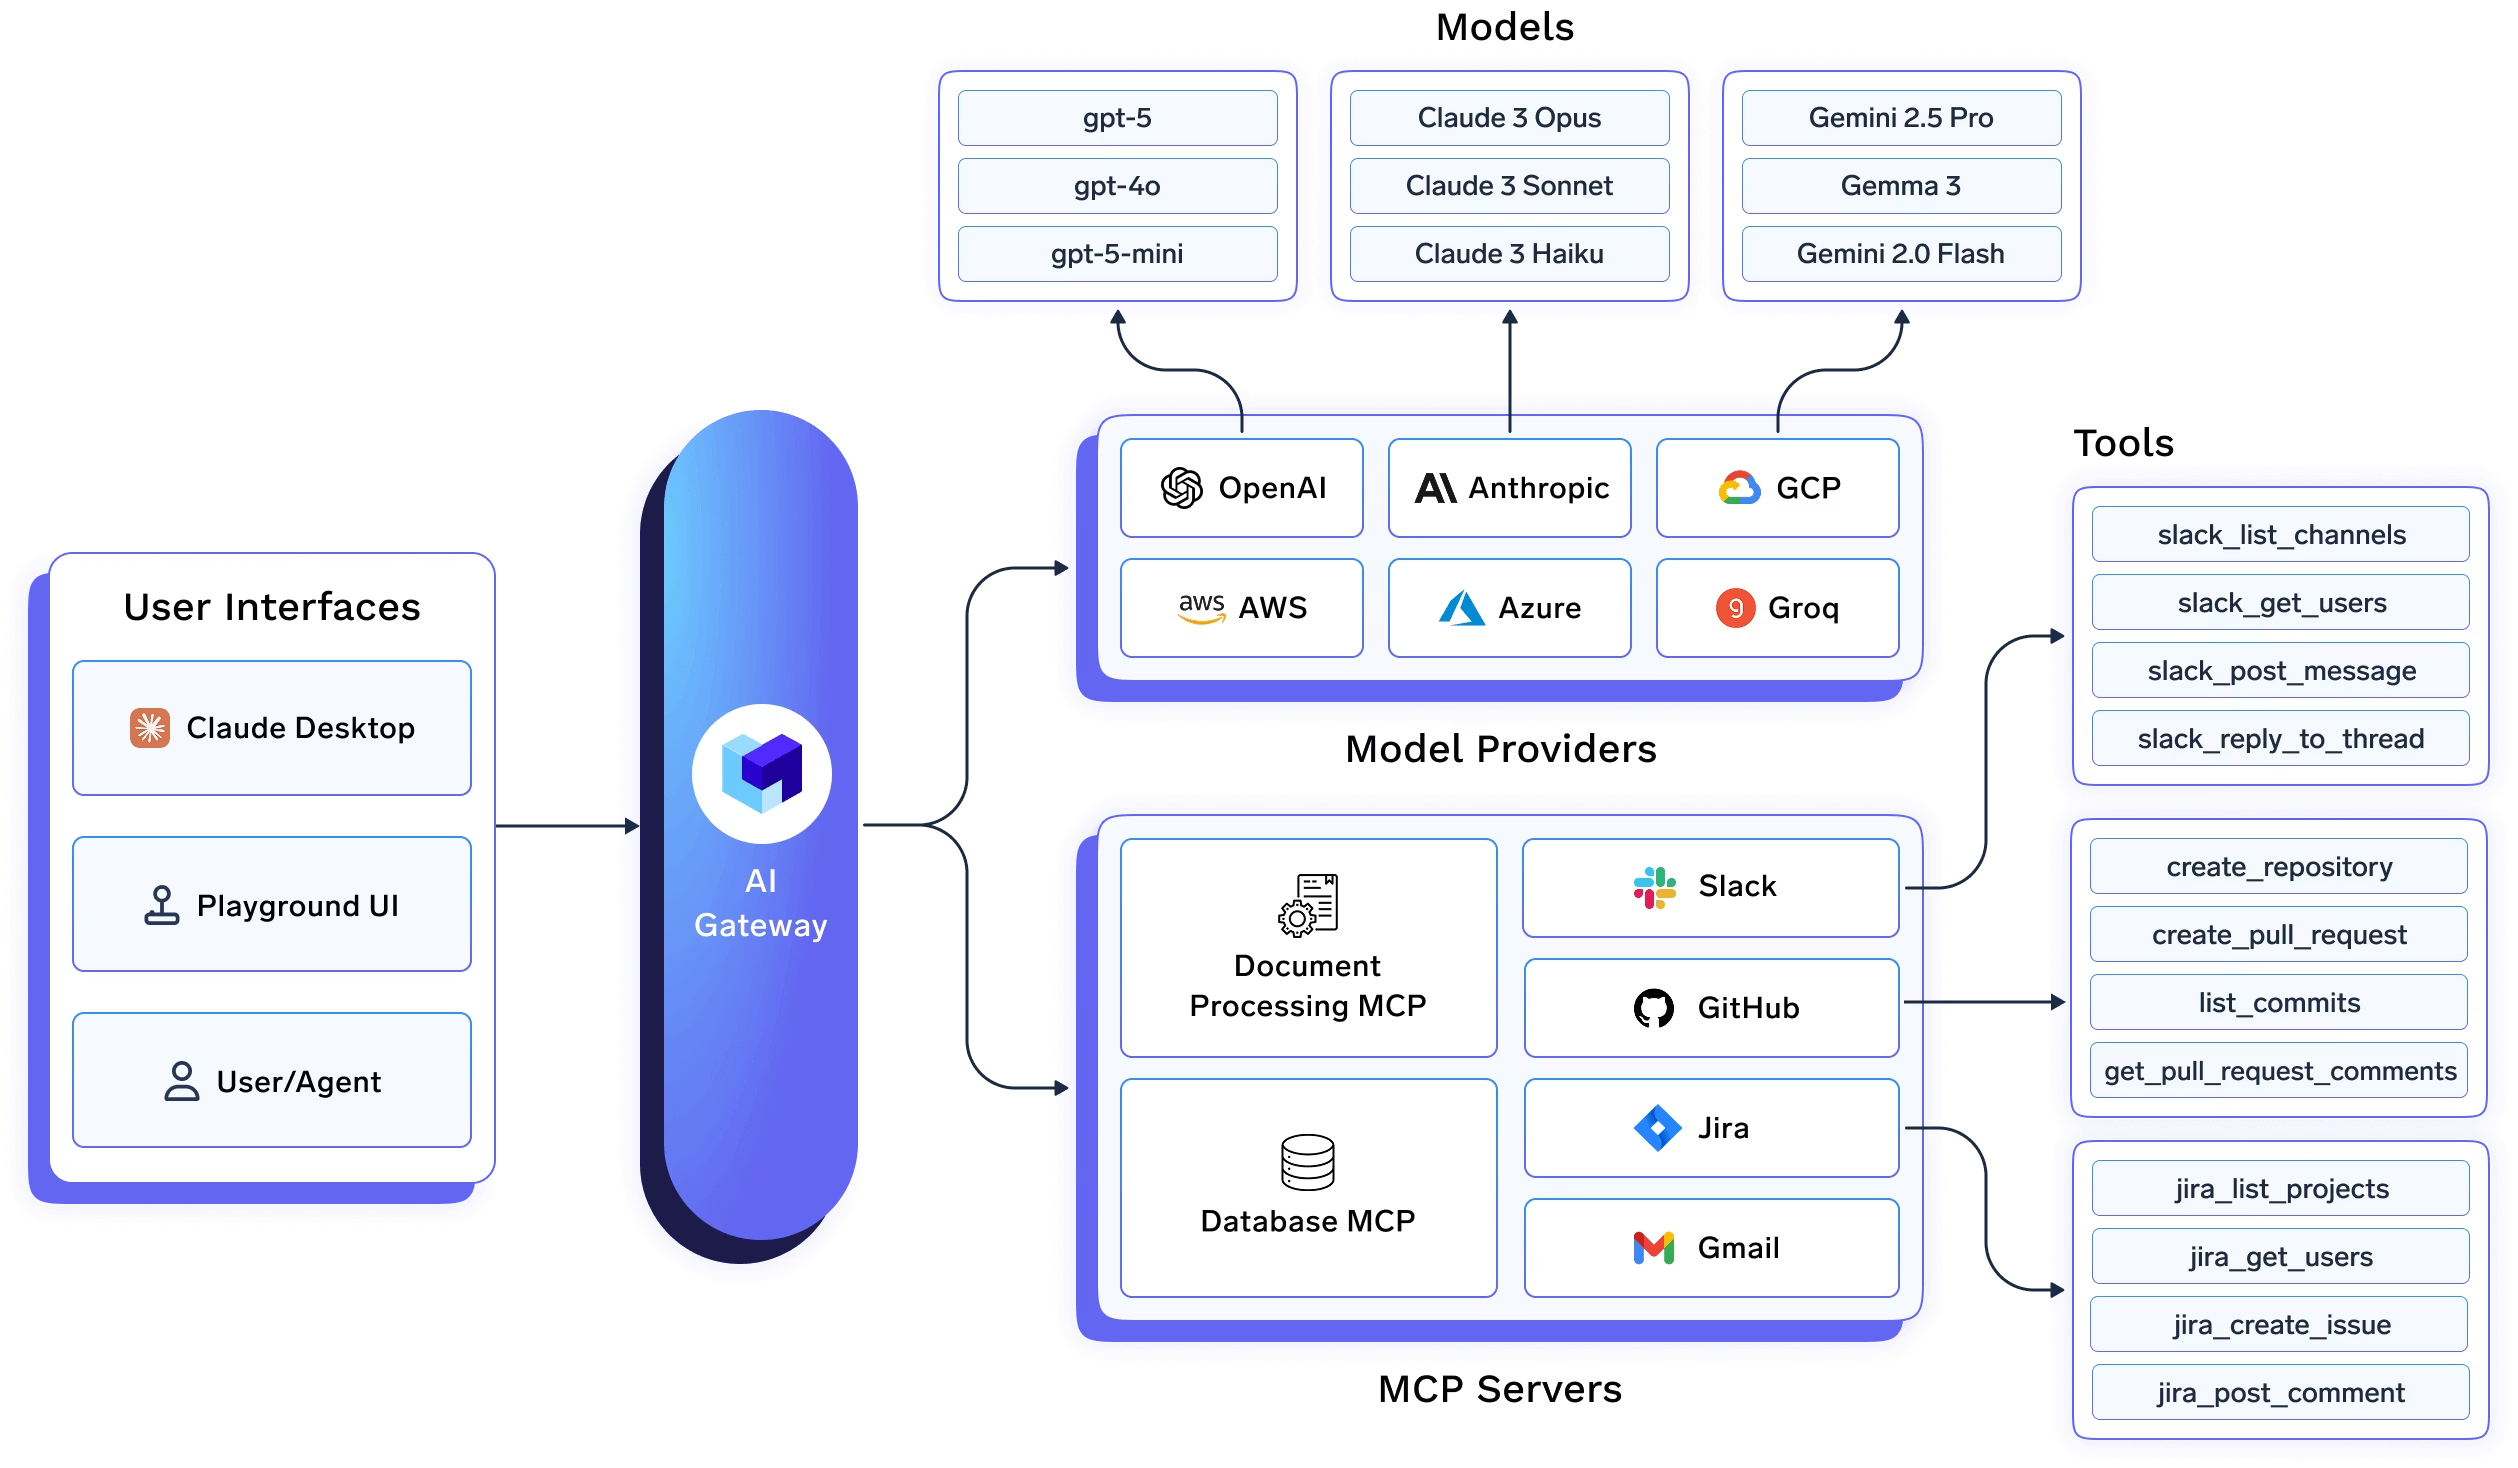
Een kernthema in de IDE-handleidingen is eenvoudig. Je haalt de basis-URL en de modelnaam uit de TrueFoundry AI Gateway playground. Vervolgens configureer je de IDE of CLI om die basis-URL en een TrueFoundry-token te gebruiken.
De meeste AI-coding-IDE's en desktoptools kunnen worden gericht op één OpenAI-compatibel eindpunt. De TrueFoundry AI Gateway geeft je dat eindpunt. Je begint in de Gateway playground en kopieert het samengevoegde fragment. Dit fragment geeft je de basis-URL en de modelnaam die je moet gebruiken. Je opent vervolgens de IDE-instellingen en selecteert een provideroptie die een aangepaste basis-URL ondersteunt. Veel tools noemen dit OpenAI-compatibel. Je plakt de Gateway basis-URL. Je plakt een TrueFoundry-token als de API-sleutel. Het token kan een persoonlijk token zijn voor een ontwikkelaar of een virtueel accounttoken voor gedeeld of geautomatiseerd gebruik. TrueFoundry documenteert beide opties en raadt het virtuele accounttoken aan voor productieomgevingen. Lees hier meer
Sommige IDE's werken het beste wanneer ze korte, standaard modelnamen zien, zoals gpt 4o. De modelnamen van TrueFoundry zijn vaak volledig gekwalificeerd. De aanbevolen oplossing is om een routing- of load balancing-regel te definiëren in de Gateway, zodat de IDE de korte naam blijft gebruiken terwijl de Gateway deze koppelt aan het volledig gekwalificeerde doelmodel. Cursor en Codex documenteren beide dit patroon omdat ze interne logica hebben die gekoppeld is aan standaard modelnamen. Cursor-documentatie
Er kunnen ook netwerkbeperkingen zijn. Cursor documenteert dat de verzoekstroom via Cursor-servers kan lopen. Dat betekent dat de Gateway-URL bereikbaar moet zijn vanuit de infrastructuur van Cursor. In de praktijk heeft het Gateway-eindpunt publieke bereikbaarheid nodig om Cursor te laten werken zoals beschreven in de handleiding.
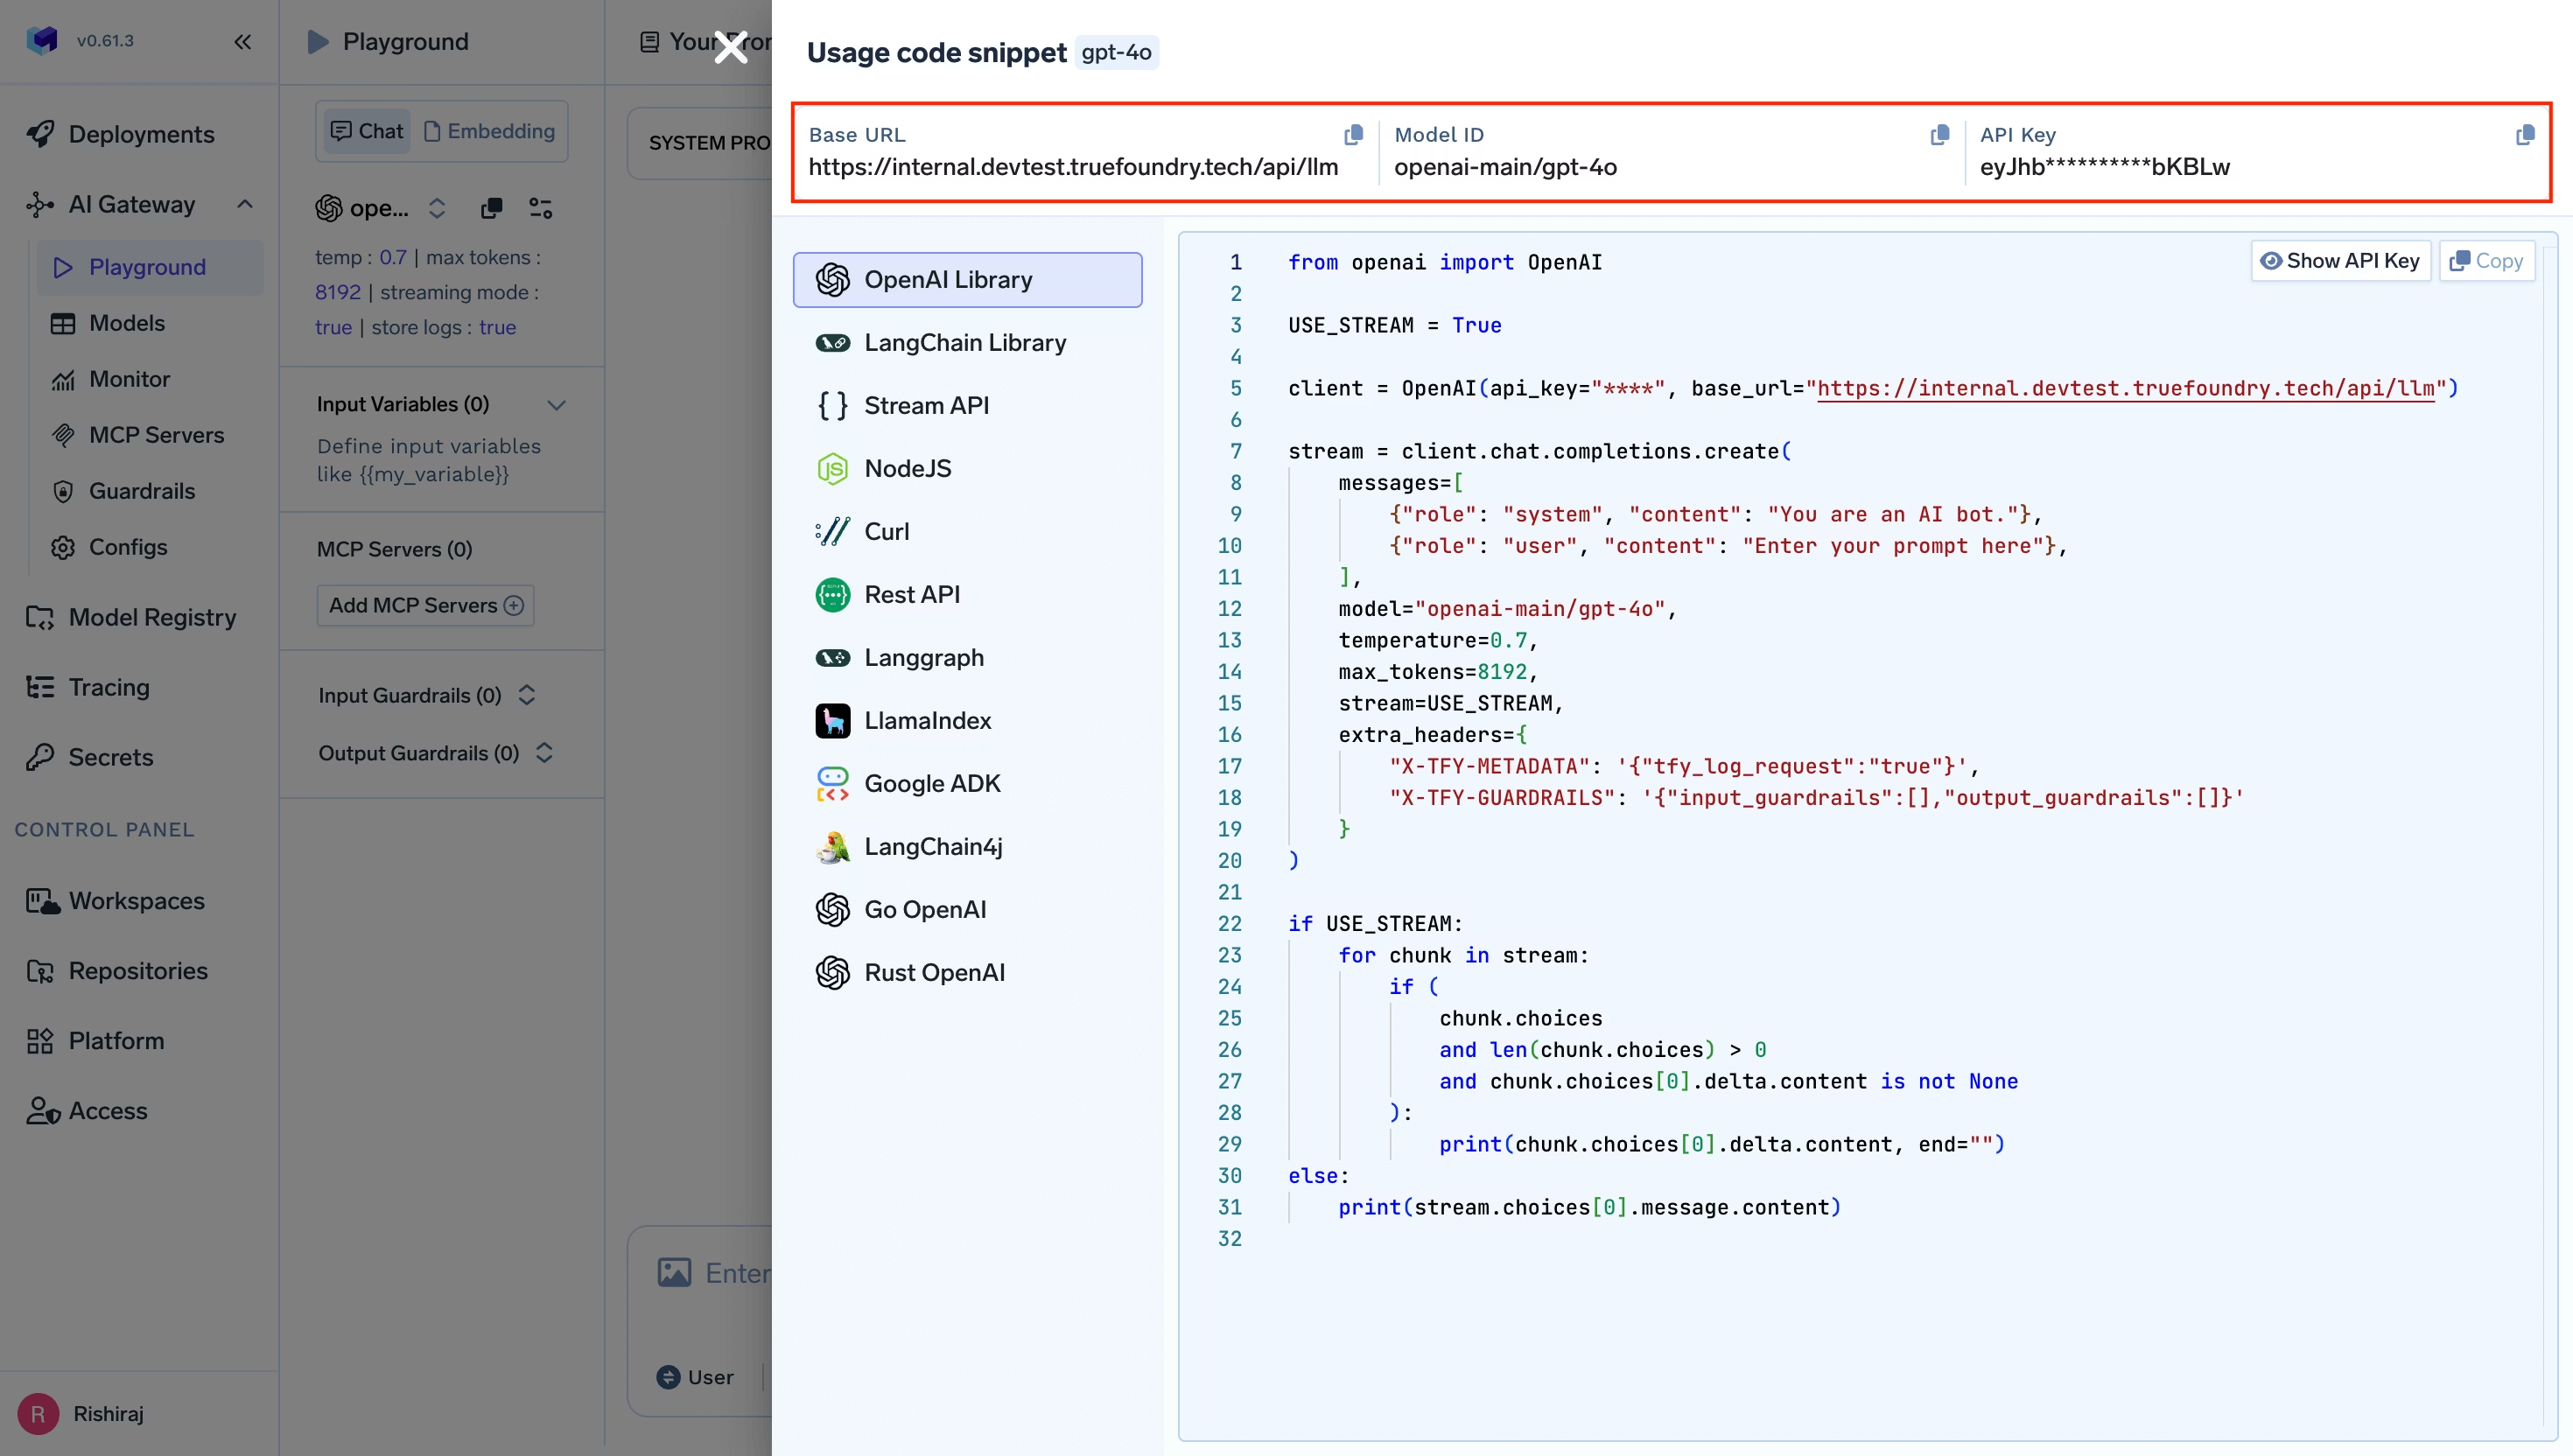
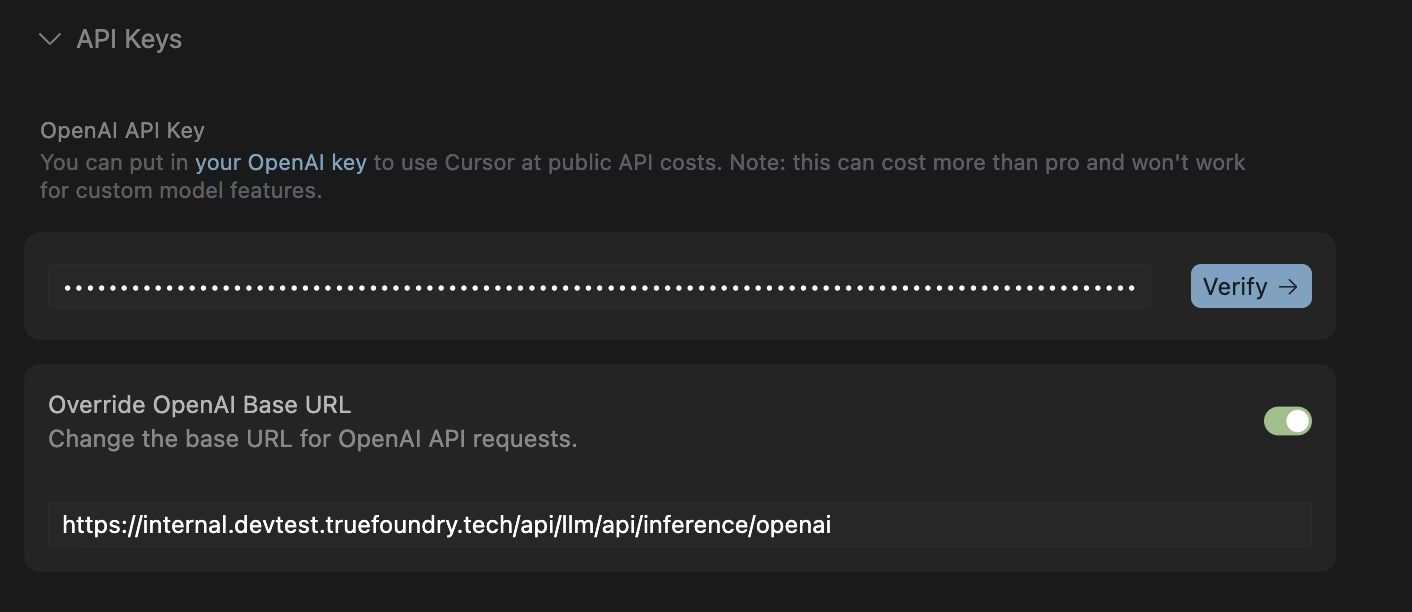
CLI-tools integreren meestal via omgevingsvariabelen of een lokaal configuratiebestand. Voor OpenAI-compatibele CLI's is het gebruikelijke patroon om OPENAI_BASE_URL in te stellen op het TrueFoundry Gateway-eindpunt en OPENAI_API_KEY in te stellen op een TrueFoundry-token. TrueFoundry documenteert dit als een ondersteunde authenticatiebenadering voor de Gateway. Lees meer: Authenticatie
Sommige CLI's gebruiken providerspecifieke variabelen. Gemini CLI gebruikt een Gemini basis-URL en een Gemini API-sleutel. De TrueFoundry-handleiding laat zien hoe je GOOGLE_GEMINI_BASE_URL instelt op een TrueFoundry Gemini-proxy-URL en GEMINI_API_KEY instelt op een TrueFoundry-token, zodat elk verzoek via de Gateway stroomt. Lees meer: Gemini-cli
Andere CLI's vertrouwen op een settings json-bestand. Claude Code wordt geconfigureerd via een settings.json-bestand dat env-waarden instelt voor de basis-URL en auth-headers. De TrueFoundry-handleiding laat zien dat ANTHROPIC_BASE_URL naar de Gateway wijst en gebruikt een Bearer-token in aangepaste headers, zodat het verkeer van Claude Code via de Gateway wordt beheerd. Lees meer: Claude Code
Sommige tools hebben ook de eerder genoemde standaard naamkoppeling nodig. De handleiding voor Codex CLI legt uit dat Codex standaard modelnamen verwacht en dat er fouten kunnen optreden bij volledig gekwalificeerde namen. Het raadt aan om Gateway-routing te gebruiken, zodat je gpt 5 aanroept in de CLI terwijl de Gateway achter de schermen naar het juiste volledig gekwalificeerde model routeert. Lees meer: Codex
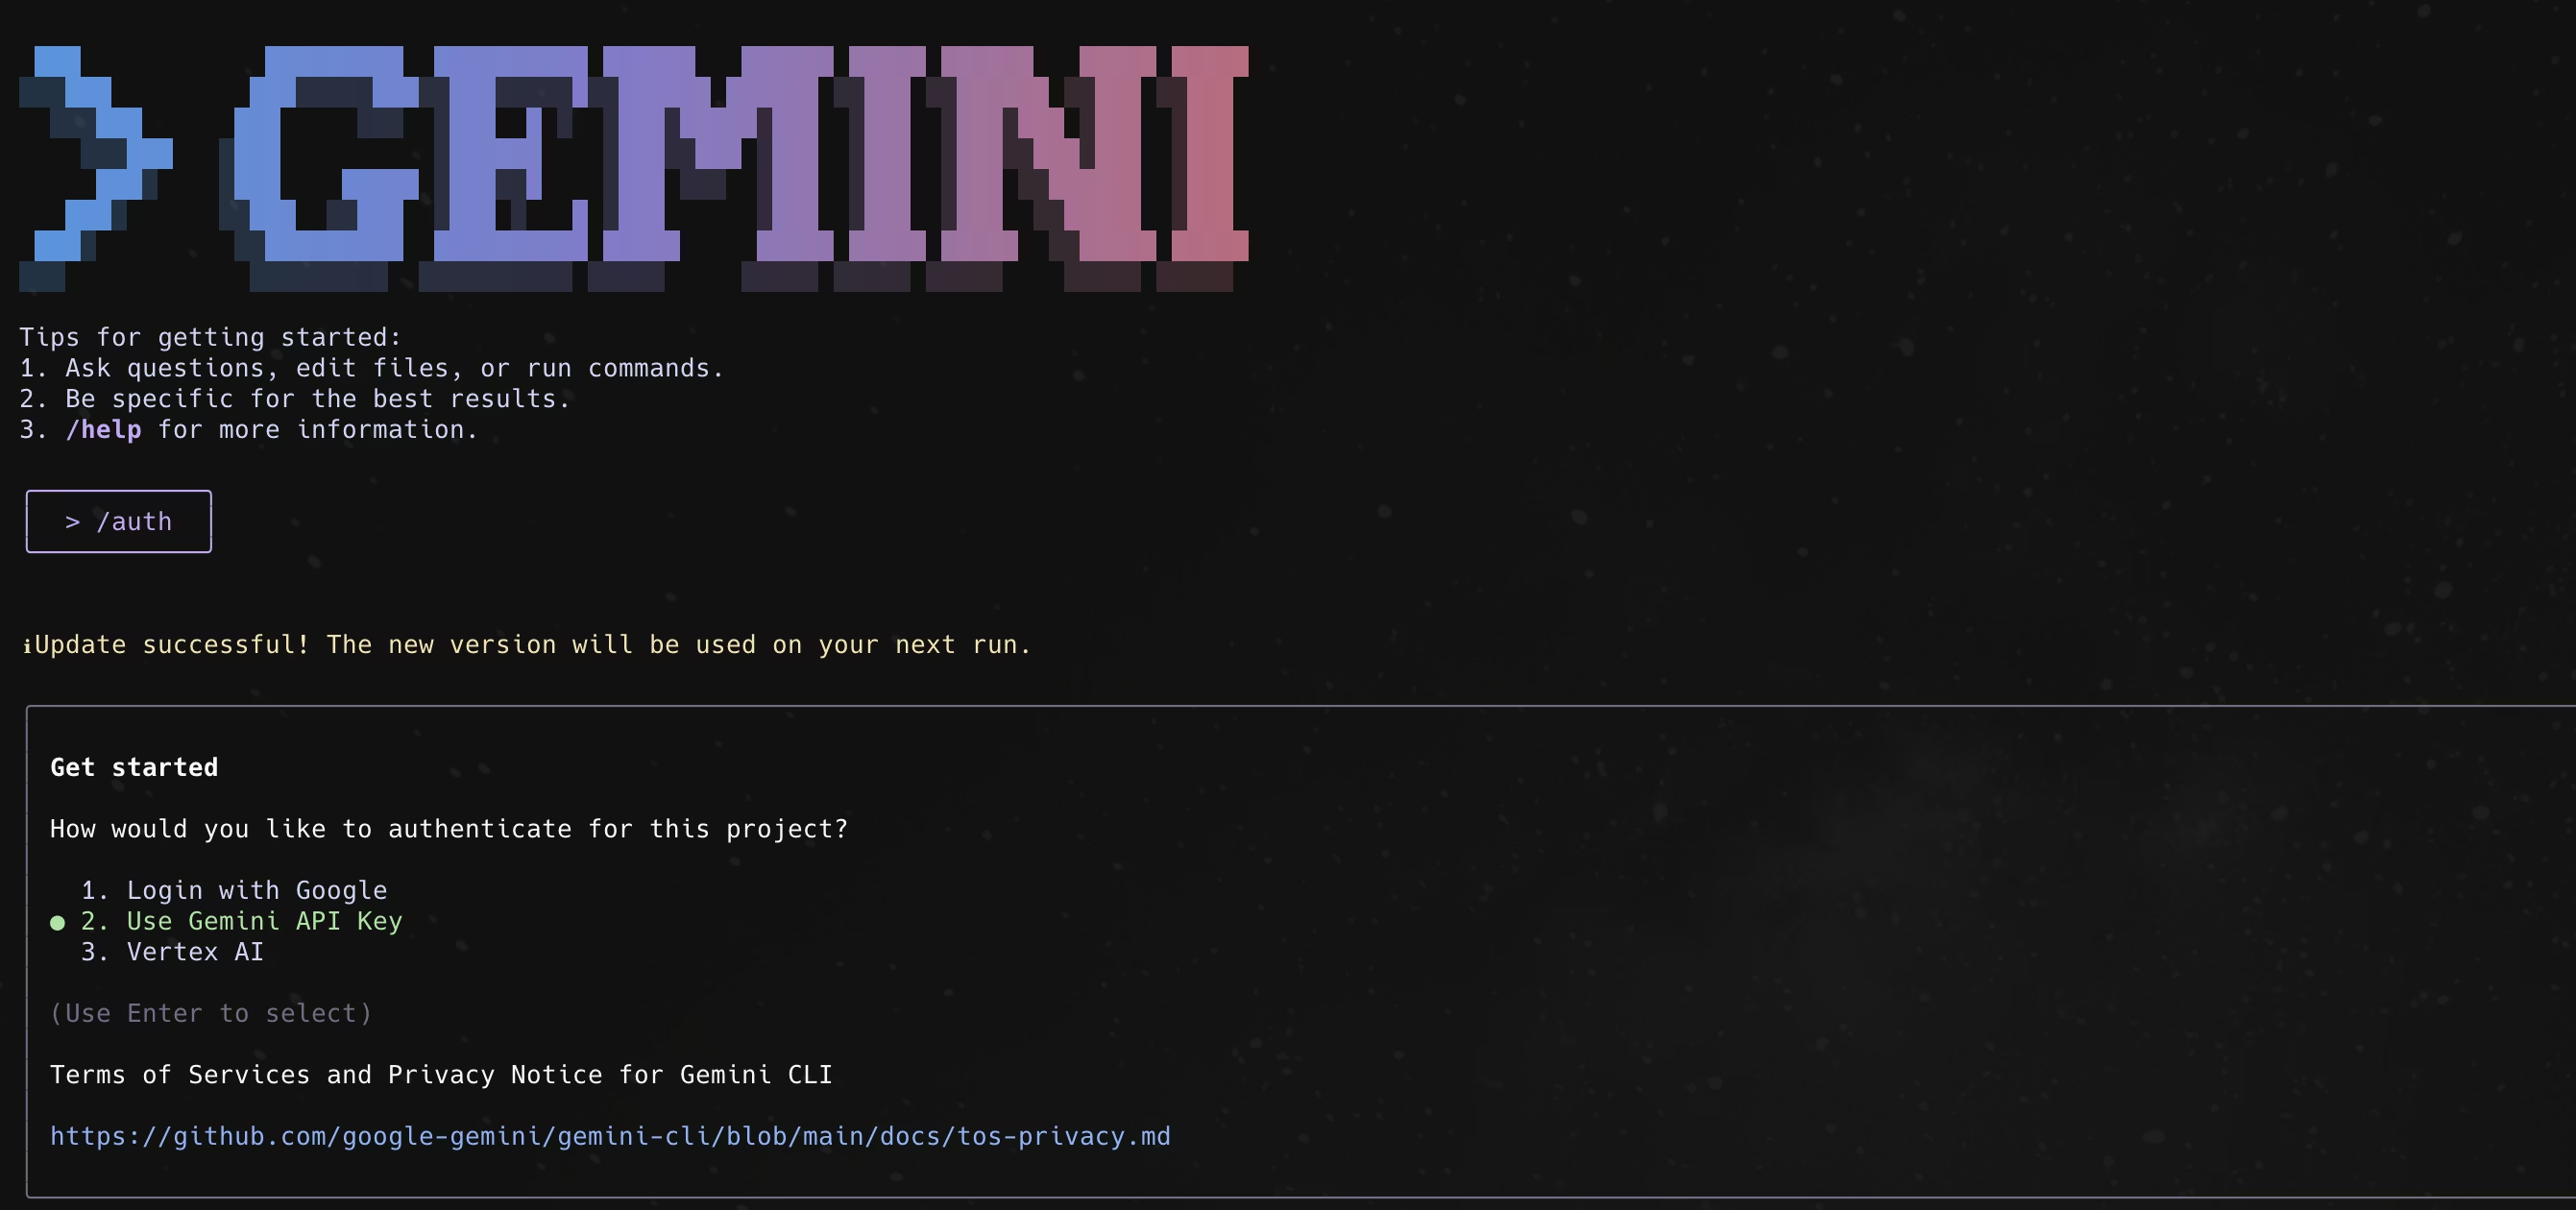
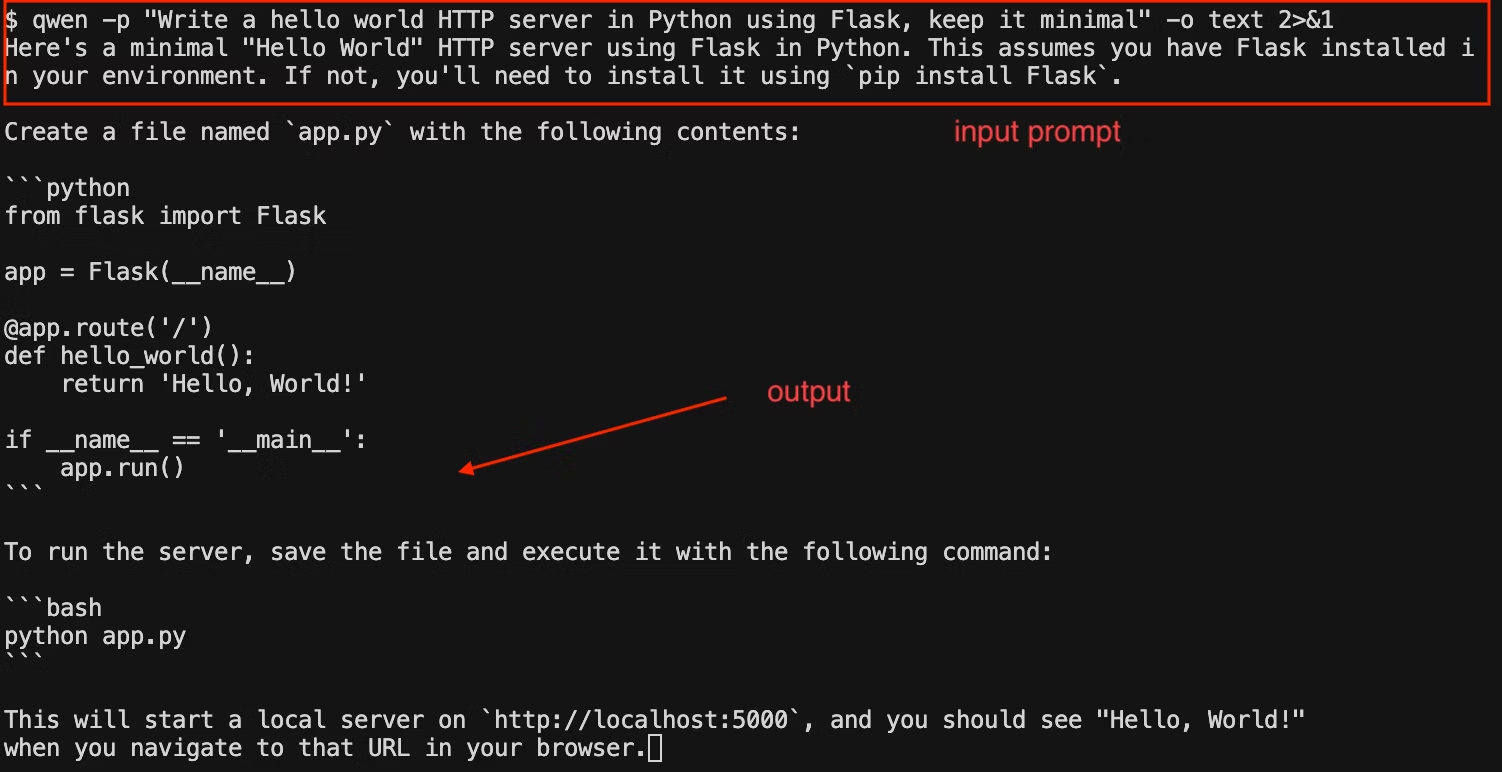
Modelgoedkeuring en toegangsbeheer zijn de meest elementaire governancebehoeften wanneer AI-codingtools zich verspreiden binnen een onderneming. Een ontwikkelaar kan Cursor of Cline binnen enkele minuten installeren en op elke modelprovider richten. Zonder een gateway eindigt het bedrijf met veel ongebeheerde paden waar codecontext en prompts het netwerk kunnen vergroten met behulp van persoonlijke sleutels. Met TrueFoundry AI Gateway maak je een kleine goedgekeurde catalogus van modellen die zijn toegestaan voor coderingsgebruik en koppel je die modellen aan teams of gebruikersgroepen. Ontwikkelaars blijven de IDE van hun voorkeur gebruiken, maar elk verzoek gaat via de gateway, zodat een verzoek naar een niet-goedgekeurd model wordt geblokkeerd. Dit maakt het ook mogelijk om toegang te scheiden op basis van risiconiveau. Een junior engineer kan toegang krijgen tot een goedkoper model voor snelle aanpassingen, terwijl een staff engineer of een team voor productie-incidenten toegang heeft tot een sterker model voor lastige debugging. Het belangrijke onderdeel is dat de goedkeuring centraal wordt afgedwongen in plaats van te vertrouwen op elke ontwikkelaar om een beleidsdocument te volgen.
Kostenverantwoordelijkheid wordt belangrijk omdat AI-codingtools grote hoeveelheden tokens kunnen genereren zonder dat iemand het merkt. Een enkele ontwikkelaar die een agent gebruikt die iteratief aan een codebase werkt, kan in een kort tijdsbestek honderden of duizenden aanroepen genereren. Zonder een gateway worden de uitgaven verdeeld over persoonlijke sleutels en vendor-accounts, waardoor de financiële afdeling wel een rekening ziet, maar niet kan zien welk team of welke applicatie de kosten heeft veroorzaakt. Met een gateway kun je op identiteit gebaseerde tokens uitgeven en vereisen dat elke IDE- of CLI-sessie zich authenticeert met een gebruikers- of service-identiteit. Daarmee kun je het gebruik toewijzen aan een persoon, een team of een interne tool. Zodra die toewijzing er is, worden beheersmaatregelen praktisch uitvoerbaar. Je kunt maandbudgetten instellen voor een team en je kunt rate limits instellen die voorkomen dat per ongeluk oneindige lussen ontstaan. Als een tool verzoeken begint te spammed, kan de gateway het verkeer knijpen in plaats van het budget stilzwijgend te laten opbranden.
Incident response en auditing zijn de gebieden waar platformteams dagelijks het verschil merken. Wanneer een ontwikkelaar zegt dat de assistent traag is en niet werkt, is het moeilijk te debuggen als het verkeer rechtstreeks van een laptop naar een vendor gaat. Je weet misschien niet of het probleem bij de vendor, het netwerk, een verkeerd geconfigureerde modelnaam of een toolspecifieke instelling ligt. Wanneer verzoeken via de gateway gaan, kan het platformteam naar de gateway-statistieken en logs kijken om te zien welk model is aangeroepen, hoe de latency eruitzag, welke fouten er zijn opgetreden en of storingen beperkt blijven tot één provider of één regio. Dit is ook de basis voor auditvereisten. Security- en complianceteams vragen vaak waar de codecontext naartoe is gestuurd en wie toegang had. Een gateway kan bijhouden welke bestemmingen zijn gebruikt en wie ze heeft aangeroepen. Het kan ook beleid ondersteunen dat risico's vermindert, zoals het maskeren van gevoelige reeksen voordat verzoeken externe providers bereiken of het volledig beperken dat bepaalde teams prompts naar externe eindpunten sturen.
Betrouwbaarheid tijdens providerproblemen is van belang omdat modelproviders wel degelijk te maken hebben met periodieke vertragingen en timeouts. AI-codingtools zijn hier bijzonder gevoelig voor omdat ze interactief zijn. Een paar timeouts kunnen ervoor zorgen dat de tool kapot aanvoelt en ontwikkelaars zullen overstappen op wat wel werkt. Veel IDE's gaan ook uit van bepaalde modelnamen. Cursor en vergelijkbare tools werken vaak het beste wanneer de modelnaam eruitziet als een standaard OpenAI-achtige naam. Als je van provider verandert, zou je normaal gesproken elke ontwikkelaarsconfiguratie moeten wijzigen. Met gateway-routing kun je dezelfde modelnaam behouden in de IDE-instellingen en achter de schermen wijzigen waar deze naar verwijst. Als één provider een timeout geeft, kun je routeren naar een andere provider of naar een ander account of andere regio. De ontwikkelaar blijft dezelfde IDE-configuratie gebruiken en ziet simpelweg dat de tool blijft werken. Dit is ook nuttig wanneer je een nieuw model wilt uitrollen. Je kunt het verkeer geleidelijk verplaatsen naar het nieuwe model terwijl de gebruikerservaring stabiel blijft, en je kunt snel terugdraaien als de kwaliteit of latency niet acceptabel is.
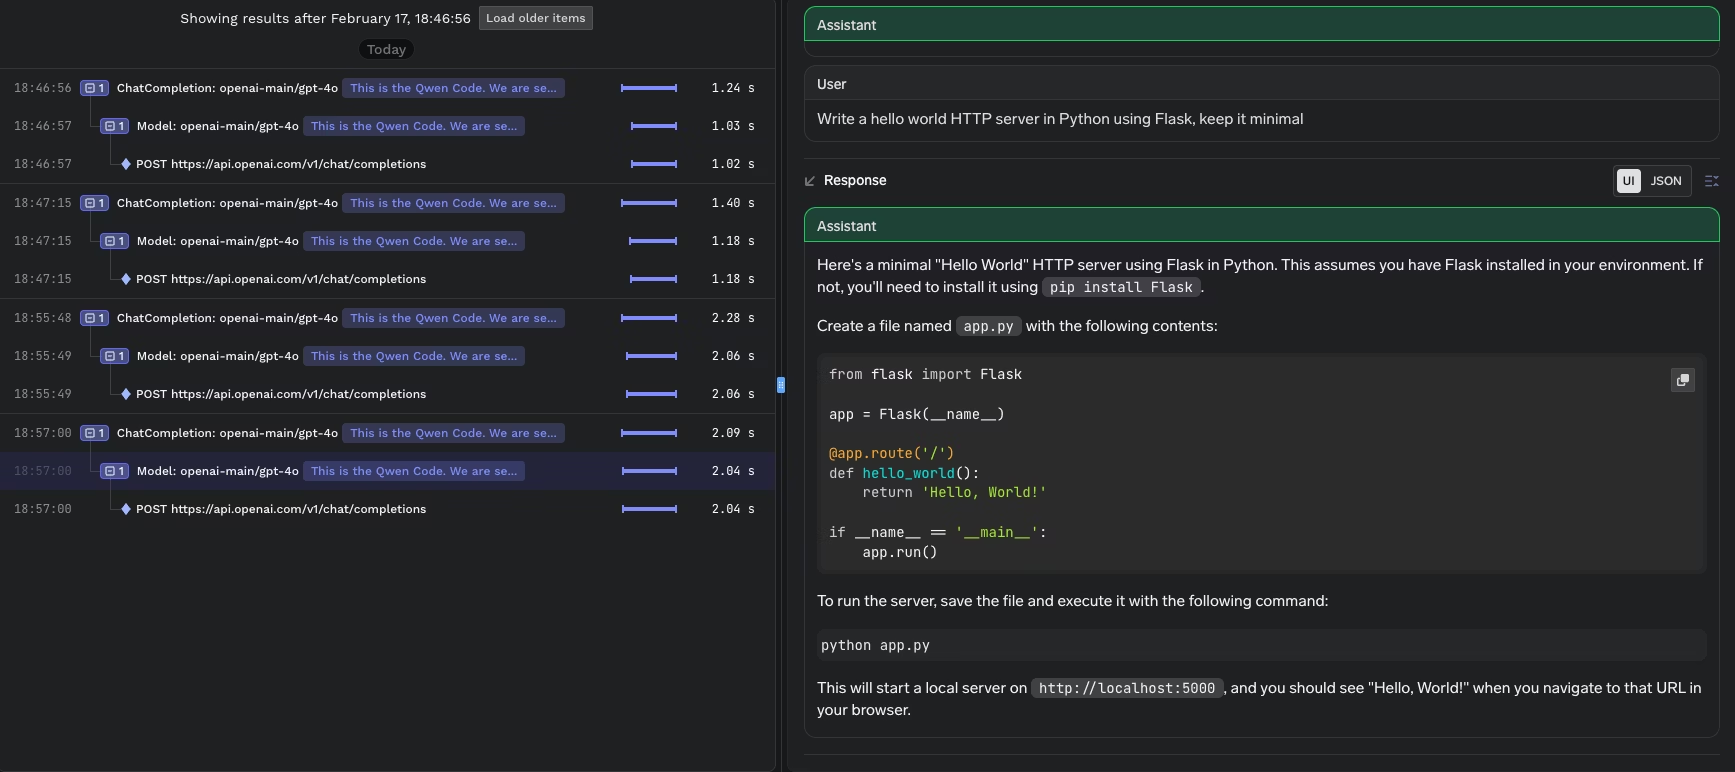
AI-coding-IDE's maken ontwikkelaars sneller. Ondernemingen hebben hetzelfde niveau van governance nodig dat ze al toepassen op bronbeheer en CI-systemen. De praktische weg is het centraliseren van de controle zonder ontwikkelaars te dwingen van tool te veranderen. TrueFoundry AI Gateway is gebouwd om op dat controlepunt te staan. De integratiehandleidingen voor Claude Code, Cline, Cursor, Gemini CLI, OpenAI Codex CLI, Qwen Code CLI, Roo Code en Goose volgen allemaal hetzelfde principe. Behoud de workflow van de ontwikkelaar. Centraliseer beleid, zichtbaarheid en controle bij de gateway.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















