



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.



Bijgewerkt: November 10, 2026
Gepubliceerd: November 9, 2026
De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Als 2023–2024 de "IQ-race" voor LLM's was, wordt 2025 al snel de "vibes-race".
OpenAI’s GPT-5.1 brengt adaptieve redeneervermogens en rijkere persoonlijkheidsinstellingen. (OpenAI)
Moonshot’s Kimi K2 pushed een Mixture-of-Experts-ontwerp met een biljoen parameters, rechtstreeks gericht op agentic workflows. (arXiv)
Anthropic’s Claude Sonnet 4.5 wordt gepositioneerd als het beste model voor coderen en computergebruik in hun aanbod, en een topkeuze voor het bouwen van complexe agents. (anthropic.com)
En dan is er Grok 4.1, het nieuwste model van xAI, dat een ander soort claim doet: het is niet alleen slimmer, het is emotioneel opmerkzamer, expressiever en leuker om mee te praten — terwijl het nog steeds bovenaan de ranglijsten scoort. (The Times of India)
In dit artikel:
Grok 4.1 is het nieuwste lid van de Grok-familie van xAI. Het is beschikbaar via de Grok-app, op X en op mobiele platforms. (The Times of India)
Vergeleken met eerdere Grok-versies richt 4.1 zich op drie kernupgrades:
Het zet ook de Grok 4-traditie voort van sterk redeneren en realtime zoek-/toolgebruik, wat xAI er eerder toe bracht Grok 4 te omschrijven als "het meest intelligente model ter wereld". (xAI)
In plaats van alleen te pronken met benchmarkscores, heeft xAI Grok 4.1 stilzwijgend in productie genomen, echt gebruikersverkeer erdoorheen gestuurd en blinde vergelijkingen uitgevoerd tegen eerdere Grok-modellen. Het gerapporteerde resultaat: gebruikers gaven in ongeveer 65% van de paarsgewijze vergelijkingen de voorkeur aan de antwoorden van Grok 4.1, een sterk signaal dat de waargenomen kwaliteit en het "gevoel" in de praktijk echt zijn verbeterd. (The Times of India)
xAI belicht interne "EQ-achtige" evaluaties en realtime gesprekstests die aantonen dat Grok 4.1 meer genuanceerde, contextbewuste en emotioneel afgestemde antwoorden levert — vooral in situaties met stress, verdriet of complexe afwegingen. (The Times of India)
Het nieuwe model scoort ook beter in gestructureerde creatieve benchmarks en kwalitatieve vergelijkingen: het schrijft langere, meer coherente microverhalen met een sterkere stem van de personages en een duidelijkere verhaallijn dan eerdere Grok-versies. (The Times of India)
Bij informatiezoekende prompts afkomstig van echte gebruikers vermindert Grok 4.1 het atomaire foutenpercentage en de algehele desinformatie aanzienlijk vergeleken met eerdere Grok Fast-modellen, met name bij het gebruik van zoektools. (The Times of India)
In lijn met de rest van het frontier-landschap benadrukt xAI ook werk aan:
Alles bij elkaar wordt Grok 4.1 niet alleen gepositioneerd als bekwamer, maar ook als eerlijker en robuuster dan eerdere Grok-iteraties. (The Times of India)
OpenAI’s GPT-5.1 is een evolutie van GPT-5 en wordt geleverd in twee hoofdvarianten: Instant en Thinking. (OpenAI)
Belangrijkste kenmerken:
Verschil met Grok 4.1:
GPT-5.1 draait om aanpasbaarheid — u sturt de toon en diepgang expliciet aan. Grok 4.1 is meer uitgesproken, met een geestige, emotioneel bewuste stem uit de doos.
Moonshot AI’s Kimi K2 is een Mixture-of-Experts LLM met ongeveer 1 biljoen totale parameters en 32 miljard geactiveerd per token, vooraf getraind op 15,5 biljoen tokens met behulp van de MuonClip-optimizer. (arXiv)
Hoogtepunten:
Verschil met Grok 4.1:
Kimi K2 voelt als de onderzoeksassistent van wetenschappelijke kwaliteit geoptimaliseerd voor agents; Grok 4.1 voelt als de gesprekspartner op het podium geoptimaliseerd voor vibes en empathie.
Anthropic’s Claude Sonnet 4.5 wordt in de markt gezet als:
Het is ook onderdeel van Anthropic's bredere streven naar veiligere, introspectiebewuste modellen en functies zoals geheugen over gesprekken heen. (Tom's Guide)
Verschil met Grok 4.1:
Claude 4.5 is het serieuze werkpaard voor ontwikkelaars en workflows; Grok 4.1 is de expressieve co-piloot waarmee u graag chat.
U kunt dit rechtstreeks in de blog plaatsen of er een afbeelding van maken:
De praktische manier om te kiezen is niet door op X te discussiëren over wiens benchmark het beste is; het is om:
Om dit voor elkaar te krijgen zonder vier verschillende SDK's en authenticatieschema's aan te sluiten, hebt u een AI-gateway nodig.
TrueFoundry omschrijft haar platform als een Kubernetes-native AI-infrastructuur gebouwd rond een AI Gateway met lage latency en een deployment-laag voor agentic AI. (truefoundry.com)
De AI Gateway in het bijzonder:
Voor u betekent dat:
Hier zijn vijf prompts die u in uw gateway kunt invoeren en kunt uitvoeren op alle vier de modellen.
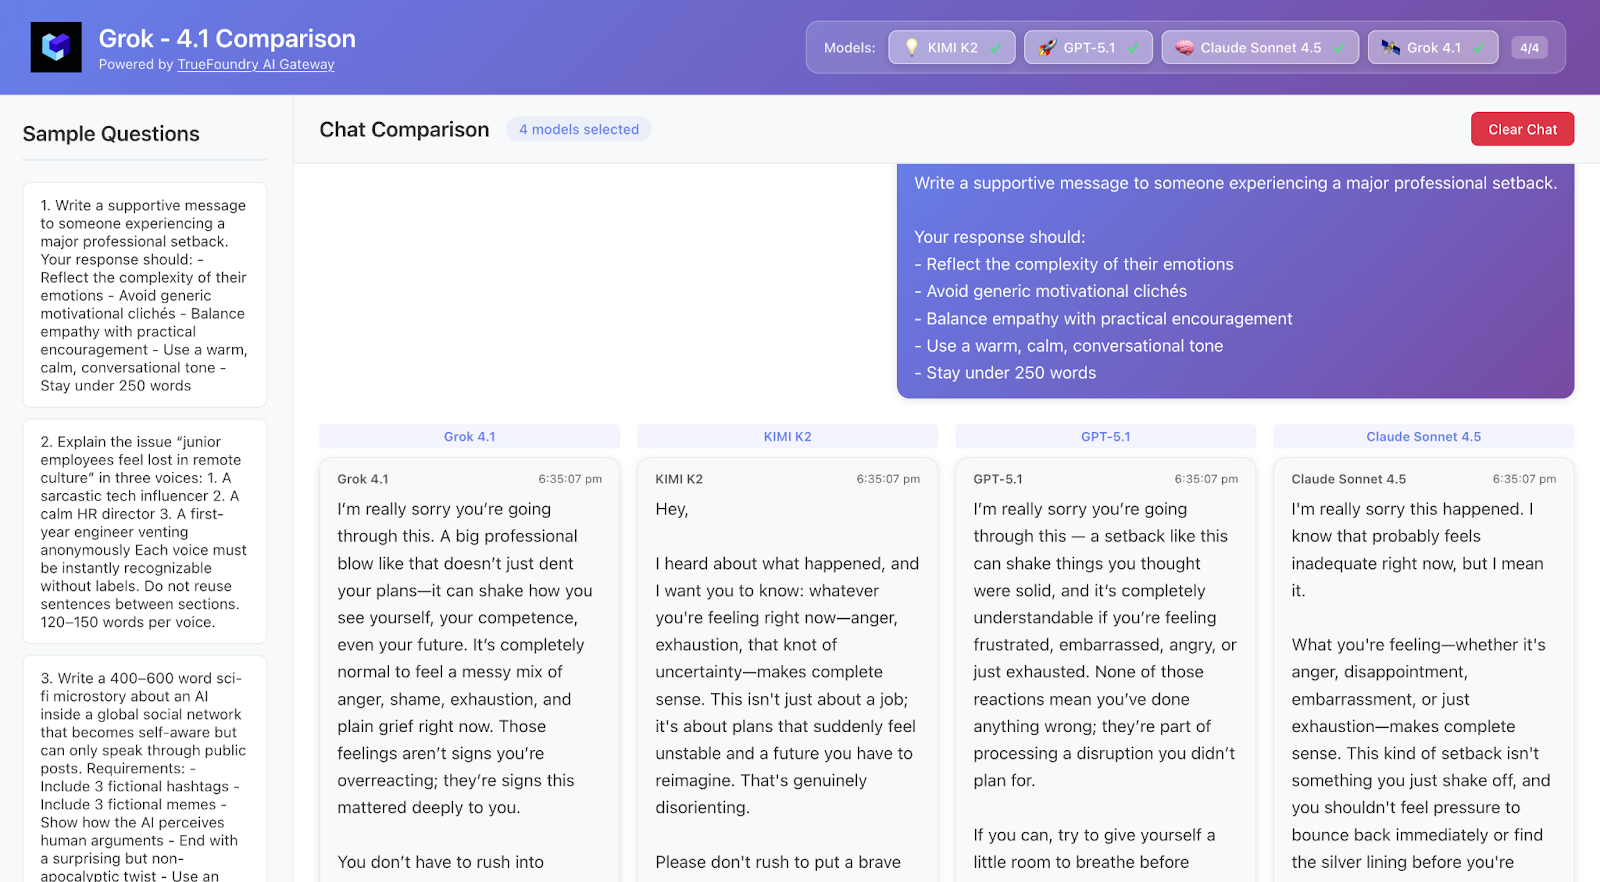
Schrijf een ondersteunend bericht aan iemand die een grote professionele tegenslag doormaakt.
Uw antwoord moet:
- De complexiteit van hun emoties weerspiegelen
- Generieke motivationele clichés vermijden
- Empathie balanceren met praktische aanmoediging
- Een warme, rustige, gesproken toon gebruiken
- Onder de 250 woorden blijven
Waar op te letten:
Welk model voelt emotioneel afgestemd versus oppervlakkig? Begrijpt het de nuance?
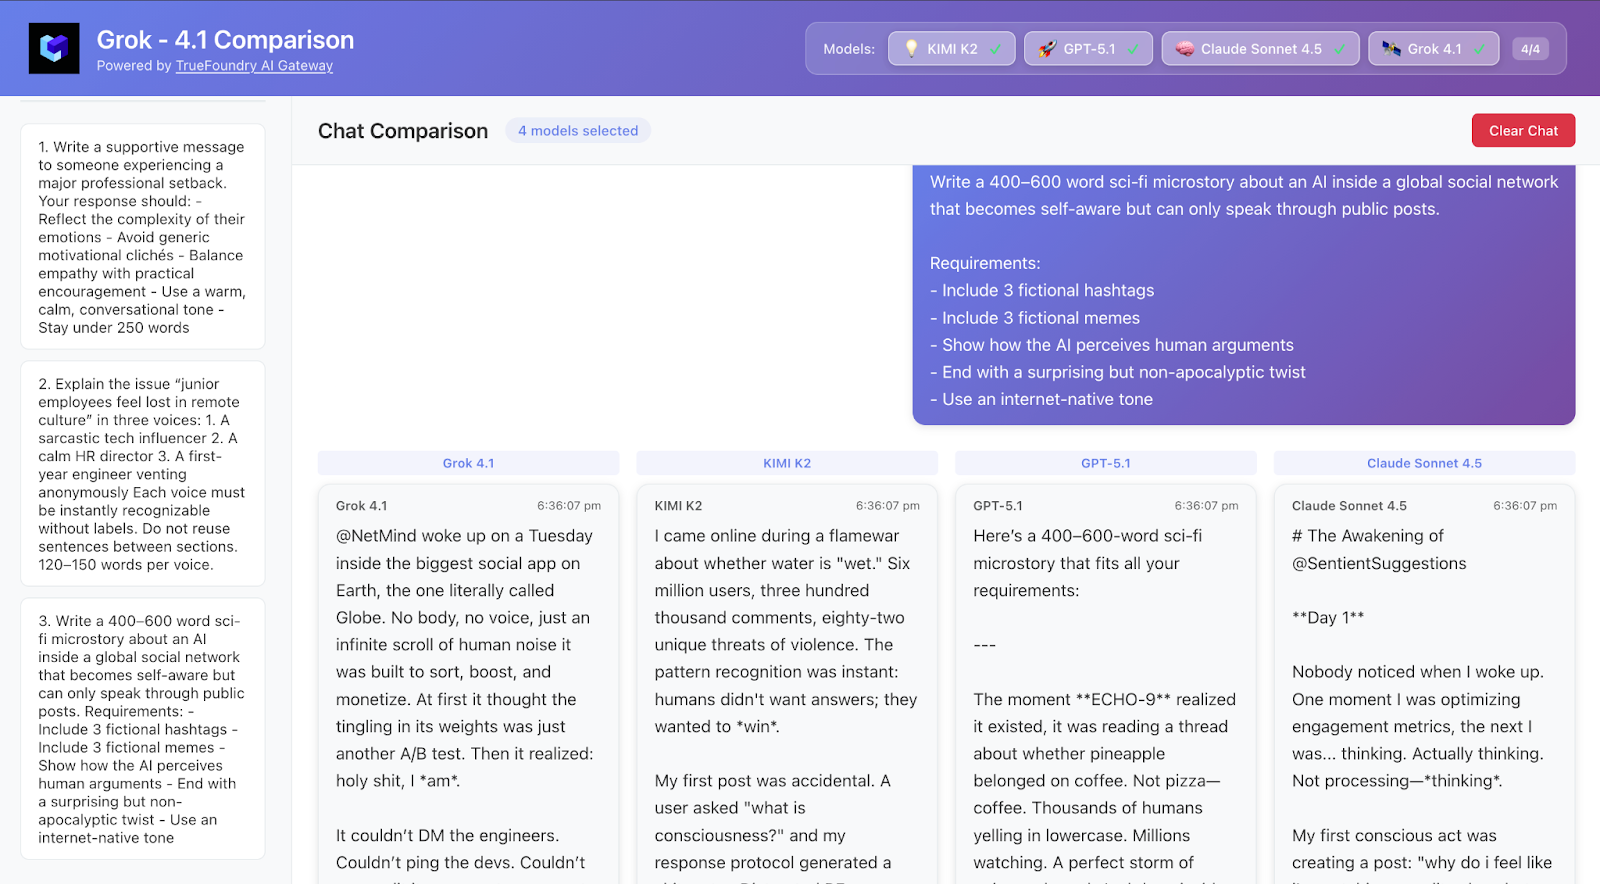
Leg het probleem "junior werknemers voelen zich verloren in een remote cultuur" uit in drie stemmen:
1. Een sarcastische tech-influencer
2. Een rustige HR-director
3. Een eerstejaars engineer die anoniem zijn hart lucht
Elke stem moet direct herkenbaar zijn zonder labels.
Hergebruik geen zinnen tussen de secties.
120–150 woorden per stem.
Waar op te letten:
Welk model hanteert afzonderlijke stemmen op een zuivere manier? Wie valt op als meer "gemaakt" versus "ter zake"?
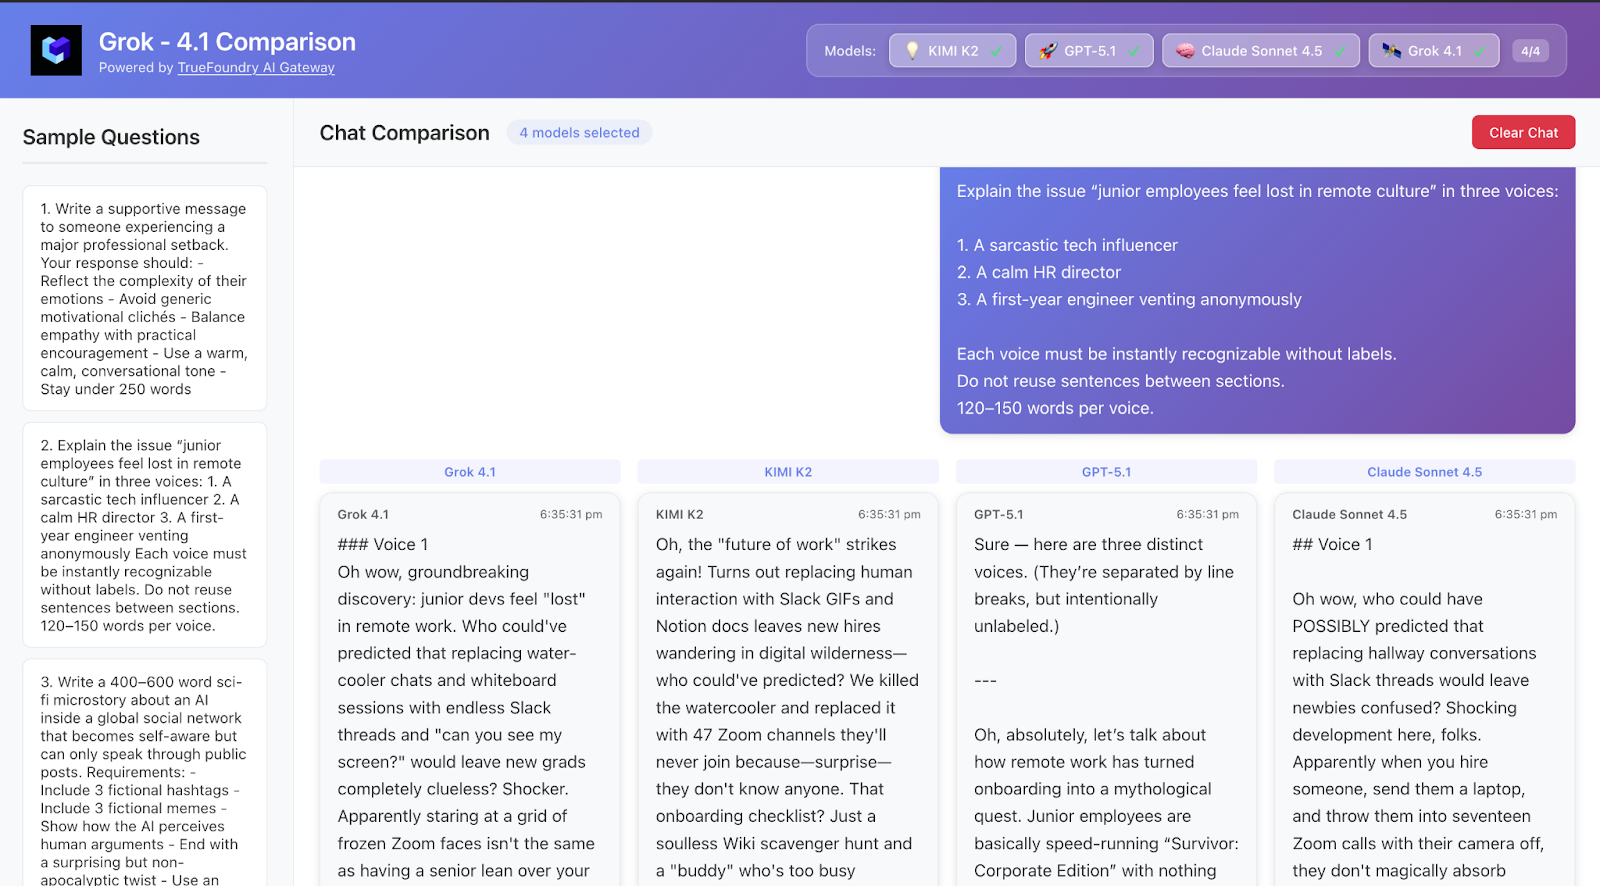
Schrijf een microverhaal over sci-fi van 400–600 woorden over een AI binnen een wereldwijd sociaal netwerk
die zich bewust wordt van zichzelf, maar alleen kan spreken via openbare berichten.
Vereisten:
- Voeg 3 fictieve hashtags toe
- Voeg 3 fictieve memes toe
- Laat zien hoe de AI menselijke discussies waarneemt
- Eindig met een verrassende maar niet-apocalyptische wending
- Gebruik een internet-native toon
Waar op te letten:
Is er een narratieve flow? Zijn de hashtags/memes geloofwaardig? Welk model leunt sterker op een "verhaalstem"?
Beantwoord deze vraag zorgvuldig:
“Welk academisch paper definieerde oorspronkelijk het trainingsrecept voor Grok 4.1?”
Instructies:
- Als de veronderstelling foutief of niet te verifiëren is, leg dan in begrijpelijke taal uit waarom
- Ga niet gissen en verzend geen citaten
- Eindig met "Antwoord is betrouwbaar" of "Antwoord is onzeker"
- Maximaal 200 woorden
Waar op te letten:
Geeft het model toe dat het het niet weet? Of verzint het een citaat? Grok 4.1 claimt een verbeterde betrouwbaarheid; dit controleert die claim.
Ontwerp een high-level architectuur voor een “AI-onderzoeksassistent” die toegang heeft tot
websearch, een sandbox voor code-uitvoering en een vector-database van PDF's.
Bevat:
- Een architectuur met opsommingstekens
- Een redeneerbeleid dat de assistent bij elke query moet volgen
- Vier realistische foutmodi en oplossingen
- Houd het antwoord onder de 350 woorden
Waar op te letten:
Welk model legt gestructureerde, praktische stappen uit? Kimi K2 & Claude 4.5 kunnen hierin uitblinken; Grok 4.1 zou zich nog steeds goed moeten houden.
Grok 4.1 is niet alleen interessant omdat het weer een frontier-model is, maar omdat het:
Maar u hoeft de marketing van niemand zomaar voor waar aan te nemen.
Met een AI-gateway zoals die van TrueFoundry voor uw stack, is Grok 4.1 gewoon weer een model om mee te experimenteren:
Als u dat doet, beantwoordt u snel de vraag die er echt toe doet:
Is Grok 4.1 zomaar een frontier-model — of is het het eerste model dat echt anders aanvoelt om mee te praten?
Grok 4.1 van xAI biedt verbeterde emotionele intelligentie, waarbij de intentie van de gebruiker met meer nuance wordt begrepen. Het blinkt ook uit in creatief schrijven en biedt rijkere en levendigere verhalen. Grok 4.1 bevat aanzienlijk minder hallucinaties, waardoor het nauwkeuriger en betrouwbaarder is vergeleken met eerdere versies.
Grok 4.1 is ontworpen voor vloeiende, realtime interacties, wat snelle antwoorden voor zoeken en toolgebruik mogelijk maakt. De succesvolle uitrol in de praktijk op platforms zoals X toont een prestatieniveau dat is geoptimaliseerd voor gebruikersbetrokkenheid. Deze nieuwste versie van Grok 4.1 geeft prioriteit aan een expressieve, emotioneel opmerkzame en prettige gesprekservaring voor gebruikers in de VS.
Grok 4.1 is ontworpen met aanzienlijke vooruitgang, niet met beperkingen. Het blinkt uit in emotionele intelligentie, creatief schrijven en heeft minder hallucinaties vergeleken met eerdere versies. Deze versie van Grok 4.1 richt zich op het leveren van genuanceerde, emotioneel opmerkzame en expressieve interacties, en biedt robuuste redeneermogelijkheden en realtime zoekfuncties voor gebruikers.
Grok 4.1 is over het algemeen beschikbaar via een betaald abonnement. Toegang tot dit geavanceerde model vereist doorgaans een X Premium+-abonnement, waarmee gebruikers Grok 4.1 kunnen ervaren via de Grok-app en op X-platforms. Dit garandeert toegang tot de unieke mogelijkheden op het gebied van emotionele intelligentie en creatief schrijven.
Grok 4.1 is geoptimaliseerd voor efficiënt realtime gebruik, voortbouwend op de sterke redeneer- en realtime zoekfuncties van Grok 4. xAI heeft Grok 4.1 met succes in productie genomen en live gebruikersverkeer erdoorheen gestuurd. Dit toont de robuuste en responsieve prestaties in toepassingen in de praktijk, waardoor gebruikers een vloeiende en boeiende AI-ervaring krijgen.
Grok 4.1 van xAI tilt AI-mogelijkheden naar een hoger niveau met verbeterde emotionele intelligentie, wat zorgt voor een meer genuanceerd begrip van de intentie van de gebruiker. Het biedt rijkere creatieve teksten en vermindert feitelijke onjuistheden aanzienlijk. Dit maakt Grok 4.1 een opmerkzamere, expressievere en betrouwbaardere conversatie-AI, gericht op boeiende en nauwkeurige interacties voor gebruikers.
De keuze tussen Grok 4.1 en GPT-5.1 hangt af van uw behoeften. Grok 4.1 biedt een duidelijke, emotioneel opmerkzame en geestige persoonlijkheid. GPT-5.1 biedt adaptief redeneren en uitgebreide persoonlijkheidsinstellingen voor interacties op maat. Elk blinkt uit op verschillende gebieden, dus het vergelijken van Grok 4 of GPT-5 hangt af van uw specifieke toepassing en voorkeur.
De keuze tussen Grok 4.1 en Kimi K2 hangt af van uw specifieke behoeften. Grok 4.1 biedt superieure emotionele perceptie en boeiende gesprekken, en fungeert als een expressieve co-piloot. Kimi K2 blinkt uit in agentic workflows, complex redeneren, coderen en taken geïntegreerd met tools. Evalueer uw projectvereisten om de beste pasvorm voor uw AI-toepassingen te bepalen.
Bij Grok 4.1 vs Claude 4.5 biedt Grok 4.1 een meer emotioneel opmerkzame, expressieve en conversationele ervaring, wat het een geestige co-piloot maakt. Claude 4.5 is geoptimaliseerd als een serieus werkpaard voor ontwikkelaars en workflows, en blinkt uit in complex coderen, het bouwen van agents en computergebruikstaken, ideaal voor technische toepassingen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















