



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
TrueFoundry AI Gateway is een geüniformeerde uitvoeringslaag voor LLM-infrastructuur. Het beheert authenticatie, routing over verschillende providers, rate limiting, beleidshandhaving, beheer van MCP tool calls en — cruciaal voor deze integratie — OpenTelemetry-compliant tracing. Elk verzoek via de gateway genereert een span met standaard gen_ai.*-attributen (modelnaam, token-aantallen, finish reason) samen met TrueFoundry-specifieke attributen zoals tfy.input, tfy.output en tfy.span_type. Deze spans worden asynchroon gepubliceerd naar een NATS message queue nadat het verzoek is voltooid, wat betekent dat het exportpad een actief verzoek nooit vertraagt. Een toegewijde OTEL exporter service leest uit die queue en stuurt spans door naar elk geconfigureerd OTLP-eindpunt via HTTP of gRPC.
Pydantic Logfire is een observability-platform gebouwd door het team achter Pydantic — de validatielaag die is ingebouwd in de SDK van OpenAI, de SDK van Anthropic en de meeste AI-frameworks die momenteel in productie zijn. Logfire verwerkt standaard OTLP-data en past daar AI-native weergave op toe: wanneer het gen_ai.*-attributen op een span detecteert, wordt het LLM Panel automatisch geactiveerd. Dit toont de volledige gespreksgeschiedenis, tool call-argumenten, token-aantallen per verzoek en berekende kosten — zonder dat er een SDK-integratie aan de zendende kant nodig is. Logfire-query's worden geschreven in PostgreSQL-compatible SQL, zodat productie-traces toegankelijk zijn voor zowel mensen als coding agents. Het is beschikbaar als een beheerde cloudservice met regionale eindpunten in de VS en de EU.
De integratie verbindt op één enkel punt: TrueFoundry's OTEL Config, dat een OTLP HTTP-eindpunt en een authorization header accepteert. Navigeer naar AI Gateway → Controls → Settings → OTEL Config en klik op de bewerkknop om het configuratiepaneel te openen.

TrueFoundry's OTEL Config-sectie — het traces-eindpunt is gericht op de EU-ingestie-URL van Logfire met de Authorization header ingesteld.
Stel het eindpunt in op de regionale ingestie-URL van Logfire, selecteer HTTP met proto-encoding en voeg het Logfire write token toe als de waarde voor de Authorization-header. Hetzelfde write token geldt voor zowel de traces- als de metrics-exporters.
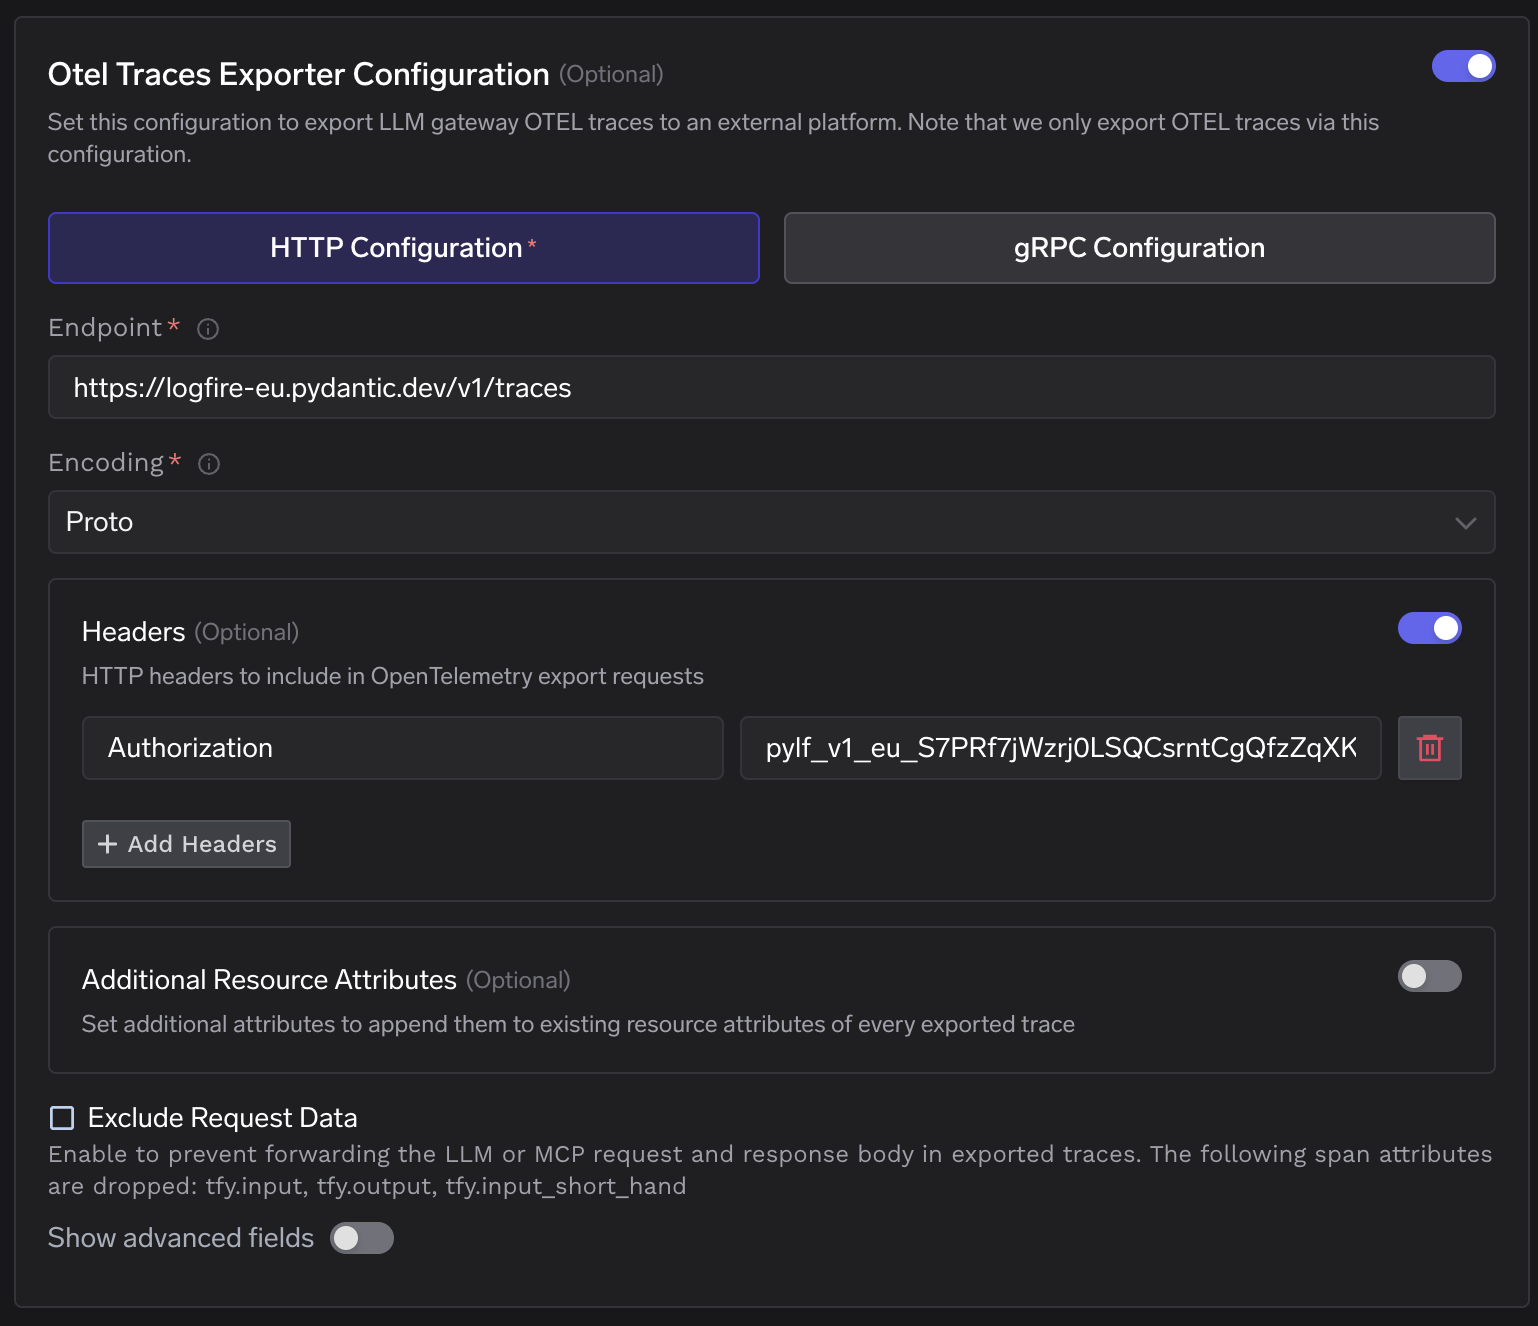
Het ingevulde Traces Exporter-formulier — eindpunt ingesteld op https://logfire-eu.pydantic.dev/v1/traces, encoding Proto en het Logfire write token in de Authorization header.
Er zijn geen code-wijzigingen vereist in de applicaties die verzoeken via de gateway sturen. De tracing pipeline werkt volledig op de infrastructuurlaag. Een verzoek van een willekeurig team, met een willekeurig model, via een willekeurige provider, genereert een span die naar Logfire stroomt met de volledige context van wat er bij de gateway is gebeurd.
Wanneer een verzoek bij de gateway aankomt, is de volgorde als volgt:
Zodra dit is geconfigureerd, verschijnen spans van tfy-llm-gateway in real-time in de Live view van Logfire. Het attribuut tfy.span_type maakt onderscheid tussen ChatCompletion-, AgentResponse- en MCPGateway-spans — waardoor teams kunnen filteren op operation type of er in SQL doorheen kunnen zoeken.

Logfire's Live view met tfy-llm-gateway spans — AgentResponse-, ChatCompletion- en MCPGateway-operaties verschijnen met volledige timing, status en geneste child spans.
Naast individuele traces brengt de metrics exporter geaggregeerde gebruiksgegevens over providers, modellen en teams naar voren. Logfire's gebruiks-overzicht groepeert deze op scope en span-naam, wat platform-leads een hoogwaardig beeld geeft van waar het verkeer naartoe gaat en in welk volume.
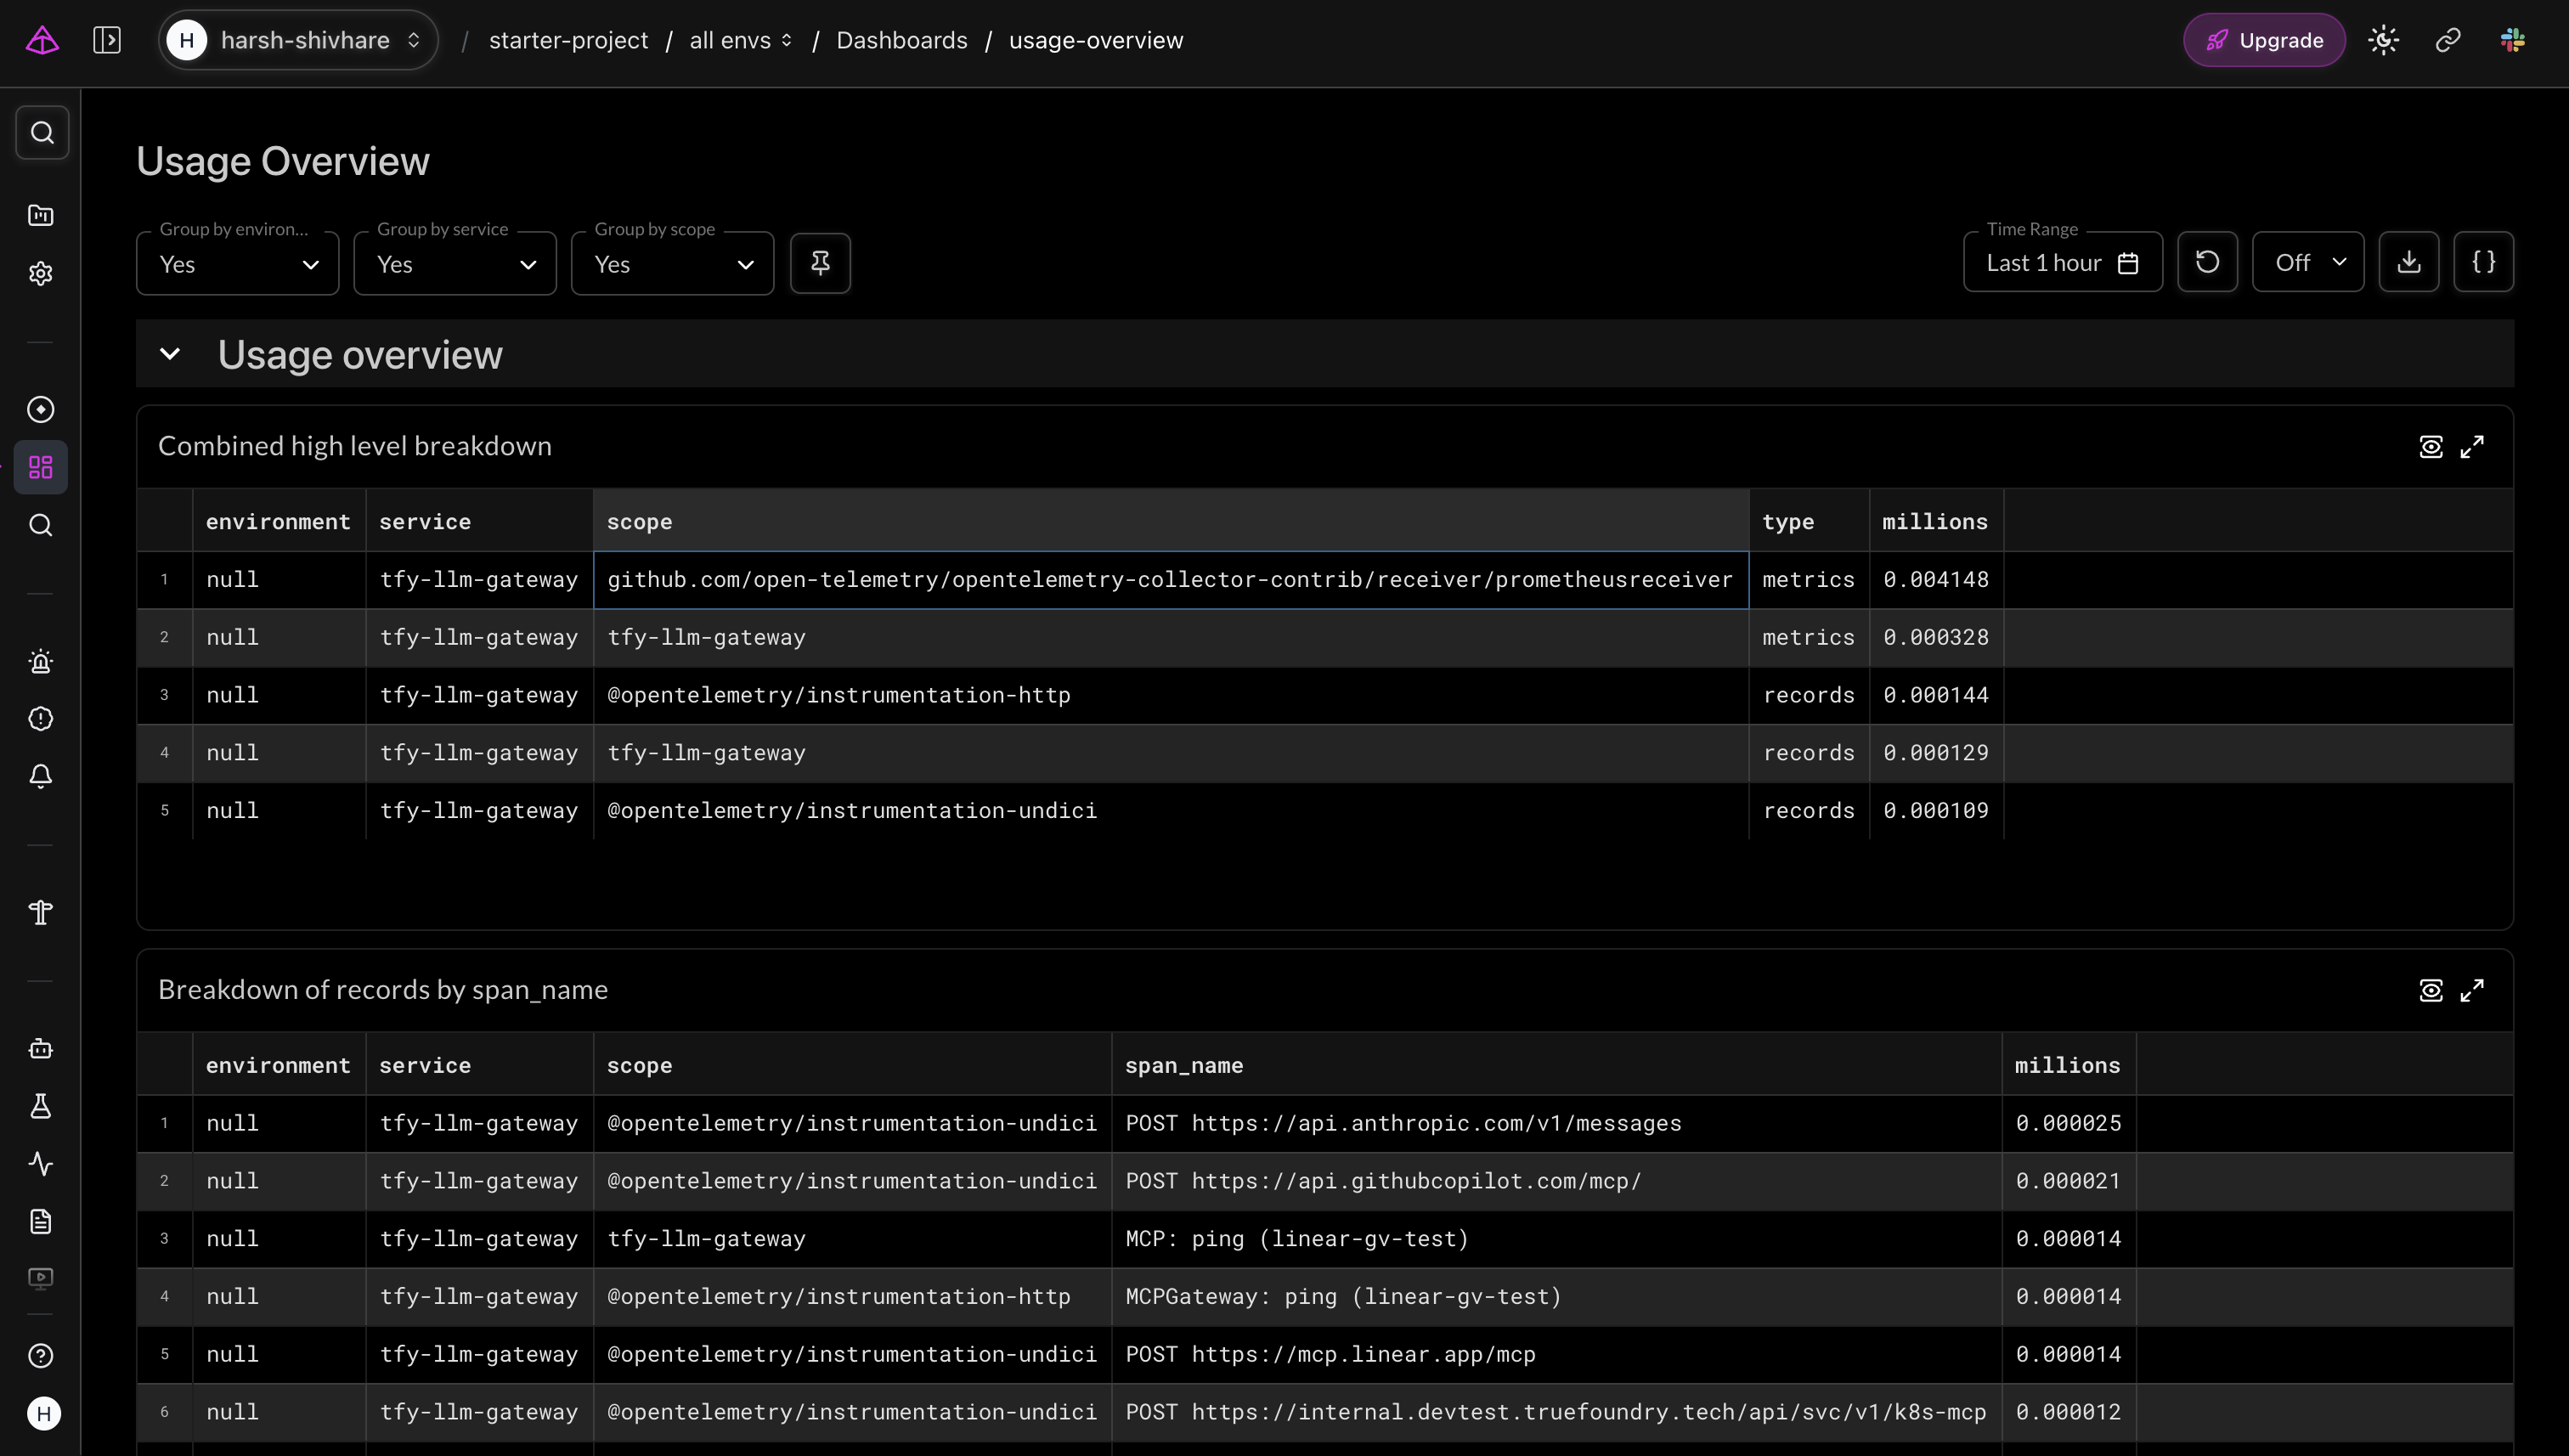
Logfire's gebruiks-overzicht — metrics van tfy-llm-gateway onderverdeeld per instrumentatiescope, met weergave van ChatCompletion- en MCPGateway-verkeer over verschillende providers.
Begin met het aanmaken van een write token in Logfire. Navigeer naar je project, open Project Settings → Write Tokens en klik op New write token. Kopieer het token onmiddellijk — Logfire toont de volledige waarde daarna niet meer.

De Logfire Write Tokens-pagina — maak een toegewezen token aan voor TrueFoundry en sla het veilig op voordat je het venster sluit.
Ga vervolgens naar AI Gateway → Controls → Settings → OTEL Config in TrueFoundry en configureer zowel de traces- als de metrics-exporters met het regionale eindpunt van Logfire en het write token. De volledige referentie voor eindpunten en de configuratiegids zijn beschikbaar in de documentatie van TrueFoundry. Logfire biedt een permanent gratis tier, met een self-hosted enterprise-optie voor teams met vereisten rondom dataresidentie.
Het waardevolle inzicht uit deze integratie is architecturaal: TrueFoundry en Logfire hoefden nooit rechtstreeks af te stemmen. De gateway verzendt standaard OpenTelemetry-spans met gen_ai.*-attributen; Logfire leest diezelfde standaard en activeert automatisch zijn LLM-bewuste weergaven. OpenTelemetry is het contract tussen hen — de gateway beheert de uitvoering en genereert telemetrie, Logfire registreert en visualiseert het gedrag, en de standaard verbindt ze zonder dat een van beide systemen afhankelijk is van de interne werking van de ander.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















