



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
TrueFoundry AI Gateway verzendt OpenTelemetry-traces voor elk verzoek dat het verwerkt en publiceert deze asynchroon via NATS naar een OTEL-exporter die ze via HTTP of gRPC doorstuur naar elke OTLP-compatibele backend. Honeycomb is zo'n backend. Het accepteert OTLP-data op https://api.honeycomb.io/v1/traces via HTTP met protobuf-codering en authenticeert met de x-honeycomb-team-header. Zodra traces aankomen, indexeert Honeycomb elk span-attribuut en maakt deze beschikbaar voor ad-hoc queries zonder dat een vooraf gedeclareerd schema vereist is.
In dit artikel wordt behandeld hoe de TrueFoundry-gateway traces genereert en meestuurt, wat Honeycomb ermee doet zodra ze aankomen en hoe de twee systemen op protocolniveau verbinding maken.
De TrueFoundry AI Gateway is gebouwd op het Hono-framework en draait als een stateless gateway-pod op 1 vCPU en 1 GB RAM, waarbij het meer dan 250 verzoeken per seconde afhandelt met ongeveer 3 ms aan toegevoegde latentie. De gateway voldoet aan OpenTelemetry en genereert spans gedurende de volledige levenscyclus van elk binnenkomend verzoek.
De span-tree omvat vijf fasen. De eerste is de inbound HTTP-handler die de aankomst van het verzoek registreert samen met de metadata van de client. De tweede is authenticatie, waarbij de gateway het JWT-token verifieert aan de hand van een gecachte openbare sleutel die is gedownload van de identity provider. Tijdens deze stap wordt er geen externe auth-call gemaakt. De derde is modelresolutie, waarbij de gateway de logische model-ID omzet naar een fysiek provider-endpoint met behulp van een routingtabel in het geheugen die vanuit het control plane via NATS wordt gesynchroniseerd. De vierde is de outbound provider-call, waarbij de gateway het verzoek via een adapter vertaalt van OpenAI-compatibel formaat naar het doelformaat van de provider en het doorstuurt. De vijfde is het afhandelen van de streaming response, waarbij de gateway het aantal tokens en de finish reasons vastlegt terwijl de respons terugstroomt.
Span-attributen volgen de gen_ai.* semantische conventies samen met TrueFoundry-specifieke attributen. Het attribuut gen_ai.request.model registreert de model-ID. De attributen gen_ai.usage.prompt_tokens en gen_ai.usage.completion_tokens registreren het tokenverbruik. De attributen tfy.input en tfy.output bevatten de volledige prompt- en responstekst. Het attribuut tfy.input_short_hand bevat een verkorte versie voor weergave. Het attribuut tfy.span_type identificeert de spancategorie, zoals ChatCompletion of MCPGateway.
Nadat het verzoek is voltooid, publiceert de gateway deze spans asynchroon naar NATS. Een OTEL-exporter op de achtergrond leest uit dit asynchrone pad en stuurt de spans door naar het geconfigureerde externe endpoint. Dit ontwerp betekent dat het exporteren van traces nooit latentie toevoegt aan het verzoekpad. De gateway laat een verzoek niet mislukken als het externe OTEL-endpoint onbereikbaar is. Het exportpad is additief en vervangt de eigen interne trace-opslag van TrueFoundry niet.

Voor workloads waarbij de inhoud van prompts en responsen de omgeving niet mag verlaten, biedt de gateway een optie Exclude Request Data. Wanneer deze is ingeschakeld, worden tfy.input, tfy.output en tfy.input_short_hand uit spans verwijderd voor export. Alle andere span-attributen, waaronder het aantal tokens, de latenties en de modelmetadata, blijven gewoon stromen.
De MCP Gateway volgt hetzelfde tracingmodel. Elke tool-aanroep genereert een span waarin de aanroepende gebruiker, de MCP-server, de toolnaam, de volledige request- en response-payload en de latentie worden geregistreerd. Deze spans verschijnen in dezelfde trace-tree als de LLM-aanroep-spans, wat zorgt voor end-to-end trace-zichtbaarheid over agentic workflows heen.
Honeycomb verwerkt OTLP-data en slaat elke span op als een rij met willekeurige kolommen. Er is geen vast schema. Elk attribuut dat TrueFoundry verzendt, of het nu gen_ai.usage.prompt_tokens, tfy.span_type of http.response.status_code is, wordt een opvraagbare kolom in Honeycomb op het moment dat de eerste span die dit attribuut bevat, binnenkomt.
De belangrijkste query-primitive in Honeycomb is de BubbleUp-analyse. Gegeven een verzameling trage of mislukte traces berekent BubbleUp welke attribuutwaarden statistisch oververtegenwoordigd zijn in die set vergeleken met de baseline. Voor LLM-gateway-verkeer betekent dit dat u kunt identificeren of een piek in latentie gecorreleerd is met een specifiek model, een specifieke gebruiker of een specifieke MCP-server, zonder handmatig een query te hoeven schrijven.
Honeycomb organiseert data in datasets. De TrueFoundry-gateway stelt service.name in op tfy-llm-gateway en Honeycomb stuurt spans standaard naar een dataset met die naam. Om spans naar een andere dataset te routeren, wordt de x-honeycomb-dataset-header toegevoegd aan de exporterconfiguratie naast x-honeycomb-team. Er kunnen meerdere datasets worden gebruikt om productie- en stagingverkeer te scheiden of om LLM-gateway-traces te scheiden van MCP-gateway-traces.
Het tabblad Traces in Honeycomb toont de span-waterfall-weergave. Elke rij is een span. De hiërarchie toont ouder-kindrelaties, zodat een root MCPGateway: resources/list-span met geneste MCP: resources/templates/list-spans en een outbound POST https://...-span direct overeenkomt met wat de gateway heeft uitgevoerd. Duurbalken maken de latentieverdeling in één oogopslag zichtbaar. De teller Spans with errors isoleert traces met fouten.
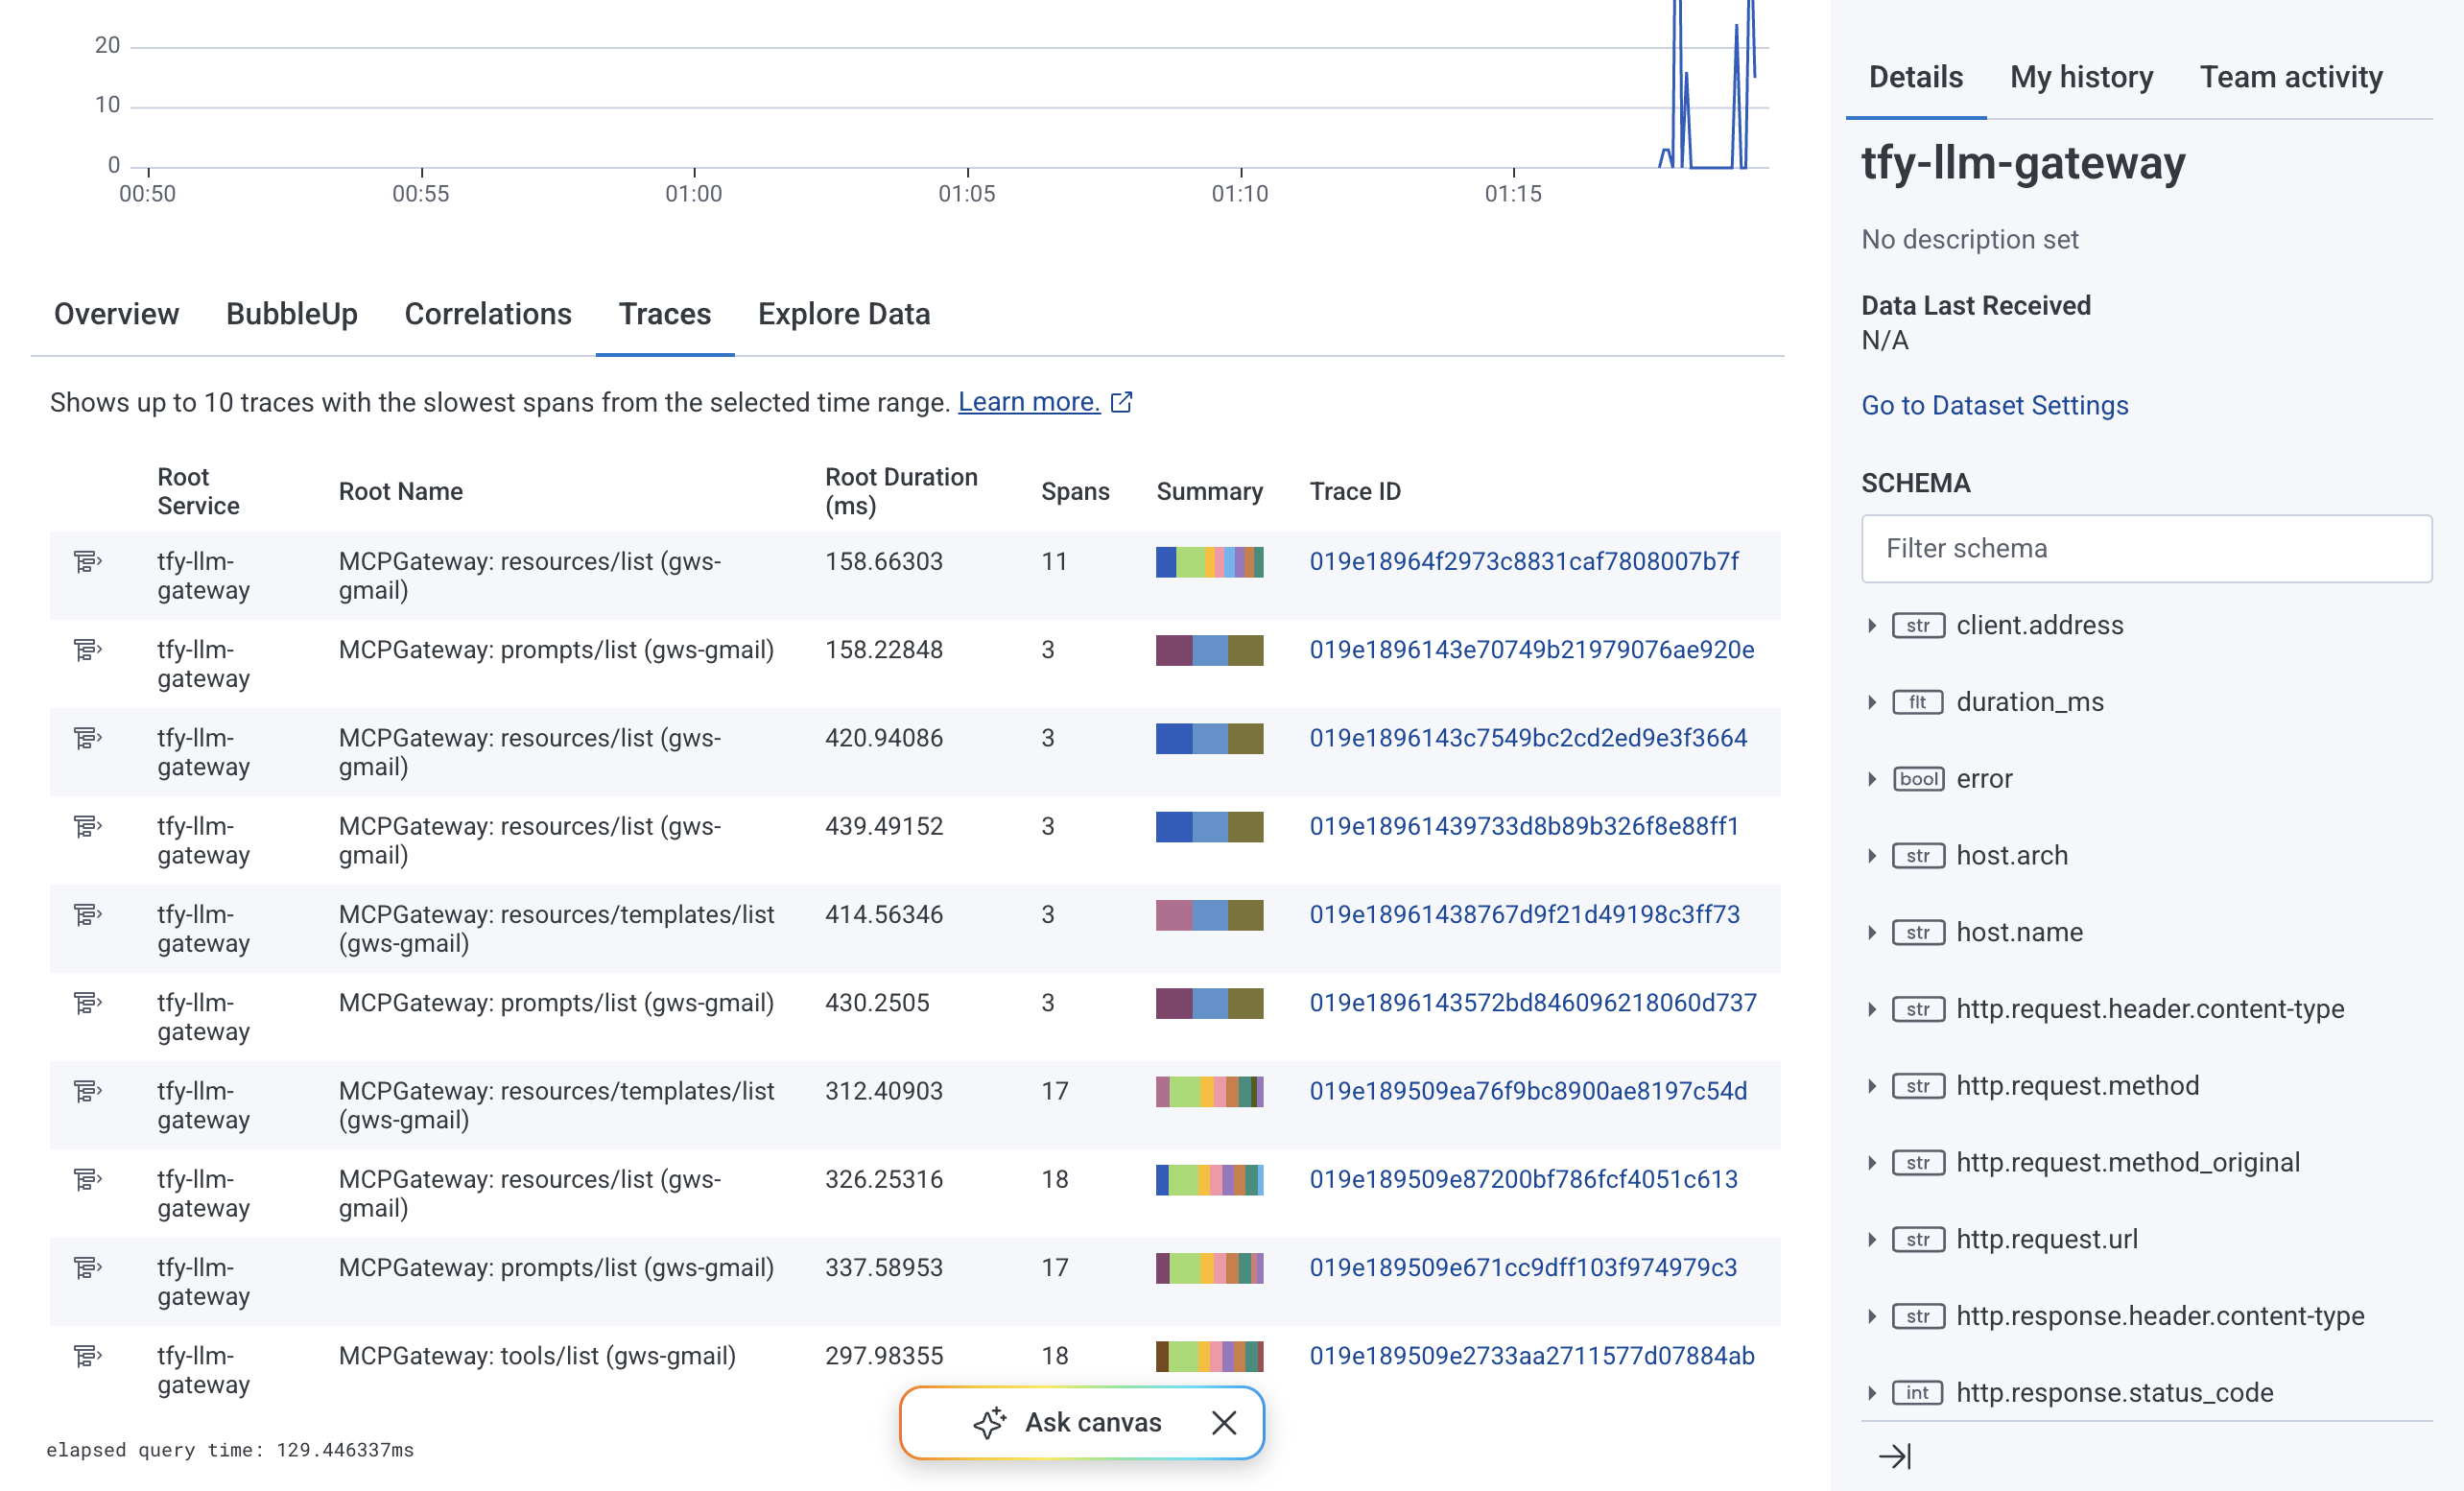
Het tabblad Overview aggregeert Total Spans, Total Errors en Total Exceptions over het geselecteerde tijdsbestek en geeft Trace Volume, Span Volume en Error Volume weer als tijdreeksgrafieken. Deze weergave weerspiegelt de gezondheid van de gateway in één oogopslag, zonder dat u vanaf nul een dashboard hoeft op te bouwen.

Door op een Trace ID te klikken, wordt de volledige span-waterfall voor die trace uitgeklapt. Elke span toont de servicenaam, de duur en eventuele foutvlaggen. Geneste kind-spans weerspiegelen de interne aanroep-hiërarchie van de gateway, waardoor het mogelijk is om per verzoek te isoleren welke fase latentie heeft veroorzaakt.

De TrueFoundry-gateway exporteert traces via OTLP HTTP met protobuf-codering. Honeycomb accepteert dit formaat op twee regionale endpoints.
Authenticatie maakt gebruik van een enkele header. De x-honeycomb-team-header bevat de Honeycomb ingest API-sleutel. De sleutel moet het machtigingsbereik Send Events hebben. Er is geen OAuth-flow en geen bearer-token-uitwisseling. De sleutel wordt bij elk exportverzoek als een gewone headerwaarde verzonden.
x-honeycomb-team: <your-honeycomb-ingest-api-key>
Dataset-routing wordt geregeld door een tweede optionele header. Wanneer x-honeycomb-dataset wordt weggelaten, gebruikt Honeycomb service.name uit de resource-attributen om de doel-dataset te bepalen. Wanneer deze expliciet is ingesteld, worden alle spans in die exportbatch naar de genoemde dataset geschreven, ongeacht service.name.
x-honeycomb-dataset: tfy-llm-gateway-production
De TrueFoundry-gateway voegt niet automatisch signaalpaden toe aan het geconfigureerde endpoint. Het volledige pad, inclusief /v1/traces, moet aanwezig zijn in het endpoint-veld. Dit verschilt van de OTLP HTTP-exporter van de OpenTelemetry Collector, die automatisch /v1/traces toevoegt op basis van het pijplijnsignaaltype. In de Collector is een enkele basis-URL zoals https://api.honeycomb.io:443 voldoende omdat de Collector het pad achterhaalt uit de pijplijndefinitie. In TrueFoundry wordt het endpoint letterlijk gebruikt.
Het configuratieoppervlak in TrueFoundry komt rechtstreeks overeen met de velden die Honeycomb vereist.
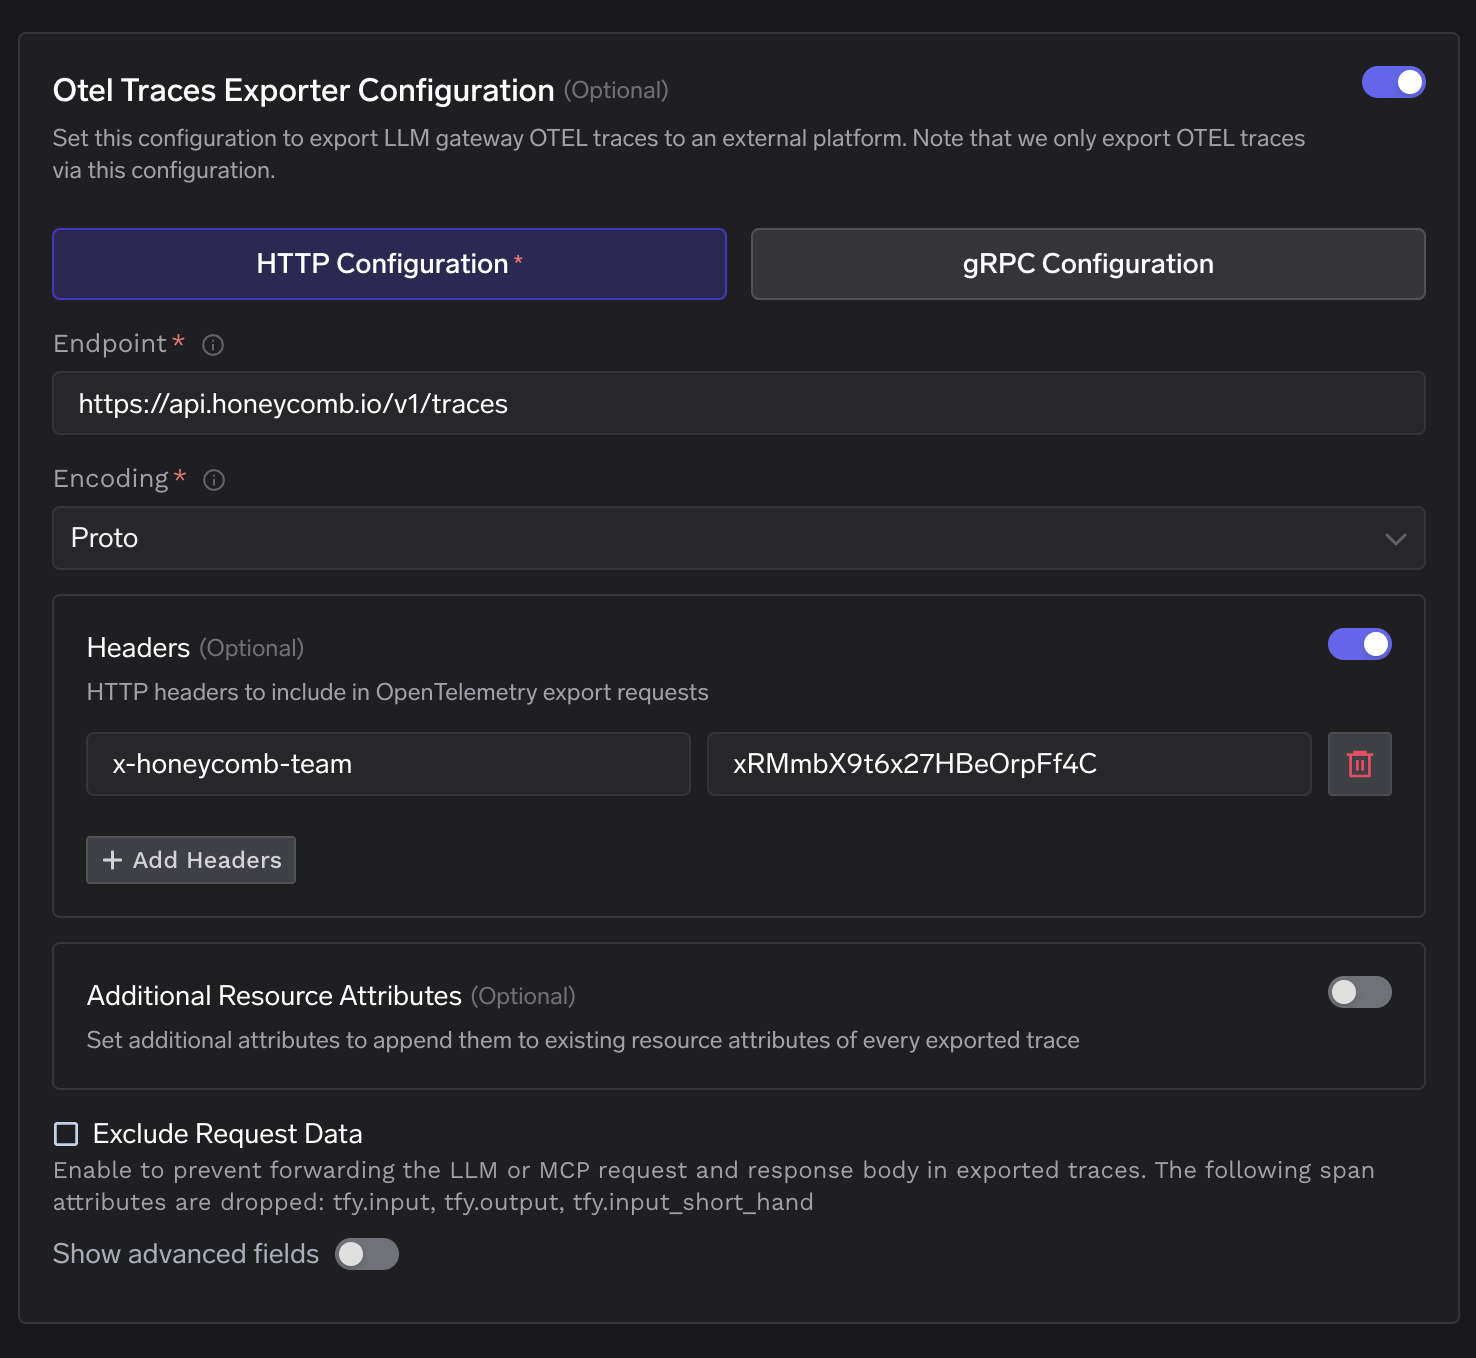
Het veld Additional Resource Attributes voegt sleutel-waardeparen toe aan het resource-blok van elke geëxporteerde span. Dit is handig voor het toevoegen van een deployment environment-tag of een cluster-ID die nog niet aanwezig is in de span-attributen.
Het selectievakje Exclude Request Data verwijdert tfy.input, tfy.output en tfy.input_short_hand voordat spans de gateway verlaten. Honeycomb ontvangt nog steeds alle structurele attributen, inclusief het aantal tokens, latenties, modelnamen en foutvlaggen.
Wanneer een verzoek de TrueFoundry-gateway bereikt, wordt de volledige span-tree tijdens de verwerking van het verzoek in het geheugen opgebouwd en na het voltooien van de respons naar NATS gepubliceerd. De OTEL-exporter is geabonneerd op dit NATS-onderwerp en bundelt spans voordat ze naar https://api.honeycomb.io/v1/traces worden gestuurd via HTTPS met de x-honeycomb-team-header aanwezig. Honeycomb schrijft elke span als een rij in de dataset tfy-llm-gateway. De spans worden binnen enkele seconden na aankomst opvraagbaar.
Er zijn geen wijzigingen in de applicatiecode vereist. Er worden geen sidecar-containers geïmplementeerd naast de gateway. Er is geen SDK ingebed in de client. De integratie is een configuratieoppervlak op de gateway: één endpoint-URL en één authenticatieheader. Bestaande clients die de gateway aanroepen via de OpenAI-compatibele API blijven werken zonder aanpassingen.
Het principe dat deze integratie betrouwbaar maakt, is het asynchrone exportpad. Het exporteren van traces is via NATS losgekoppeld van de levenscyclus van het verzoek. Een storing in de Honeycomb-API of een netwerkpartitie tussen de gateway en het ingesteindpoint van Honeycomb heeft geen invloed op de beschikbaarheid van de inferentie. De gateway verwerkt verzoeken en publiceert spans naar NATS, ongeacht of de downstream-export slaagt. Dit betekent dat de observability-pijplijn kan worden geconfigureerd, opnieuw geconfigureerd en herstart zonder het pad te raken dat verzoeken afhandelt.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















