



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
TrueFoundry AI Gateway exporteert OpenTelemetry-traces naar Traceloop over OTLP/HTTP via het https://api.traceloop.com/v1/traces eindpunt en een Bearer-token in de Authorization-header. Elke LLM-aanvraag die door de gateway gaat, genereert een span tree die in het Traceloop-dashboard terechtkomt zonder enige wijziging aan de applicatiecode of de deployment-topologie.
Deze blogpost behandelt het pad voor het genereren van traces binnen de TrueFoundry AI Gateway en hoe Traceloop die data verwerkt en weergeeft. Ook worden de configuratie-opties en de privacy-instellingen op gateway-niveau beschreven.
De TrueFoundry AI Gateway is gebouwd op het Hono-framework en draait als een stateless pod die meer dan 250 requests per seconde afhandelt op een enkele vCPU, met ongeveer 3 ms aan toegevoegde latentie per request. De gateway werkt volgens een gesplitste architectuur waarbij een control plane de configuratie beheert en een of meer gateway-pods het inference-verkeer verwerken.
Wanneer een request binnenkomt, voert de gateway de volgende stappen uit in de hot path:
Geen van deze stappen voert externe aanroepen uit, behalve de provider-aanroep zelf. Rate-limiting voert het Sliding Window Token Bucket-algoritme uit op de in-memory status. Guardrail-evaluatie (indien geconfigureerd) draait gelijktijdig met de modelaanroep voor invoercontroles en sequentieel voor uitvoercontroles.
Nadat het request is voltooid, publiceert de gateway de span tree asynchroon naar NATS. De OTEL-exporter leest uit dit asynchrone pad en stuurt spans door naar het geconfigureerde externe eindpunt. Omdat het exportpad volledig is losgekoppeld van het requestpad, zal een trage of onbereikbare OTEL-backend nooit latentie toevoegen voor de client en nooit een request laten mislukken. Als Traceloop onbereikbaar is, worden spans bij de exporter verworpen en intern gelogd. TrueFoundry's eigen interne trace-opslag blijft ongewijzigd, omdat de export additief is.
De gateway genereert spans over vijf fasen: de inkomende HTTP-handler, authenticatie, modelresolutie, de uitgaande provider-aanroep en de opbouw van de streaming respons. Elke span bevat een consistente set attributen.
De gen_ai.*-attributen volgen de OpenTelemetry Semantic Conventions voor Generatieve AI-systemen. Dit betekent dat de trace-data die in Traceloop aankomt structureel identiek is aan wat een met OpenLLMetry geïnstrumenteerde applicatie zou genereren.

Traceloop is een LLM-observabilityplatform dat is gebouwd op OpenLLMetry, de open-source OpenTelemetry-instrumentatielaag. De backend van Traceloop accepteert OTLP/HTTP-tracedata en indexeert deze voor het Traceloop-dashboard. Het platform is trace-native. Metrieken zoals tokengebruik, latentie en kosten worden berekend op basis van span-attributen in plaats van een afzonderlijke OTLP-metriekenstream. Dit is de reden waarom het configureren van alleen de Traces Exporter in TrueFoundry voldoende is — er is geen /v1/metrics-eindpunt in het ingestieoppervlak van Traceloop.
Traceloop organiseert data rond drie kernabstracties. Traces vormen de hoofdeenheid en komen rechtstreeks overeen met een LLM-request of een agentic workflow. Spans binnen een trace vertegenwoordigen individuele operaties (een LLM-aanroep, een tool-aanroep en een retrieval-stap). Environments komen overeen met deployment-fasen en elke omgeving heeft zijn eigen API-sleutel, waardoor traces van Development, Staging en Production gescheiden blijven in het dashboard.
Het Traceloop-dashboard toont tokengebruik over de tijd, latentieverdelingen, foutpercentages en overzichten per model rechtstreeks vanuit de gen_ai.*-span-attributen. Omdat TrueFoundry deze attributen op elke span invult, is het Traceloop-dashboard volledig gevuld zonder dat er SDK-instrumentatie in de applicatielaag nodig is.

Traceloop ondersteunt ook promptversiebeheer en regressietestpipelines, maar die functies werken op applicatie-SDK-niveau en vallen buiten de scope van deze integratie. De integratie op gateway-niveau dekt het volledige observability-oppervlak: elk request dat door TrueFoundry gaat, genereert een trace in Traceloop, ongeacht welke LLM-provider of welk model wordt aangeroepen.
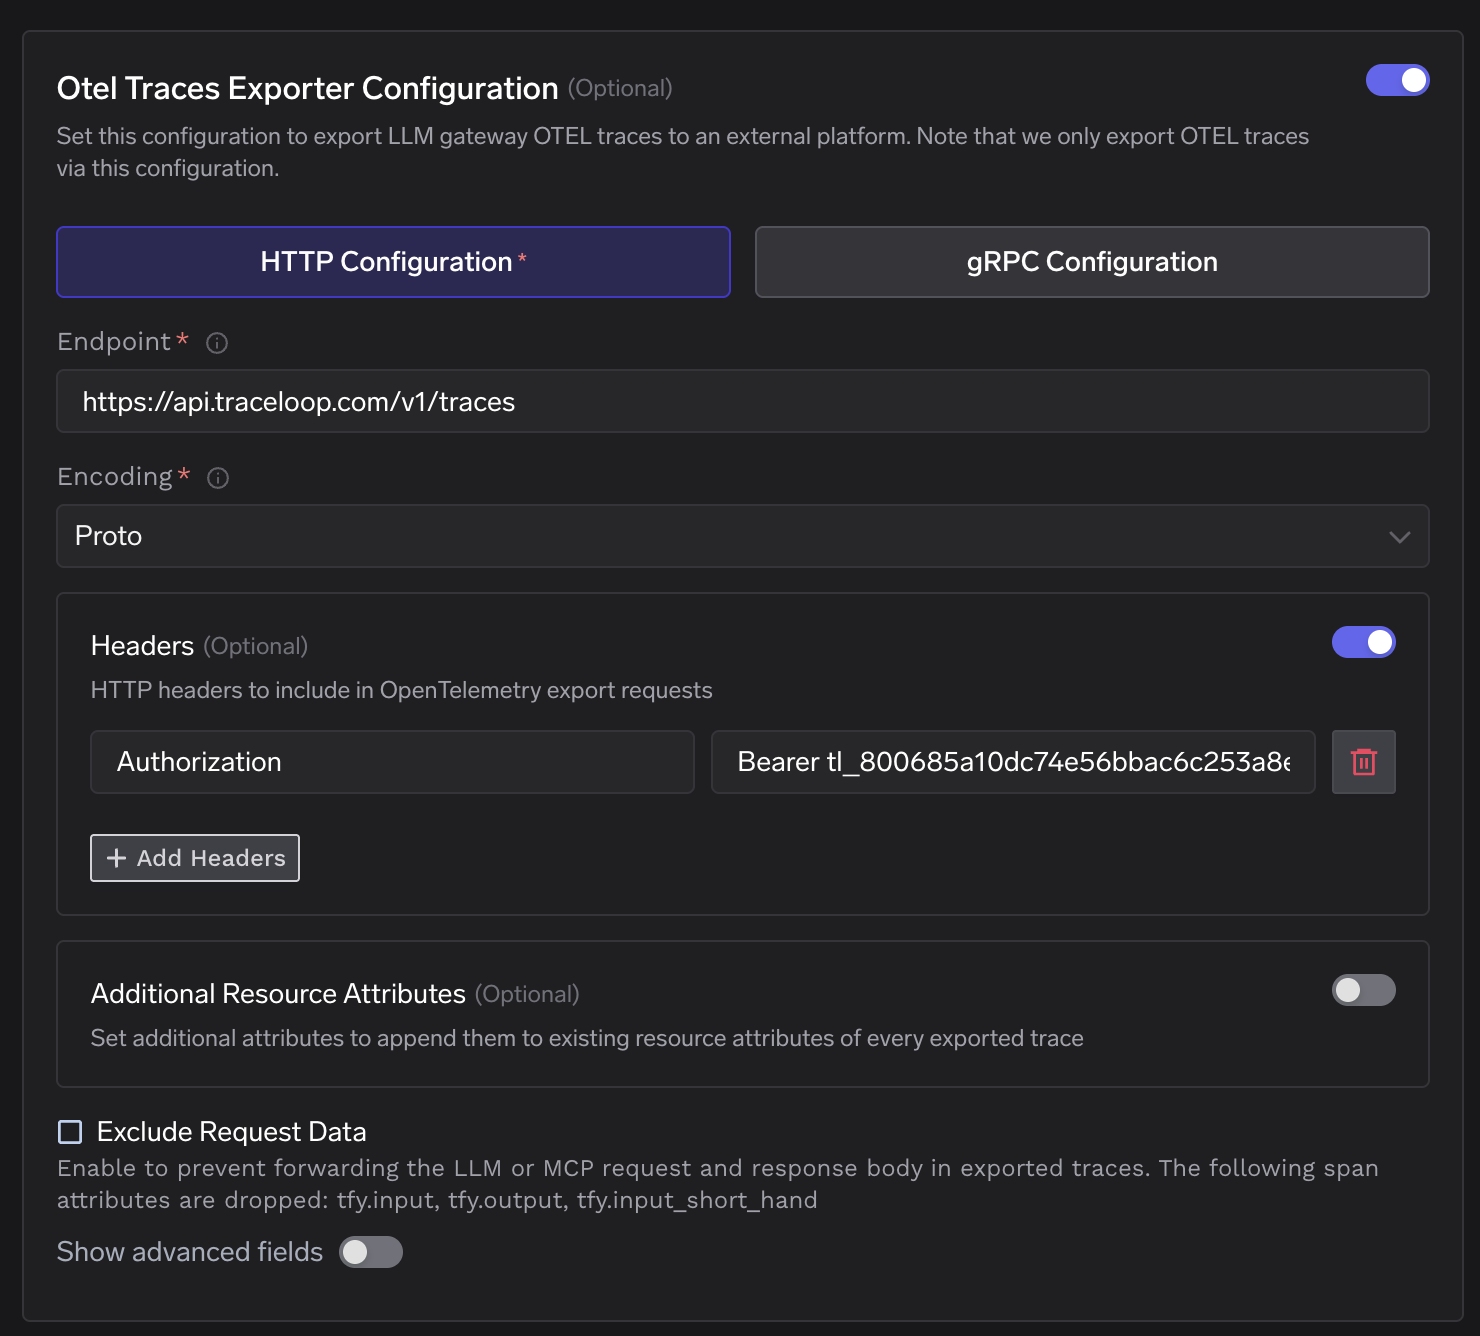
De verbinding tussen TrueFoundry en Traceloop is een enkele OTLP/HTTP POST naar https://api.traceloop.com/v1/traces met Proto-gecodeerde span batches. Authenticatie verloopt via een Bearer-token in de Authorization-header. Het token is een Traceloop API-sleutel gekoppeld aan een specifieke omgeving.
TrueFoundry biedt deze configuratie aan onder AI Gateway → Controls → Settings → OTEL Config. De sectie Otel Traces Exporter accepteert de volgende velden.
Het eindpunt moet het volledige /v1/traces-pad bevatten. De exporter van TrueFoundry voegt niet automatisch signaalpaden toe. Dit verschilt van de OTel Collector otlphttp-exporter, die het pad automatisch toevoegt aan de basis-URL. Beide verwijzen naar dezelfde bestemming.
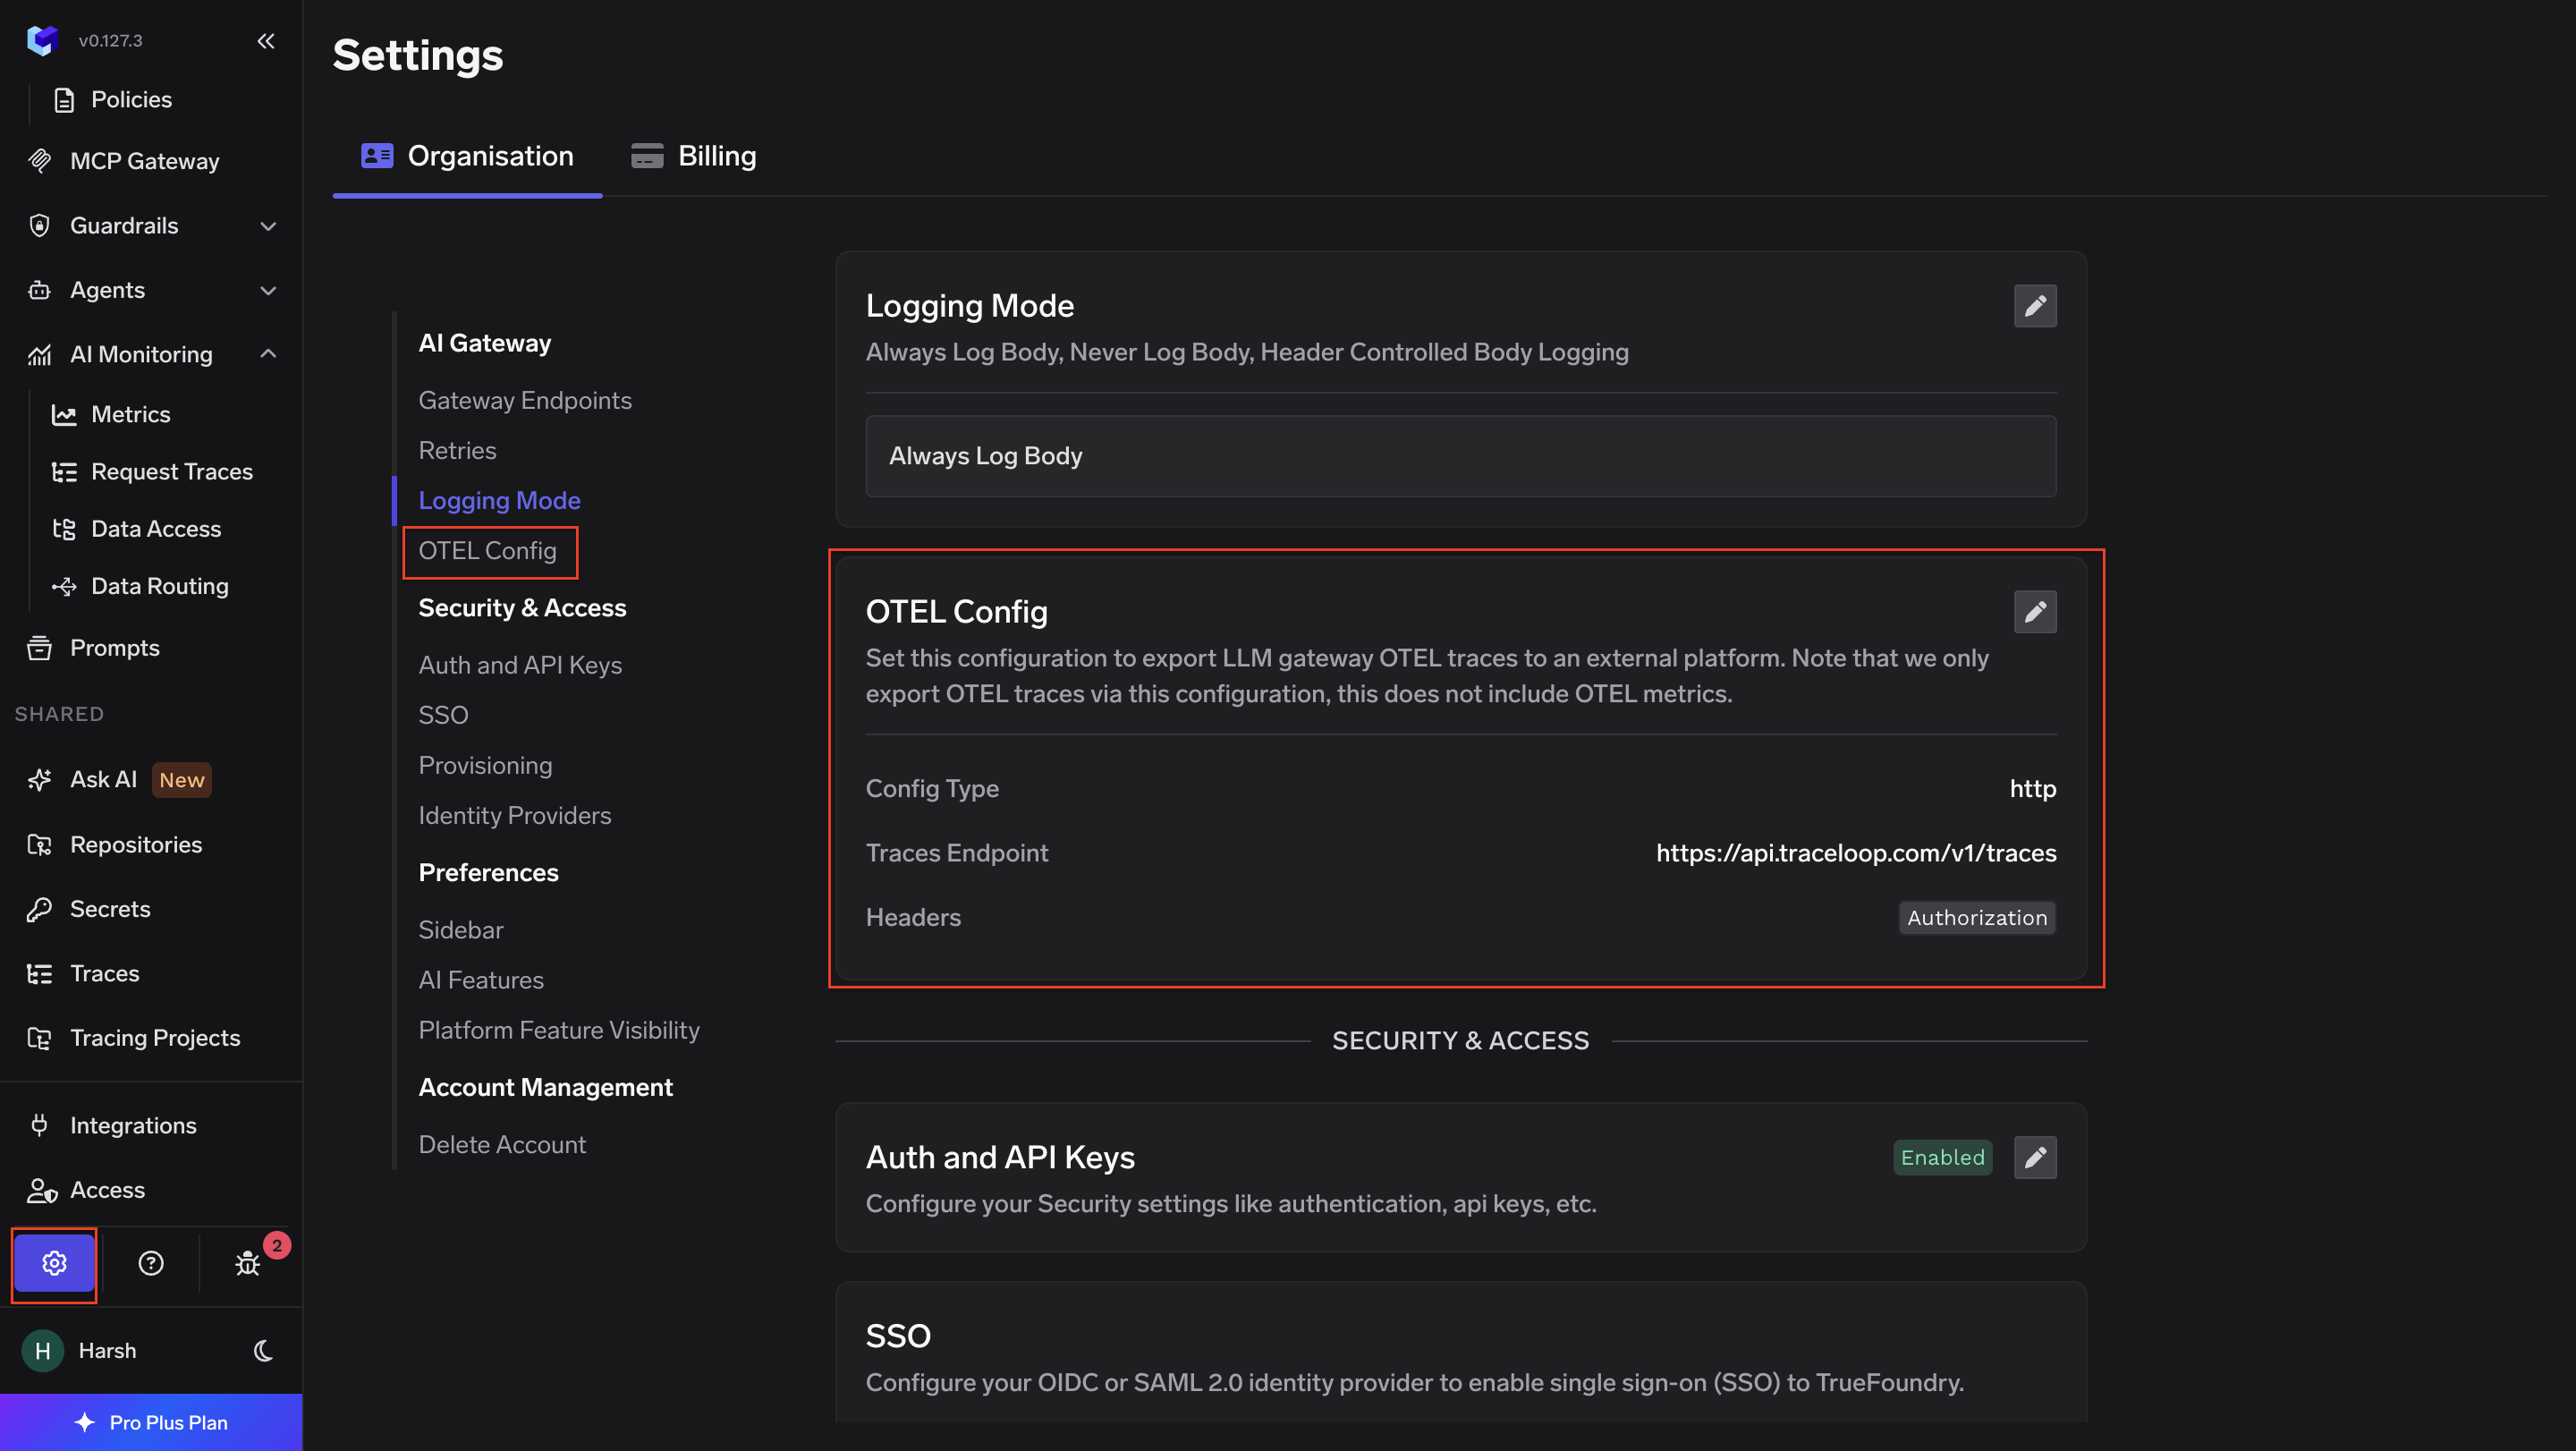
Traceloop API-sleutels worden per omgeving gegenereerd via de pagina Environments in het Traceloop-dashboard. Een sleutel wordt slechts één keer getoond bij het aanmaken. De sleutelwaarde wordt doorgegeven in de header als Bearer <key>, inclusief de Bearer-prefix als een letterlijke string.
De gateway biedt een schakelaar Exclude Request Data in de OTEL Config-sectie. Wanneer deze is ingeschakeld, verwijdert de exporter tfy.input, tfy.output en tfy.input_short_hand uit elke span voordat deze wordt doorgestuurd naar Traceloop. De overige span-attributen (tokenaantallen, modelnamen, latentie en routing-metadata) blijven ongewijzigd. Deze optie is geschikt wanneer prompts of completions PII van gebruikers of propriëtaire inhoud bevatten die de grenzen van het cluster niet mag verlaten.
Het veld Additional Resource Attributes maakt het mogelijk om aangepaste sleutel-waarde-paren toe te voegen aan elke geëxporteerde span. Dit is nuttig voor tagging per omgeving, toewijzing van kostenplaatsen en multi-tenant filtering binnen een enkele Traceloop-omgeving.
Elk LLM-request via de TrueFoundry AI Gateway genereert een span tree die authenticatie, routing, de provider-aanroep en de respons omvat. Nadat het request is voltooid, publiceert de gateway deze span tree asynchroon naar NATS. De OTEL-exporter leest uit NATS en stuurt Proto-gecodeerde batches via POST naar https://api.traceloop.com/v1/traces met een Bearer-token. Traceloop indexeert de spans en toont tokengebruik, latentie en overzichten per model in het dashboard op basis van de gen_ai.*-attributen op elke span.
Er zijn geen sidecars vereist. Er zijn geen wijzigingen in de applicatiecode nodig. Er hoeft geen OpenLLMetry SDK te worden toegevoegd aan services die de gateway aanroepen. De integratie werkt volledig op gateway-niveau en dekt 100% van het verkeer dat erdoorheen gaat, ongeacht de instrumentatiestatus van de aanroepende applicatie.
Eén van de belangrijkste architecturale voordelen is de asynchrone NATS-publicatie. Omdat het exporteren van spans is losgekoppeld van het requestpad, voegt de integratie nul latentie toe aan inference-aanroepen en ontstaat er geen afhankelijkheid van de beschikbaarheid van Traceloop. De gateway verwerkt requests op volle capaciteit, of Traceloop nu bereikbaar is of niet.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















